Claude로 채팅 애플리케이션을 구축할 때 중요한 사용자 경험 문제가 하나 있습니다. 응답을 생성하는 데 10~30초가 걸릴 수 있어 사용자가 로딩 스피너만 바라보게 된다는 것입니다. 이에 대한 해결책이 바로 응답 스트리밍입니다. 스트리밍을 사용하면 Claude가 텍스트를 생성하는 동안 사용자가 청크 단위로 텍스트가 나타나는 것을 볼 수 있어 훨씬 더 반응성이 높은 느낌을 만들어냅니다.
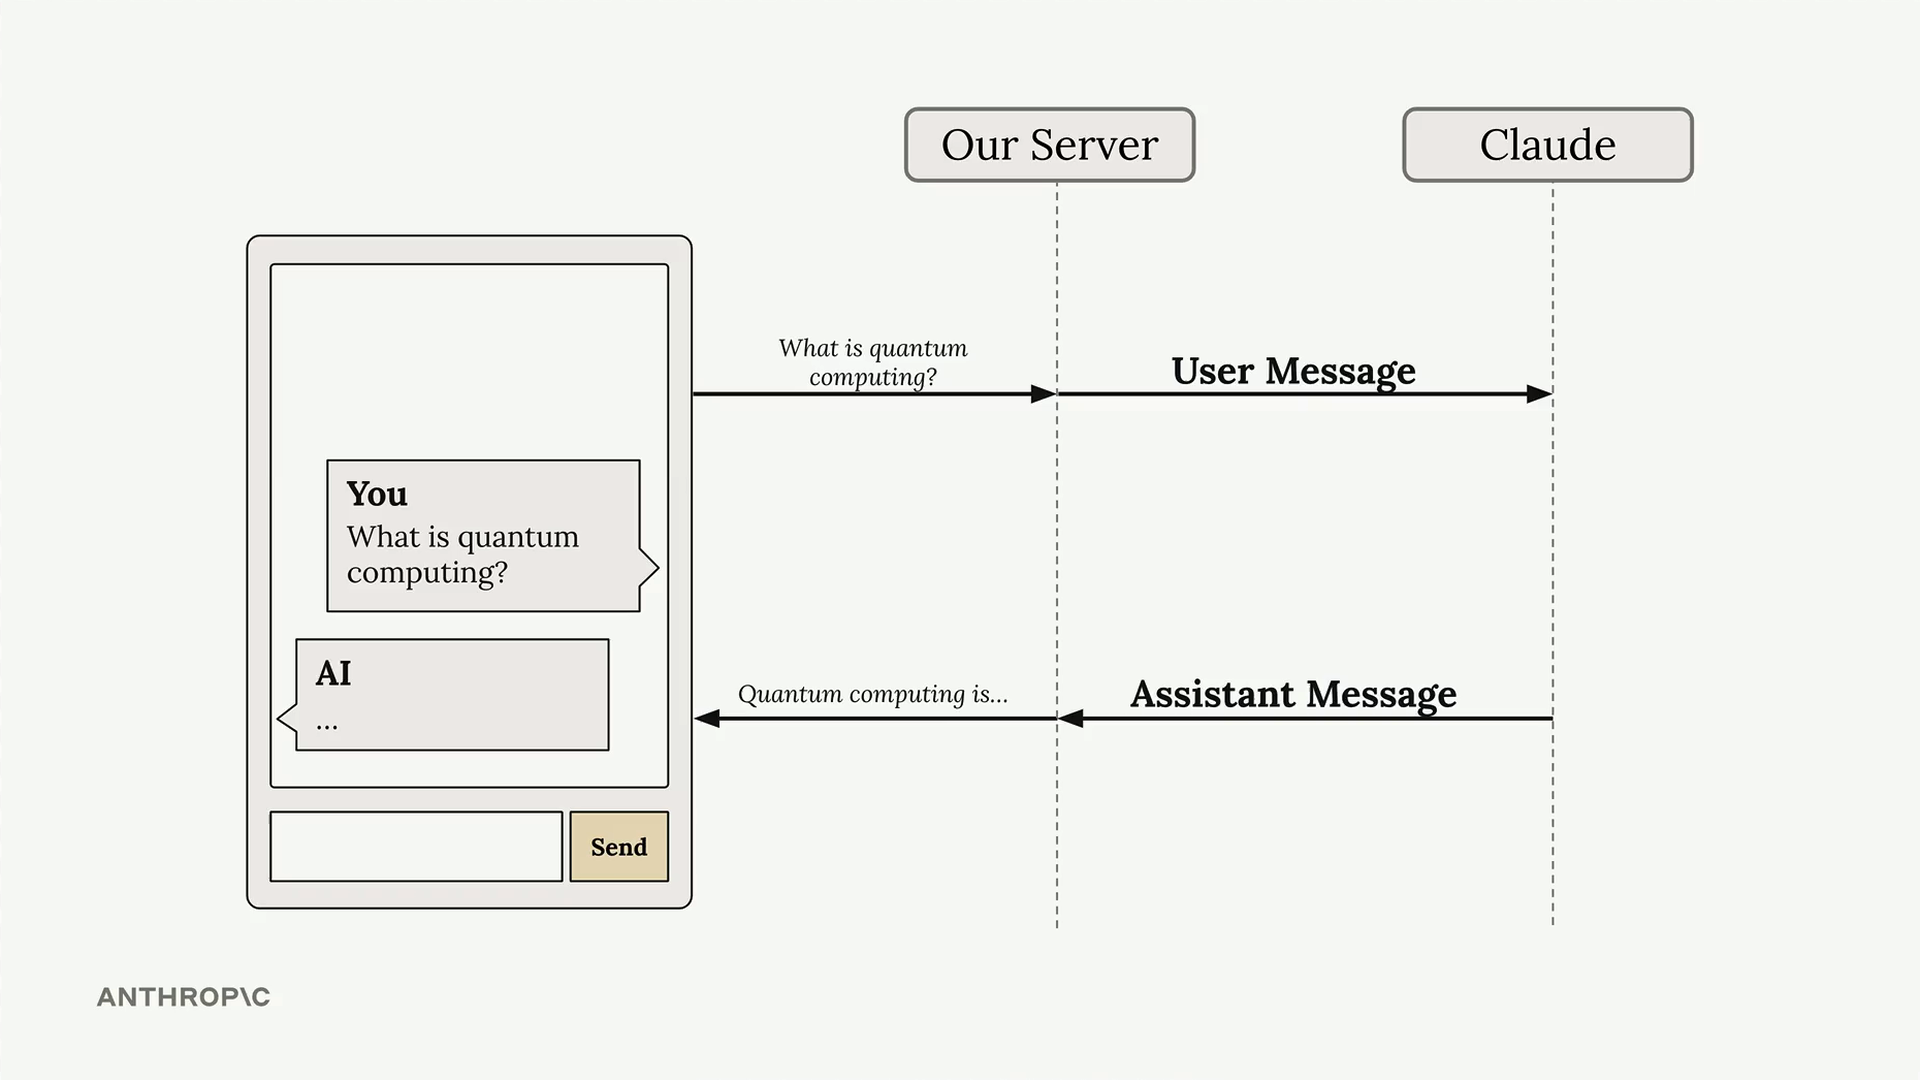
표준 응답의 문제점
일반적인 채팅 설정에서는 서버가 사용자 메시지를 Claude로 전송하고 클라이언트에게 아무것도 전송하기 전에 완전한 응답을 기다립니다. 이로 인해 사용자가 어떤 일이 진행되고 있는지에 대한 피드백을 전혀 받지 못하는 어색한 지연이 발생합니다.
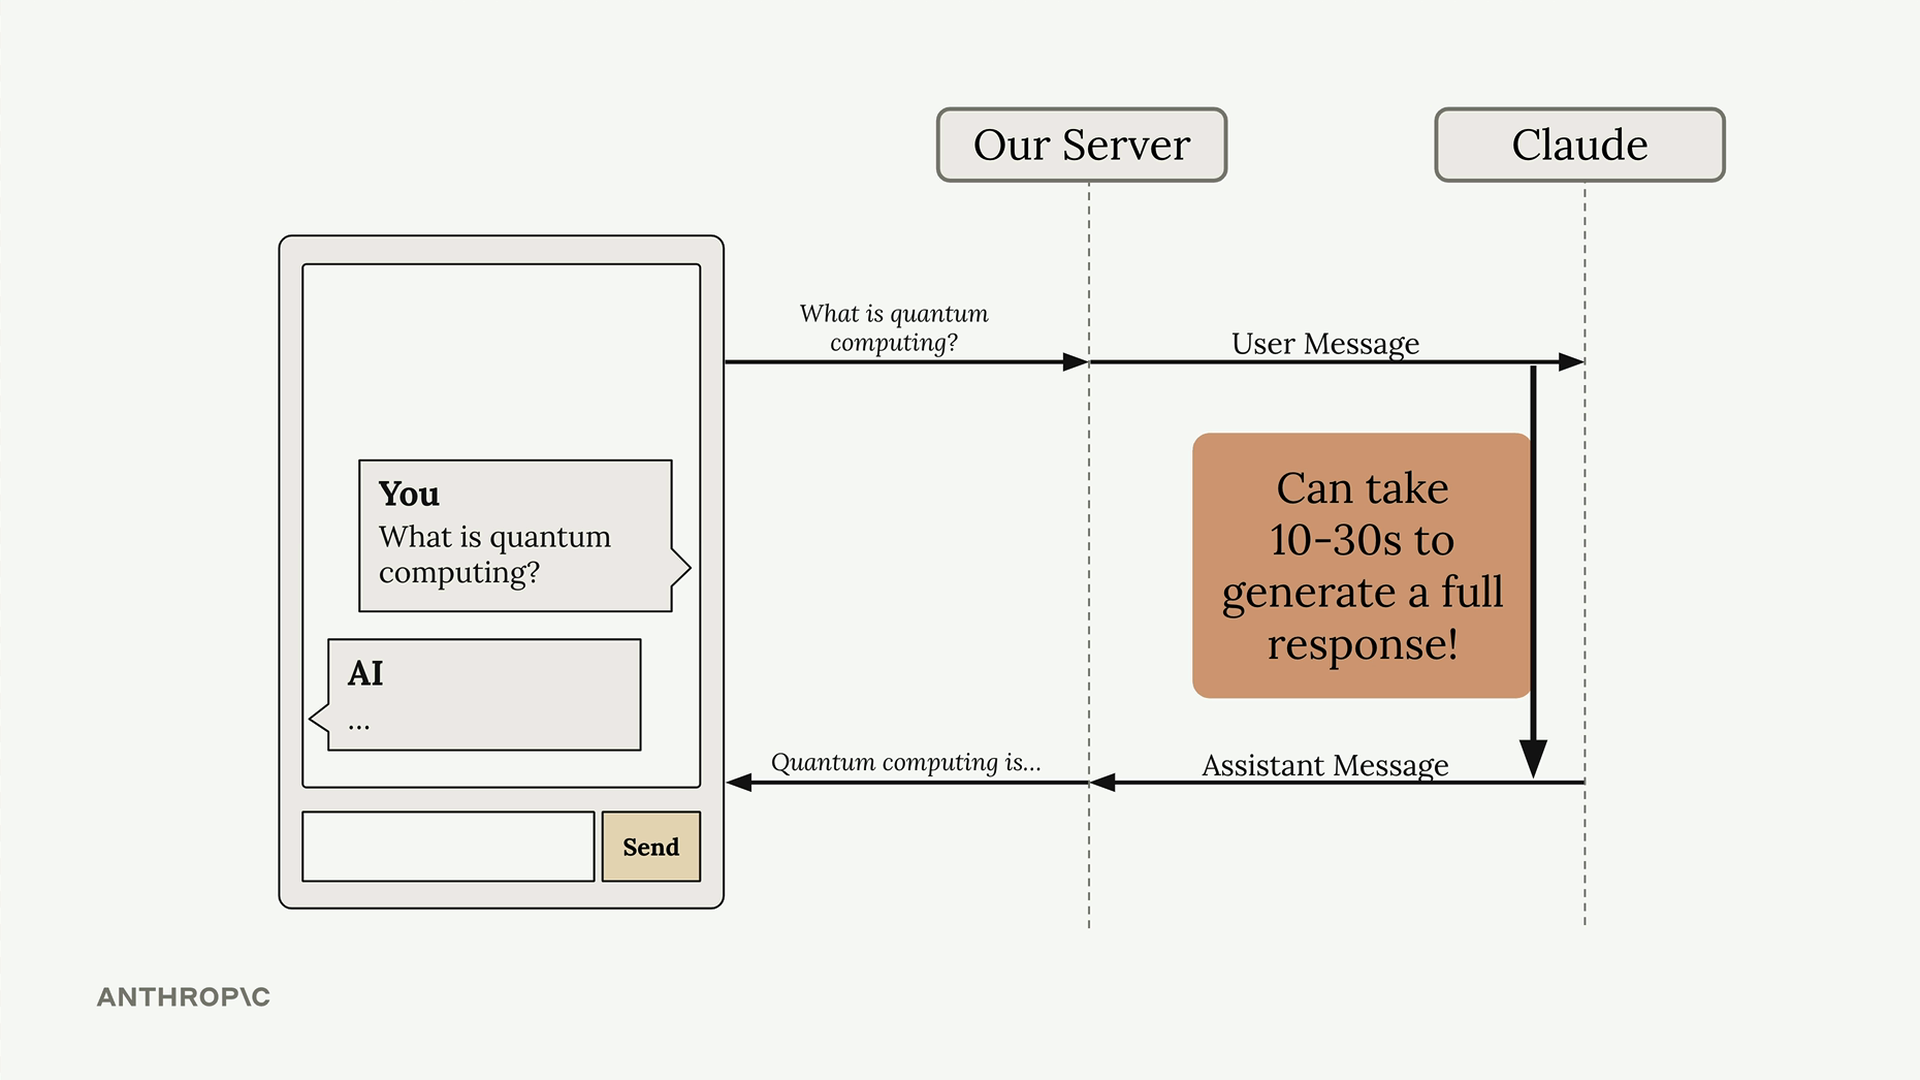
스트리밍 작동 방식
스트리밍이 활성화되면 Claude는 요청을 수신했으며 텍스트 생성을 시작한다는 초기 응답을 즉시 보냅니다. 그런 다음 전체 응답의 작은 조각을 각각 담은 일련의 이벤트를 받게 됩니다.
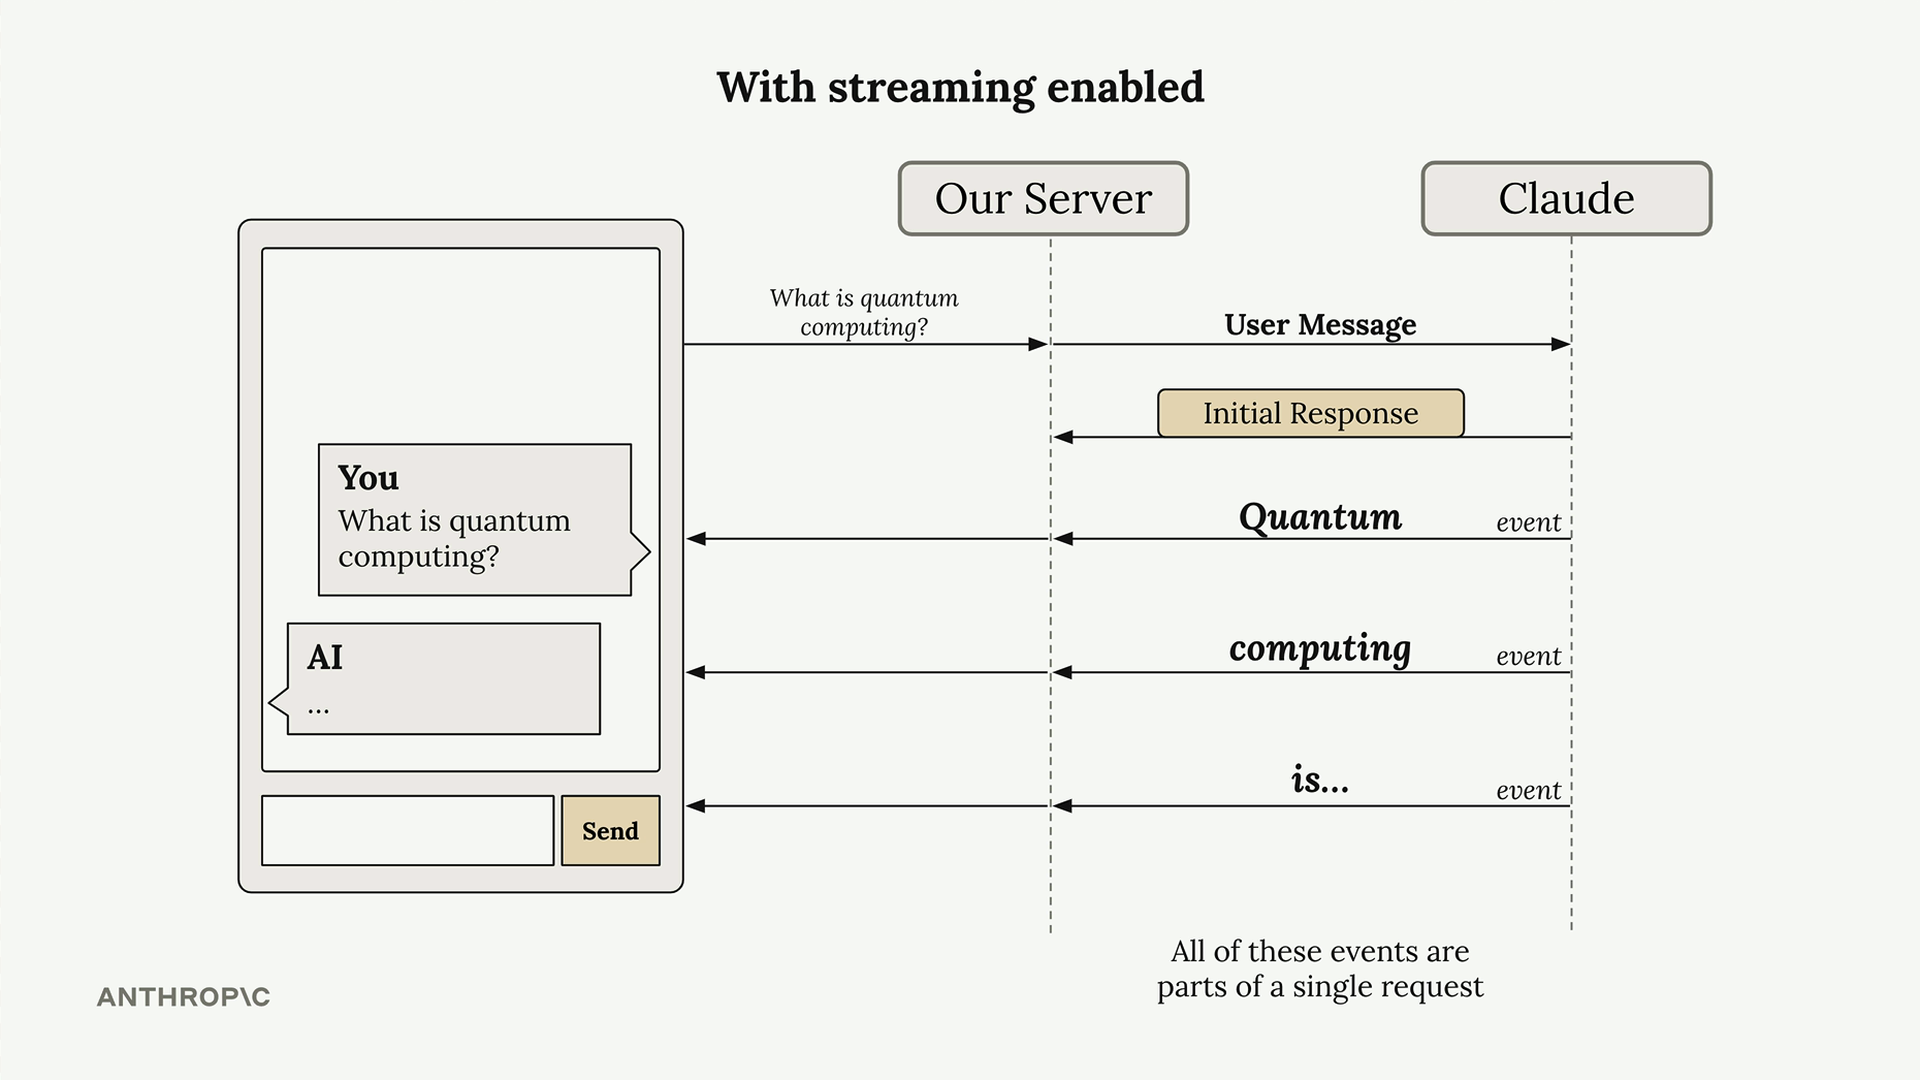
서버는 이러한 텍스트 청크가 도착하는 대로 클라이언트 애플리케이션으로 전달할 수 있으며, 이를 통해 사용자는 응답이 단어 단위로 쌓여가는 것을 볼 수 있습니다. 이러한 모든 이벤트는 Claude에 대한 하나의 단일 요청의 일부입니다.
스트림 이벤트 이해하기
스트리밍을 활성화하면 Claude는 여러 유형의 이벤트를 보냅니다:
- MessageStart - 새로운 메시지가 전송되고 있음
- ContentBlockStart - 텍스트, 도구 사용 또는 기타 콘텐츠를 포함하는 새로운 블록의 시작
- ContentBlockDelta - 실제로 생성된 텍스트의 청크
- ContentBlockStop - 현재 콘텐츠 블록이 완료됨
- MessageDelta - 현재 메시지가 완료됨
- MessageStop - 현재 메시지에 대한 정보의 끝
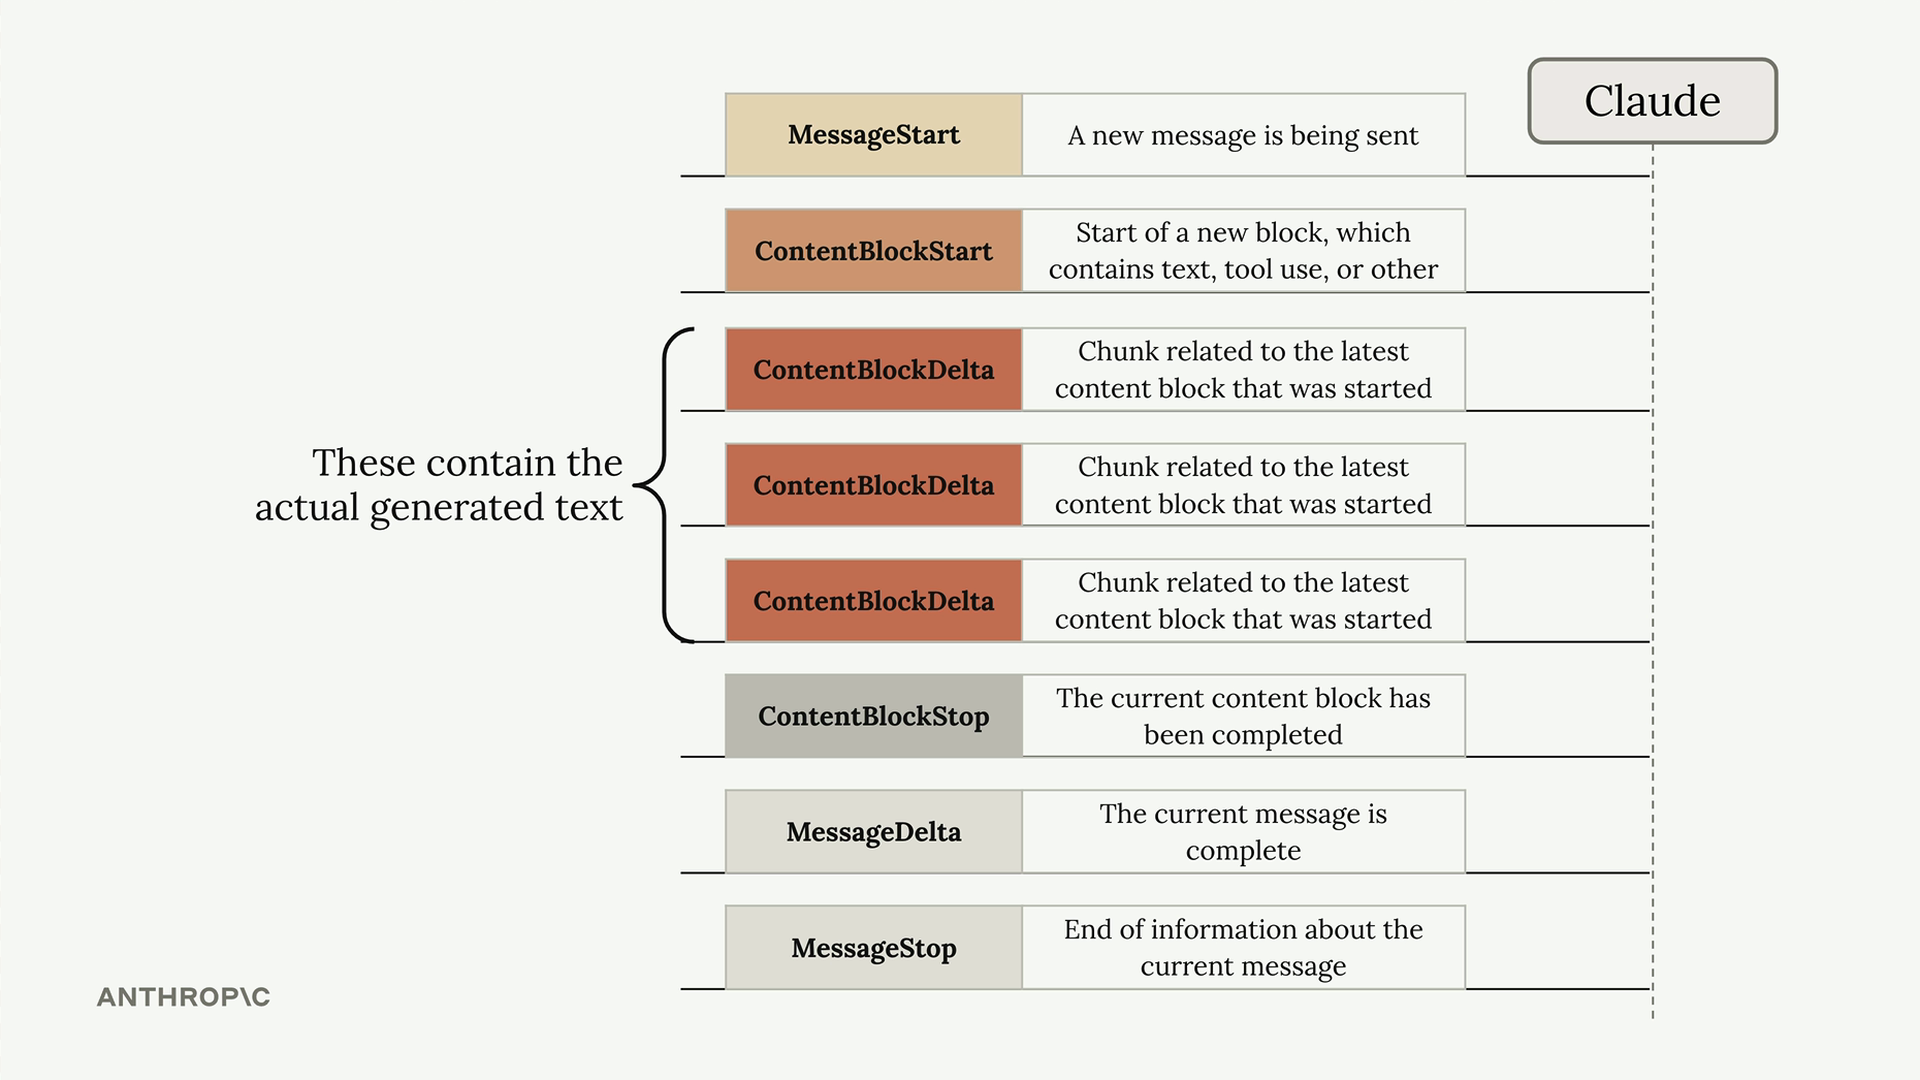
ContentBlockDelta 이벤트에는 사용자에게 표시하고자 하는 실제 생성된 텍스트가 포함되어 있습니다.
기본 스트리밍 구현
스트리밍을 활성화하려면 messages.create 호출에 stream=True를 추가하세요:
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)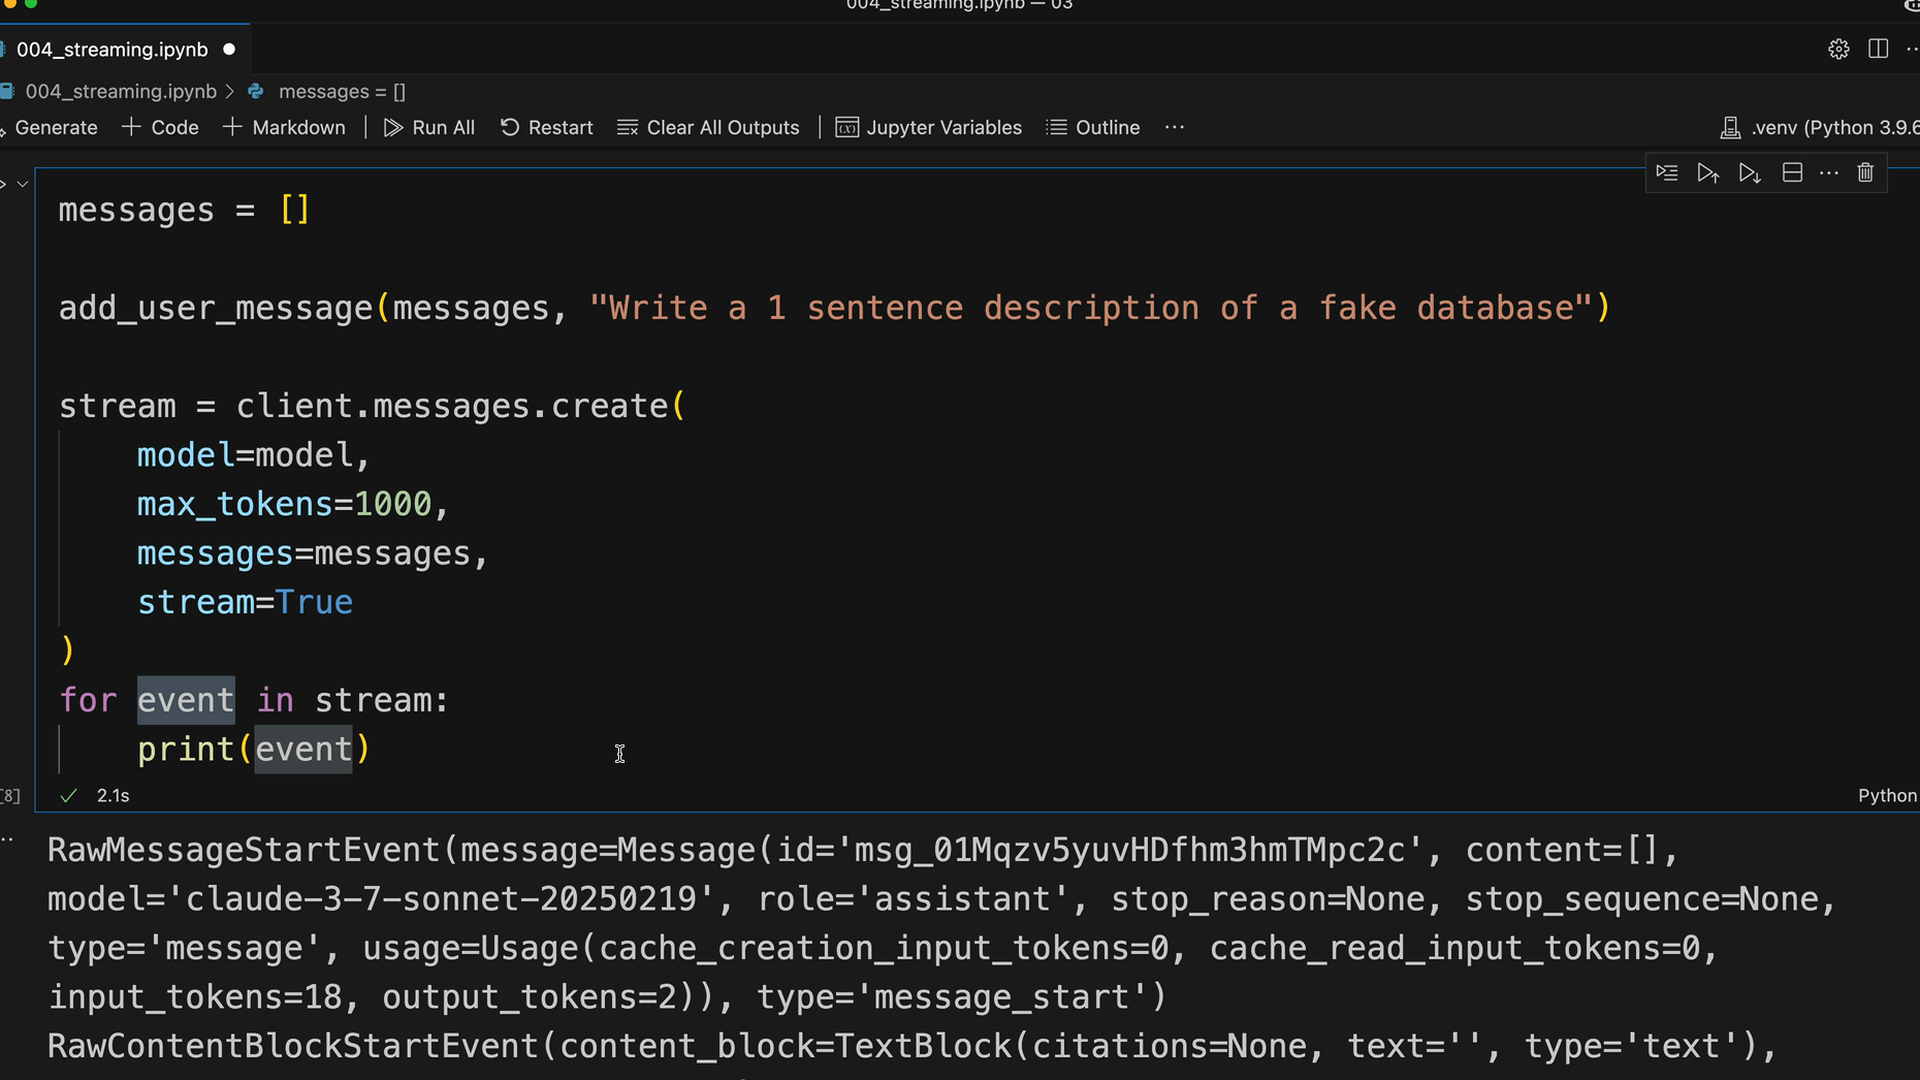
단순화된 텍스트 스트리밍
이벤트를 수동으로 파싱하는 대신, SDK의 단순화된 스트리밍 인터페이스를 사용하여 실제 텍스트 콘텐츠만 추출할 수 있습니다:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
이 방식은 실제 텍스트 콘텐츠를 제외한 모든 것을 자동으로 필터링하며, 이는 보통 사용자에게 응답을 표시할 때 필요한 것입니다.
최종 메시지 가져오기
스트리밍은 사용자 경험에 훌륭하지만, 저장이나 추가 처리를 위해 완전한 메시지가 필요한 경우가 많습니다. 스트리밍이 완료된 후, 조립된 최종 메시지를 가져올 수 있습니다:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        pass  # Send to client in real application

    final_message = stream.get_final_message()
이를 통해 사용자 경험을 위한 스트리밍 기능과 데이터베이스 저장 또는 대화 기록을 위한 완전한 메시지 객체를 모두 얻을 수 있습니다.
실용적 고려사항
스트림의 각 텍스트 청크에는 여러 단어 또는 완전한 문장이 포함될 수 있습니다. 이벤트당 정확히 한 단어를 받는다는 보장은 없습니다. 청크 크기는 Claude가 각 텍스트 부분을 얼마나 빠르게 생성하는지에 따라 달라집니다.
실제 운영 애플리케이션에서는 일반적으로 이러한 텍스트 청크를 WebSocket이나 Server-Sent Events를 통해 클라이언트 애플리케이션으로 즉시 전달하여, 서버에서 완전한 대화 기록을 유지하면서도 사용자가 실시간으로 응답이 나타나는 것을 볼 수 있도록 합니다.