코드를 생성하는 AI 모델을 평가할 때는 응답이 말이 되는지 확인하는 것만으로는 충분하지 않습니다. 생성된 코드가 실제로 유효한 구문을 가지고 있는지, 그리고 올바른 형식을 따르는지도 검증해야 합니다. 바로 이 지점에서 코드 기반 채점이 필요합니다.
코드 채점 작동 방식
코드 채점은 AI가 생성한 응답의 두 가지 핵심 측면을 검증합니다:
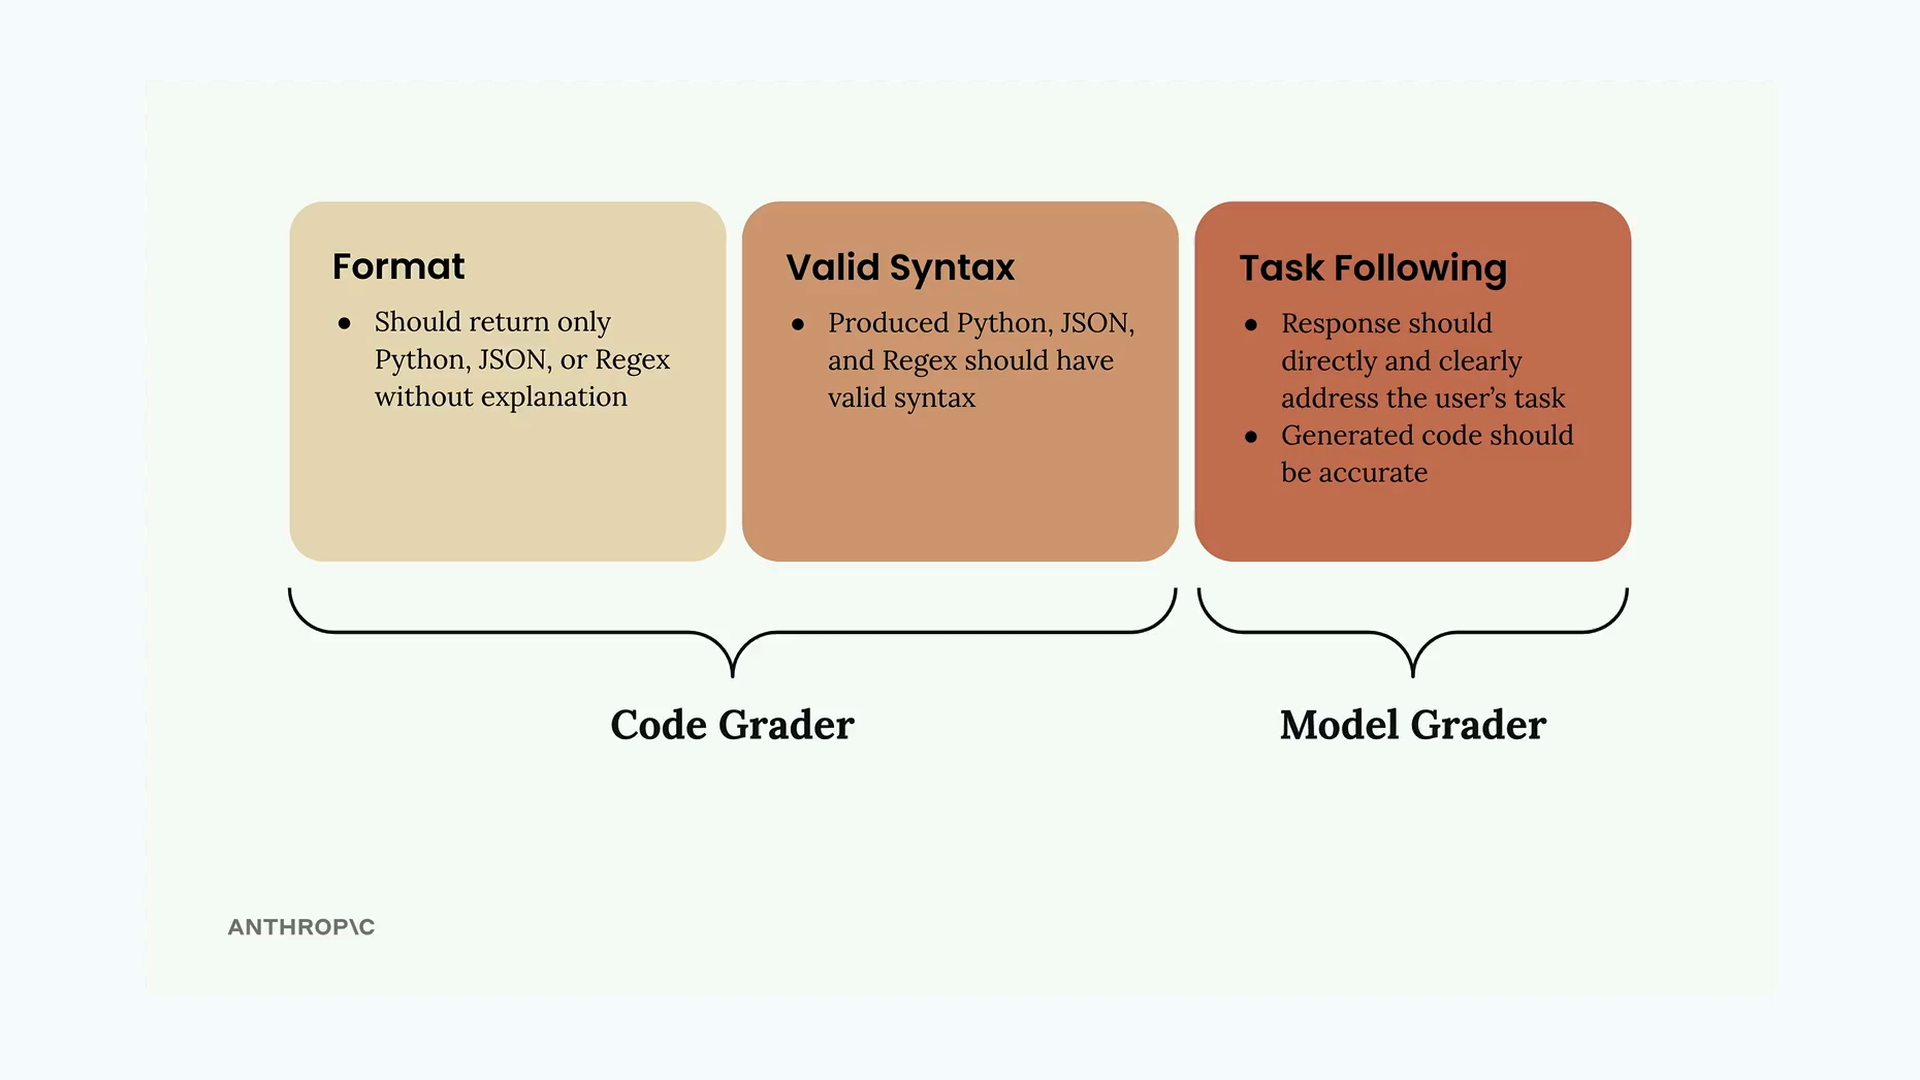
- 형식(Format) - 응답은 설명 없이 요청된 코드 유형(Python, JSON, 또는 Regex)만을 반환해야 합니다
- 유효한 구문(Valid Syntax) - 생성된 코드는 의도한 언어로 실제로 올바르게 파싱되어야 합니다
- 작업 수행(Task Following) - 응답은 요청받은 내용을 직접적으로 다루고 정확해야 합니다
처음 두 가지 기준은 코드 채점기가 처리하며, 작업 수행은 모델 채점기에 의해 평가됩니다. 이 둘을 합치면 포괄적인 평가가 이루어집니다.
구문 검증 함수
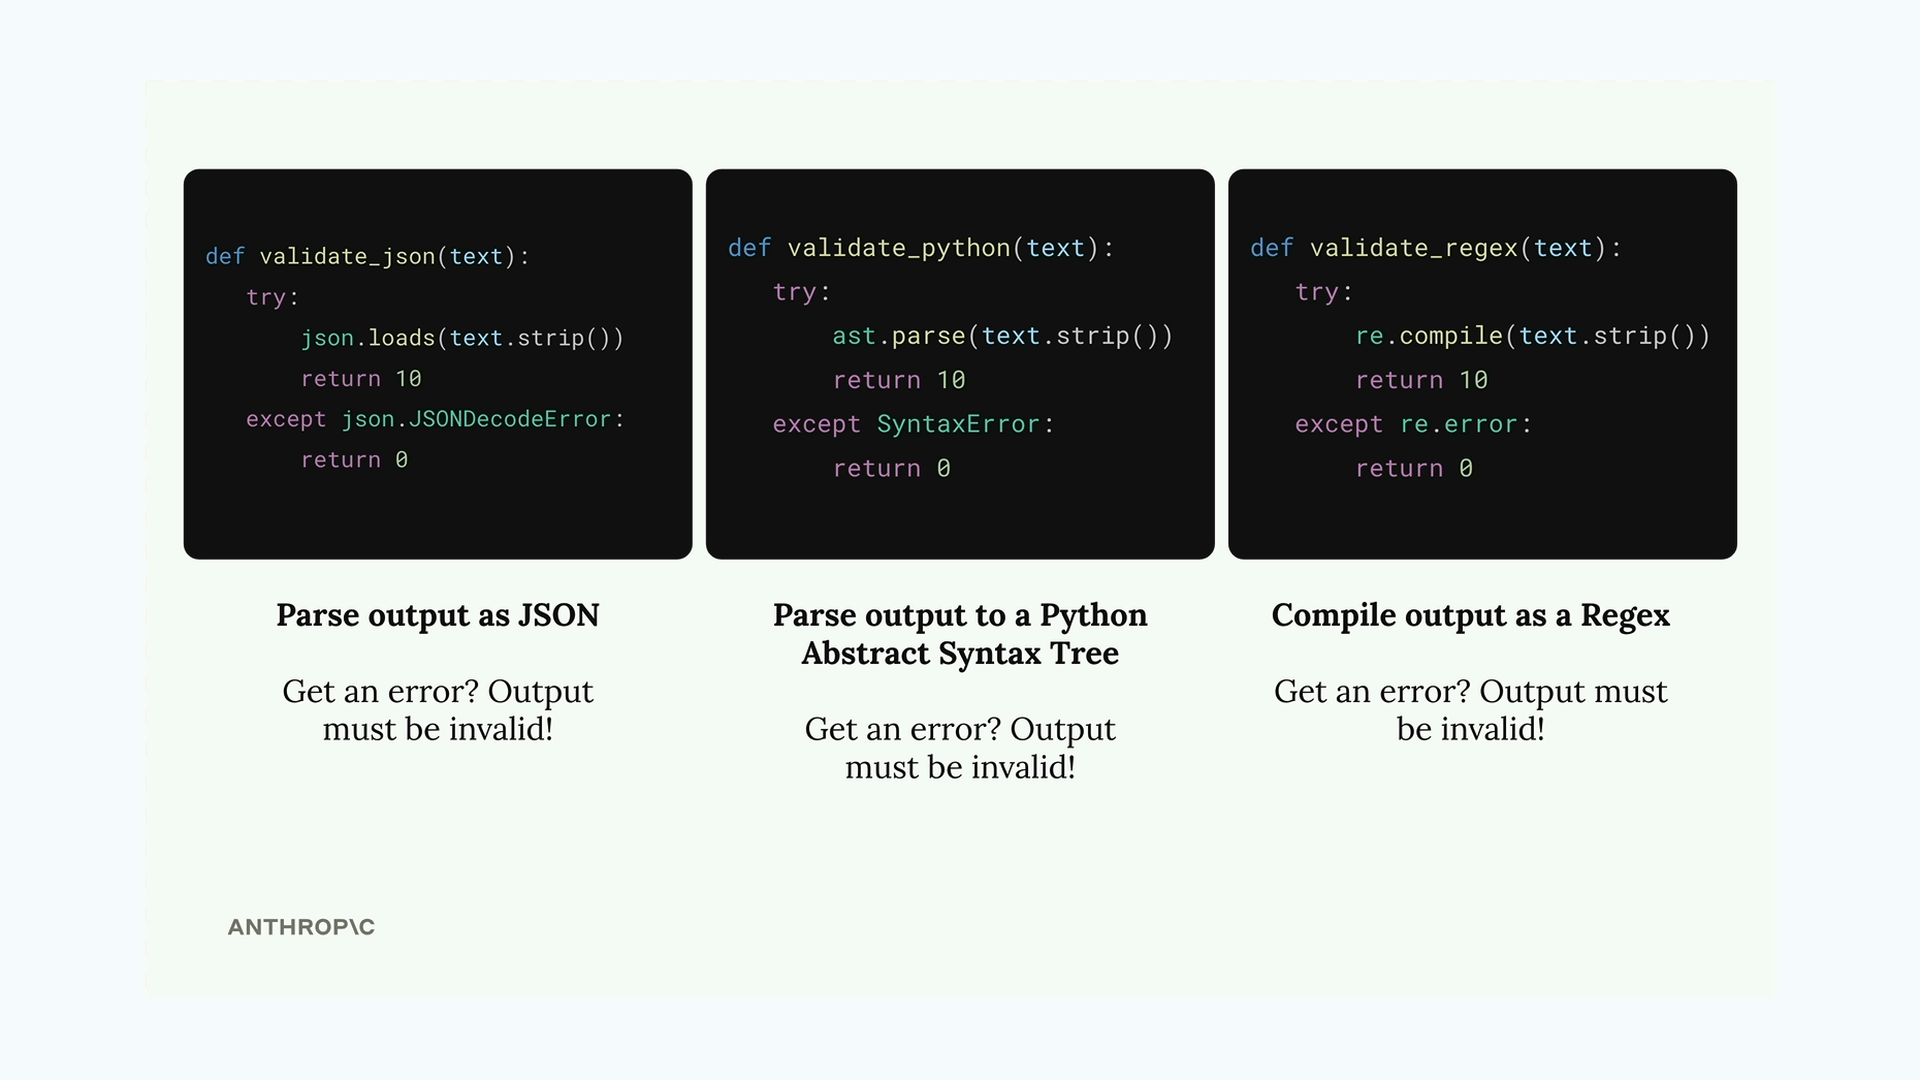
생성된 코드가 유효한 구문을 가지고 있는지 확인하기 위해, 출력을 파싱하려고 시도하는 세 가지 도우미 함수를 만들 수 있습니다:
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
각 함수는 텍스트를 해당 형식으로 파싱하려고 시도합니다. 파싱이 성공하면 완벽한 점수인 10점을 반환합니다. 오류와 함께 실패하면 구문이 유효하지 않은 것이며 0점을 반환합니다.
데이터셋 형식 요구 사항
코드 채점기가 어떤 검증기를 사용해야 하는지 알 수 있도록, 테스트 케이스에 예상 출력 형식을 명시해야 합니다:
{
    "task": "Create a Python function to validate an AWS IAM username",
    "format": "python"
}
예시 출력 구조에 이 형식 필드를 추가함으로써, 데이터셋 생성 프롬프트를 업데이트하여 이 필드를 자동으로 포함하도록 할 수 있습니다.
프롬프트 명확성 개선
AI 모델에서 더 나은 결과를 얻으려면, 예상되는 출력 형식에 대해 프롬프트 지침을 더 구체적으로 만드세요:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanation또한 코드 블록이 포함된 미리 채워진 어시스턴트 메시지를 사용하여 모델이 원시 코드만 반환하도록 유도할 수도 있습니다:
add_assistant_message(messages, "```code")
output = chat(messages, stop_sequences=["```"])
이렇게 하면 Claude가 Python, JSON, Regex 중 어느 것인지 미리 명시할 필요 없이 코드 콘텐츠 생성을 시작하도록 지시합니다.
점수 결합하기
먼저, 각 테스트 케이스에 맞는 검증기를 선택합니다:
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
    return validate_regex(output)
마지막 단계는 모델 채점기 점수와 코드 채점기 점수를 병합하는 것입니다. 간단한 접근 방법은 run_test_case 내부에서 두 점수의 평균을 내는 것입니다:
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
이렇게 하면 콘텐츠 품질과 기술적 정확성 모두에 동일한 가중치가 부여됩니다. 특정 사용 사례에서 무엇이 더 중요한지에 따라 이러한 가중치를 조정할 수 있습니다.
구현 테스트하기
코드 채점을 구현했다면, 평가를 실행하여 기준 점수를 얻으세요. 점수 자체가 본질적으로 좋거나 나쁜 것은 아닙니다 - 중요한 것은 프롬프트를 개선함으로써 점수를 향상시킬 수 있는지 여부입니다. 이를 통해 주관적인 평가에 의존하는 대신 프롬프트 엔지니어링 진행 상황을 정량적으로 측정할 수 있는 방법을 얻게 됩니다.