맥락적 검색은 RAG 파이프라인의 정확도를 개선하는 기법으로, 근본적인 문제를 해결합니다: 문서를 청크로 분할하면 각 청크는 더 넓은 문서 맥락과의 연결을 잃게 됩니다.
표준 청킹의 문제점
소스 문서를 가져와 벡터 데이터베이스에 넣기 위해 청크로 분할하면, 각각의 개별 조각은 자신이 어디서 왔는지 또는 문서의 나머지 부분과 어떻게 연관되는지를 더 이상 알지 못하게 됩니다. 이는 청크가 중요한 맥락 정보를 결여하고 있기 때문에 검색 정확도를 해칠 수 있습니다.
맥락적 검색의 작동 방식
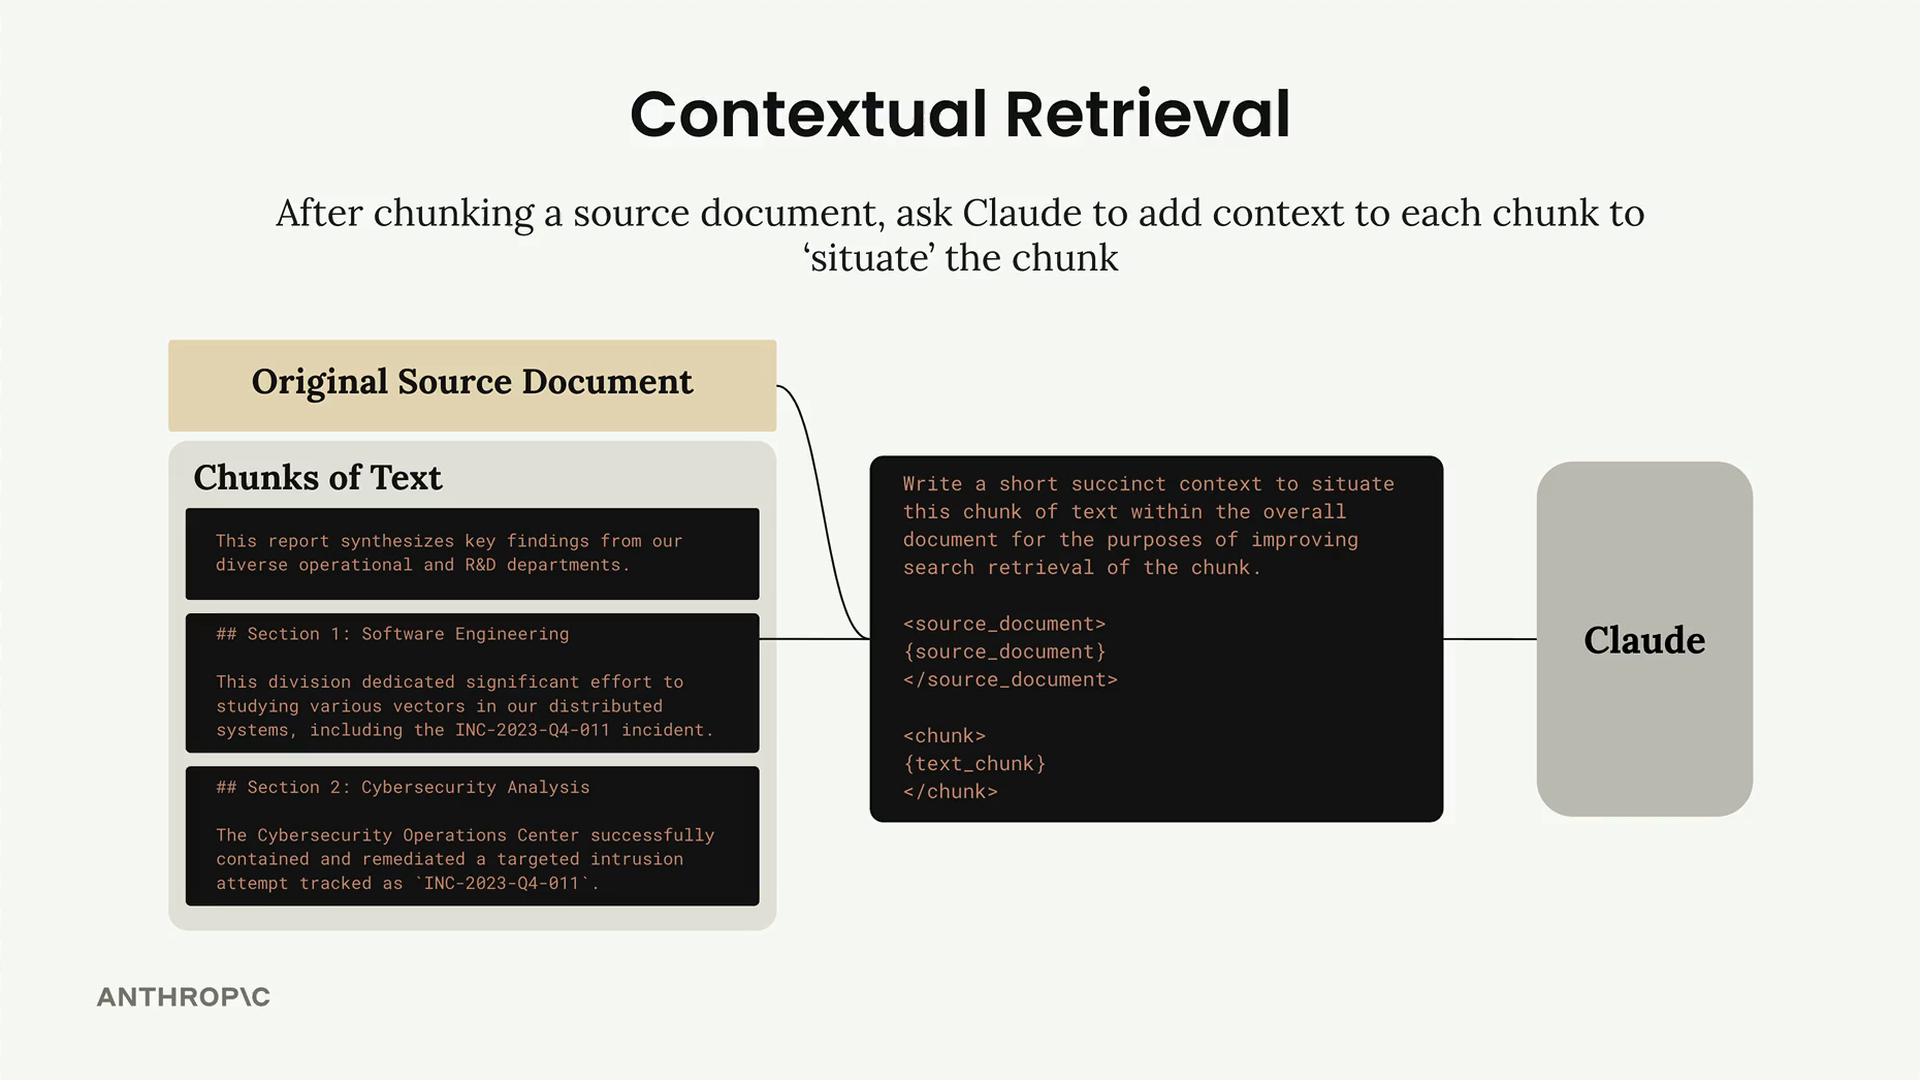
맥락적 검색은 청크를 리트리버 데이터베이스에 삽입하기 전에 전처리 단계를 추가합니다. 그 과정은 다음과 같습니다:
- 각 개별 청크와 원본 소스 문서를 가져옵니다
- 둘 다 맥락을 추가해달라는 특정 프롬프트와 함께 Claude에 전송합니다
- Claude는 더 큰 문서 내에서 해당 청크를 "위치시키는" 짧은 스니펫을 생성합니다
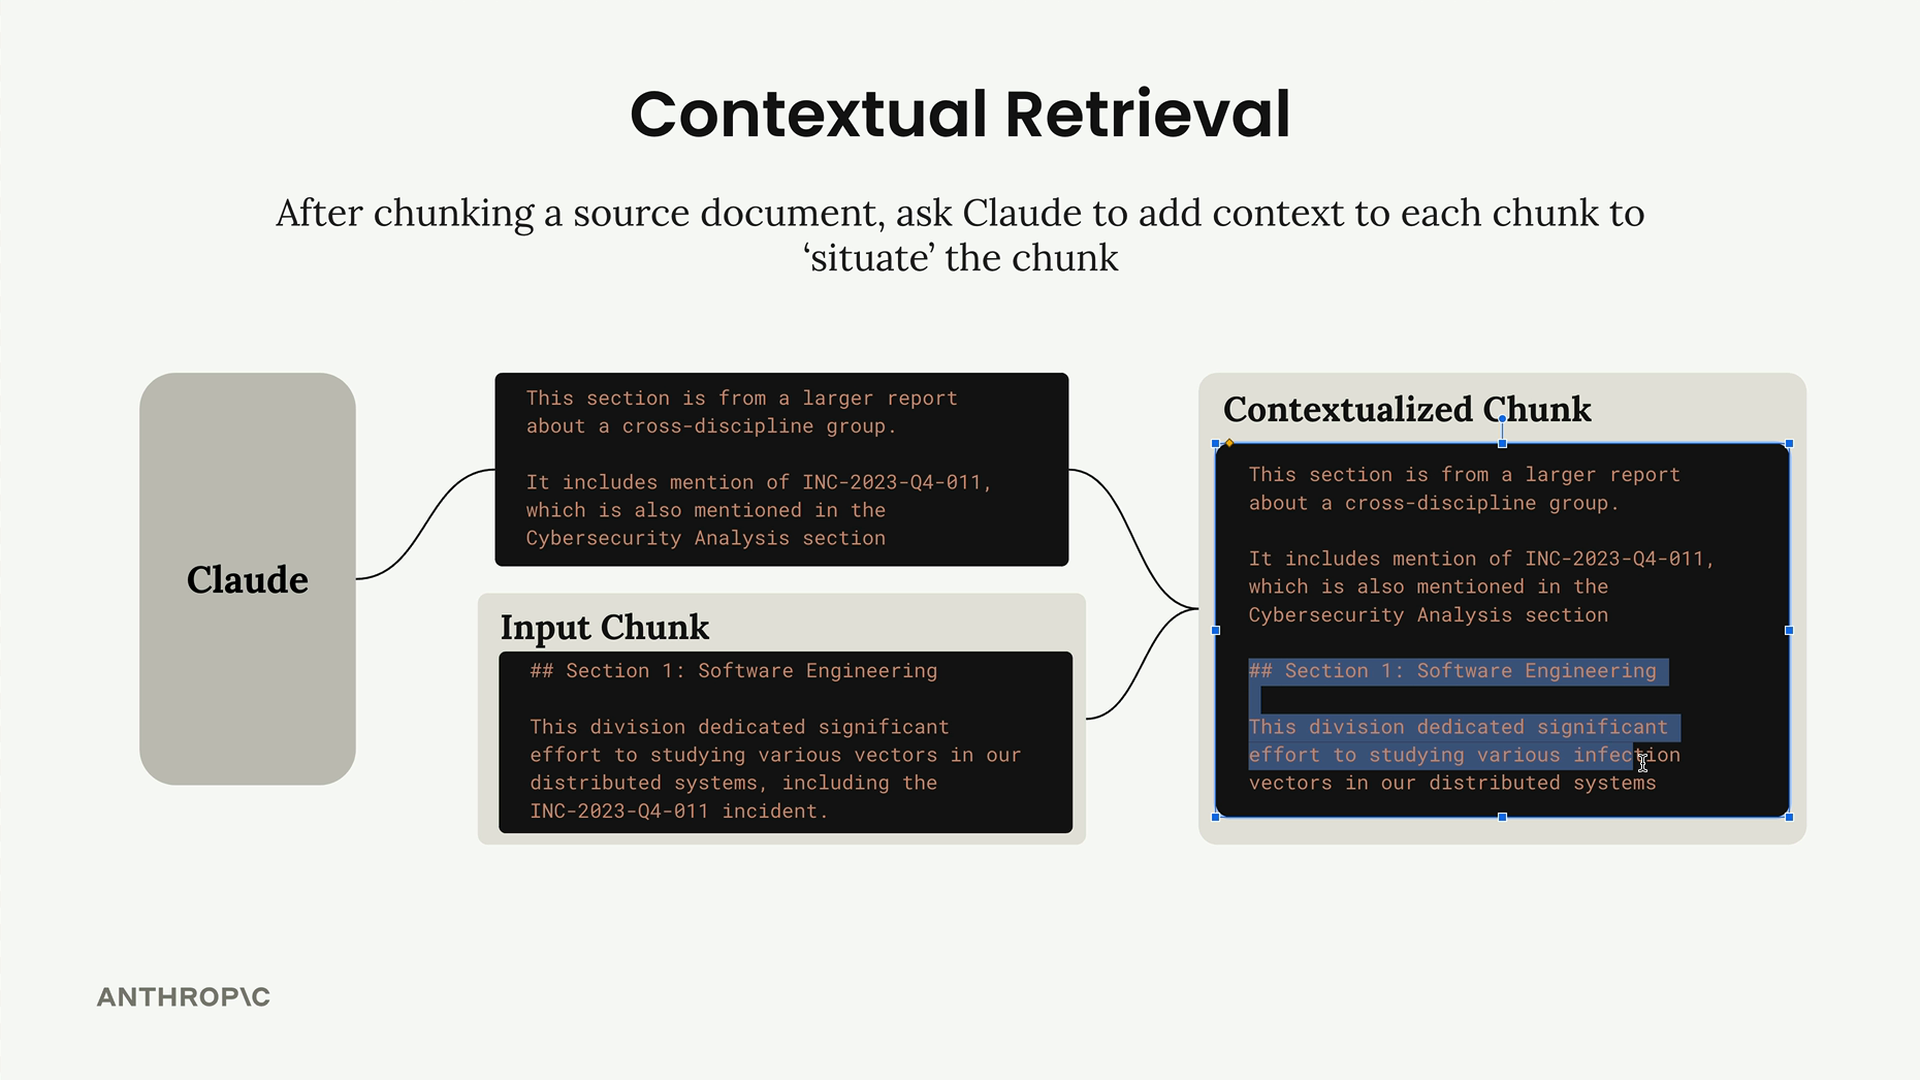
- 이 맥락을 원본 청크와 결합하여 "맥락화된 청크"를 생성합니다
- 맥락화된 청크를 벡터 및 BM25 인덱스에 사용합니다
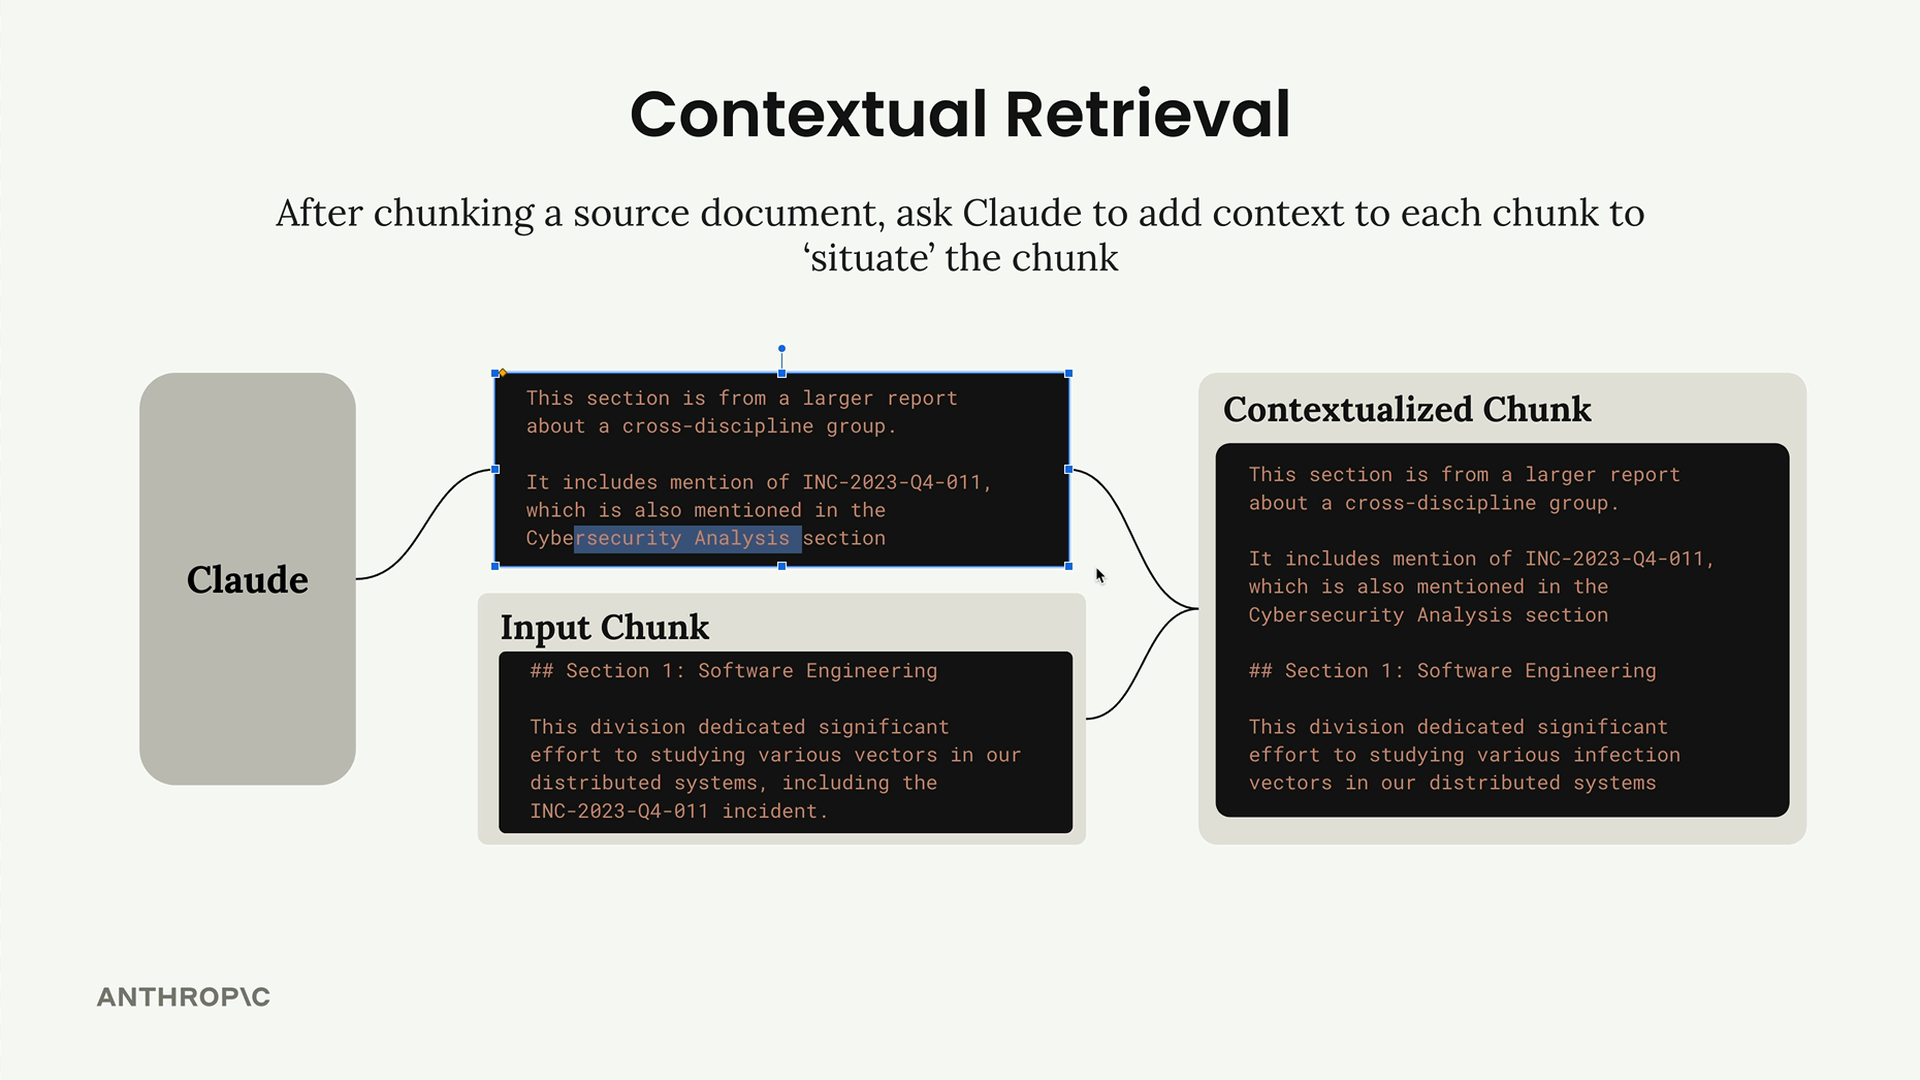
예를 들어, 소프트웨어 엔지니어링에 관한 섹션에 2023년 인시던트가 언급되어 있다면, Claude는 다음과 같은 맥락을 생성할 수 있습니다: "이 섹션은 여러 분야에 걸친 그룹에 관한 더 큰 보고서에서 발췌한 것입니다. 여기에는 사이버보안 분석 섹션에서도 언급된 INC-2023-04-011에 대한 언급이 포함되어 있습니다."
대용량 문서 처리하기
흔히 발생하는 문제는 소스 문서가 너무 커서 Claude의 컨텍스트 창에 들어가지 않는 경우입니다. 이 경우에도 맥락의 범위를 줄여서 제공하면 맥락적 검색을 계속 사용할 수 있습니다:
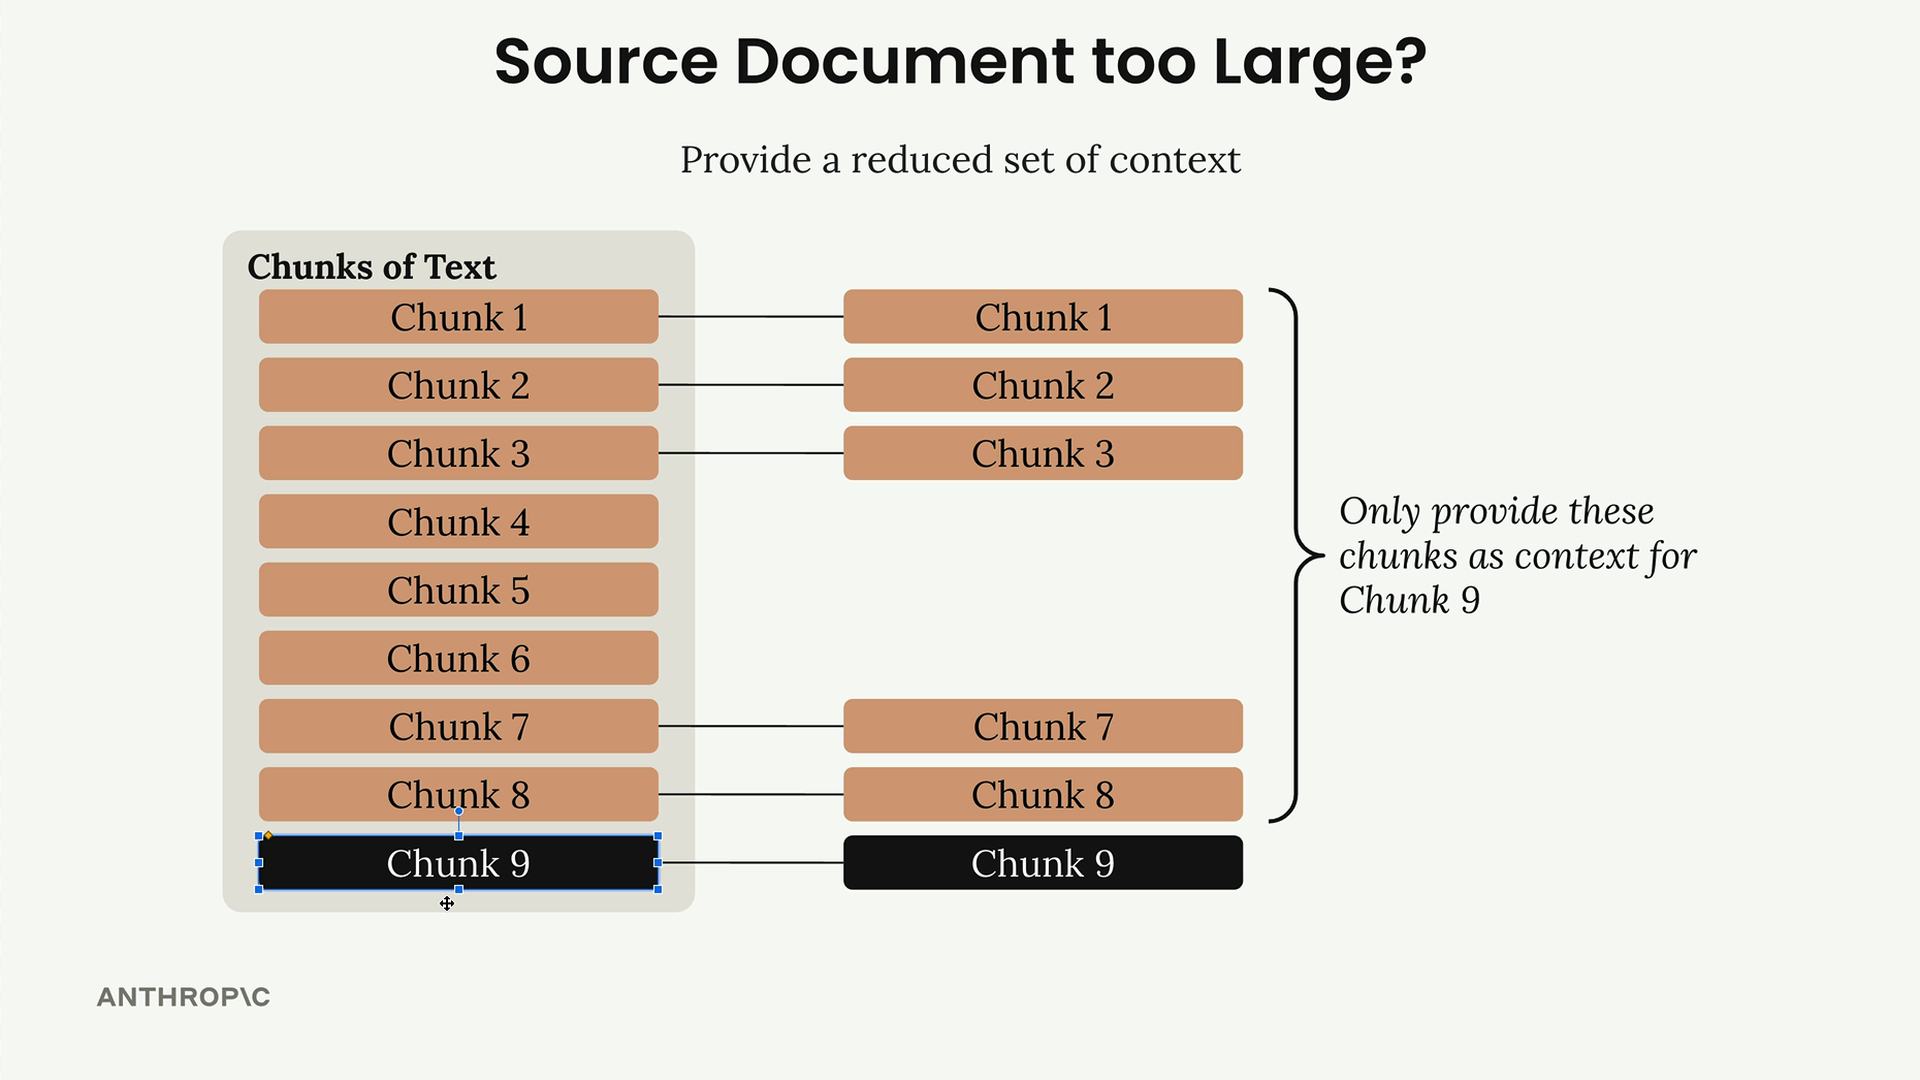
전체 문서를 포함하는 대신 다음을 제공하세요:
- 문서 시작 부분의 몇몇 청크(대개 요약이나 초록을 포함)
- 맥락을 부여하려는 청크 바로 앞에 위치한 청크들
이 접근 방식은 프롬프트에 과부하를 주지 않으면서도 Claude가 문서 구조와 직접적인 맥락을 이해하기에 충분한 정보를 제공합니다.
구현 예시
다음은 청크에 맥락을 추가하는 기본적인 함수입니다:
def add_context(text_chunk, source_text):
    prompt = f"""
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.
"""

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return text_from_message(result) + "\n" + text_chunk
대용량 문서의 경우, 관련된 맥락 청크를 선택하는 전략을 구현할 수 있습니다:
# 각 청크에 컨텍스트를 추가한 다음 retriever에 추가합니다
num_start_chunks = 2
num_prev_chunks = 2

for i, chunk in enumerate(chunks):
    context_parts = []

    # 문서 시작 부분에서 가져온 초기 청크 집합
    context_parts.extend(chunks[: min(num_start_chunks, len(chunks))])

    # 현재 컨텍스트화하는 청크보다 앞에 있는 추가 청크
    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
맥락적 검색을 사용해야 할 때
이 기법은 다음과 같은 경우에 가장 유용합니다:
- 문서의 섹션들 사이에 복잡한 내부 관계가 있는 경우
- 청크가 문서의 다른 곳에서 정의된 개념을 참조하는 경우
- 정확한 검색을 위해 문서 구조를 이해하는 것이 중요한 경우
- 기술 문서, 보고서, 또는 학술 논문을 다루는 경우
맥락적 검색은 처리 시간과 비용을 추가하지만(추가적인 API 호출을 하게 되므로), 맥락이 중요한 복잡한 문서에 대해 검색 정확도를 크게 향상시킬 수 있습니다.