검색 증강 생성(Retrieval Augmented Generation, RAG)은 Claude를 사용할 때 대용량 문서를 다루는 데 도움이 되는 기법입니다. 800페이지 분량의 재무 보고서 전체를 하나의 프롬프트에 욱여넣는 대신, RAG를 사용하면 각 질문에 가장 관련성이 높은 부분만 지능적으로 찾아 포함할 수 있습니다.
대용량 문서의 문제점
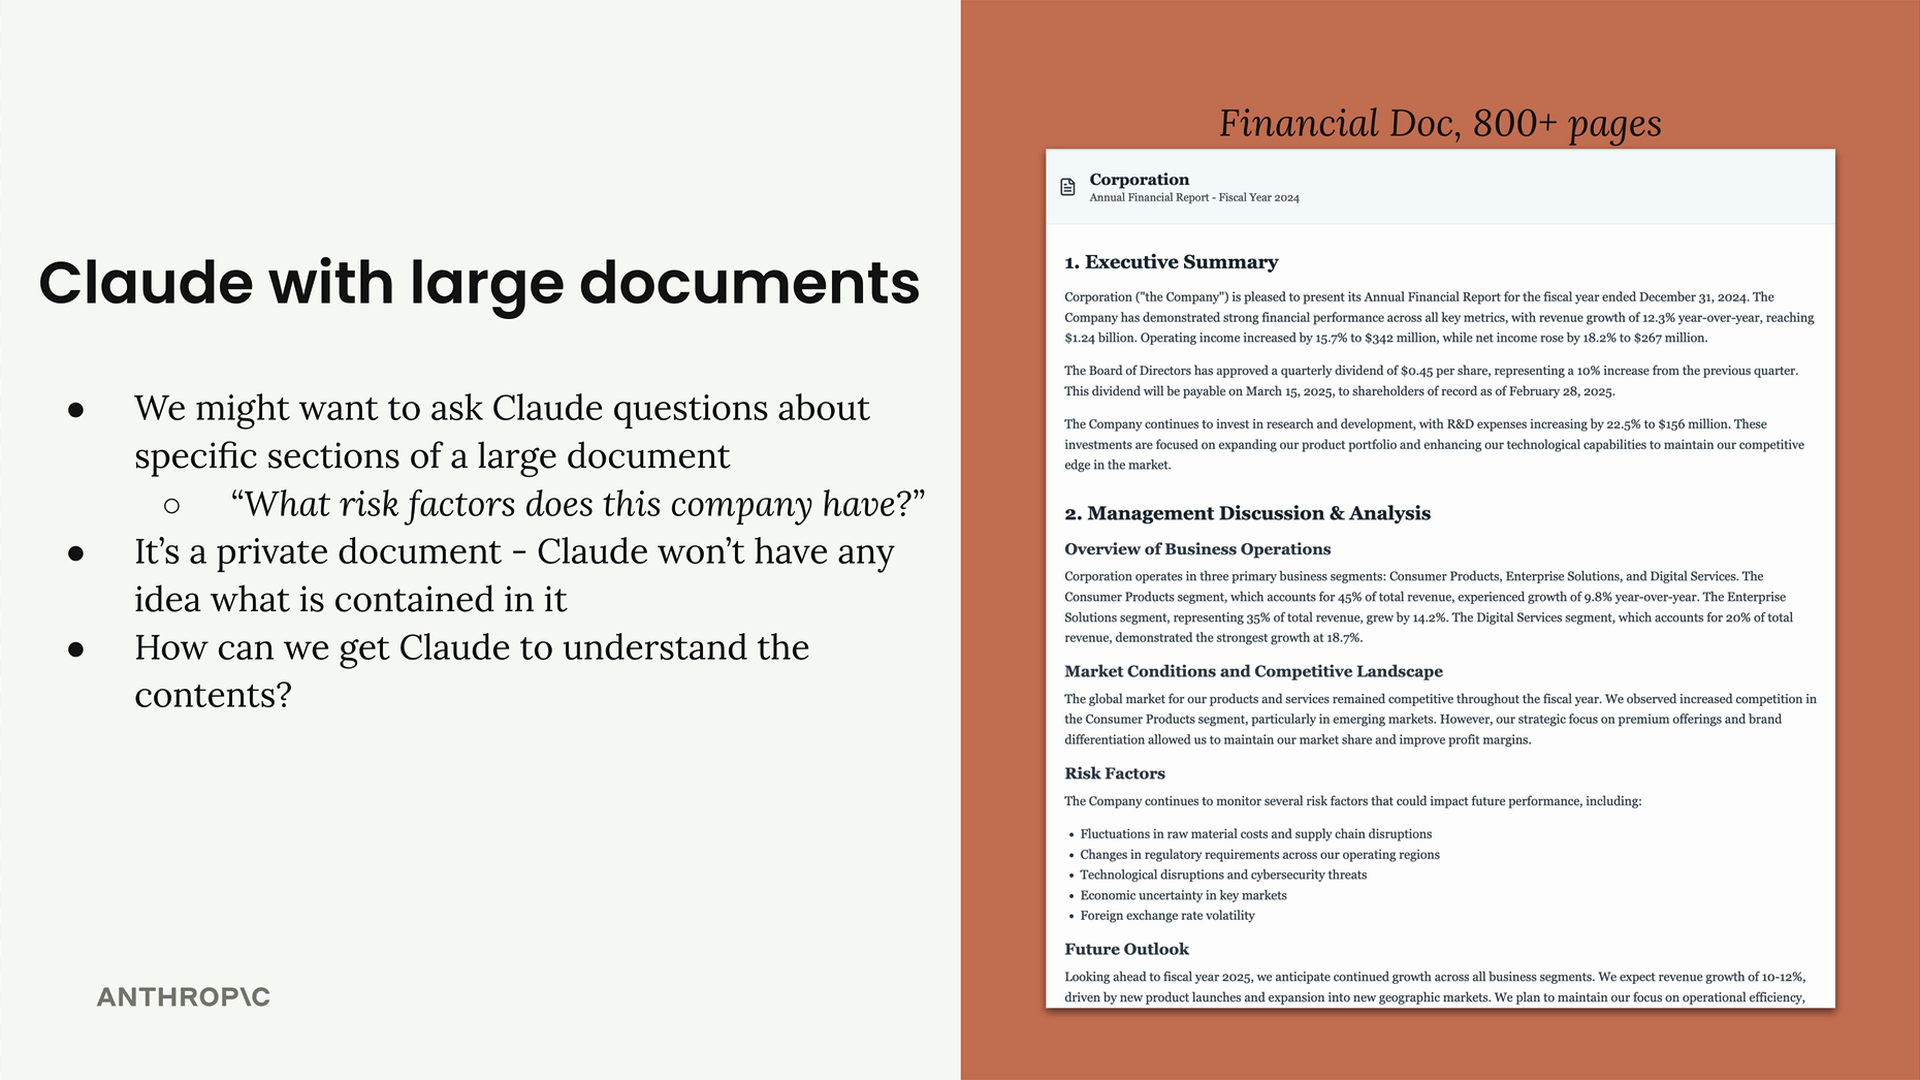
방대한 재무 문서를 가지고 있고 "이 회사는 어떤 리스크 요인을 가지고 있나요?"와 같은 구체적인 질문을 Claude에게 하고 싶다고 상상해 보세요. 여기서 근본적인 문제에 직면하게 됩니다: 문서에서 올바른 정보를 어떻게 Claude에게 전달해야 질문에 효과적으로 답변할 수 있을까요?
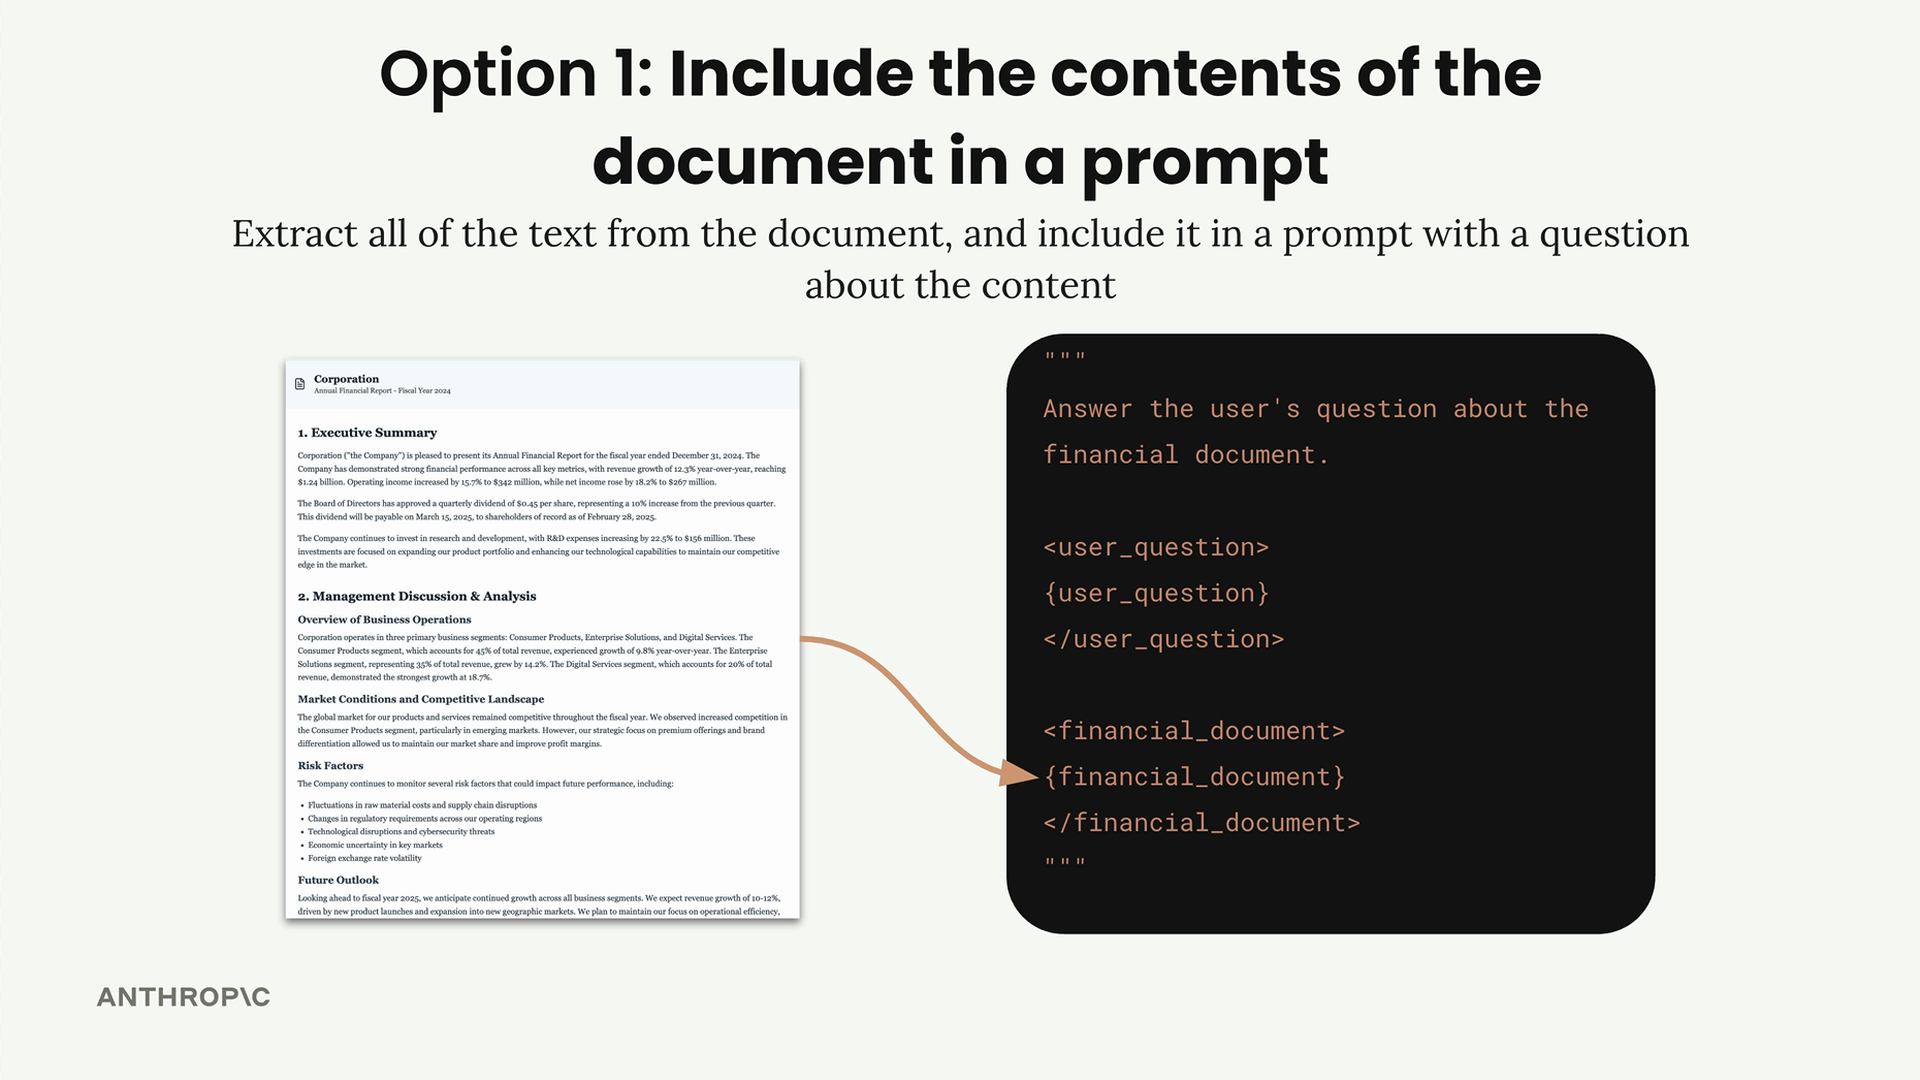
옵션 1: 프롬프트에 모든 내용 포함하기
첫 번째 접근 방식은 간단해 보입니다 - 문서에서 모든 텍스트를 추출하여 사용자의 질문과 함께 프롬프트에 직접 집어넣는 것입니다.
이 접근 방식에는 여러 가지 문제가 있습니다:
- Claude가 처리할 수 있는 텍스트 양에는 엄격한 한계가 있으며, 문서가 너무 길 수 있습니다
- Claude는 매우 긴 프롬프트에서는 효과가 떨어집니다
- 프롬프트가 길어질수록 비용이 더 많이 들고 처리 시간도 더 오래 걸립니다
옵션 2: 문서를 청크로 나누기
두 번째 접근 방식은 더 정교합니다. 전처리 단계에서 문서를 더 작은 청크로 나눈 다음, 각 사용자 질문과 관련된 청크만 찾아서 포함합니다.
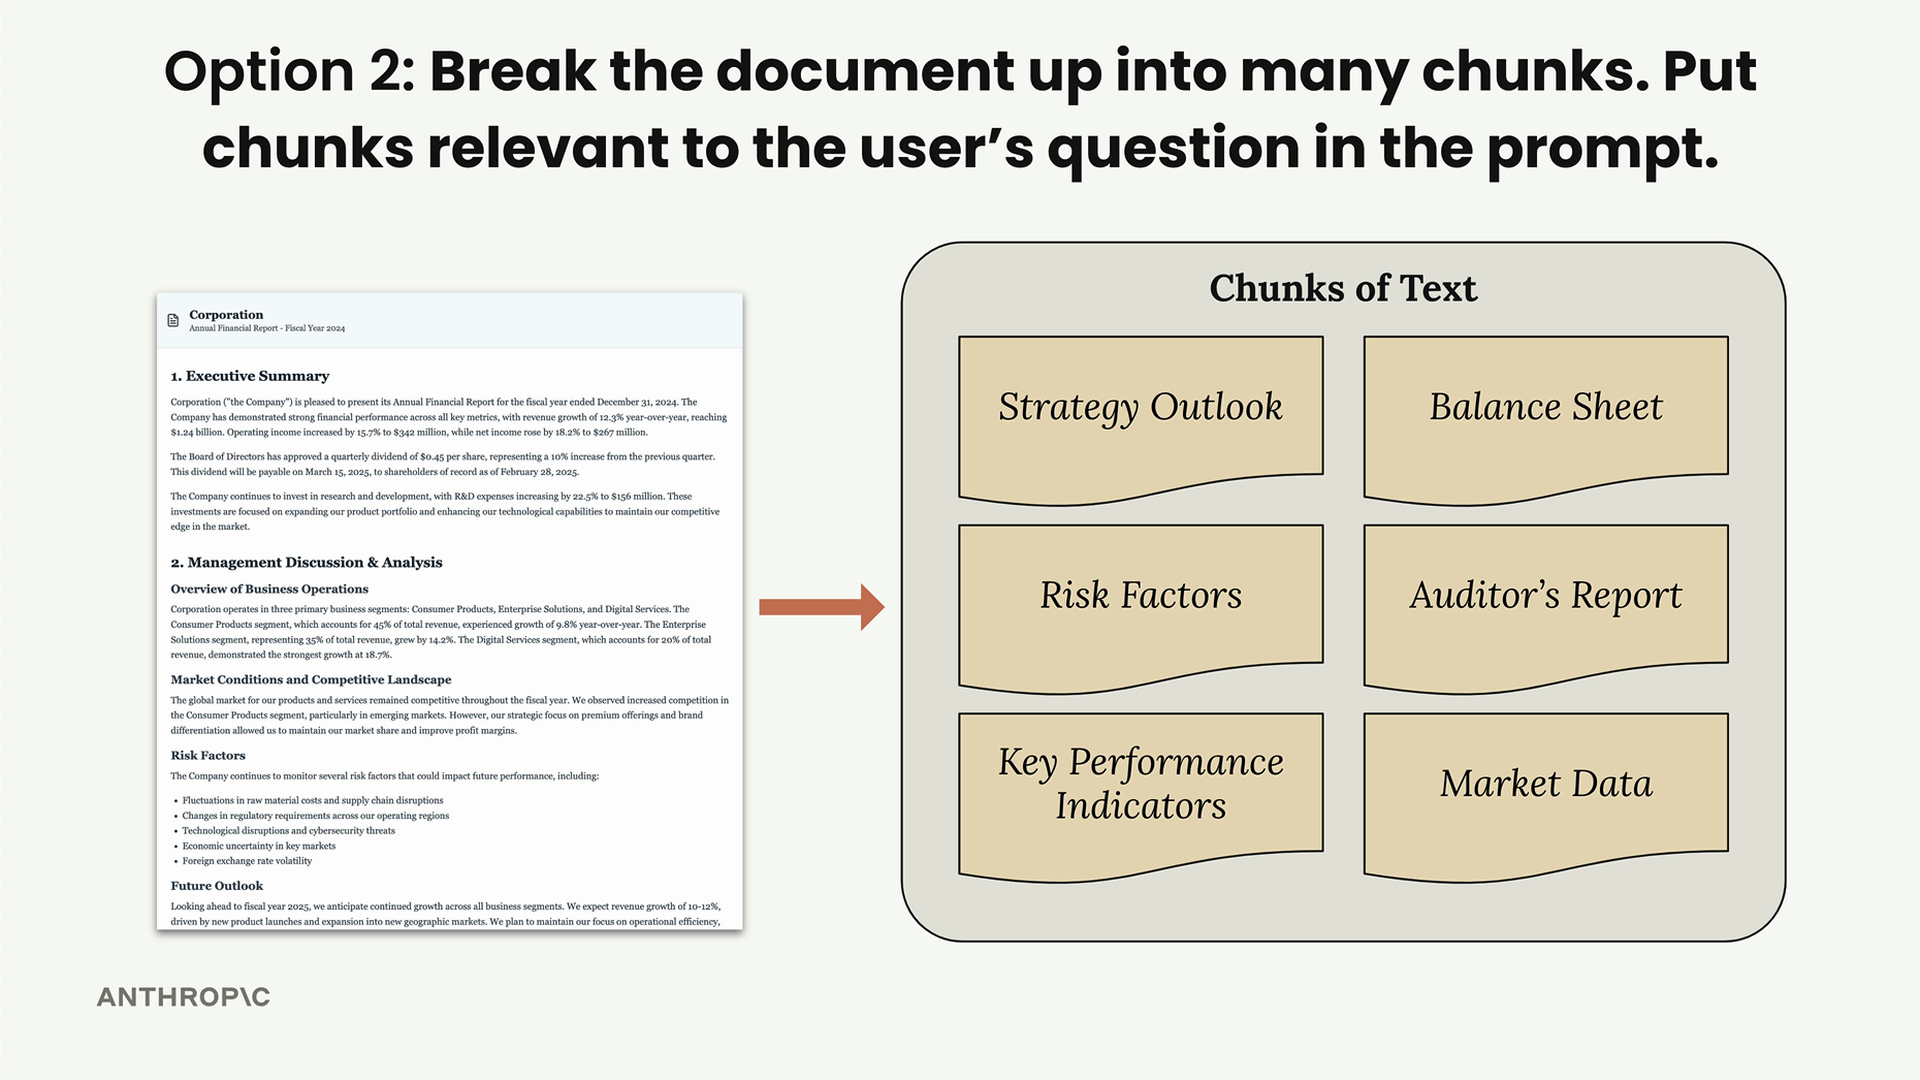
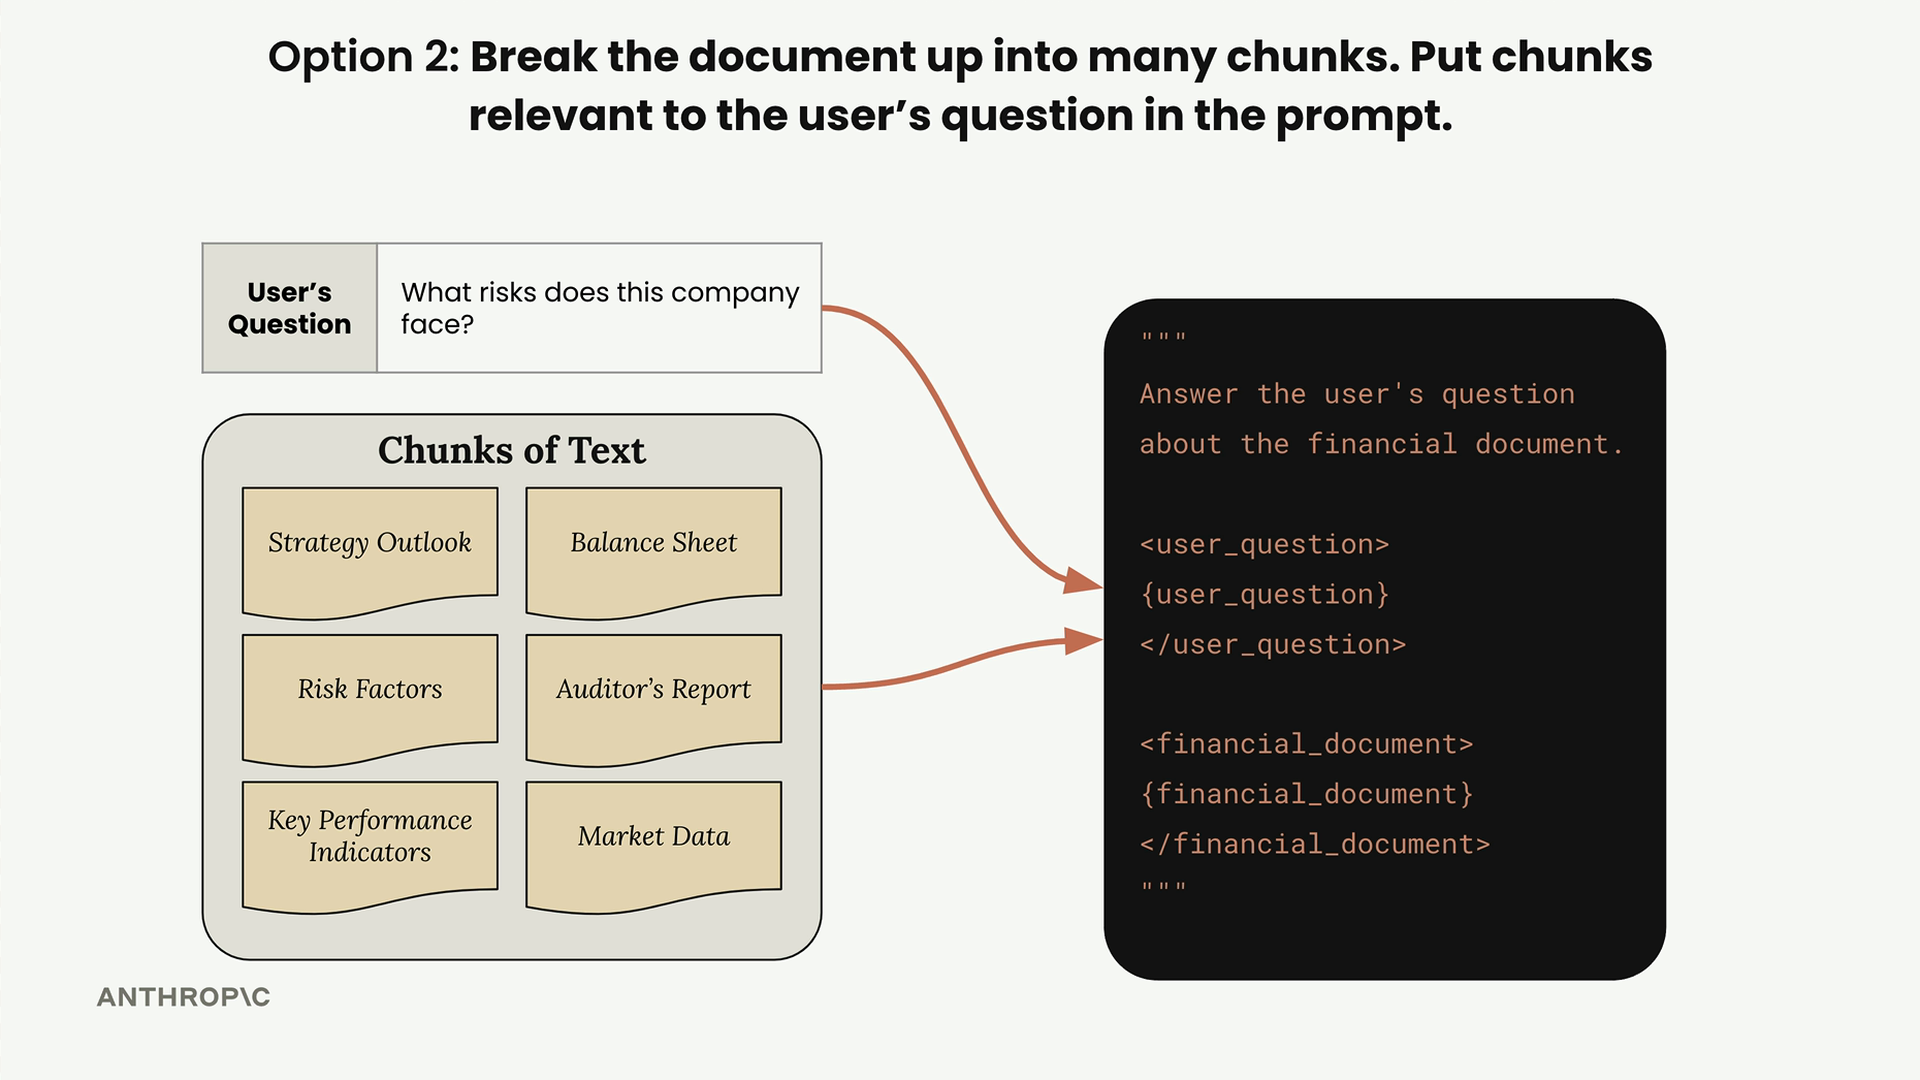
작동 방식은 다음과 같습니다: 사용자가 "이 회사가 직면한 리스크는 무엇인가요?"라고 물으면, 청크들을 검색하여 "Risk Factors"에 관한 청크를 찾아내고, Claude에게 보낼 프롬프트에는 그 섹션만 포함시킵니다.
청킹 방식의 이점
- Claude가 가장 관련성 높은 콘텐츠에만 집중할 수 있습니다
- 매우 큰 문서까지 확장 가능합니다
- 여러 문서와 함께 작동합니다
- 프롬프트가 작아지므로 비용이 줄고 속도가 빨라집니다
청킹의 과제
- 문서를 분할하는 전처리 단계가 필요합니다
- "관련성 있는" 청크를 찾기 위한 검색 메커니즘이 필요합니다
- 포함된 청크가 Claude에게 필요한 모든 맥락을 담고 있지 않을 수 있습니다
- 텍스트를 청크로 나누는 방법은 다양한데 - 어떤 방식이 가장 좋을까요?
예를 들어, "Risk Factors" 섹션만 포함하면, 회사가 그 리스크를 어떻게 다룰 계획인지 설명하는 "Strategy Outlook" 섹션의 중요한 맥락을 놓칠 수 있습니다.
이것이 바로 RAG입니다
옵션 2가 바로 검색 증강 생성입니다. 복잡함에도 불구하고, RAG는 대용량 문서를 다루는 데 상당한 이점을 제공하지만, 신중한 고려가 필요한 기술적 과제도 수반합니다.
RAG의 핵심 구성 요소는 다음과 같습니다:
- 문서 전처리 및 청킹
- 관련 청크를 찾는 검색 메커니즘
- 프롬프트에 포함할 청크를 지능적으로 선택하는 것
애플리케이션에 RAG를 도입할지 고려할 때는, 해당 사용 사례에서 추가되는 복잡성보다 이점이 더 큰지 평가해야 합니다. 이 기법은 정확하고 맥락에 맞는 답변이 필요한 대규모 문서 컬렉션을 다룰 때 빛을 발하지만, 단순히 전체 문서를 프롬프트에 포함하는 것보다 더 많은 사전 엔지니어링 작업이 필요합니다.