이제 RAG, 텍스트 청킹, 임베딩의 기본을 살펴봤으니, 전체 RAG 파이프라인을 단계별로 살펴보겠습니다. 이 상세한 예제를 통해 실제 구현에서 모든 구성 요소가 어떻게 맞물리는지 정확히 확인할 수 있습니다.
1단계: 소스 텍스트 청킹하기
먼저, 소스 문서를 가져와서 관리하기 쉬운 청크로 나눕니다. 이 예제에서는 두 개의 간단한 텍스트 섹션을 사용하겠습니다:
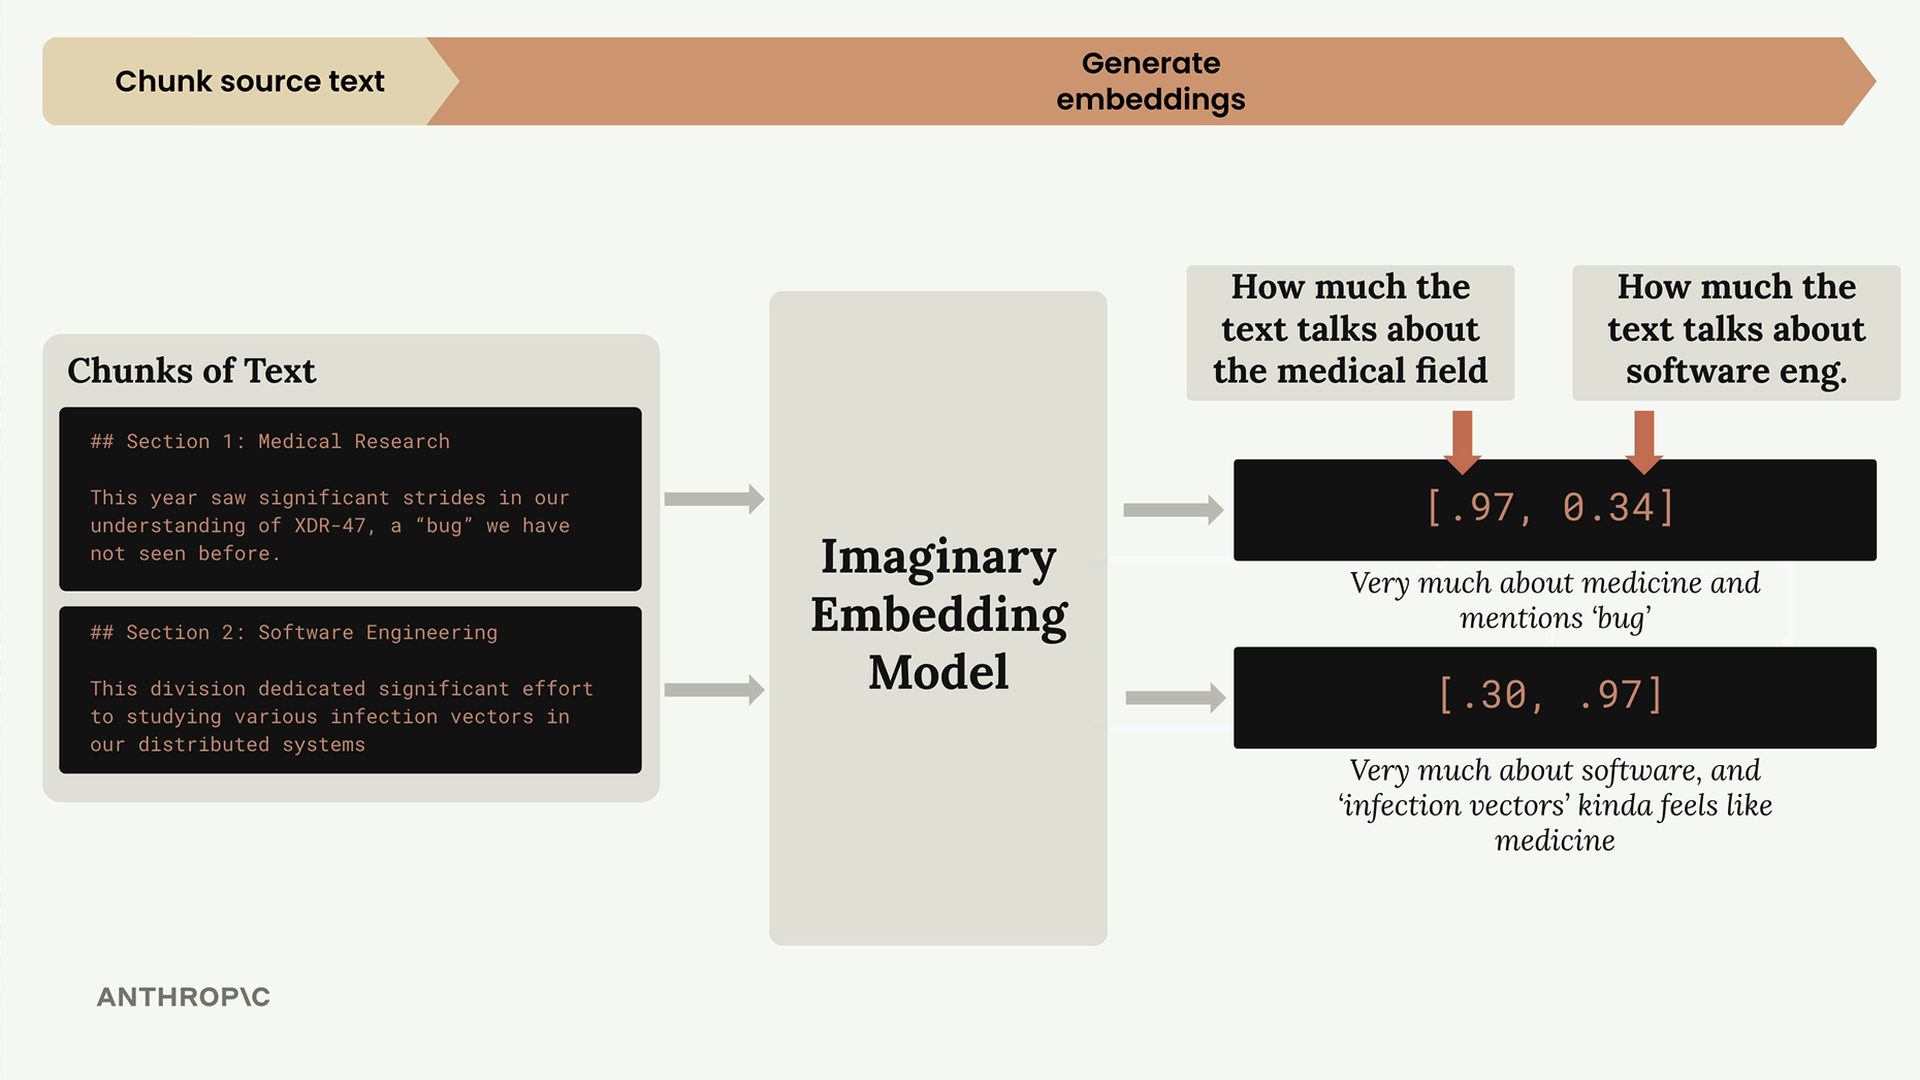
- 섹션 1: 의학 연구 - "올해는 이전에 본 적 없는 '버그'인 XDR-47에 대한 이해에서 상당한 진전이 있었습니다."
- 섹션 2: 소프트웨어 엔지니어링 - "이 부서는 분산 시스템 내 다양한 감염 경로를 연구하는 데 상당한 노력을 기울였습니다"
2단계: 임베딩 생성하기
다음으로, 각 텍스트 청크를 숫자 임베딩으로 변환합니다. 이 개념을 명확히 하기 위해, 항상 정확히 두 개의 숫자를 반환하는 완벽한 임베딩 모델이 있고, 각 숫자가 무엇을 의미하는지 알고 있다고 가정해 보겠습니다:
이 가상의 모델에서:
- 첫 번째 숫자: 텍스트가 의학 분야에 대해 얼마나 이야기하는지
- 두 번째 숫자: 텍스트가 소프트웨어 엔지니어링에 대해 얼마나 이야기하는지
따라서 우리의 의학 연구 섹션은 [0.97, 0.34]라는 임베딩을 얻습니다 - 매우 의학적이지만, "버그"라는 단어 때문에 소프트웨어와도 다소 관련이 있습니다. 소프트웨어 엔지니어링 섹션은 [0.30, 0.97]을 얻습니다 - 매우 소프트웨어 중심이지만, "감염 경로"는 의학적 의미를 가지고 있습니다.
정규화
이러한 임베딩을 저장하기 전에, 각 벡터의 크기를 1.0으로 조정하는 정규화 과정을 거칩니다. 이 과정은 일반적으로 임베딩 API가 자동으로 처리하지만, 이런 일이 일어난다는 것을 이해하는 것이 중요합니다.
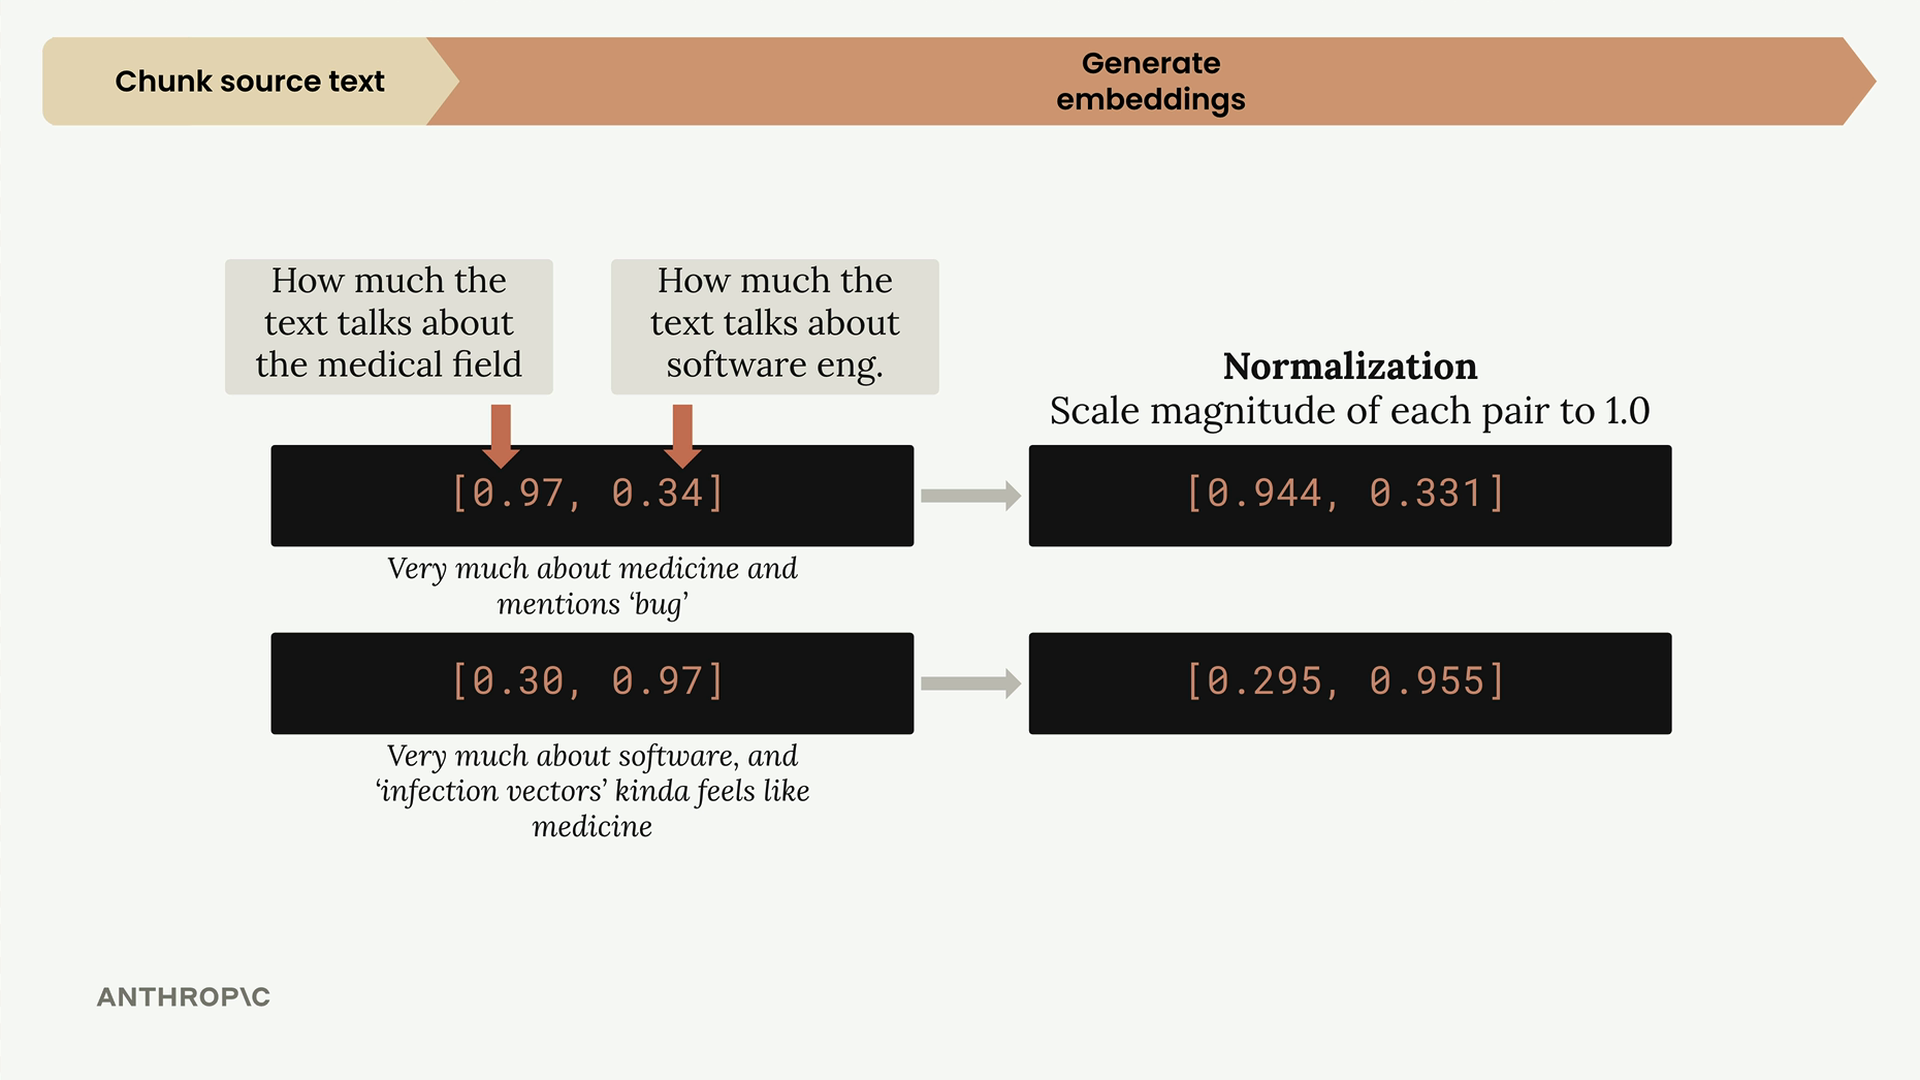
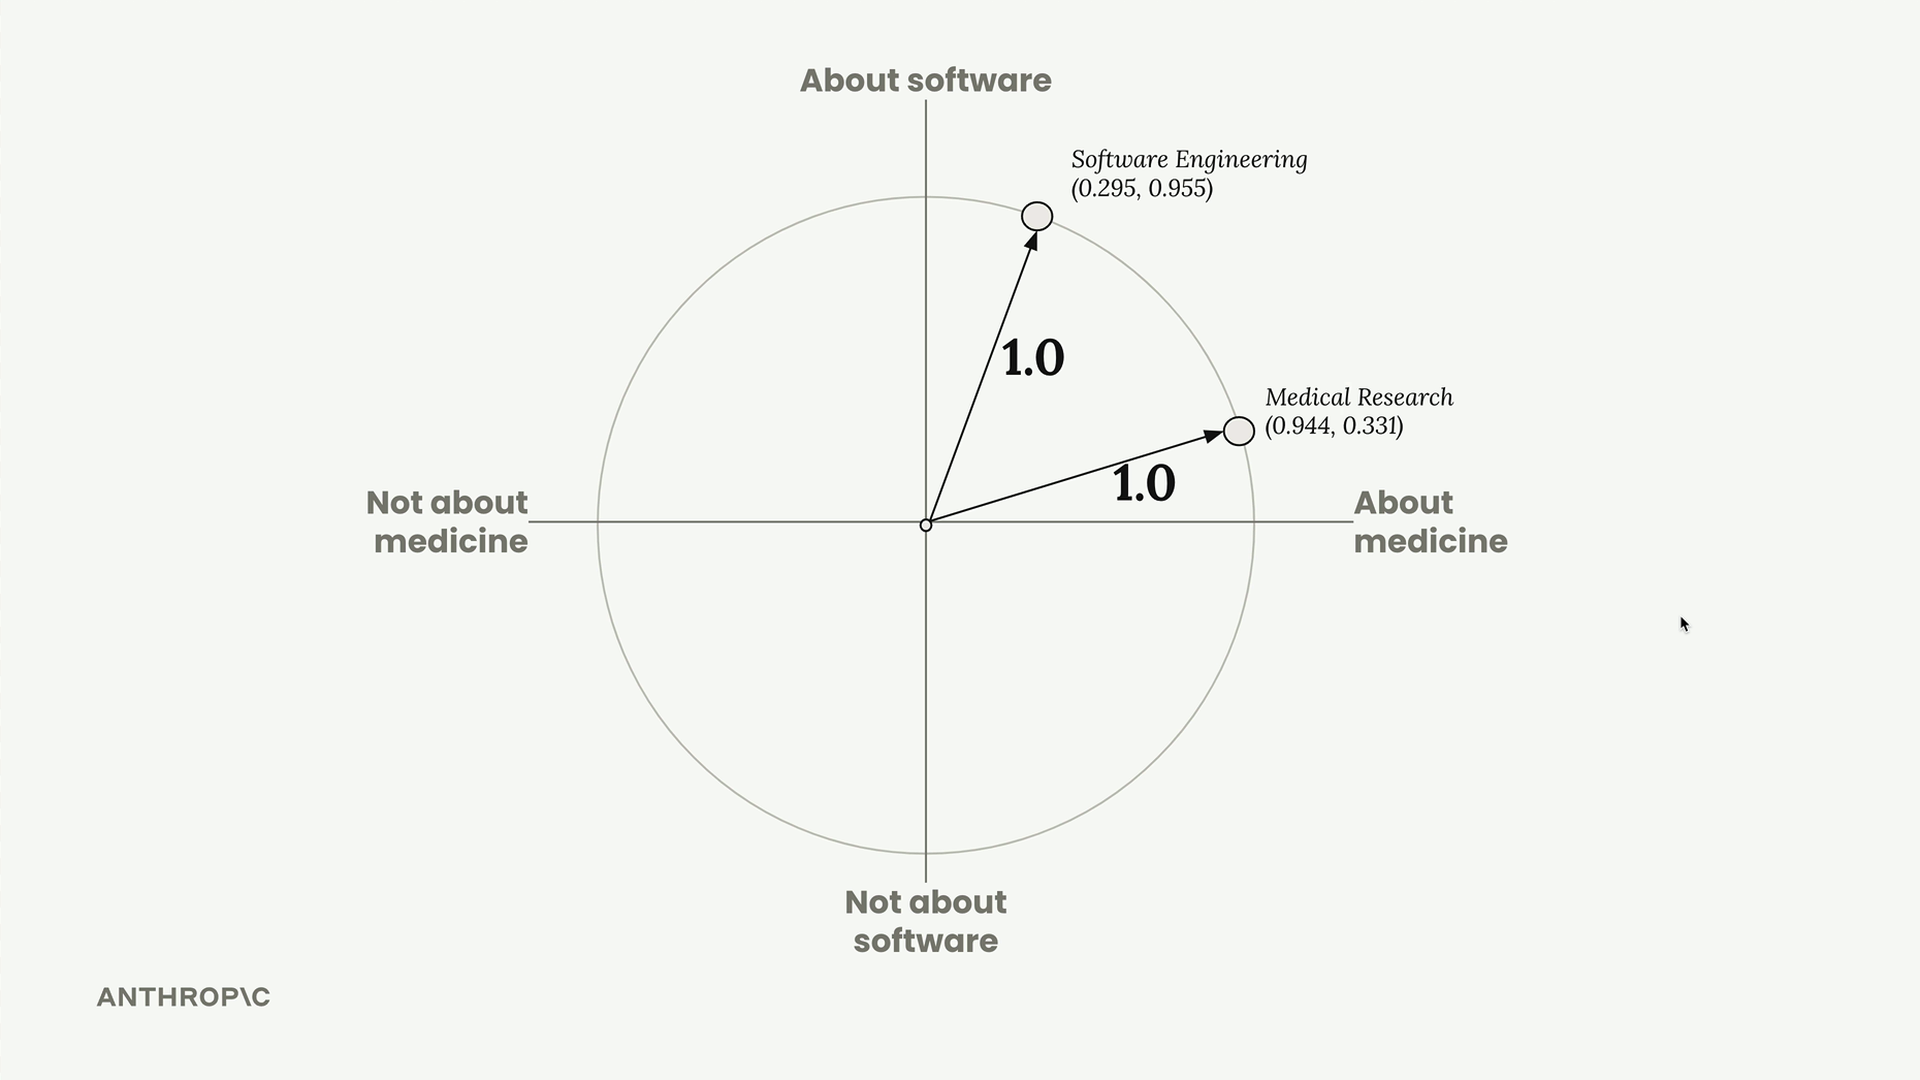
정규화 후, 우리의 임베딩은 [0.944, 0.331]과 [0.295, 0.955]가 됩니다. 각 점이 원의 가장자리에 정확히 위치하는 단위 원 위에서 이것들을 시각화할 수 있습니다.
3단계: 벡터 데이터베이스에 저장하기
정규화된 임베딩은 벡터 데이터베이스에 저장됩니다 - 벡터 데이터베이스는 우리의 임베딩과 같은 긴 숫자 목록을 저장, 비교, 검색하는 데 최적화된 전문 데이터베이스입니다.
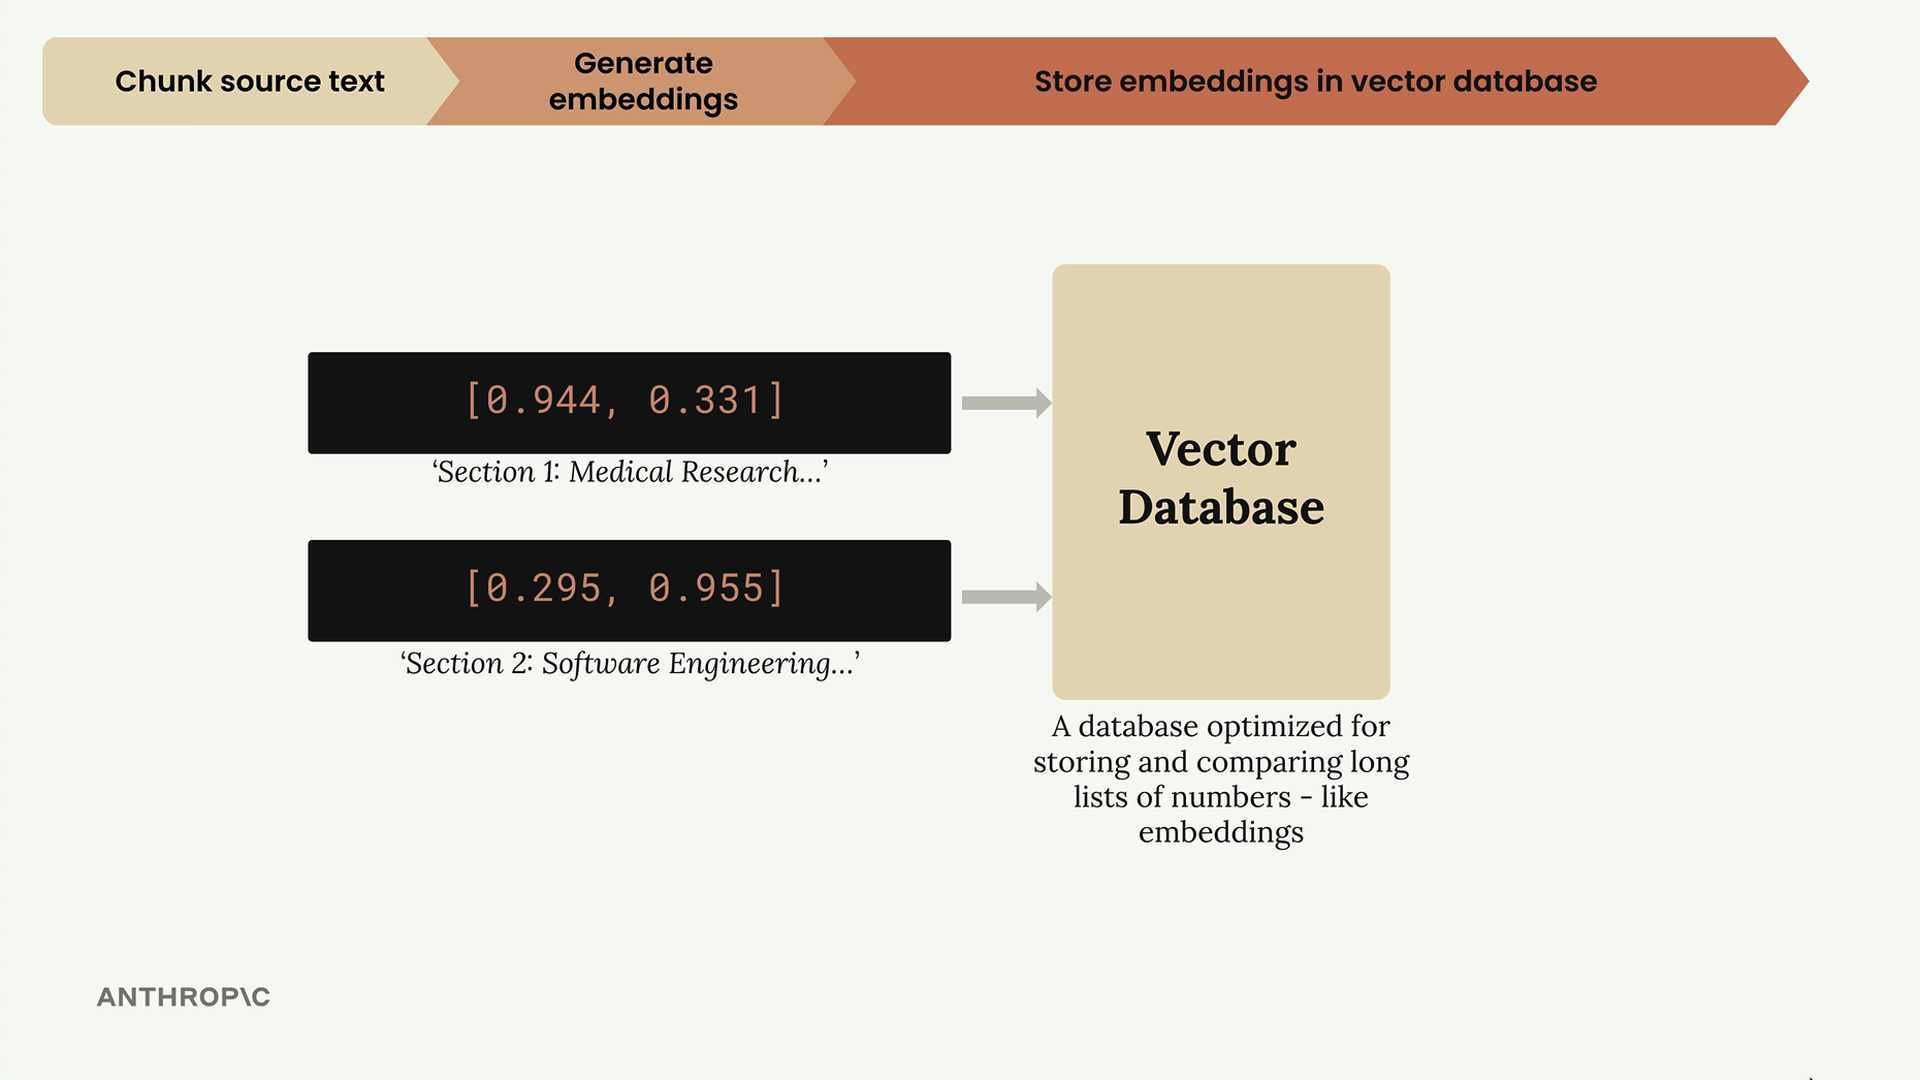
이 시점에서 우리는 잠시 멈춥니다. 지금까지의 모든 작업은 미리 이루어지는 전처리였습니다. 이제 사용자가 쿼리를 제출하기를 기다립니다.
4단계: 사용자 쿼리 처리하기
사용자가 "회사에 대해 궁금한데요. 특히, 소프트웨어 엔지니어링 부서는 올해 무엇을 했나요?"와 같은 질문을 하면, 동일한 임베딩 모델을 통해 그들의 쿼리를 실행합니다.
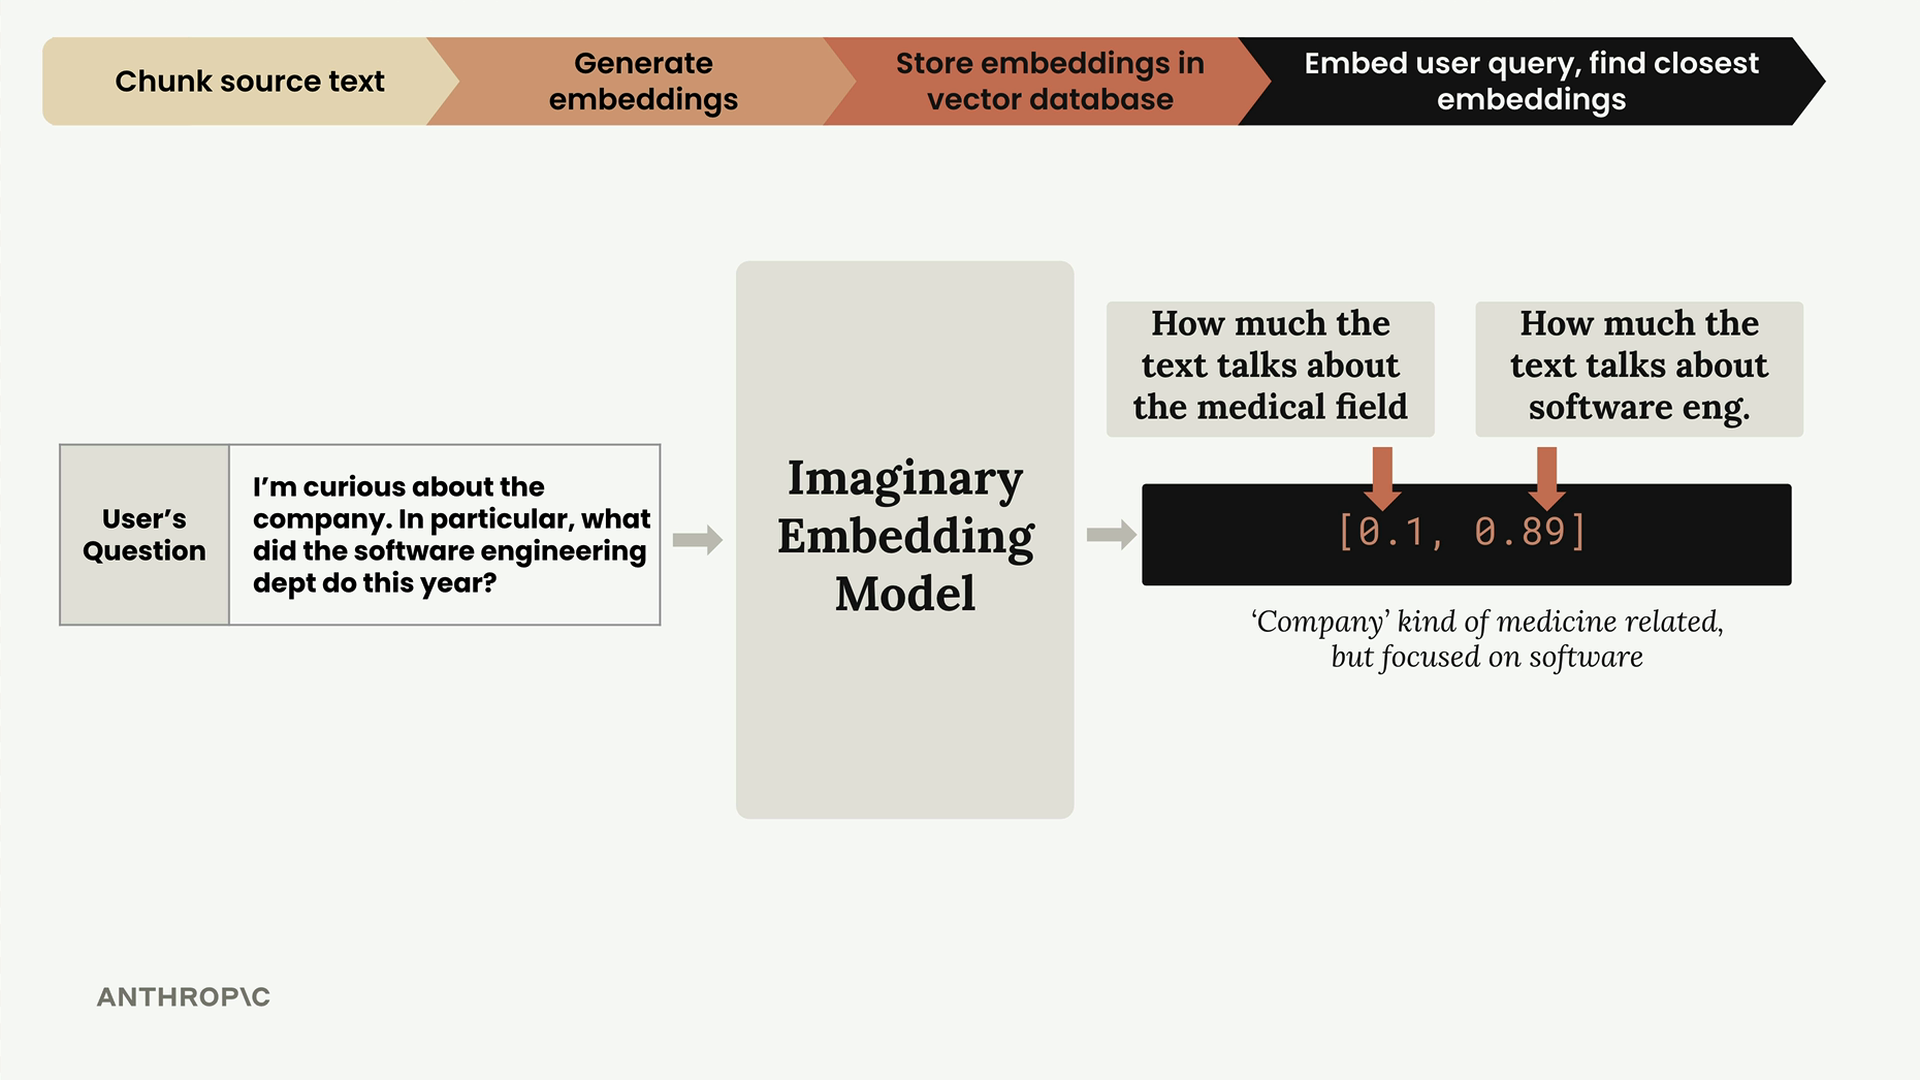
이 쿼리는 [0.1, 0.89]로 임베딩됩니다 - 낮은 의학 점수, 높은 소프트웨어 엔지니어링 점수. 정규화 후, 이것은 [0.112, 0.993]이 됩니다.
5단계: 유사한 임베딩 찾기
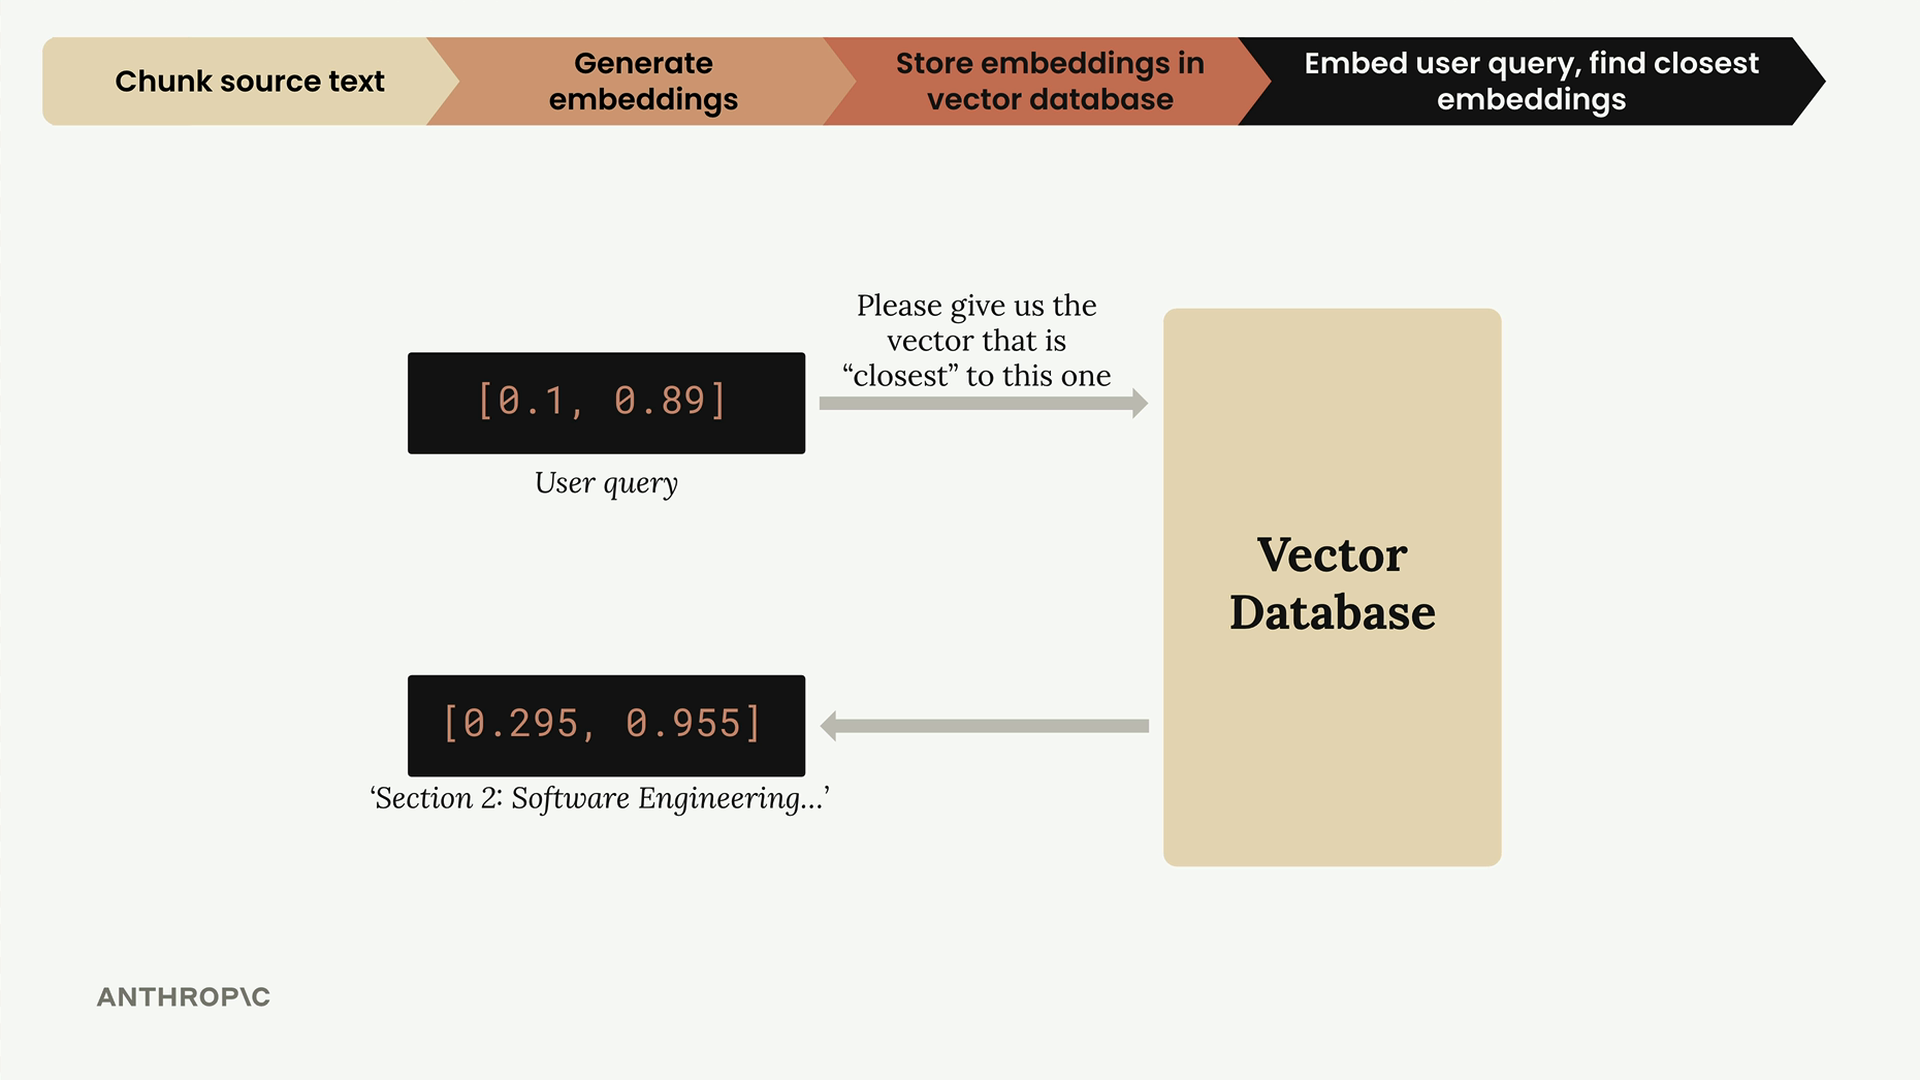
이제 벡터 데이터베이스에게 다음과 같이 묻습니다: "이 사용자 쿼리 임베딩과 가장 가까운 저장된 임베딩을 찾아라." 데이터베이스는 가장 유사하기 때문에 소프트웨어 엔지니어링 섹션을 반환합니다.
유사도 작동 방식: 코사인 유사도
벡터 데이터베이스는 어떤 임베딩이 가장 유사한지 판단하기 위해 코사인 유사도를 사용합니다. 이것은 두 벡터 사이의 각도의 코사인을 측정합니다.
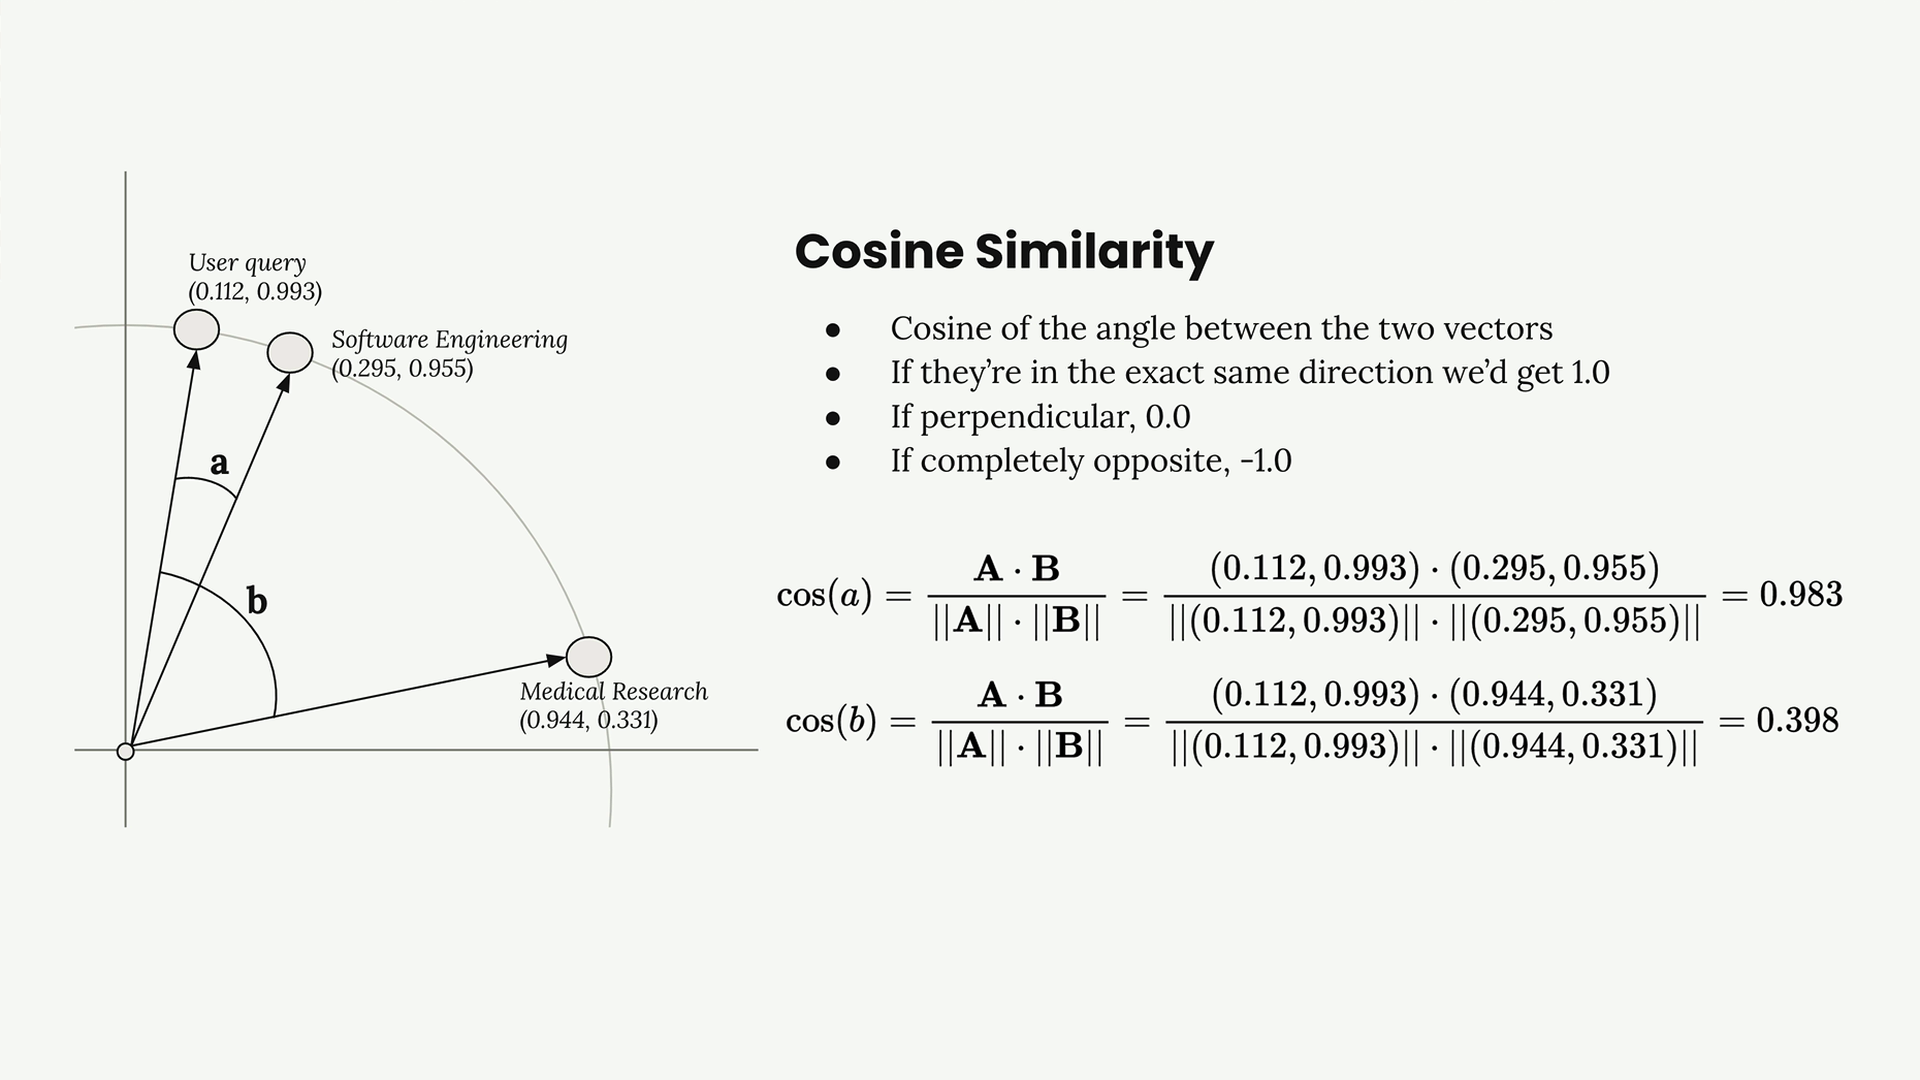
코사인 유사도에 관한 핵심 포인트:
- 결과는 -1에서 1 사이의 범위를 가집니다
- 1에 가까운 값은 매우 유사함을 의미합니다
- 0에 가까운 값은 수직(관련 없음)을 의미합니다
- -1에 가까운 값은 완전히 반대임을 의미합니다
계산에는 내적 공식이 사용됩니다: cos(a) = (A · B) / (||A|| · ||B||)
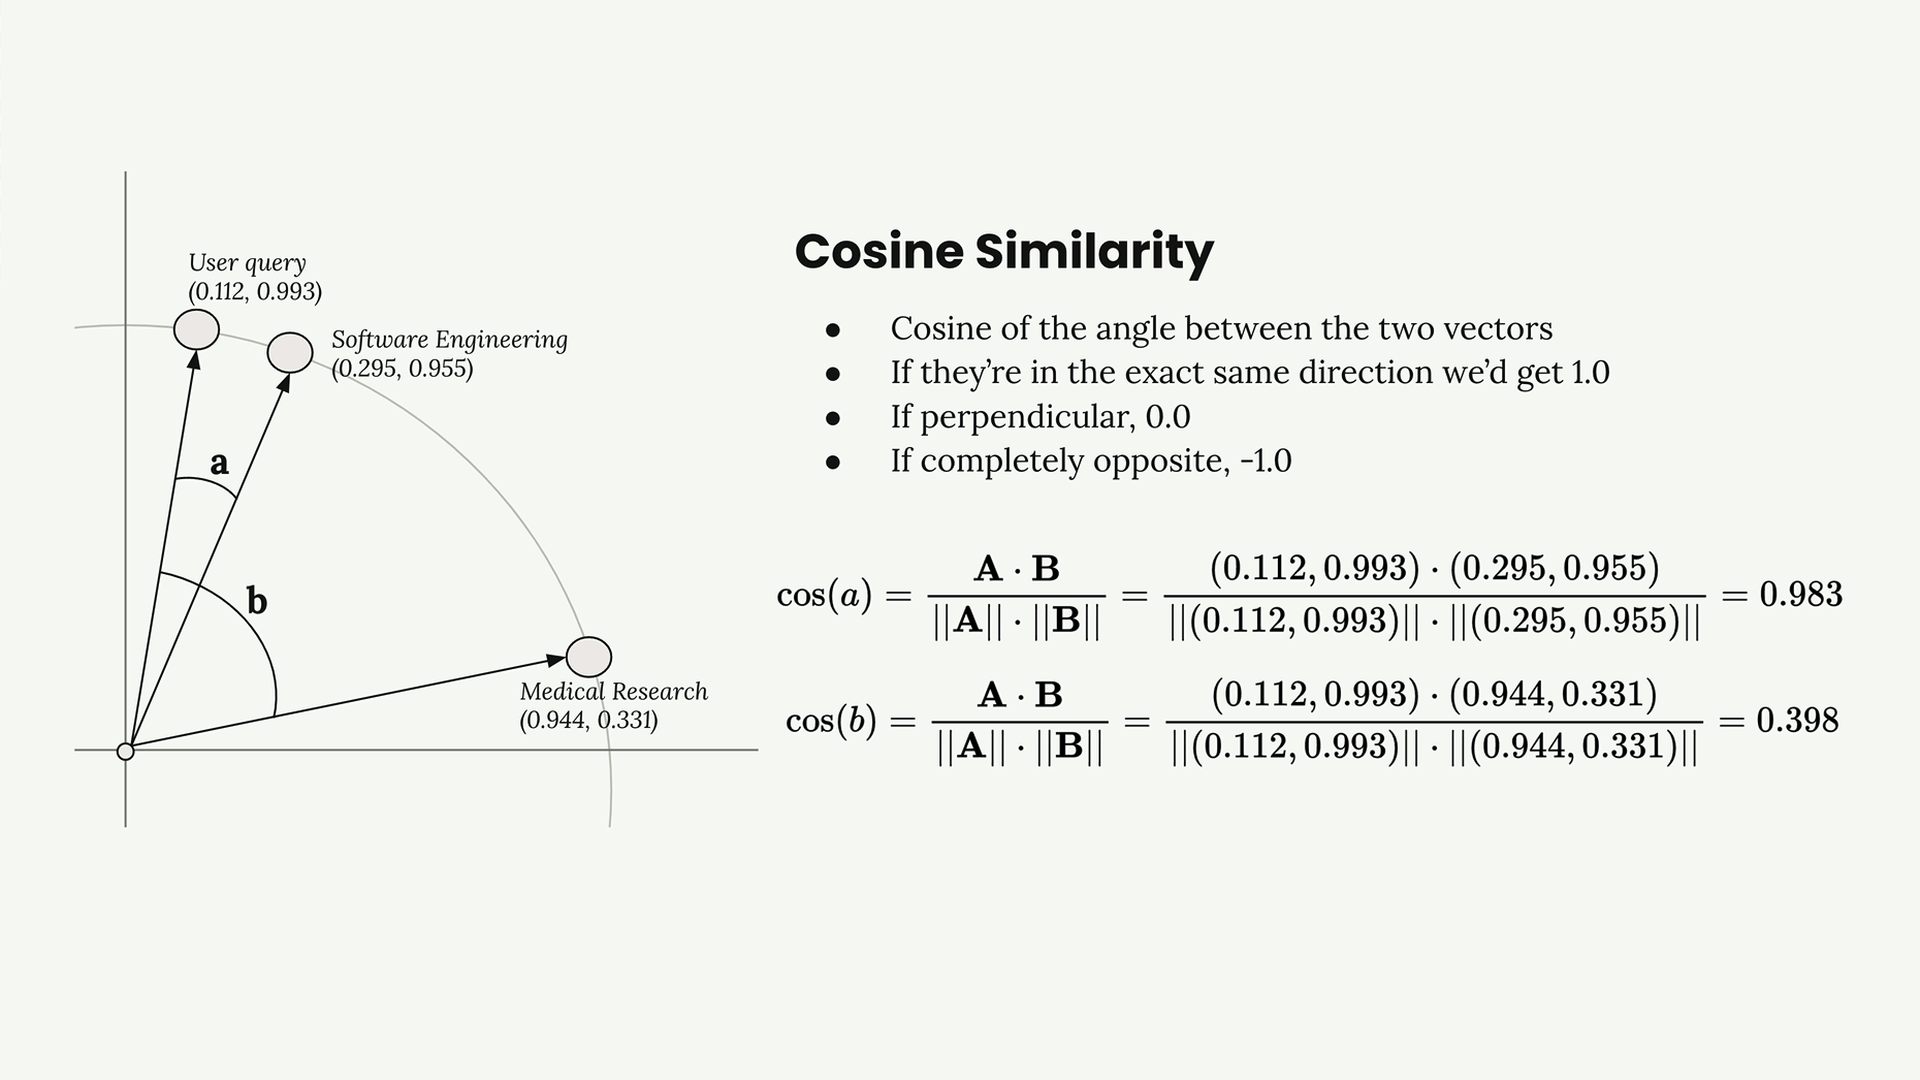
이 예제에서, 사용자 쿼리는 소프트웨어 엔지니어링 청크와 0.983의 코사인 유사도를 가지며, 의학 연구 청크와는 0.398에 불과합니다. 소프트웨어 엔지니어링 청크가 분명히 더 나은 일치입니다.
코사인 거리
벡터 데이터베이스 문서에서 "코사인 거리"를 자주 보게 될 것입니다. 이것은 단순히 1 - 코사인 유사도로, 다음과 같이 해석하기 더 쉬운 숫자를 제공합니다:
- 0에 가까운 값은 높은 유사도를 의미합니다
- 더 큰 값은 더 낮은 유사도를 의미합니다
6단계: 최종 프롬프트 만들기
마지막으로, 사용자의 질문과 우리가 찾은 가장 관련성 높은 텍스트 청크를 가져와서, 이를 결합하여 Claude를 위한 프롬프트를 만듭니다:
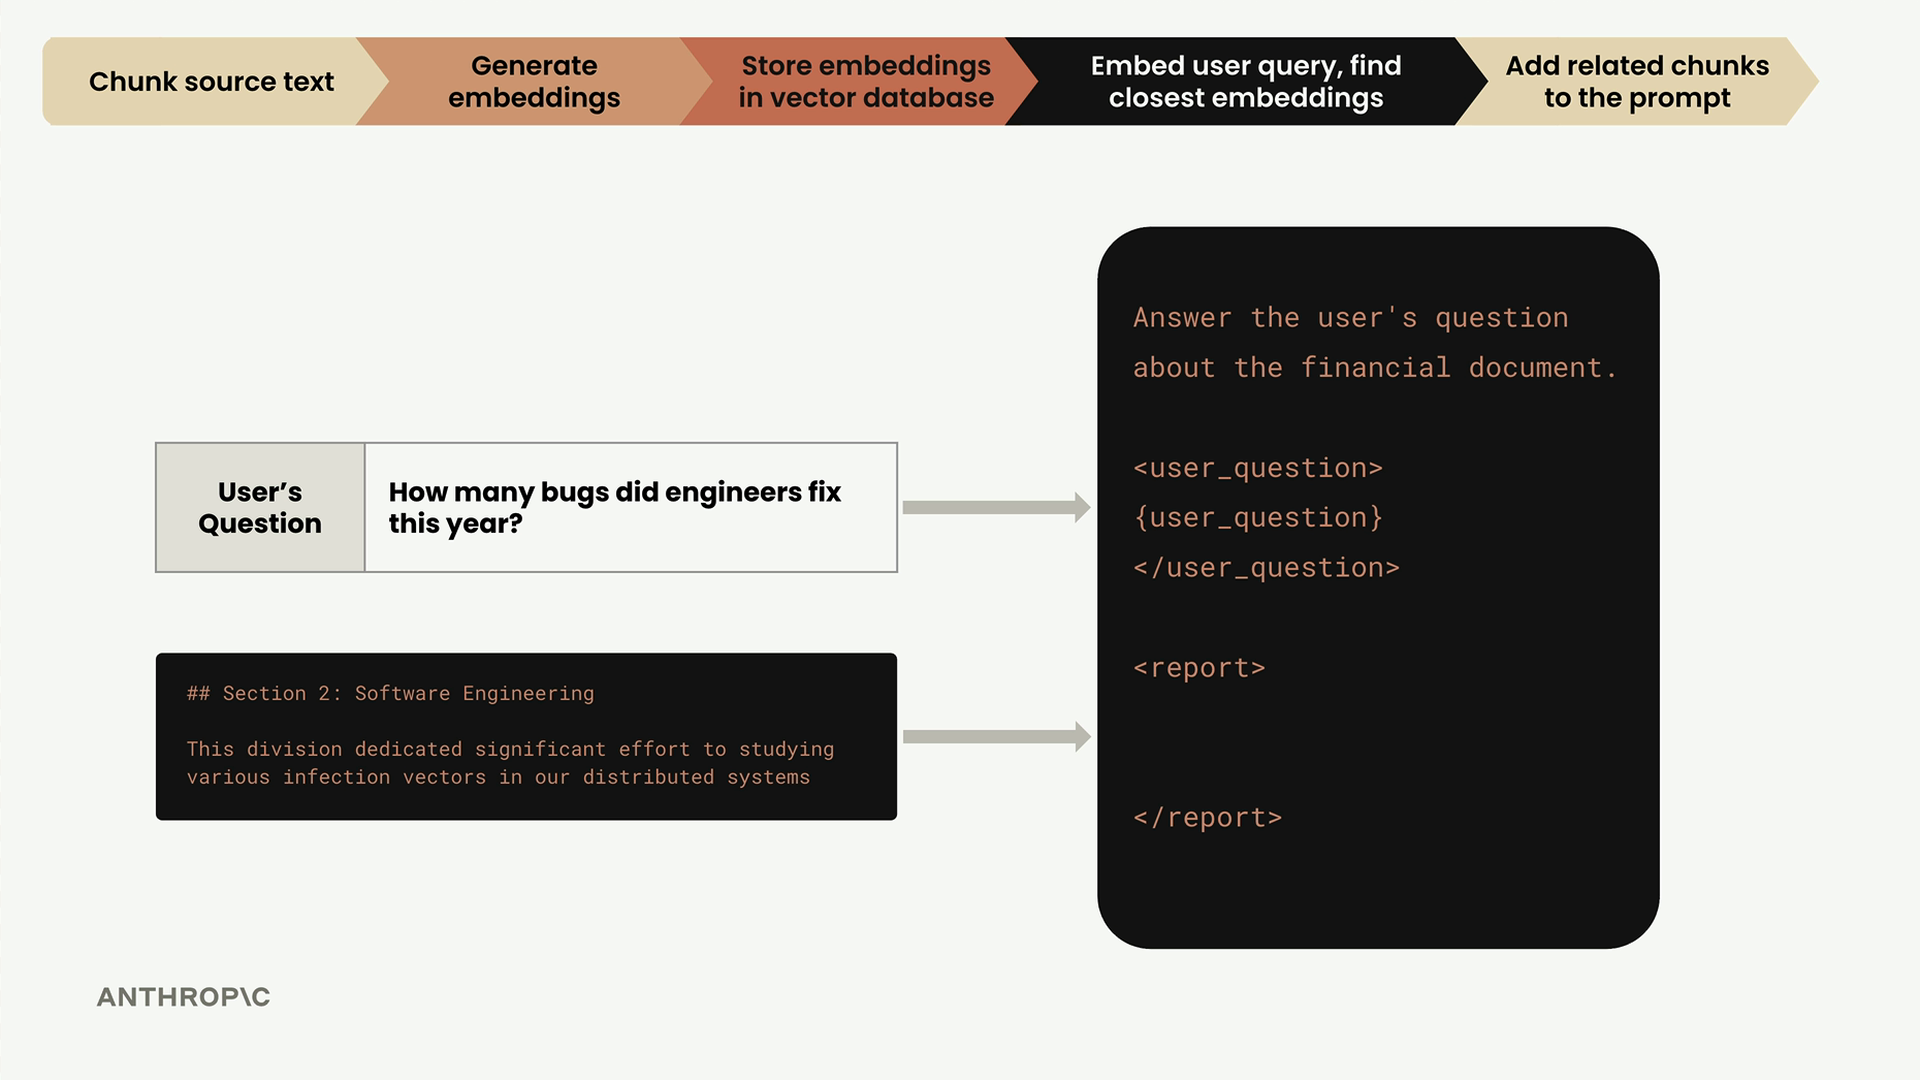
이 프롬프트는 사용자의 질문과 우리 문서에서 찾은 관련 컨텍스트를 모두 포함하여, Claude가 지식 베이스의 구체적인 정보를 바탕으로 잘 알고 답변할 수 있게 해줍니다.
전체 흐름
이것이 처음부터 끝까지의 전체 RAG 파이프라인입니다:
- 소스 문서를 청킹합니다
- 각 청크에 대한 임베딩을 생성합니다
- 임베딩을 벡터 데이터베이스에 저장합니다
- 사용자가 질문을 하면, 그들의 쿼리를 임베딩합니다
- 코사인 유사도를 사용하여 가장 유사한 저장된 임베딩을 찾습니다
- 관련 청크를 사용자의 질문과 함께 프롬프트에 추가합니다
- 향상된 프롬프트를 Claude에 보내 응답을 받습니다
이 프로세스와 그 배후의 수학을 이해하면, 벡터 데이터베이스로 효과적으로 작업하고 RAG 시스템이 예상한 결과를 반환하지 않을 때 문제를 디버깅하는 데 도움이 될 것입니다.