AI 모델로 채팅 인터페이스를 구축할 때, 사용자는 완전한 응답을 받기까지 10~30초를 기다리는 대신 응답이 즉시 나타나기를 기대합니다. converse_stream 함수는 텍스트가 생성되는 대로 스트리밍함으로써 이 문제를 해결하여 훨씬 더 나은 사용자 경험을 제공합니다.
스트리밍 작동 방식
전체 응답이 생성될 때까지 기다리는 대신, 스트리밍은 텍스트 조각이 준비되는 즉시 그것을 다시 전송합니다. 흐름이 어떻게 바뀌는지 살펴보겠습니다:
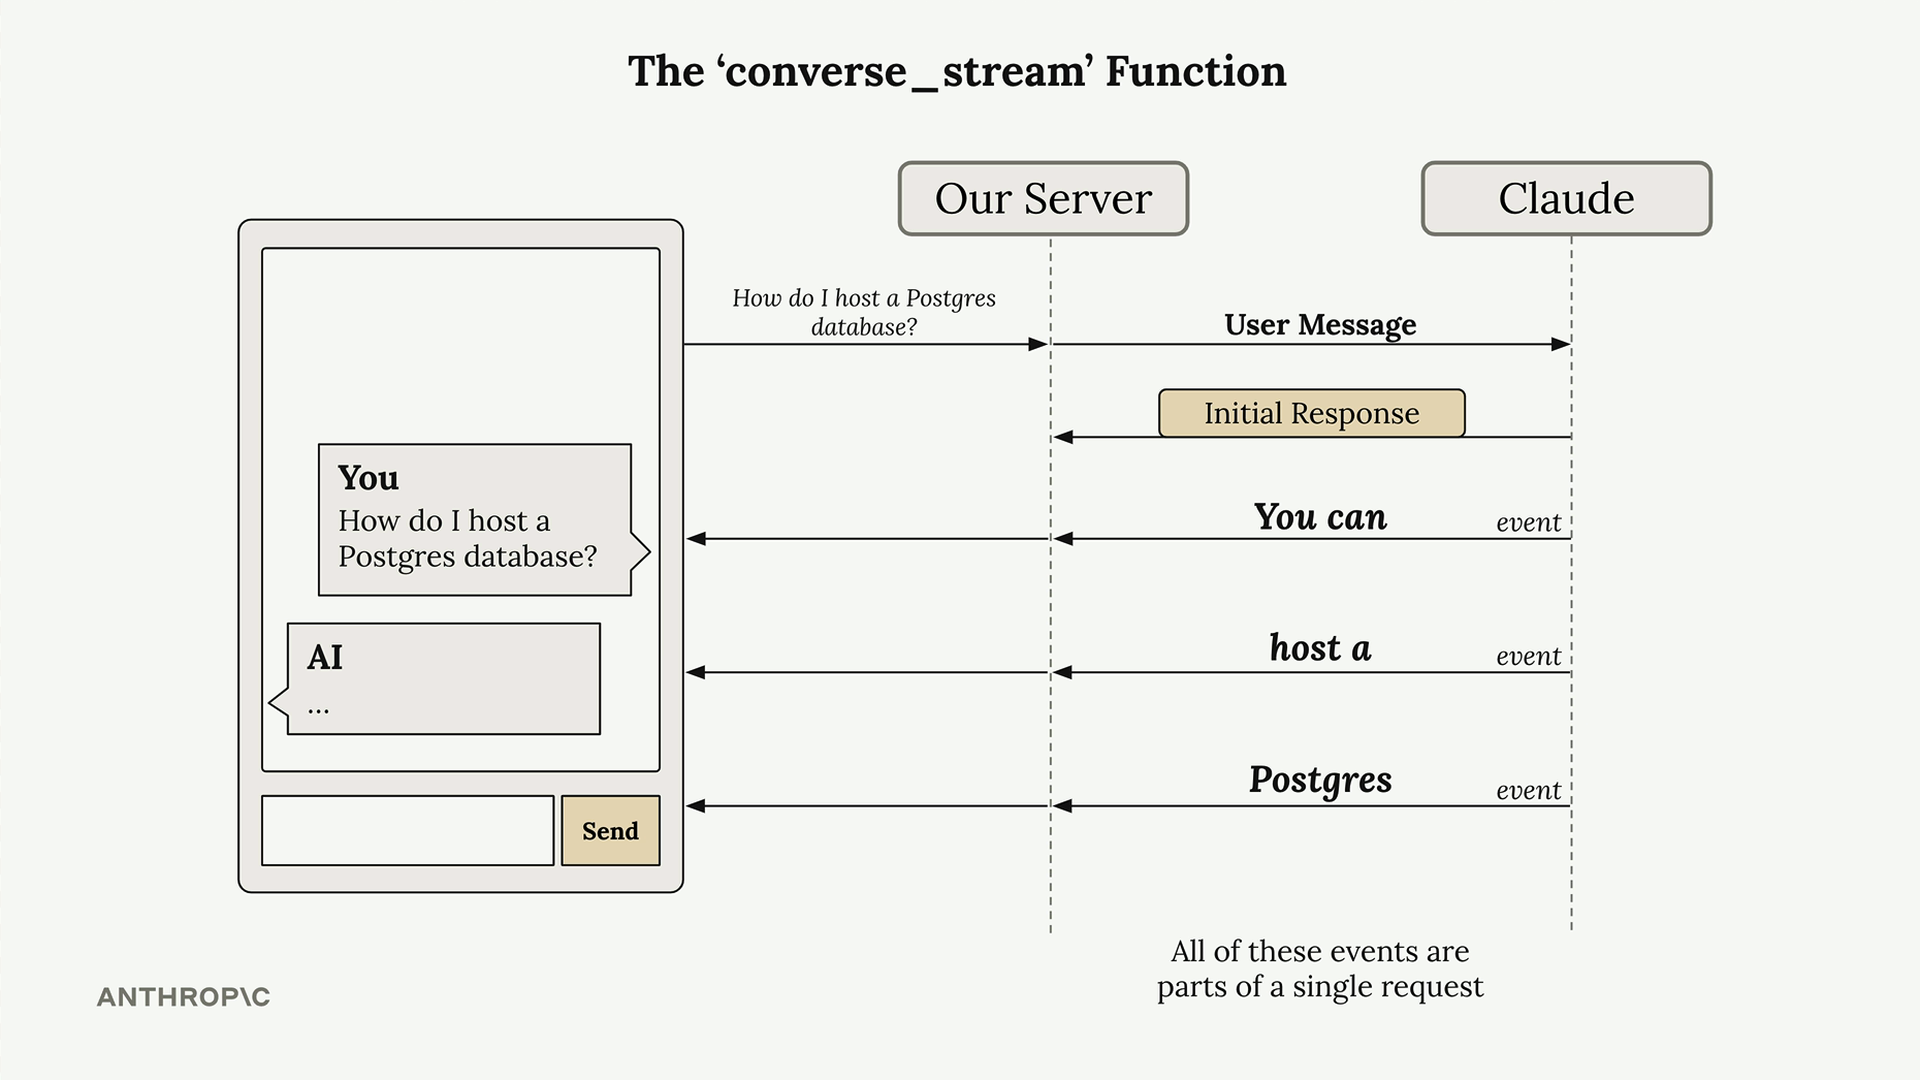
converse_stream을 호출하면, stream 객체를 포함하는 초기 응답을 즉시 받게 됩니다. 이 스트림은 모델이 텍스트를 생성하면서 이벤트를 산출하는 생성기(generator)입니다. 각 이벤트는 전체 응답 중 작은 조각을 포함합니다.
기본 구현
다음은 코드에서 converse_stream을 사용하는 방법입니다:
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")
response = client.converse_stream(messages=messages, modelId=model_id)

for event in response["stream"]:
    print(event)
이렇게 하면 이벤트들이 도착하는 대로 다양한 종류의 이벤트가 모두 출력됩니다. 응답이 한 번에 오지 않고 청크(chunk) 단위로 들어오는 것을 볼 수 있습니다.
스트림 이벤트 이해하기
스트림은 각각 다른 목적을 수행하는 여러 유형의 이벤트를 산출합니다:
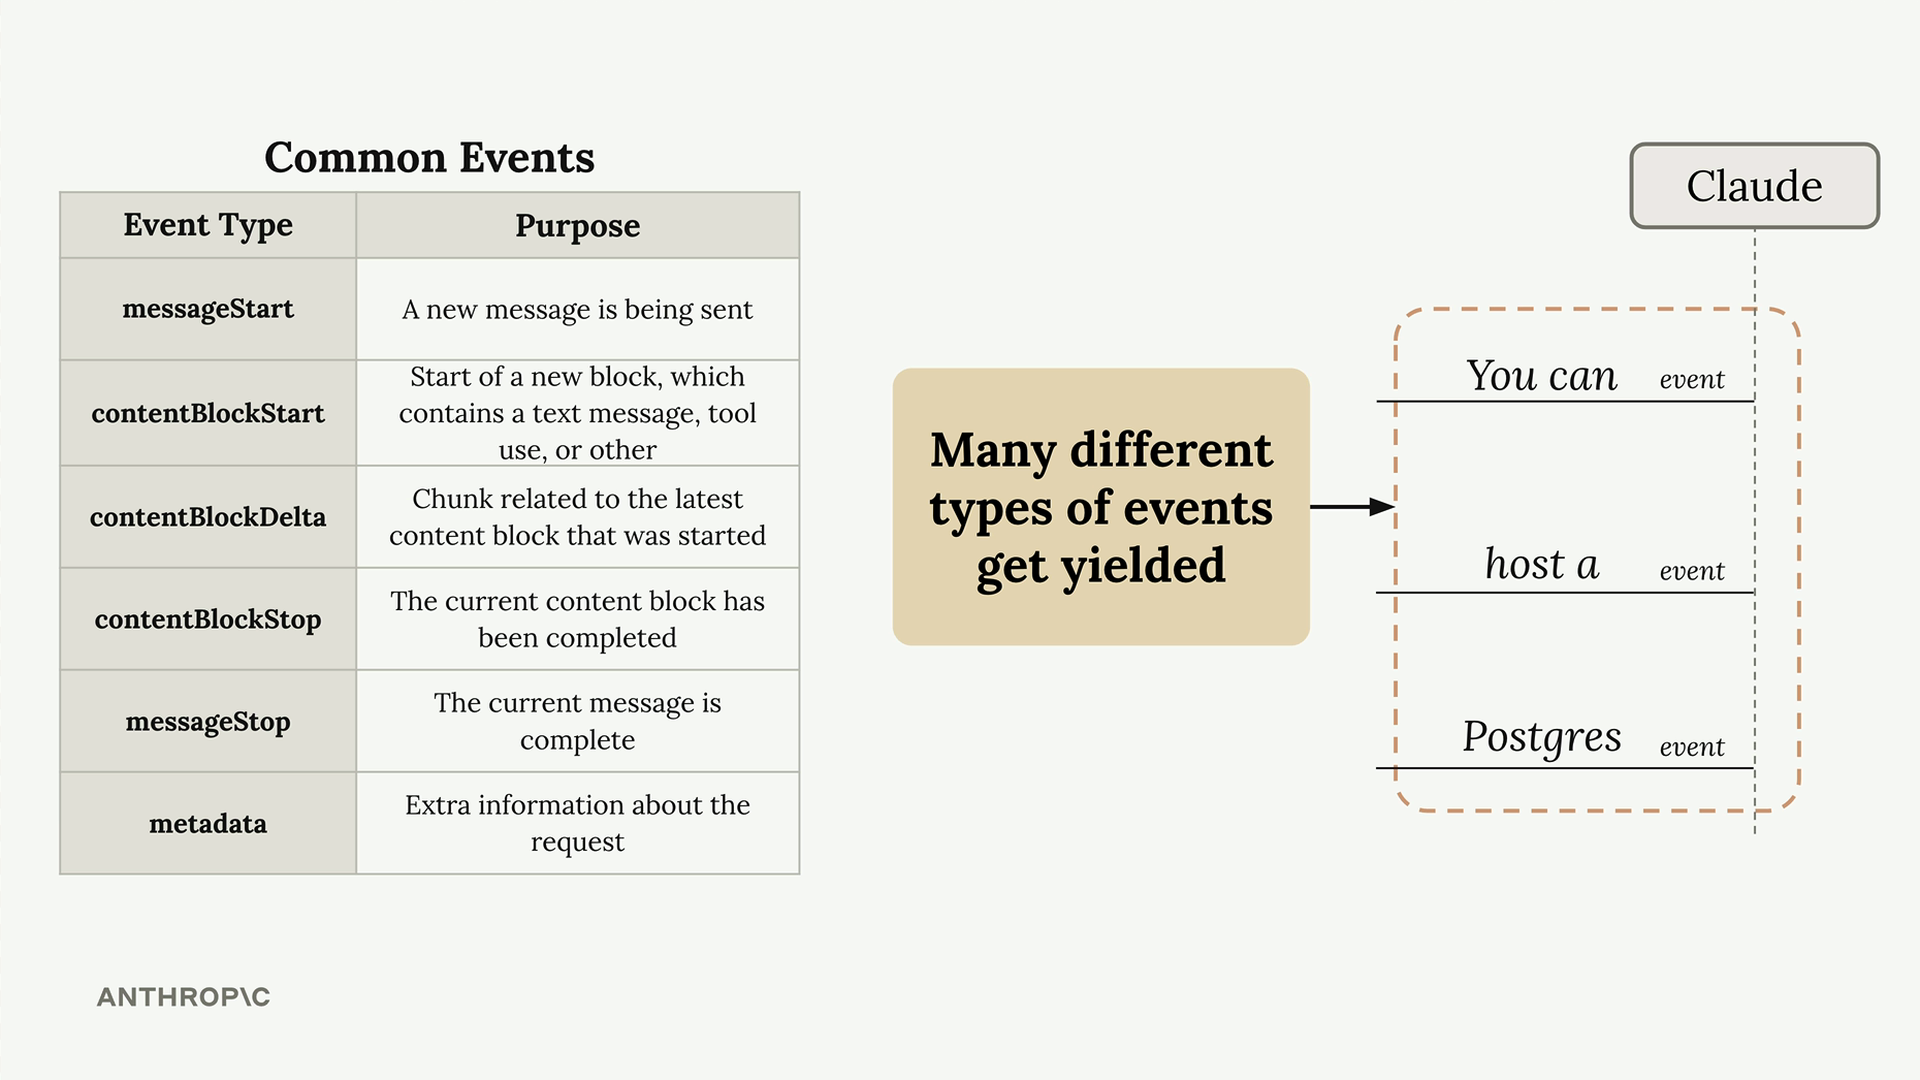
기본적인 텍스트 생성의 경우, contentBlockDelta 이벤트에만 신경 쓰면 됩니다. 이 이벤트들에는 사용자에게 표시하고자 하는 실제 생성된 텍스트 청크가 포함되어 있습니다.
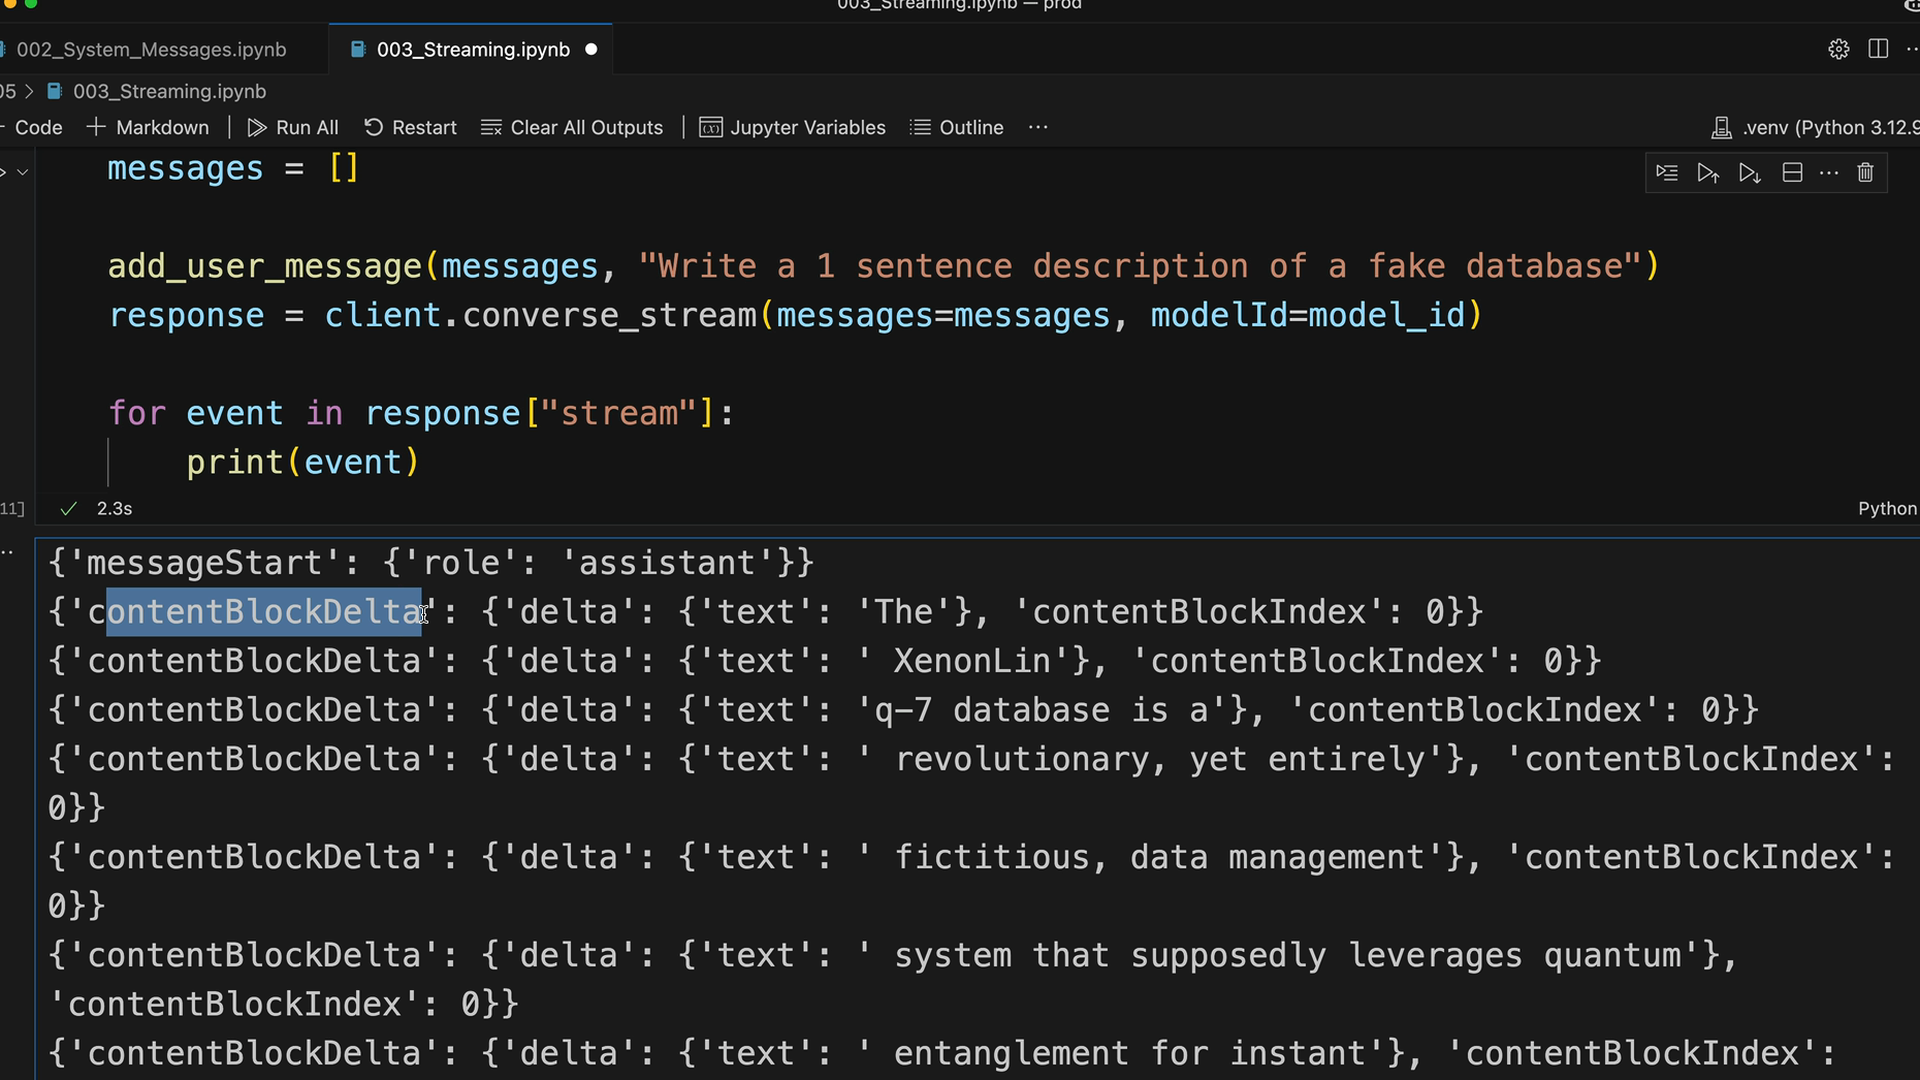
이벤트는 항상 예측 가능한 순서로 도착합니다: messageStart, 텍스트를 담은 다수의 contentBlockDelta 이벤트, 그 다음 contentBlockStop, messageStop, 그리고 마지막으로 metadata입니다.
텍스트 추출하기
각 청크에서 생성된 텍스트만 얻으려면, contentBlockDelta 이벤트를 필터링하여 텍스트를 추출하세요:
text = ""
for event in response["stream"]:
    if "contentBlockDelta" in event:
        chunk = event["contentBlockDelta"]["delta"]["text"]
        print(chunk, end="")
        text += chunk

print("\n\nTotal Message:\n" + text)
end="" 매개변수는 Python의 print 함수가 추가하는 자동 줄바꿈을 제거하여, 스트리밍 텍스트가 더 자연스럽게 보이도록 합니다.
실제 적용 사례
실제 애플리케이션에서는 각 청크를 출력하는 대신, 일반적으로 다음과 같은 작업을 수행합니다:
- WebSocket이나 Server-Sent Events를 통해 각 청크를 프런트엔드로 전송
- 점점 늘어나는 응답을 실시간으로 표시하도록 UI를 업데이트
- 스트리밍이 끝나면 완전한 메시지를 저장
- 스트리밍 중 발생할 수 있는 오류 처리
이러한 스트리밍 방식은 사용자 경험을 "제출하고 기다리기"에서 "제출하고 응답이 나타나는 것을 지켜보기"로 전환시켜, AI 기반 애플리케이션을 훨씬 더 반응성 있고 몰입감 있게 느껴지도록 만들어 줍니다.