컨텍스트 검색(Contextual retrieval)은 근본적인 문제를 해결함으로써 RAG 파이프라인의 정확도를 향상시키는 기법입니다: 문서를 청크로 나누면 각 청크는 더 넓은 문서 맥락과의 연결을 잃게 됩니다.
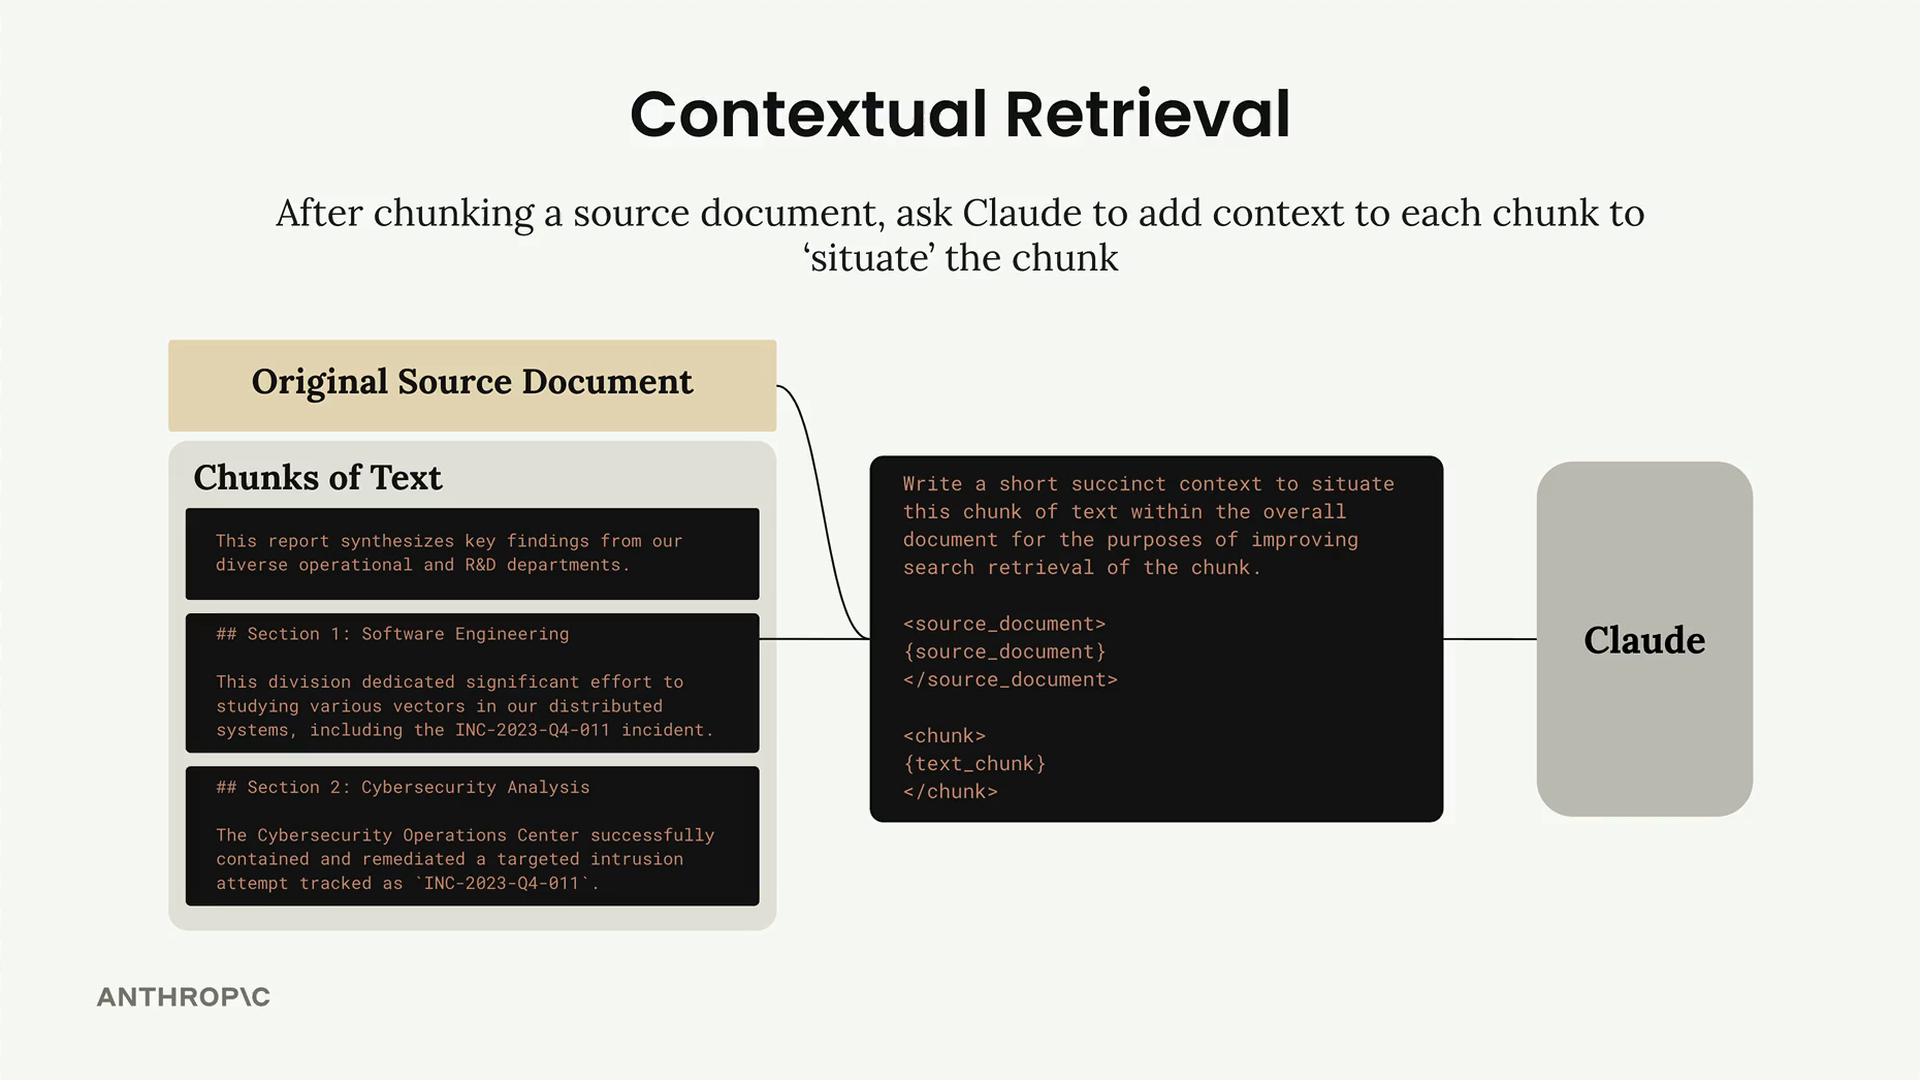
기본적인 아이디어는 간단합니다. 소스 문서를 청킹한 후, 각 청크를 리트리버 데이터베이스에 저장하기 전에 Claude에게 각 청크에 컨텍스트를 추가해달라고 요청합니다. 이 전처리 단계는 각 청크를 더 큰 문서 안에 "위치시키는" 데 도움이 됩니다.
작동 방식
각 텍스트 청크에 대해, 청크와 원본 소스 문서를 다음과 같은 프롬프트와 함께 Claude에게 전송합니다:
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.Claude는 다음과 같은 컨텍스트를 생성할 수 있습니다: "이 섹션은 여러 분야가 결합된 그룹에 관한 더 큰 보고서에서 발췌한 것입니다. 이 섹션에는 사이버보안 분석 섹션에서도 언급된 INC-2023-04-011에 대한 언급이 포함되어 있습니다."
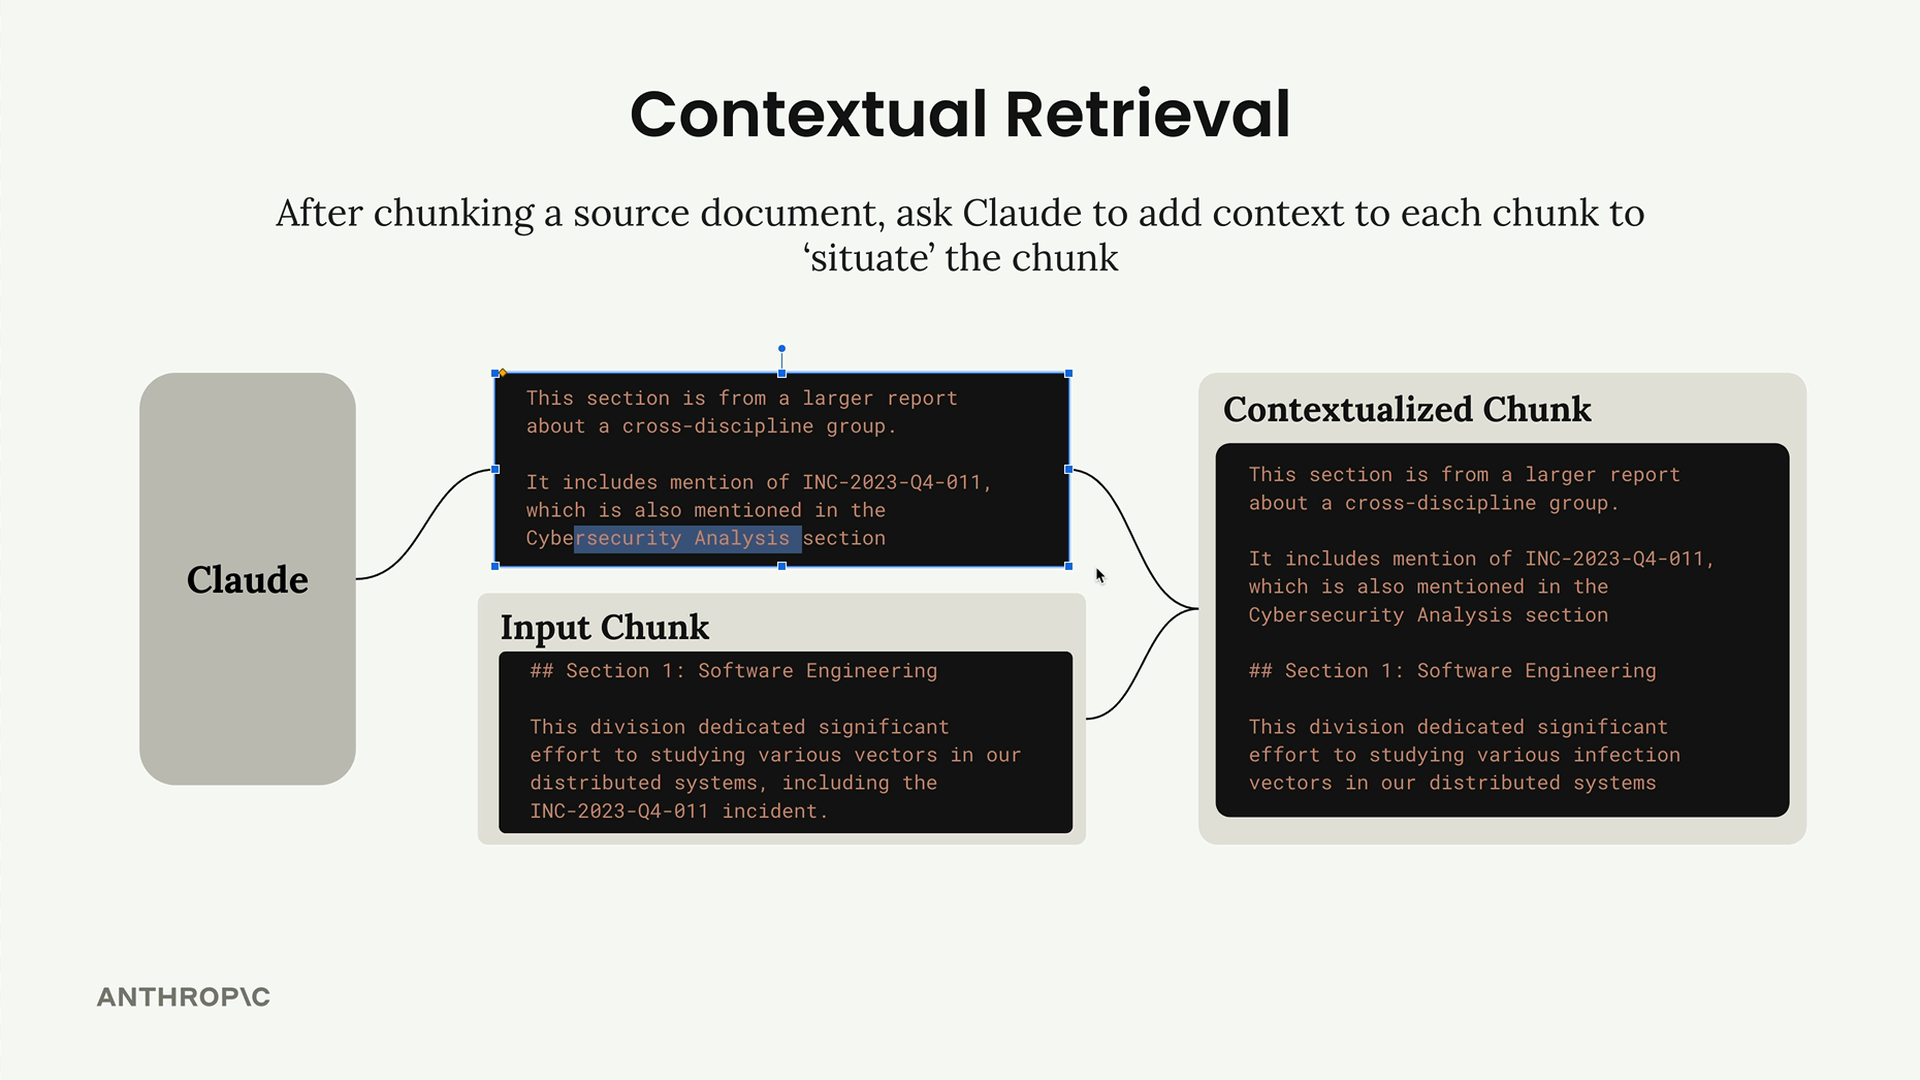
그런 다음 이 생성된 컨텍스트를 원본 청크 텍스트와 결합하여 "맥락화된 청크"를 만들고, 이를 벡터 및 BM25 인덱스에 저장합니다.
대용량 문서 처리하기
소스 문서가 너무 커서 하나의 프롬프트에 들어가지 않는 경우, 전체 문서 대신 축소된 컨텍스트 세트를 제공할 수 있습니다.
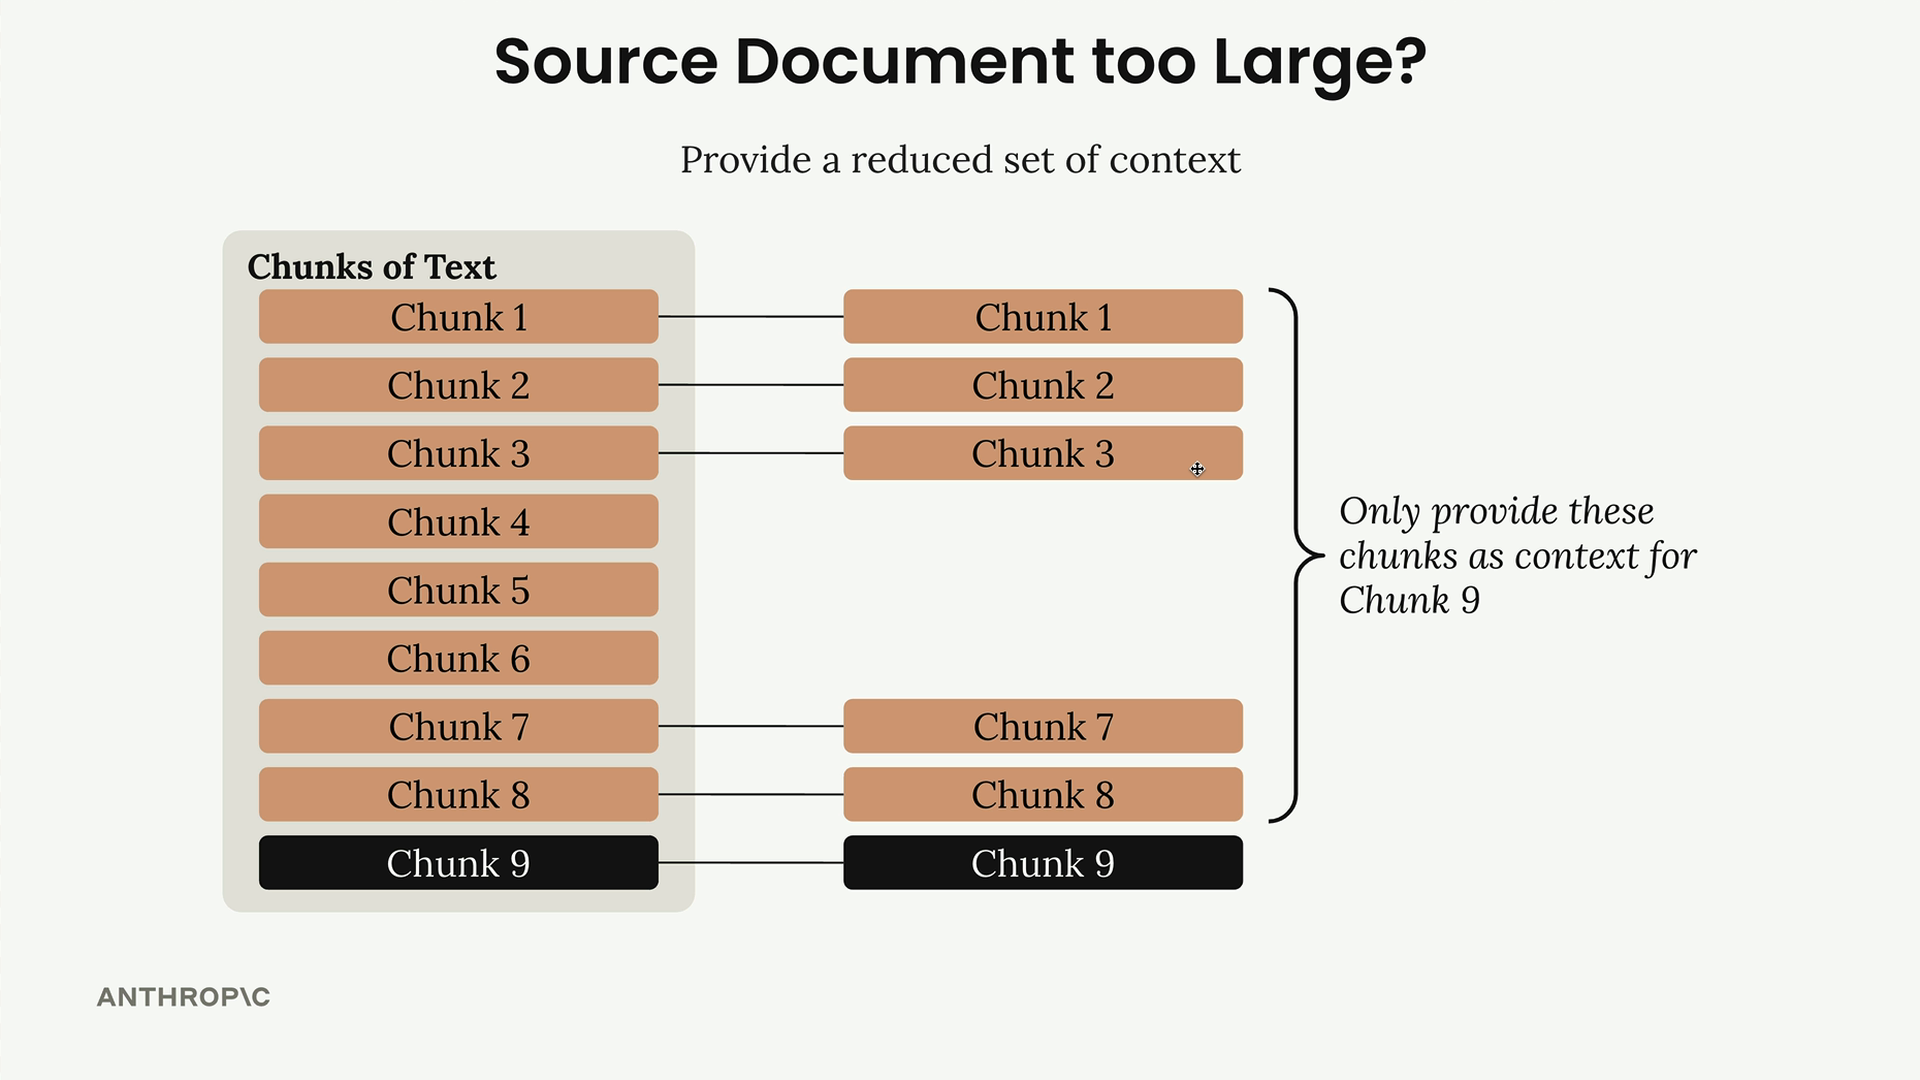
맥락화하려는 특정 청크에 대해, 다음을 포함하세요:
- 문서 시작 부분의 일부 청크(주로 요약이나 초록이 포함됨)
- 대상 청크 바로 앞에 있는 청크들(로컬 컨텍스트 제공)
이 접근 방식은 Claude가 전체 문서로 프롬프트를 과부하시키지 않으면서도 의미 있는 컨텍스트를 생성하기에 충분한 정보를 제공합니다.
구현 예시
다음은 컨텍스트 검색 함수의 기본 구현입니다:
def add_context(text_chunk, source_text):
    prompt = f"""
    Write a short and succinct snippet of text to situate this chunk within the
    overall source document for the purposes of improving search retrieval of the chunk.

    Here is the original source document:
    <document>
    {source_text}
    </document>

    Here is the chunk we want to situate within the whole document:
    <chunk>
    {text_chunk}
    </chunk>

    Answer only with the succinct context and nothing else.
    """

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return result["text"] + "\n" + text_chunk
문서 청크를 처리할 때, 각 청크를 반복하며 맥락화된 버전을 생성합니다:
# 각 청크에 컨텍스트를 추가한 후 retriever에 추가
for i, chunk in enumerate(chunks):
    # 시작 청크와 이전 청크로부터 컨텍스트를 구성
    context_parts = []
    context_parts.extend(chunks[:min(num_start_chunks, len(chunks))])

    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
예상 결과
생성된 컨텍스트는 문서 구조와 관계에 대한 유용한 정보를 제공합니다. 예를 들어, Claude는 청크를 다음과 같이 설명할 수 있습니다: "Project Phoenix의 안정성 문제를 해결하기 위한 소프트웨어 엔지니어링 노력을 상세히 다루는 연간 학제 간 연구 검토 보고서의 섹션 2입니다. 이는 방법론 섹션 뒤에 이어지고 재무 분석 섹션보다 앞서며, 조직 전반의 열 가지 연구 분야를 다루는 포괄적인 보고서의 일부를 구성합니다."
이 추가 컨텍스트는 검색 시스템이 각 청크가 무엇을 담고 있는지뿐만 아니라, 그것이 더 큰 문서 구조에 어떻게 맞아 들어가고 다른 섹션들과 어떻게 관련되는지도 더 잘 이해하도록 돕습니다. 단순한 문서에서는 극적인 개선을 보지 못할 수도 있지만, 문서가 섹션 간의 복잡한 상호 참조와 종속성으로 더욱 복잡해질수록 컨텍스트 검색의 가치는 점점 더 커집니다.