문서를 청크로 나눈 후, RAG 파이프라인의 다음 단계는 사용자의 질문과 가장 관련성이 높은 청크를 찾는 것입니다. 이는 본질적으로 검색 문제입니다 - 모든 텍스트 청크를 살펴보고 사용자가 묻는 내용과 관련된 것을 식별해야 합니다.
관련 청크 찾기
문제는 어떤 청크가 사용자의 질문과 "관련이 있는지" 판단하는 것입니다. 이는 단순한 키워드 매칭만큼 간단하지 않습니다 - 질문과 청크 양쪽의 의미와 맥락을 모두 이해해야 합니다.
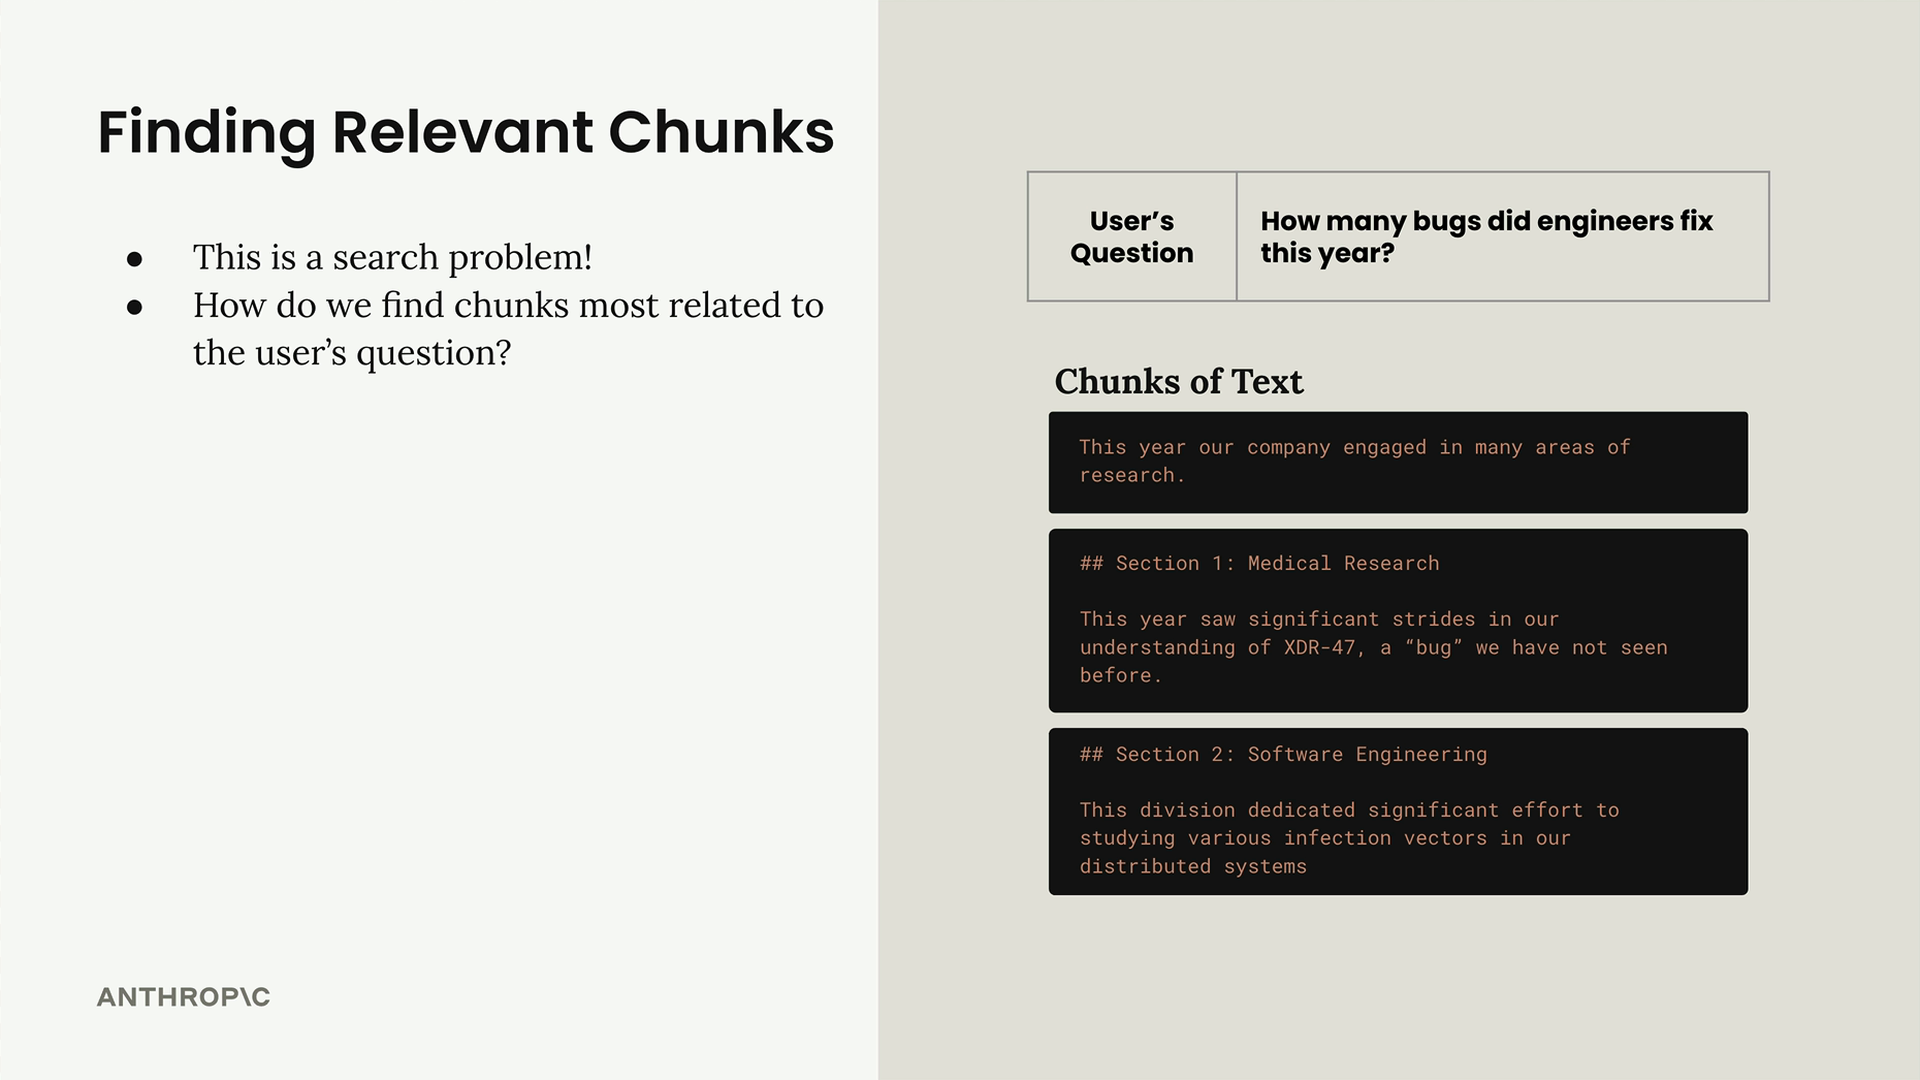
가장 일반적인 해결책은 시맨틱 검색(semantic search)으로, 단순히 정확한 단어 일치를 찾는 대신 텍스트 임베딩을 사용해 각 텍스트 조각이 실제로 무엇에 관한 것인지 이해합니다.
텍스트 임베딩이란 무엇인가요?
텍스트 임베딩은 텍스트에 담긴 의미를 숫자로 표현한 것입니다. 단어와 문장을 컴퓨터가 수학적으로 다룰 수 있는 형식으로 변환하는 것이라고 생각하면 됩니다.
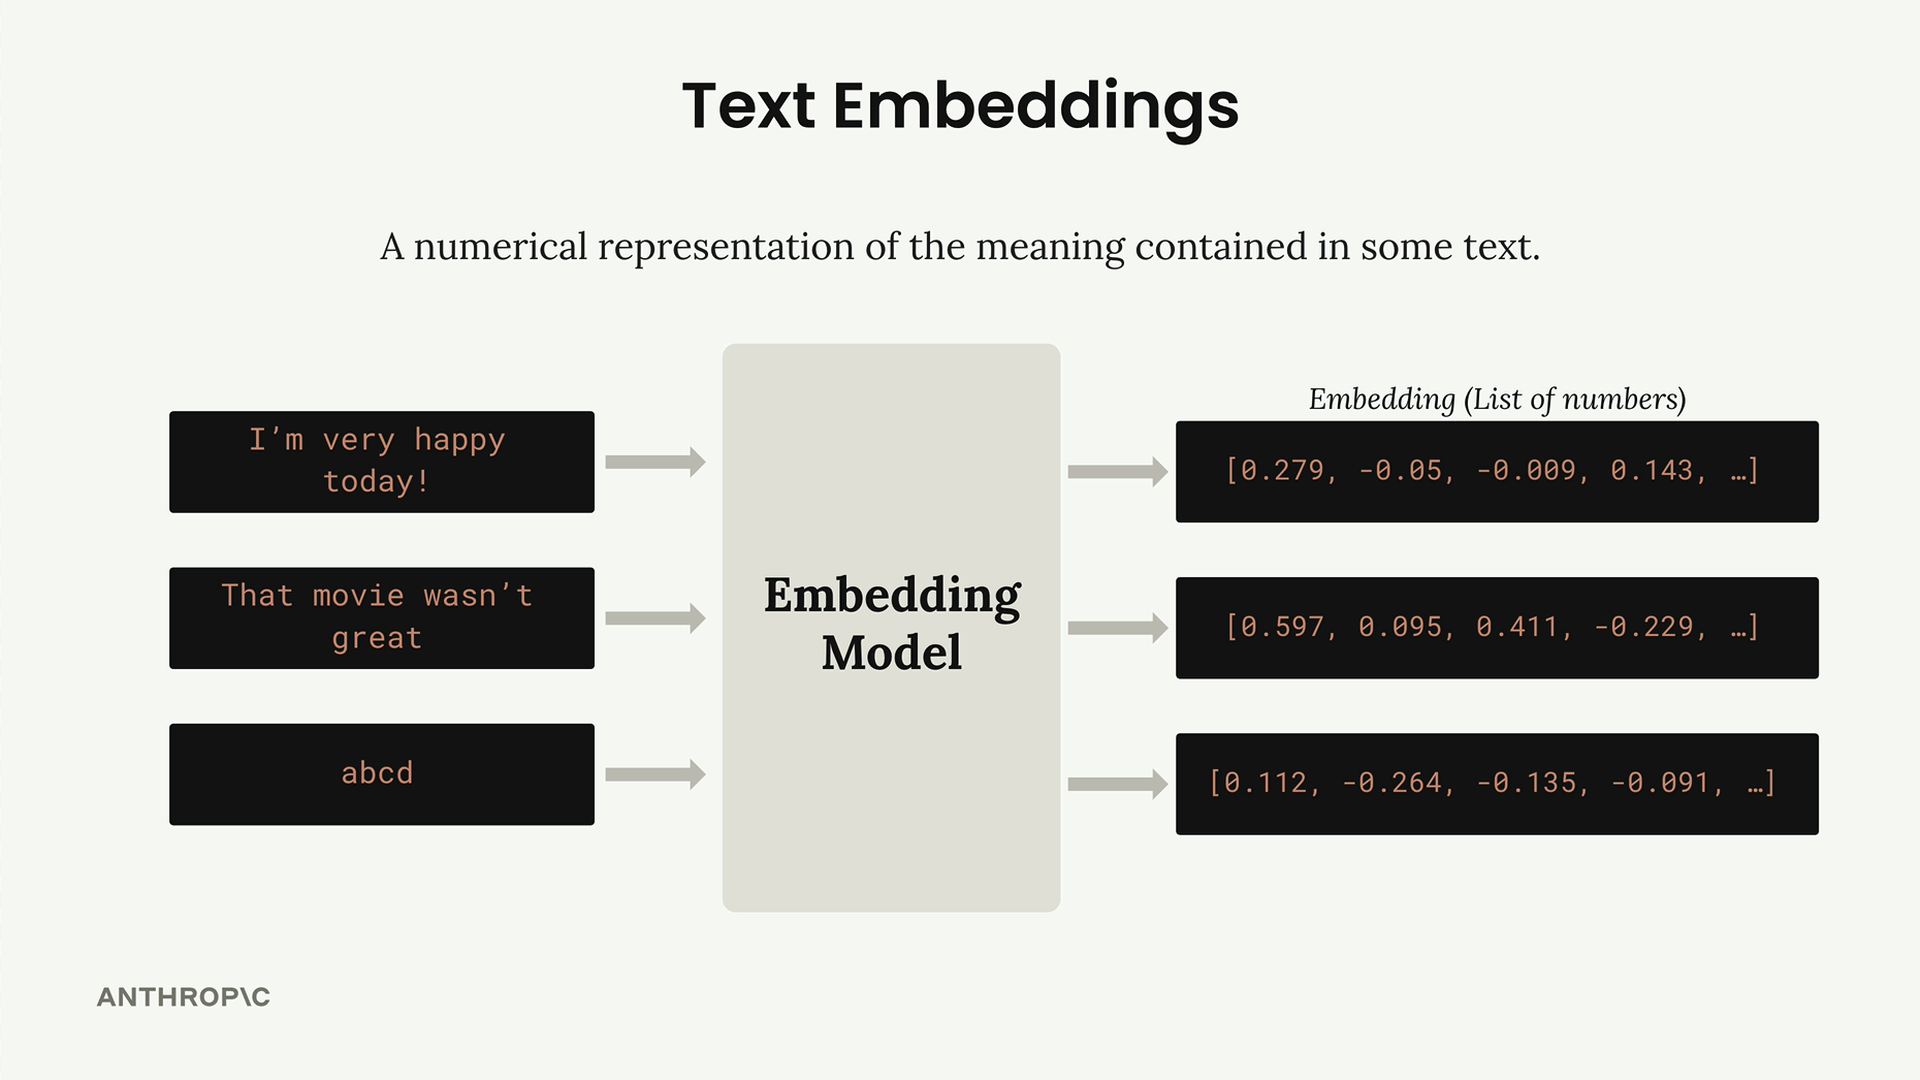
작동 방식은 다음과 같습니다:
- 텍스트를 임베딩 모델에 입력합니다
- 모델은 긴 숫자 목록(일반적으로 1024개의 숫자)을 출력합니다
- 각 숫자는 입력 텍스트의 어떤 특성에 대한 "점수"를 나타냅니다
- 숫자는 -1에서 +1 사이의 범위를 가집니다
숫자 이해하기
임베딩의 각 숫자는 텍스트의 어떤 측면에 대한 점수와 같습니다. 각 위치가 정확히 무엇을 나타내는지는 알 수 없지만, 서로 다른 특성을 측정하는 것이라고 생각하면 이해에 도움이 됩니다.
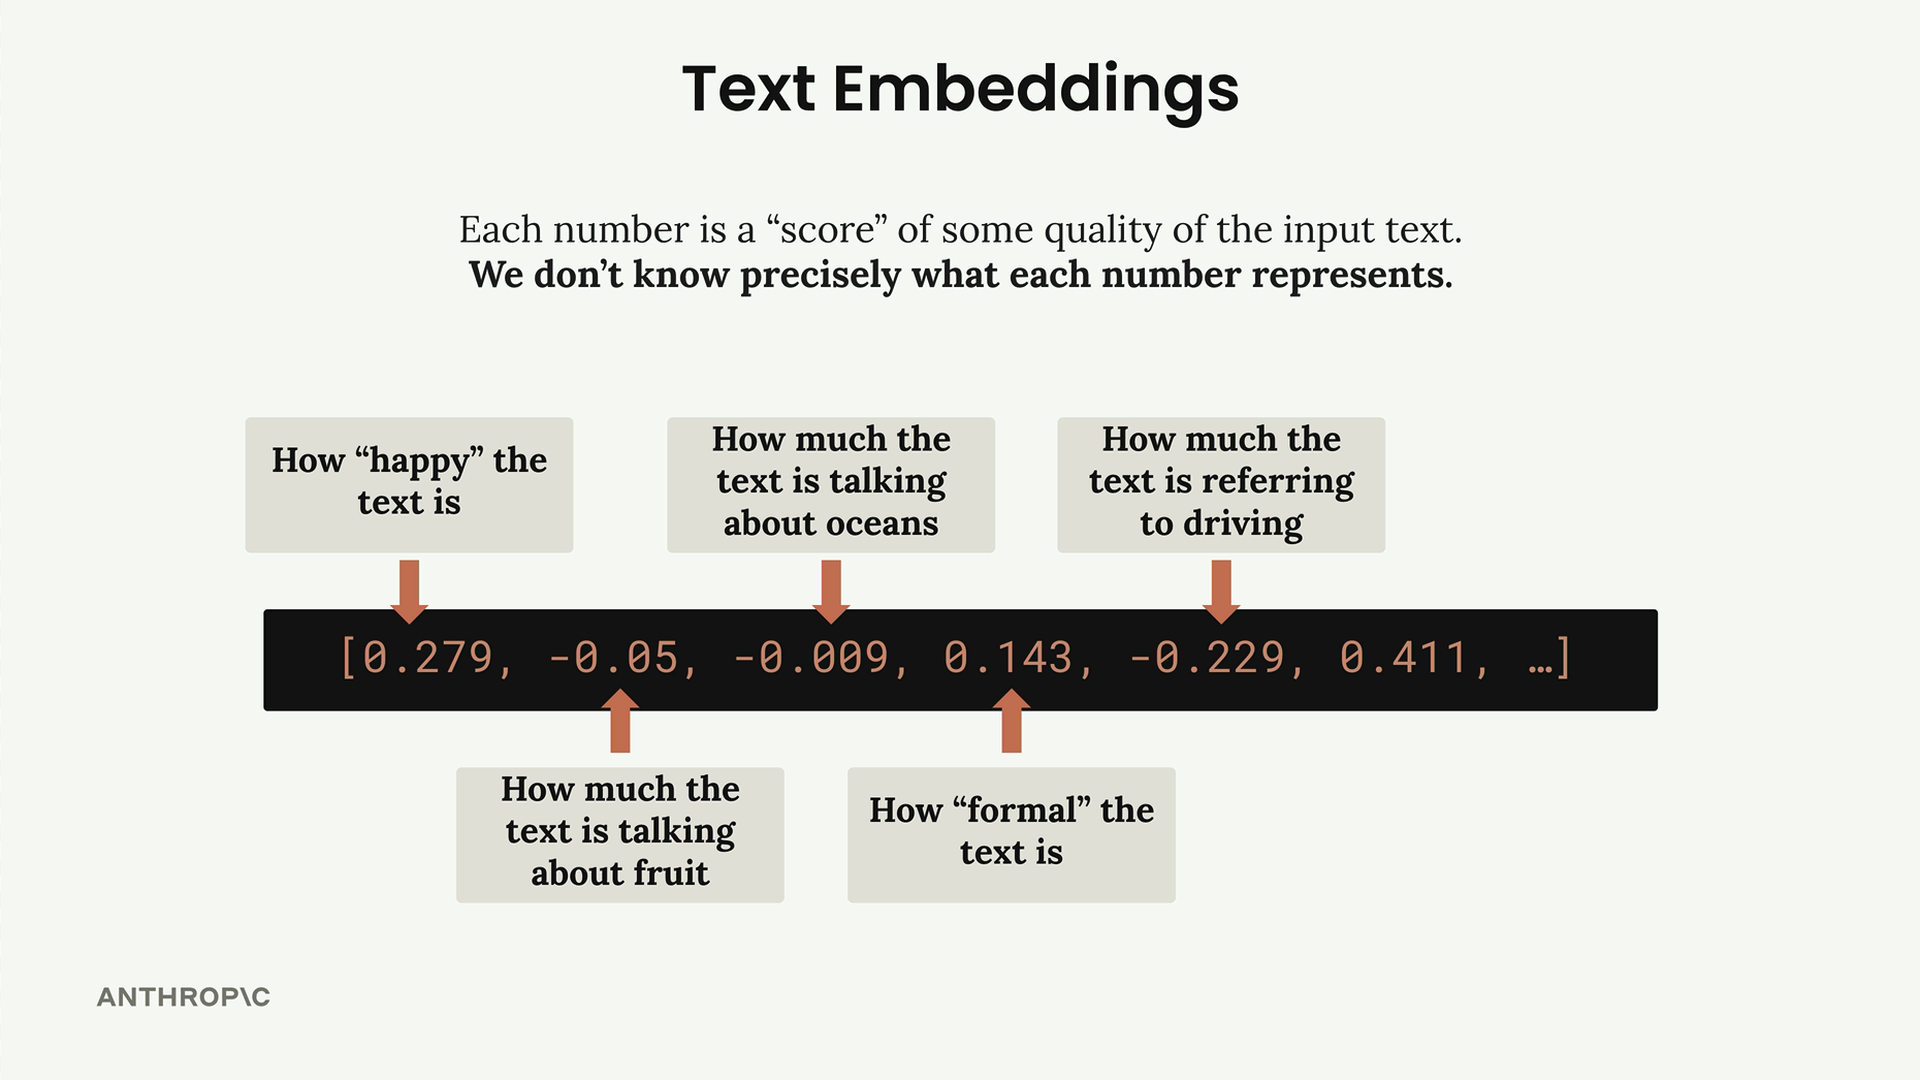
예를 들어, 어떤 숫자는 "텍스트가 얼마나 행복한가"에 점수를 매길 수 있고, 다른 숫자는 "텍스트가 바다에 대해 얼마나 많이 이야기하는가"를 측정할 수 있습니다. 핵심은 각 숫자가 실제로 무엇을 나타내는지 우리가 알지 못한다는 점입니다 - 임베딩 모델은 학습 과정에서 이러한 패턴을 학습하며, 이는 사람이 해석할 수 있는 것이 아닙니다.
코드로 임베딩 생성하기
임베딩을 생성하는 것은 간단합니다. 기본적인 과정은 다음과 같습니다:
def generate_embedding(
    text,
    embedding_model_id="amazon.titan-embed-text-v2:0",
    dimensions=1024,
    normalize=True,
):
    request_body = {
        "inputText": text,
        "dimensions": dimensions,
        "normalize": normalize,
    }

    request_json = json.dumps(request_body)
    response = client.invoke_model(
        modelId=embedding_model_id,
        body=request_json,
        accept="application/json",
        contentType="application/json",
    )

    response_body = json.loads(response.get("body").read())
    return response_body["embedding"]
이 함수를 텍스트 청크에 대해 실행하면, 해당 텍스트의 의미를 나타내는 1024개의 숫자 목록을 얻게 됩니다.
AWS Bedrock 콘솔에서 Titan 임베딩 모델에 대한 액세스를 요청해야 할 수도 있습니다. 버전 2를 사용할 수 없다면, 학습 목적으로는 버전 1도 똑같이 잘 작동합니다.
RAG에서 임베딩이 중요한 이유
임베딩의 강력함은 유사한 텍스트가 유사한 임베딩 값을 가진다는 사실을 깨달을 때 분명해집니다. 즉, 사용자의 질문을 문서 청크와 수학적으로 비교하여 정확히 같은 단어를 공유하지 않더라도 의미적으로 가장 유사한 것을 찾을 수 있습니다.
이러한 수치적 표현 덕분에 시맨틱 검색이 가능해지며, RAG 시스템에서 관련 맥락을 찾는 데 있어 단순한 키워드 매칭보다 훨씬 더 효과적입니다.