이 실습에서는 실제 예제를 사용하여 완전한 RAG(Retrieval-Augmented Generation) 구현을 보여드립니다. 처음부터 벡터 데이터베이스를 구축하고, 샘플 보고서 문서를 사용하여 RAG 워크플로우의 다섯 단계를 모두 실행해 보겠습니다.
벡터 데이터베이스 설정하기
이 구현에서는 임베딩을 저장하고 유사도 검색을 수행하는 커스텀 VectorIndex 클래스를 사용합니다. 이 클래스는 벡터 데이터베이스 작업에 필요한 핵심 기능을 제공합니다.
5단계 RAG 구현
1단계: 섹션별로 텍스트를 청크하기
먼저, 앞서 다룬 섹션 기반 청킹 방식을 사용하여 소스 문서를 로드하고 청크로 나눕니다:
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
이렇게 하면 보고서가 독립적으로 처리할 수 있는 논리적 섹션들로 나뉩니다.
2단계: 각 청크에 대한 임베딩 생성하기
다음으로, 리스트 컴프리헨션을 사용하여 모든 청크에 대한 임베딩을 생성합니다:
embeddings = [generate_embedding(chunk) for chunk in chunks]이 단계는 여러 번의 API 호출을 포함하므로 완료까지 다소 시간이 걸립니다. 각 청크는 숫자 벡터 표현으로 변환됩니다.
3단계: 벡터 데이터베이스에 임베딩 저장하기
이제 벡터 스토어를 생성하고 임베딩과 그에 연관된 텍스트를 함께 채워 넣습니다:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
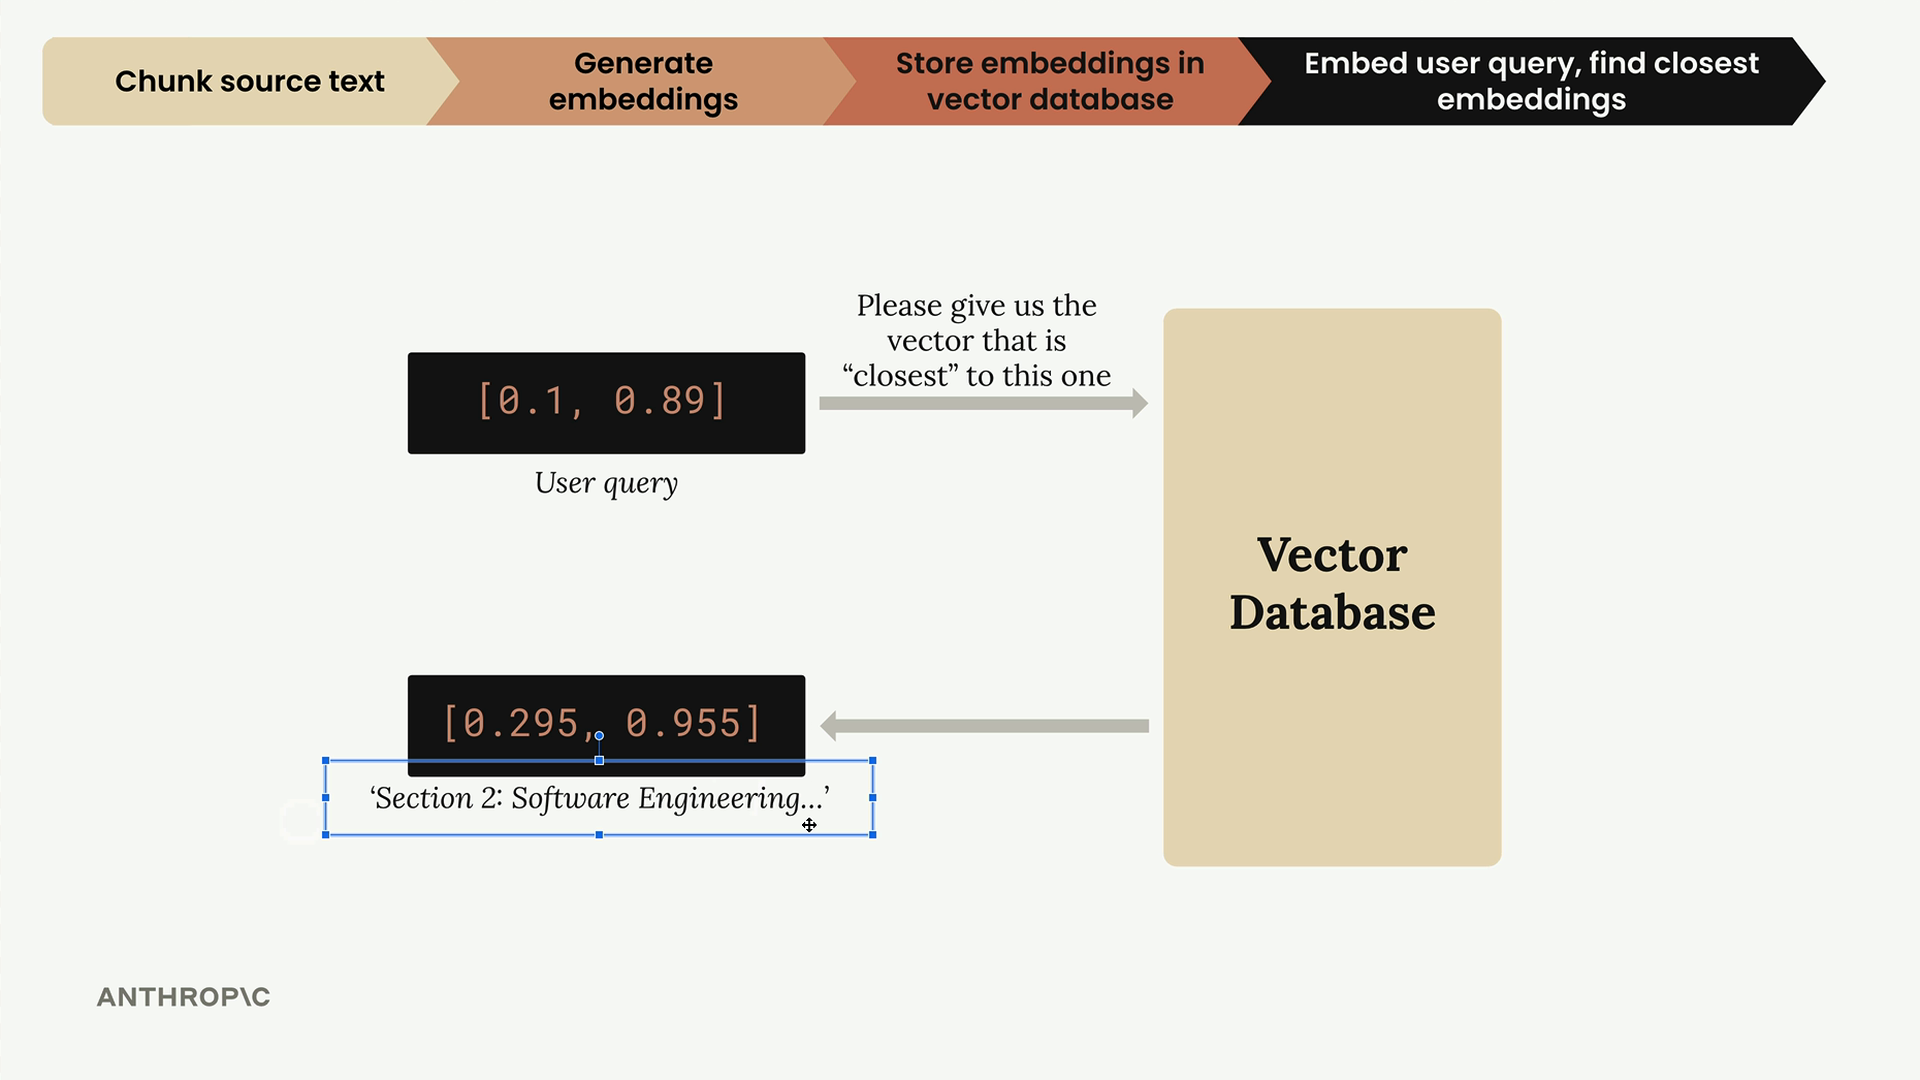
여기서 핵심은 임베딩과 원본 텍스트를 함께 저장한다는 점입니다. 단순히 숫자 목록만 돌려받는 것은 유용하지 않습니다. 해당 임베딩에 대응하는 실제 텍스트 콘텐츠가 필요합니다. 이 메타데이터를 통해 나중에 의미 있는 결과를 검색할 수 있습니다.
4단계: 사용자 쿼리 임베딩 생성하기
사용자가 질문을 하면, 이를 동일한 임베딩 형식으로 변환합니다:
user_embedding = generate_embedding("What did the software engineering dept do last year?")이를 통해 저장된 임베딩과 비교할 수 있는 사용자 질문의 벡터 표현이 생성됩니다.
5단계: 관련 청크 검색 및 검색하기
마지막으로, 벡터 스토어를 검색하여 가장 유사한 콘텐츠를 찾습니다:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
이렇게 하면 코사인 거리 점수와 함께 가장 관련성이 높은 두 개의 청크가 반환됩니다. 거리가 낮을수록 유사도가 높다는 의미입니다.
결과 이해하기
검색 결과는 관련성 순으로 정렬되어 반환됩니다. 예제에서는 소프트웨어 엔지니어링 섹션이 가장 낮은 거리(0.71)를 보여, 가장 관련성이 높은 매치로 나타났습니다. 방법론 섹션이 0.72의 거리로 두 번째를 차지했습니다.
거리 지표는 각 결과의 관련성에 대해 시스템이 얼마나 확신하고 있는지를 이해하는 데 도움이 됩니다. 거리가 가까울수록 사용자 쿼리에 더 잘 매칭된다는 뜻입니다.
텍스트를 임베딩과 함께 저장하는 이유
중요한 설계 결정 중 하나는 각 임베딩과 함께 원본 텍스트를 저장하는 것입니다. 이렇게 하지 않으면 숫자 배열만 돌려받게 되는데, 이는 응답을 생성하는 데 유용하지 않습니다. 소스 텍스트를 포함함으로써, 검색된 청크를 언어 모델의 컨텍스트로 즉시 활용할 수 있습니다.
이것으로 핵심 RAG 워크플로우가 완성되지만, 실제 시나리오에서 성능을 향상시킬 수 있는 추가적인 최적화와 개선 사항들이 존재합니다.