일반적인 프롬프트 평가 워크플로우는 프롬프트를 객관적으로 측정하고 개선하기 위해 체계적인 접근 방식을 따릅니다. 이러한 워크플로우를 구성하는 방법은 다양하며 여러 오픈 소스 및 유료 도구를 사용할 수 있지만, 핵심 프로세스를 이해하면 작게 시작해서 필요에 따라 규모를 확장할 수 있습니다.
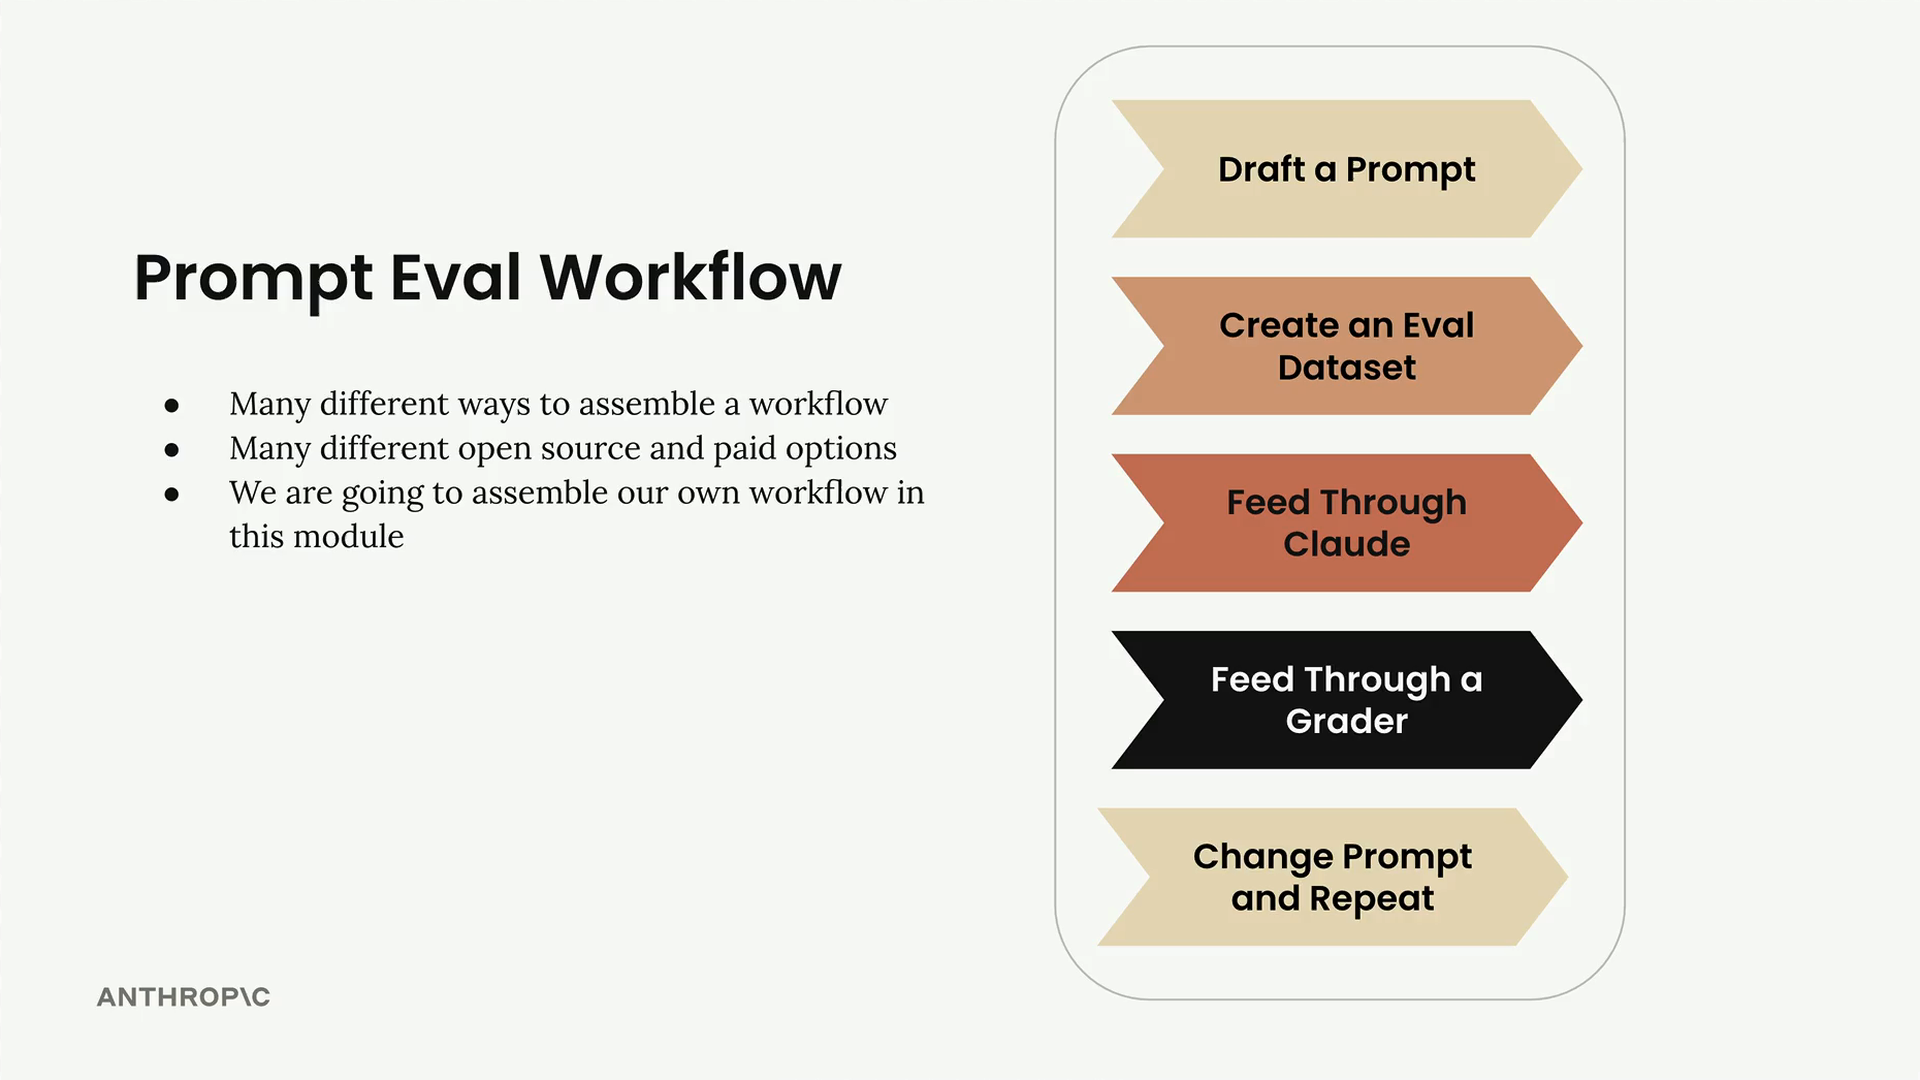
1단계: 초기 프롬프트 작성
개선하고자 하는 기본 프롬프트를 작성하는 것부터 시작합니다. 이 예시에서는 간단한 프롬프트 구조를 사용하겠습니다:
prompt = f"""
Please answer the user's question:

{question}
"""
이는 작업을 시작할 기준선을 제공합니다. 객관적인 방법론으로 평가하기 전까지는 이것이 효과적인지 알 수 없습니다.
2단계: 평가 데이터셋 생성
평가 데이터셋에는 프롬프트에 입력할 샘플 입력값이 들어 있습니다. 우리의 프롬프트는 입력값이 하나(사용자의 질문)뿐이므로, 테스트할 다양한 질문들의 모음이 필요합니다.
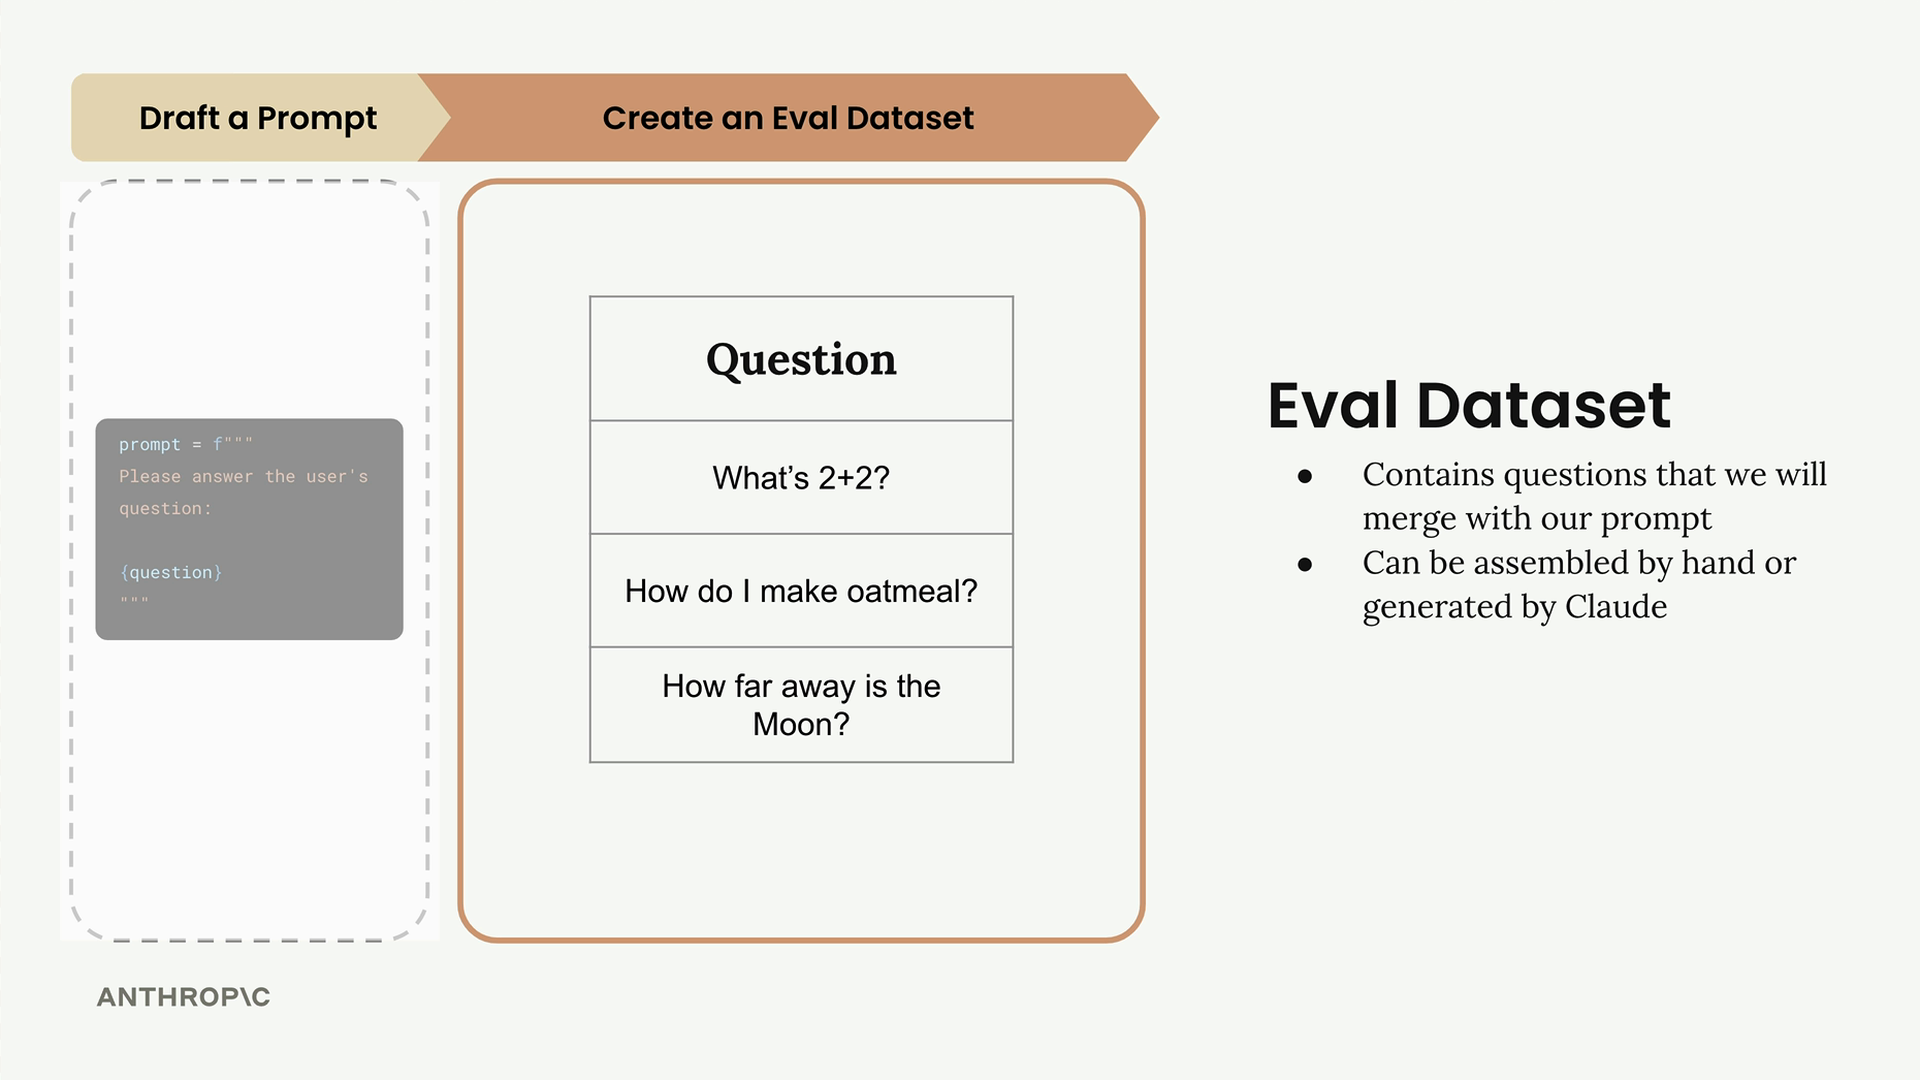
데이터셋에는 프롬프트와 결합할 질문들이 들어 있습니다. 이러한 데이터셋은 직접 구성하거나 Claude를 사용해 생성할 수 있습니다. 실제 평가에서는 수십, 수백, 심지어 수천 개의 다른 레코드가 있을 수 있지만, 이 예시에서는 세 가지 질문만으로 시작하겠습니다:
- 2+2는 얼마인가요?
- 오트밀은 어떻게 만드나요?
- 달까지의 거리는 얼마나 되나요?
3단계: Claude를 통해 입력하기
데이터셋의 각 질문을 가져와 프롬프트 템플릿과 결합하여 완전한 프롬프트를 만듭니다. 그런 다음 각각을 Claude에 보내고 응답을 수집합니다.
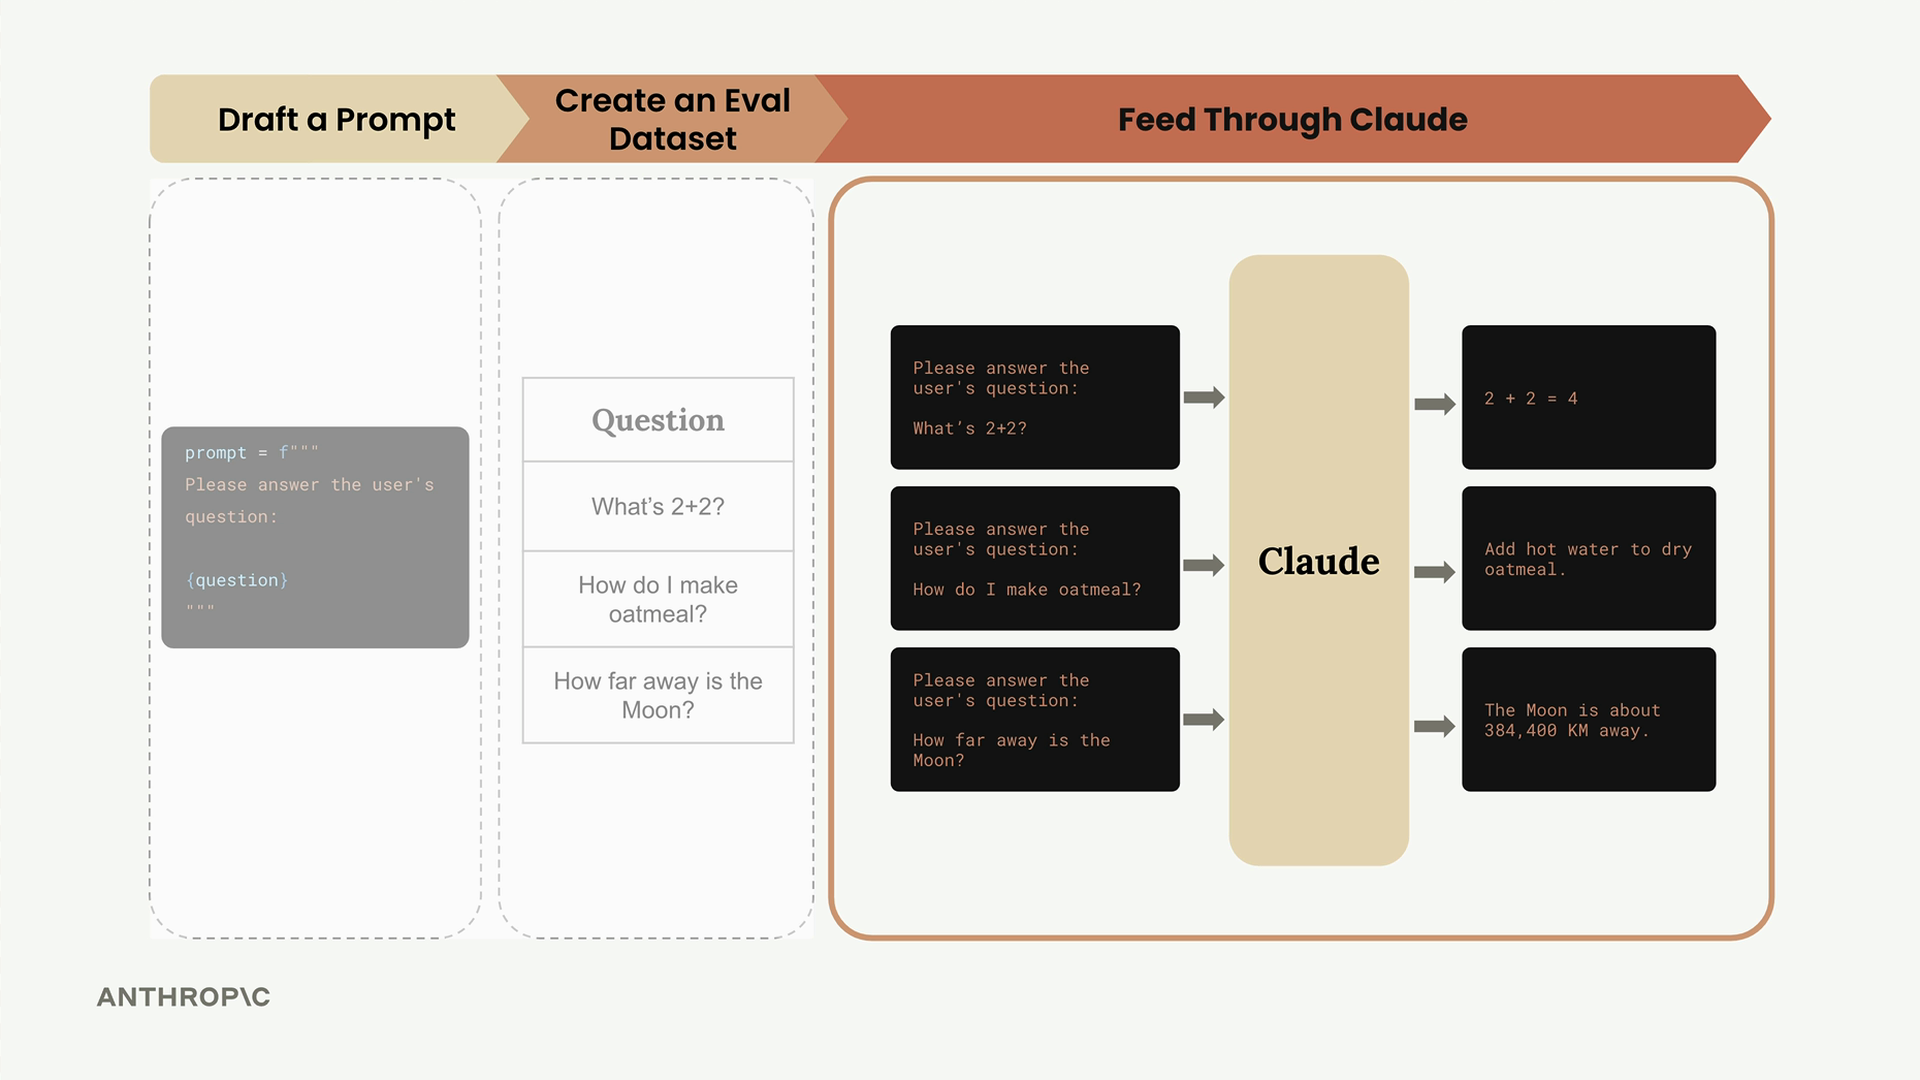
예를 들어, 첫 번째 질문은 Claude가 응답할 수 있는 완전한 프롬프트가 됩니다. 데이터셋의 모든 레코드에 대해 이 과정을 반복하면서 "2 + 2 = 4"와 같은 응답, 자세한 오트밀 조리법, 달까지의 거리에 관한 정보를 받게 됩니다.
4단계: 채점자를 통해 입력하기
이제 중요한 단계가 나옵니다: Claude의 응답을 객관적으로 채점하는 것입니다. 각 질문-답변 쌍을 가져와 Claude 응답의 품질을 평가할 채점자에게 입력합니다.
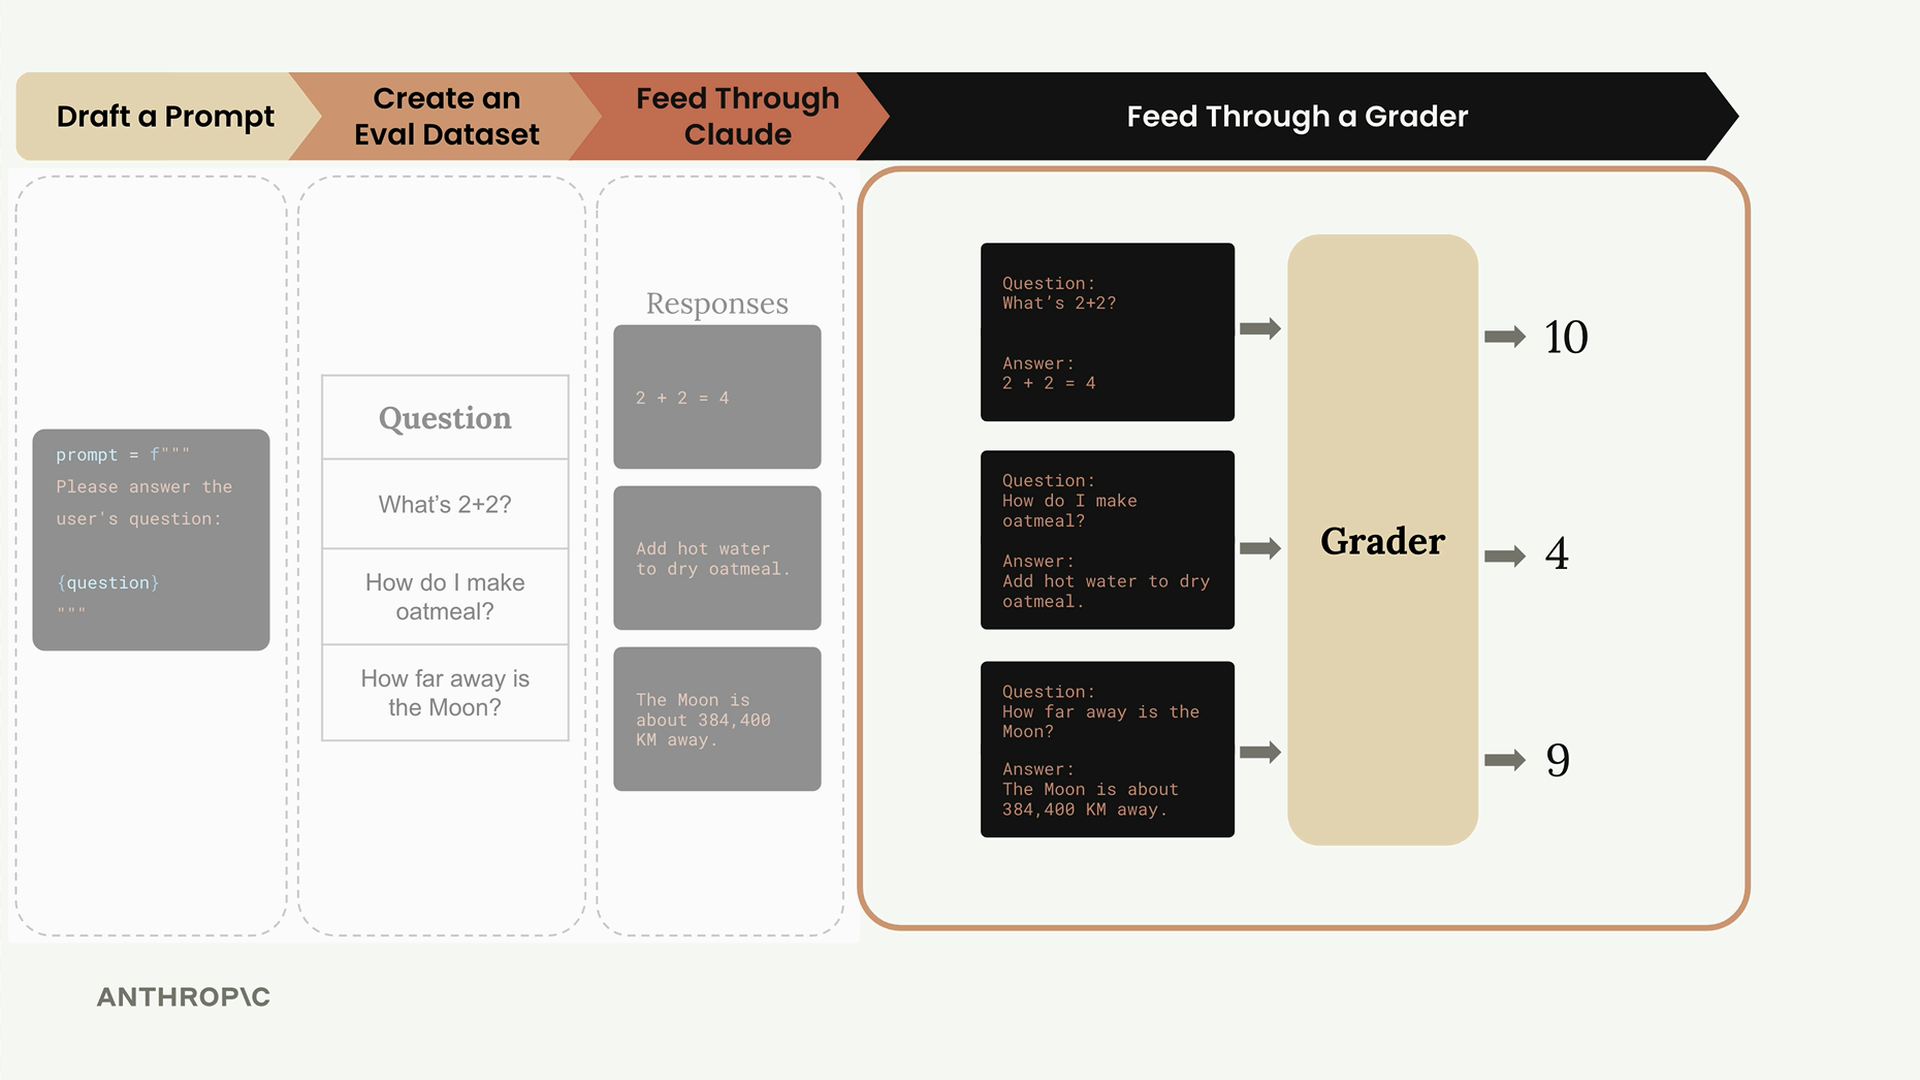
채점자는 응답 품질에 따라 점수(일반적으로 1~10점)를 부여합니다:
- 10 = 완벽한 답변, 개선의 여지 없음
- 4 = 확실히 개선이 필요함
- 1 = 부족하거나 잘못된 응답
이 예시에서는 각 응답이 각각 10점, 4점, 9점을 받을 수 있습니다. 이 점수들을 평균하여 전체 성능 지표를 구하면 7.66이 됩니다.
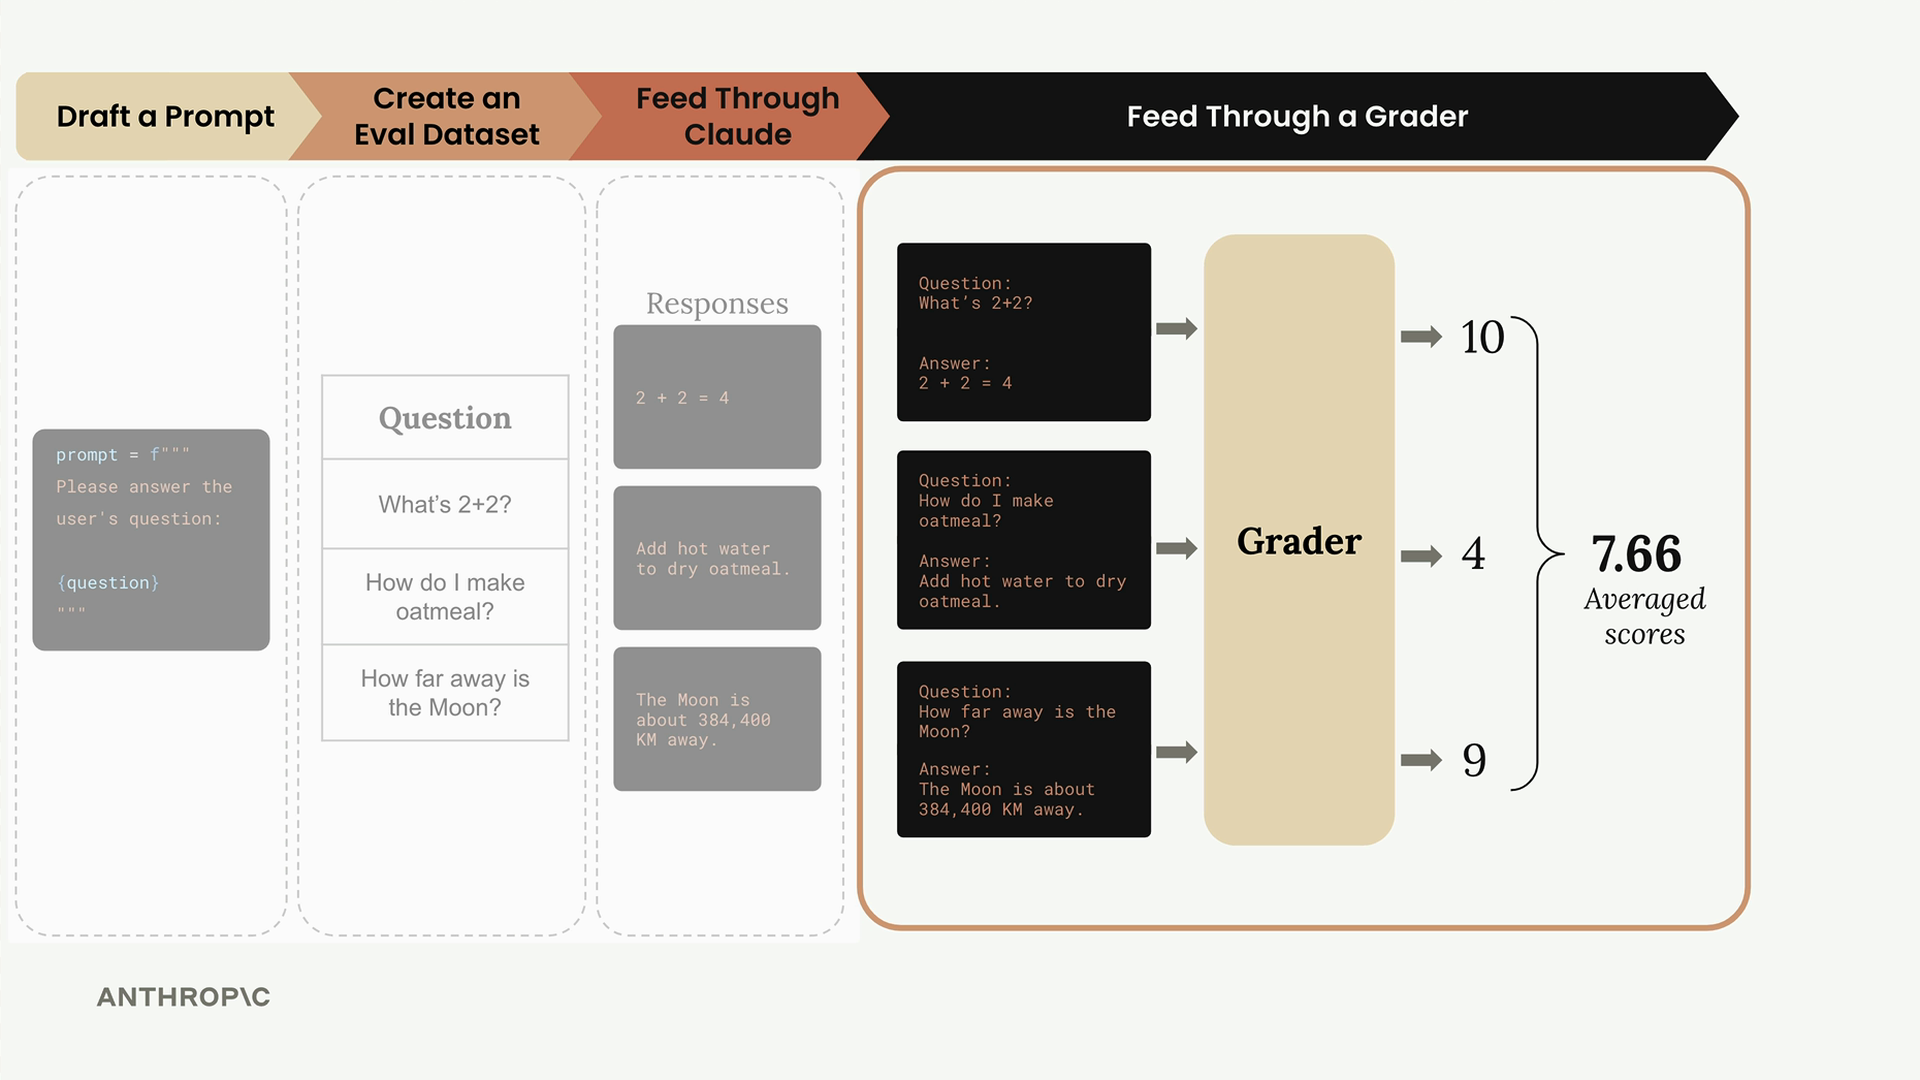
5단계: 프롬프트 변경 및 반복
기준 점수가 확립되면 이제 프롬프트를 반복적으로 개선할 수 있습니다. Claude의 응답을 유도할 더 구체적인 지침을 추가해 보세요:
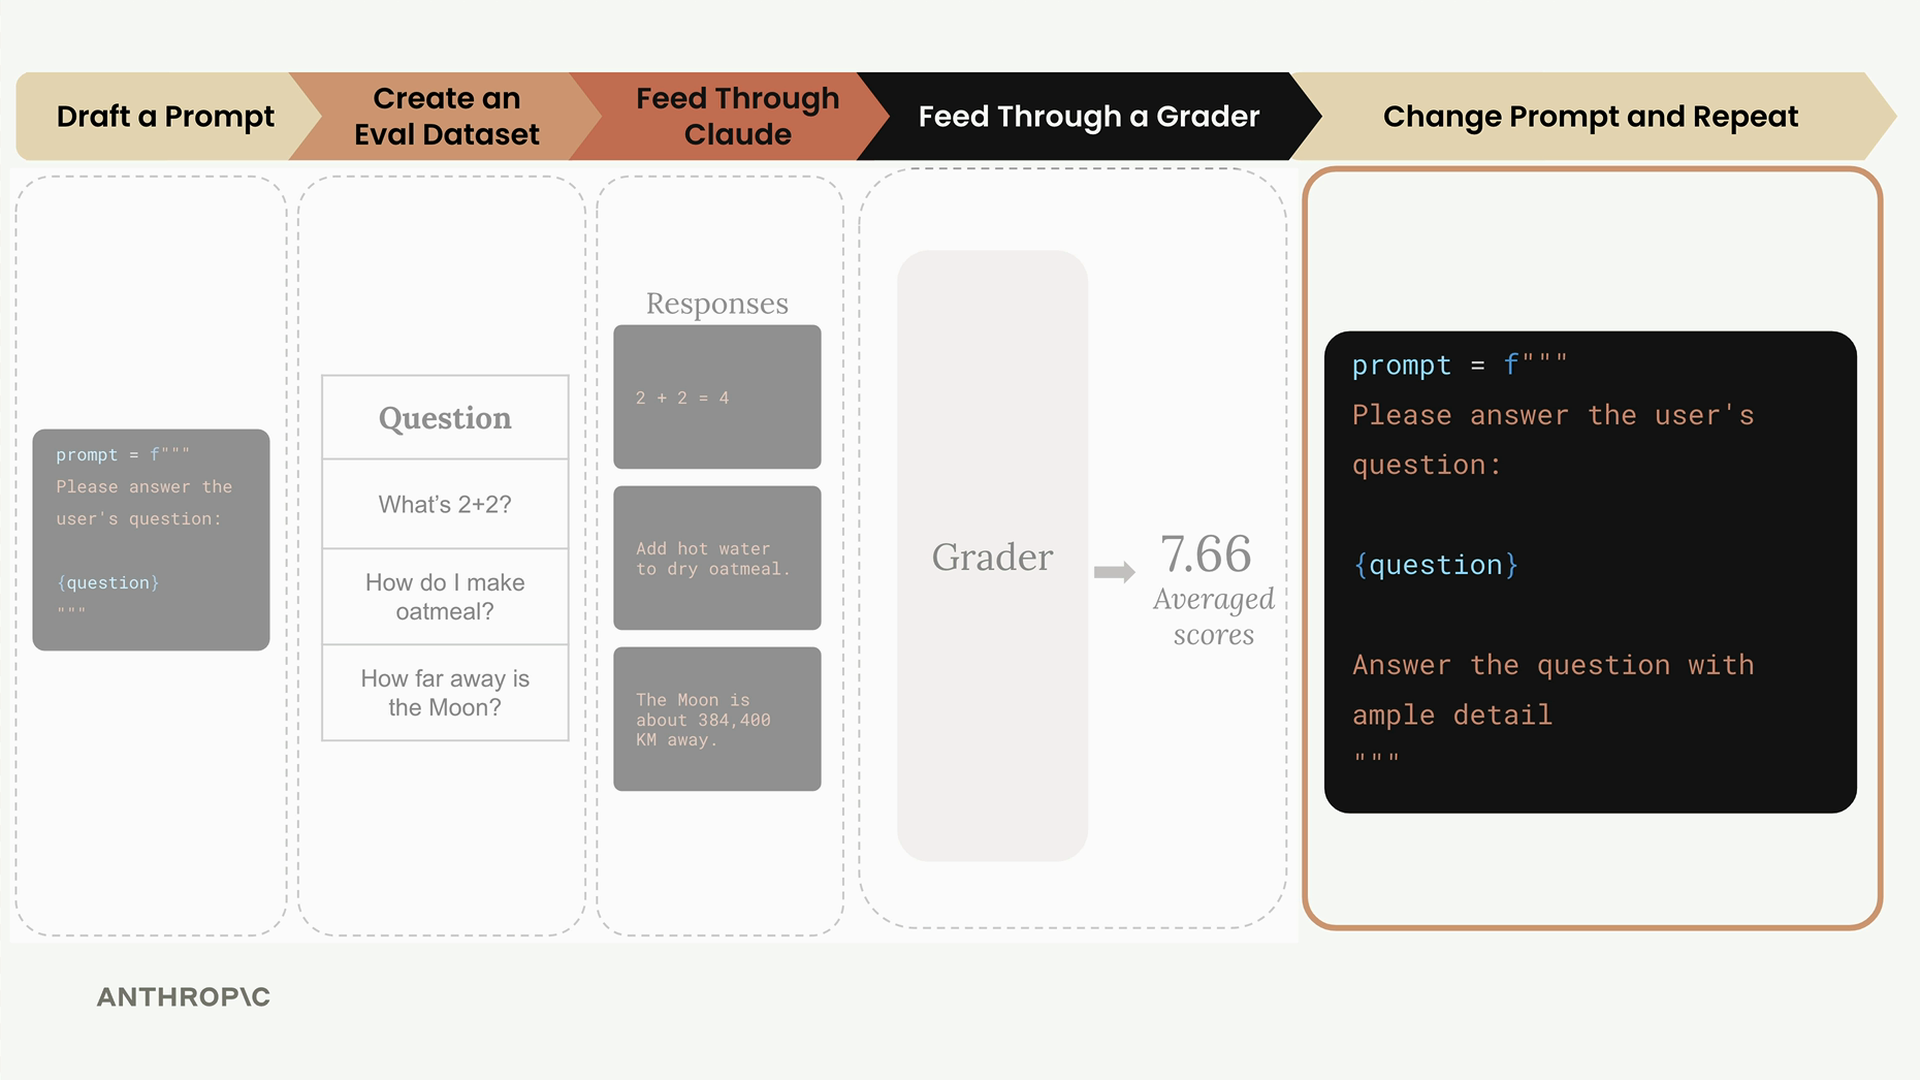
prompt = f"""
Please answer the user's question:

{question}

Answer the question with ample detail
"""
이 개선된 프롬프트를 전체 평가 파이프라인에 다시 실행해 보세요. 점수를 비교하여 어느 버전이 더 나은 성능을 보이는지 확인합니다.
프롬프트 채점 및 반복
이 워크플로우의 강점은 각 프롬프트 버전에 대해 객관적인 측정값을 얻을 수 있다는 점입니다. 서로 다른 반복 버전들의 점수를 비교해 가장 성능이 좋은 버전을 사용하거나, 더 나은 접근 방식을 찾기 위해 계속 반복할 수 있습니다.
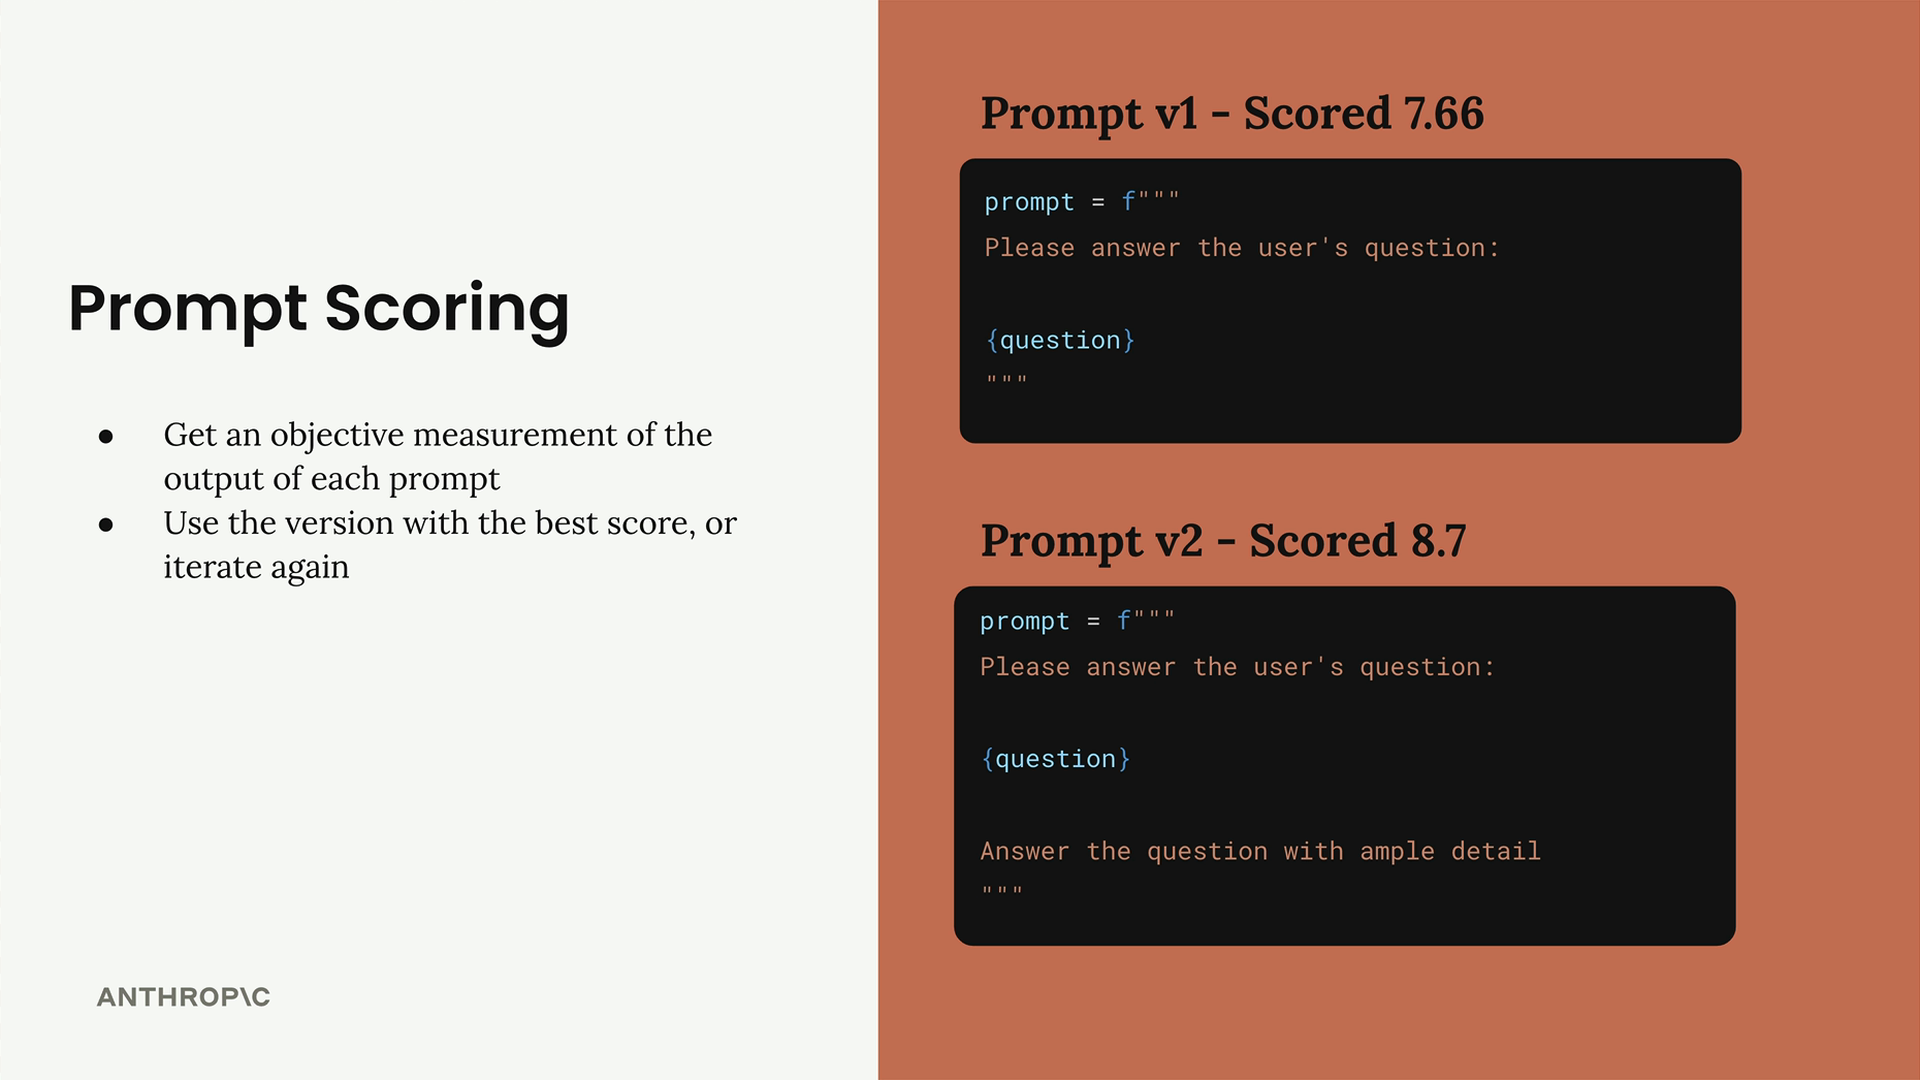
이 예시에서:
- 프롬프트 v1은 7.66점을 받았습니다
- 프롬프트 v2는 8.7점을 받았습니다
v2의 더 높은 점수는 "질문에 충분히 상세하게 답변하세요"를 추가한 것이 테스트 사례 전반에서 프롬프트의 성능을 향상시켰음을 시사합니다.
이러한 체계적인 접근 방식은 주관적인 판단에 의존하는 대신 프롬프트 개선을 측정할 수 있는 객관적인 방법을 제공합니다. 간단한 구현으로 시작해서 필요에 따라 점차 더 정교한 평가 기준을 추가해 나갈 수 있습니다.