로드 중
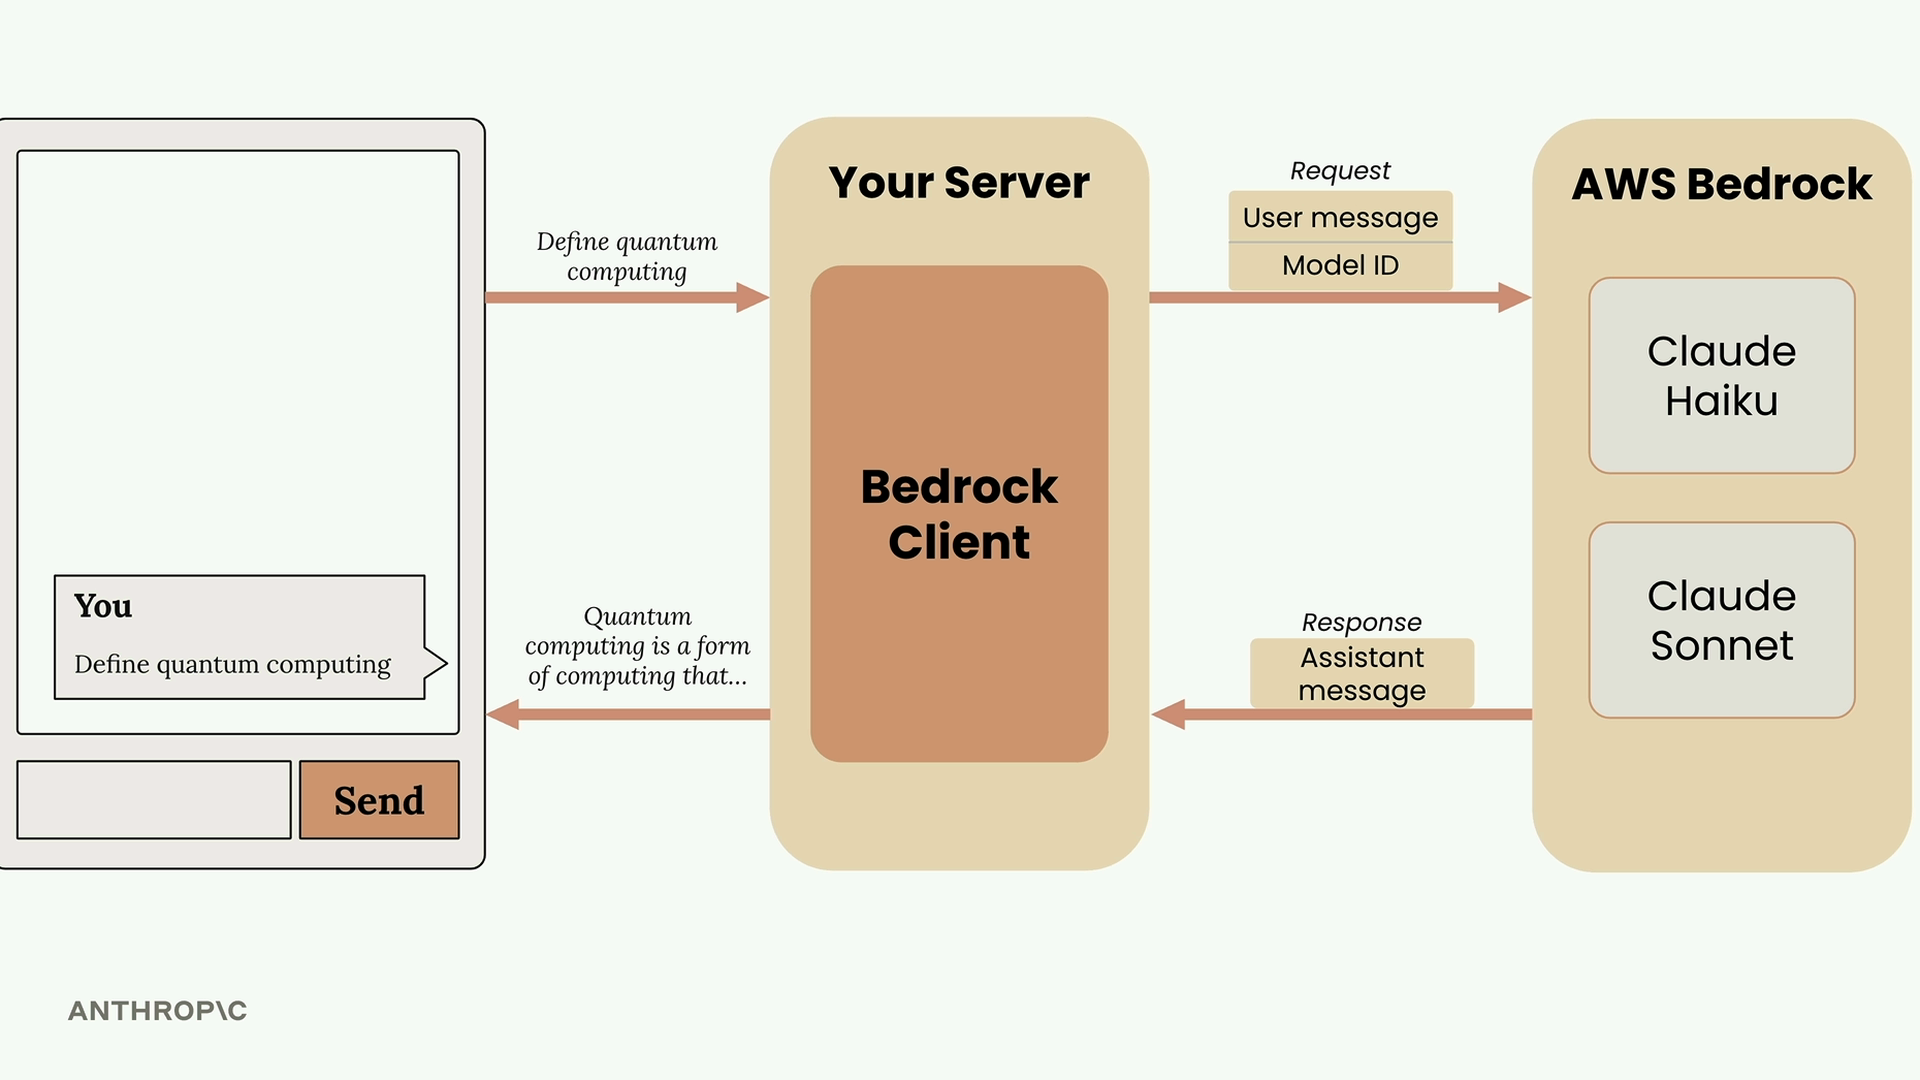
AI 모델로 애플리케이션을 구축할 때는 사용자 입력에서 AI가 생성한 응답에 이르기까지 데이터의 흐름을 이해해야 합니다. AWS Bedrock을 사용하여 이 과정이 어떻게 작동하는지 살펴보고, 일반적인 채팅 애플리케이션의 이면에서 무슨 일이 일어나는지 알아보겠습니다.
채팅 애플리케이션의 작동 방식
간단한 채팅 인터페이스를 갖춘 웹 앱을 만들고 있다고 상상해 보세요. 사용자가 "양자 컴퓨팅을 정의하라"라고 입력하고 전송을 클릭합니다. 실제로 일어나는 일은 다음과 같습니다.
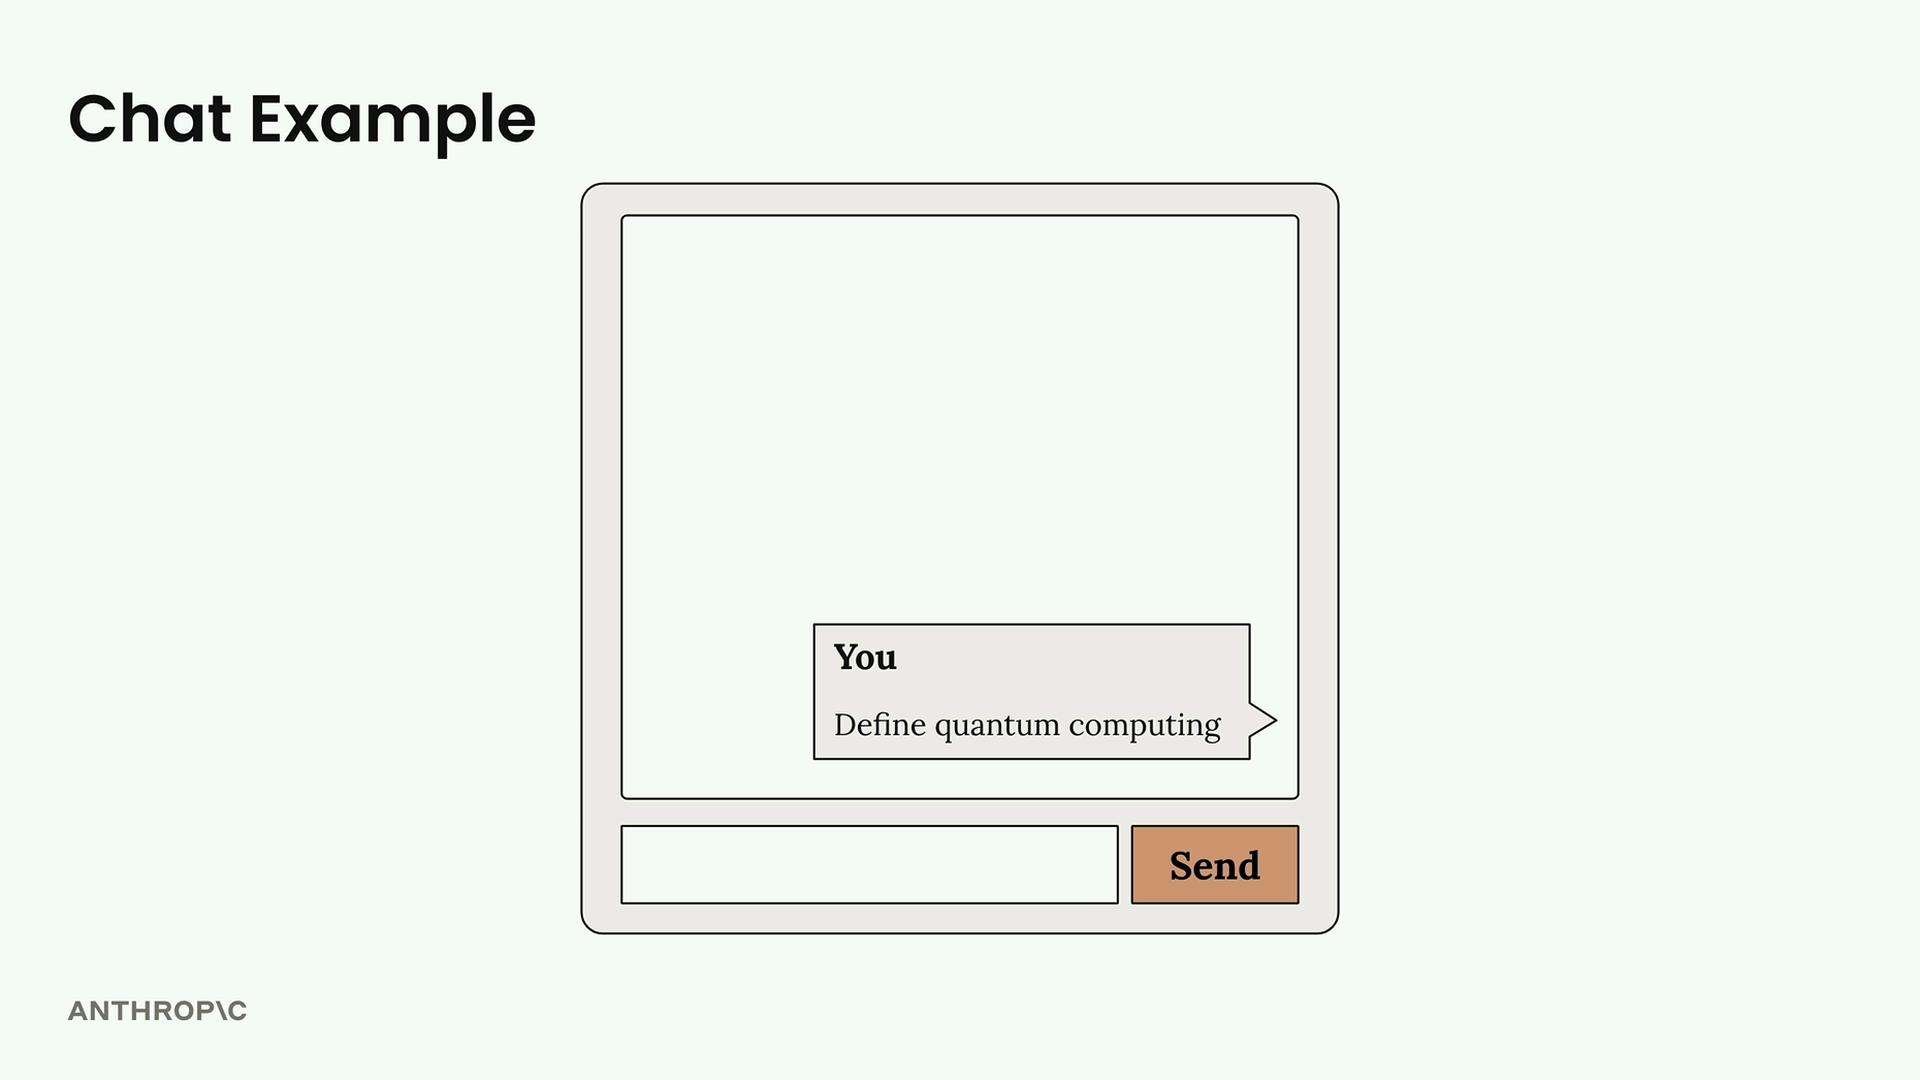
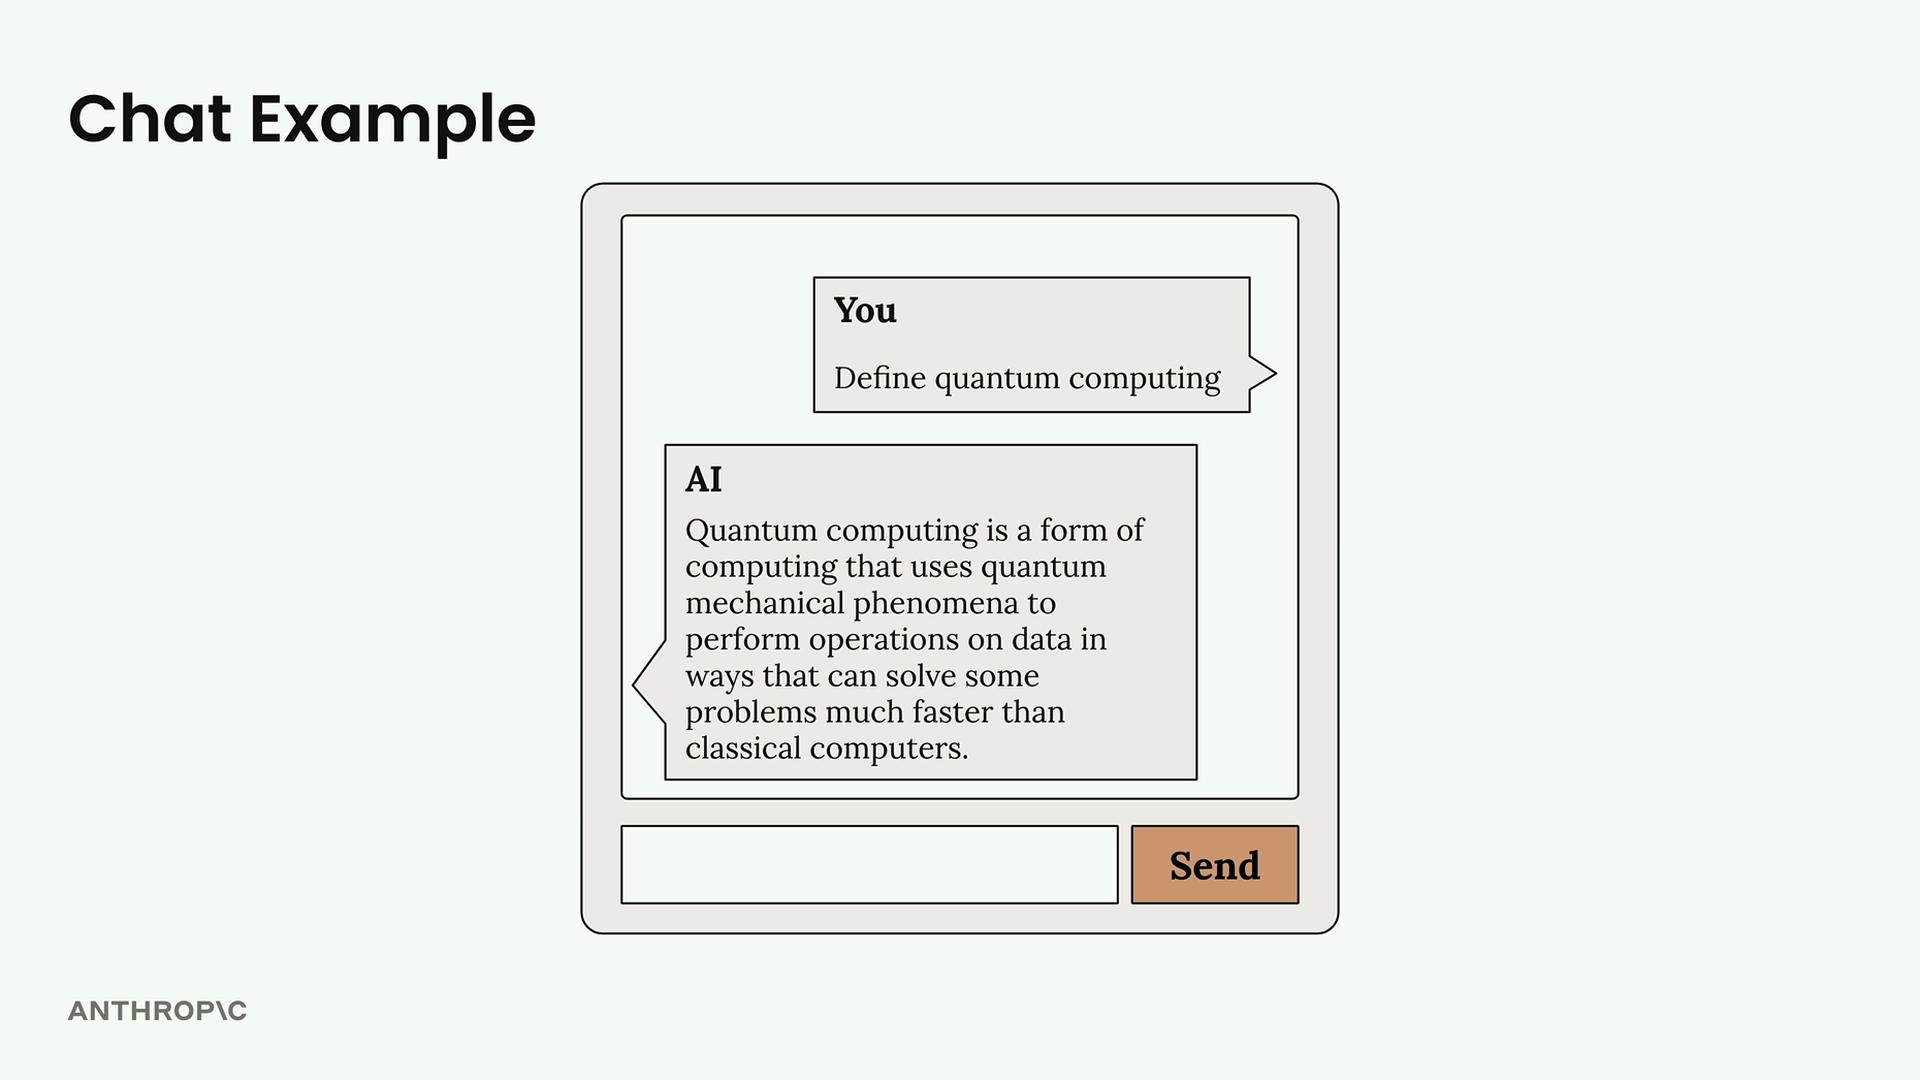
사용자에게는 깔끔한 인터페이스만 보이지만, 그 뒤에서는 해당 응답을 생성하기 위한 전체 시스템이 작동하고 있습니다.
요청 흐름
사용자가 텍스트를 제출하면, 해당 메시지는 다음과 같은 경로를 거칩니다.
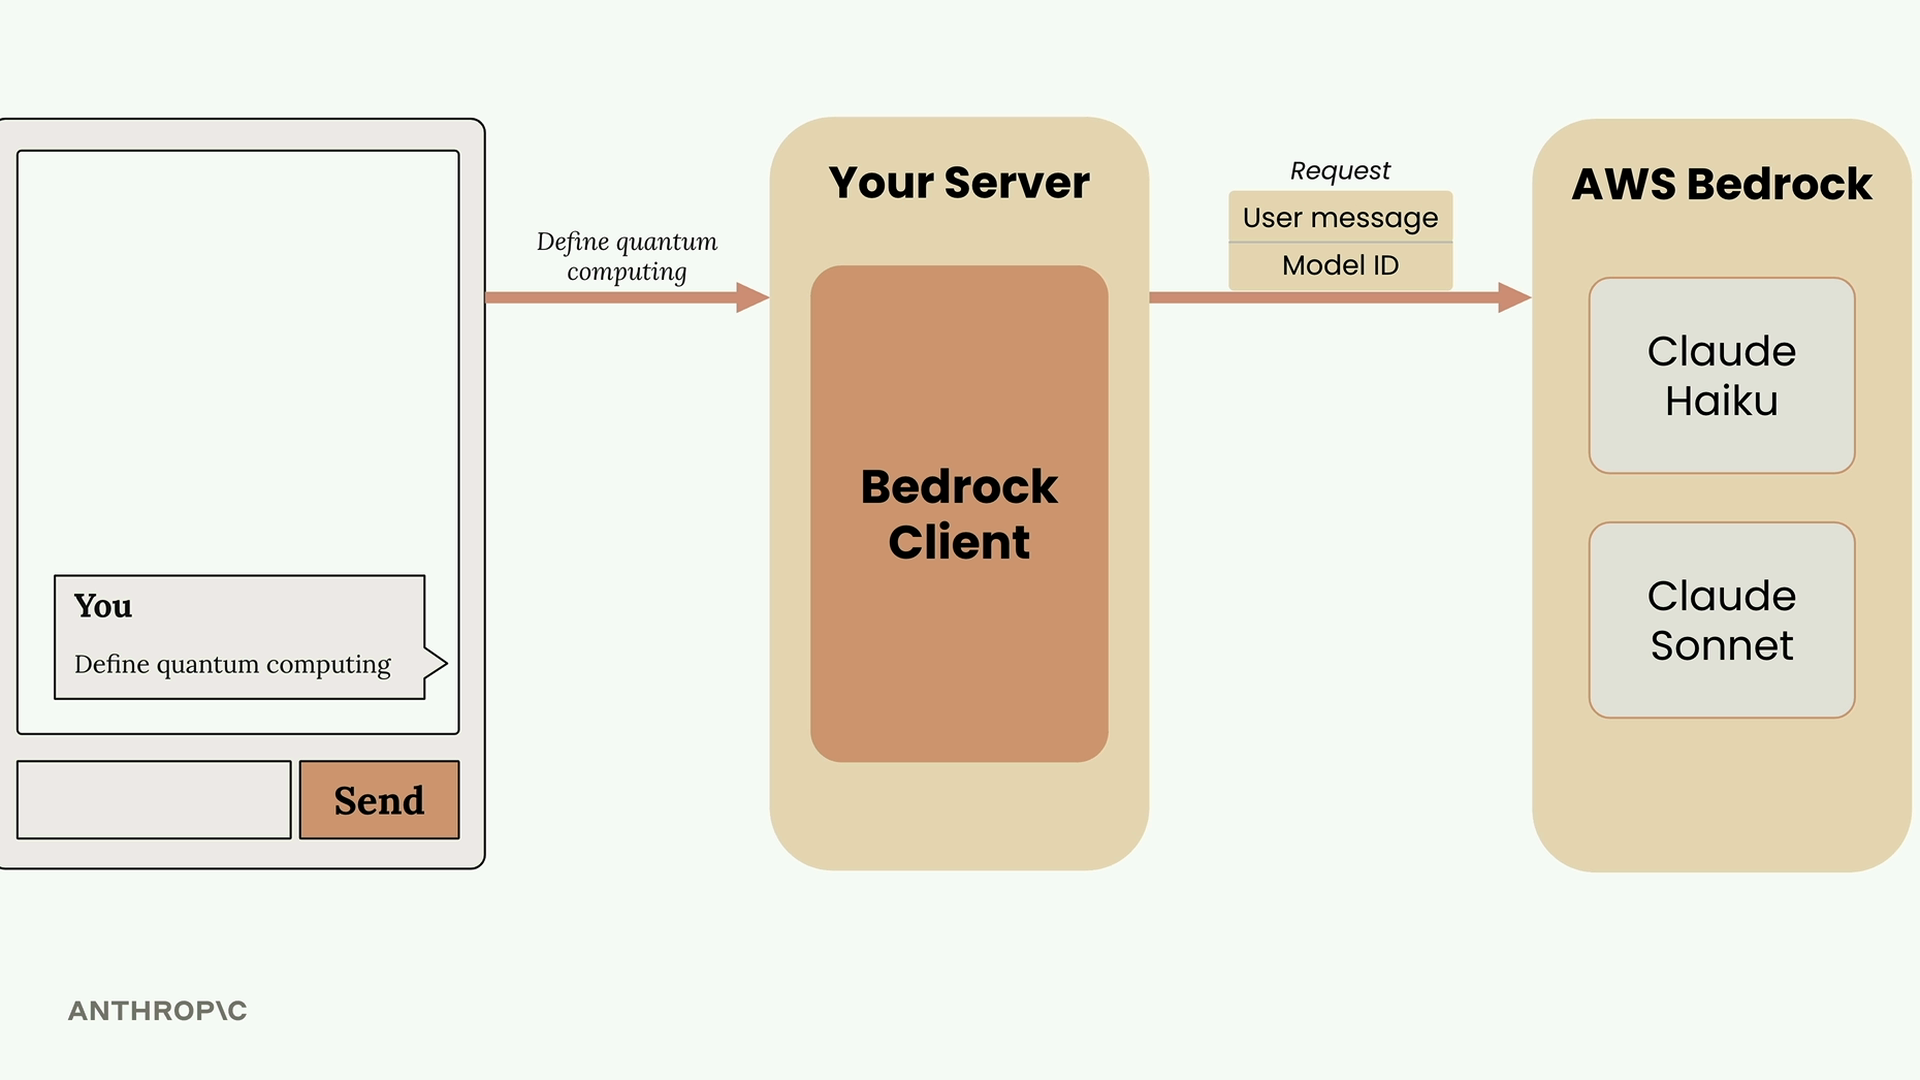
- 사용자가 웹 인터페이스를 통해 메시지를 제출합니다
- 서버가 해당 텍스트를 포함한 요청을 수신합니다
- 서버는 Bedrock 클라이언트를 사용하여 AWS Bedrock에 요청을 보냅니다
- 요청에는 사용자 메시지와 모델 ID(예: Claude Haiku 또는 Claude Sonnet)가 포함됩니다
- 선택된 모델이 요청을 처리하고 텍스트를 생성합니다
- AWS Bedrock은 생성된 응답을 담은 어시스턴트 메시지를 다시 보냅니다
- 서버는 이 응답을 사용자의 브라우저로 다시 전달합니다