확장 사고는 최종 응답을 생성하기 전에 모델이 복잡한 문제를 추론할 시간을 갖도록 해주는 Claude의 고급 기능입니다. Claude의 내적 독백이라고 생각하면 됩니다 - Claude가 문제에 단계적으로 어떻게 접근하는지 볼 수 있습니다.
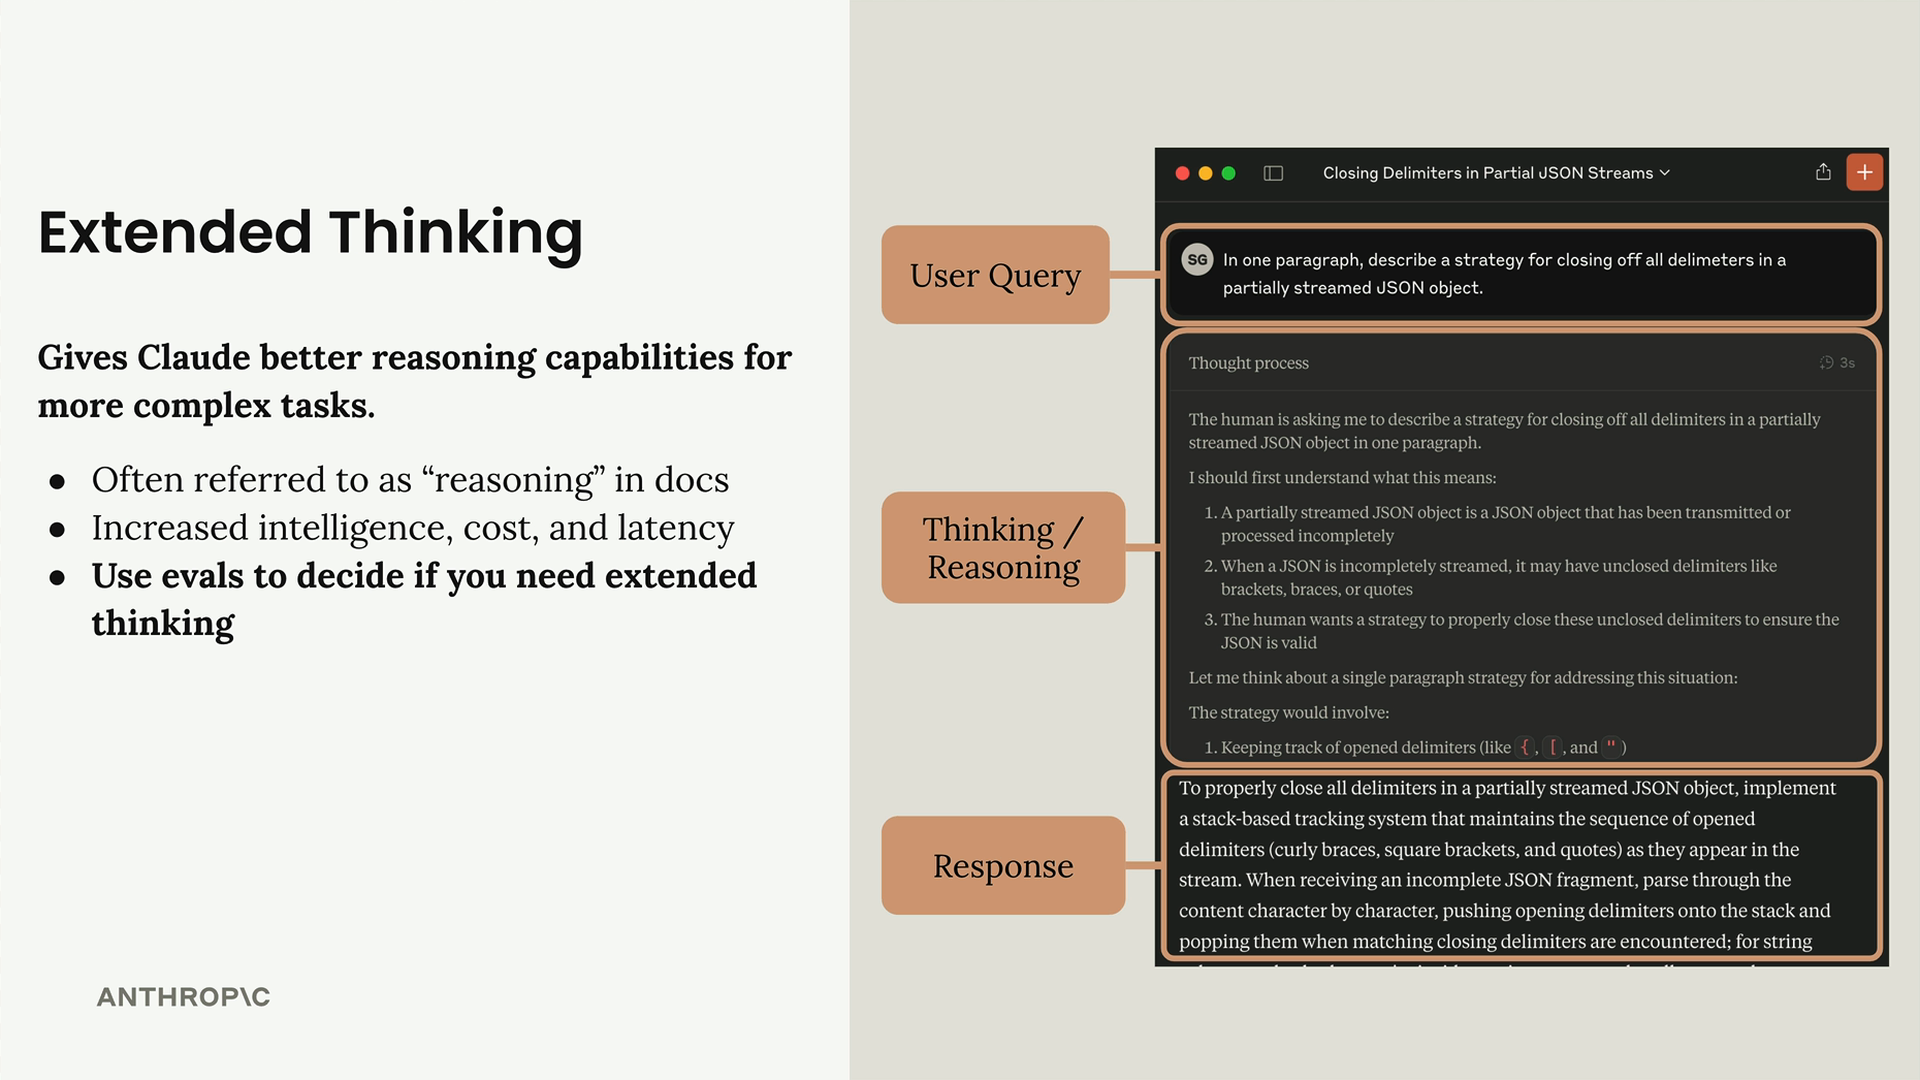
확장 사고의 작동 방식
확장 사고를 활성화하면 Claude의 응답은 하나가 아니라 두 부분으로 구성됩니다:
- Reasoning Content Part - Claude의 내부 사고 과정
- Text Part - 실제로 원했던 최종 응답
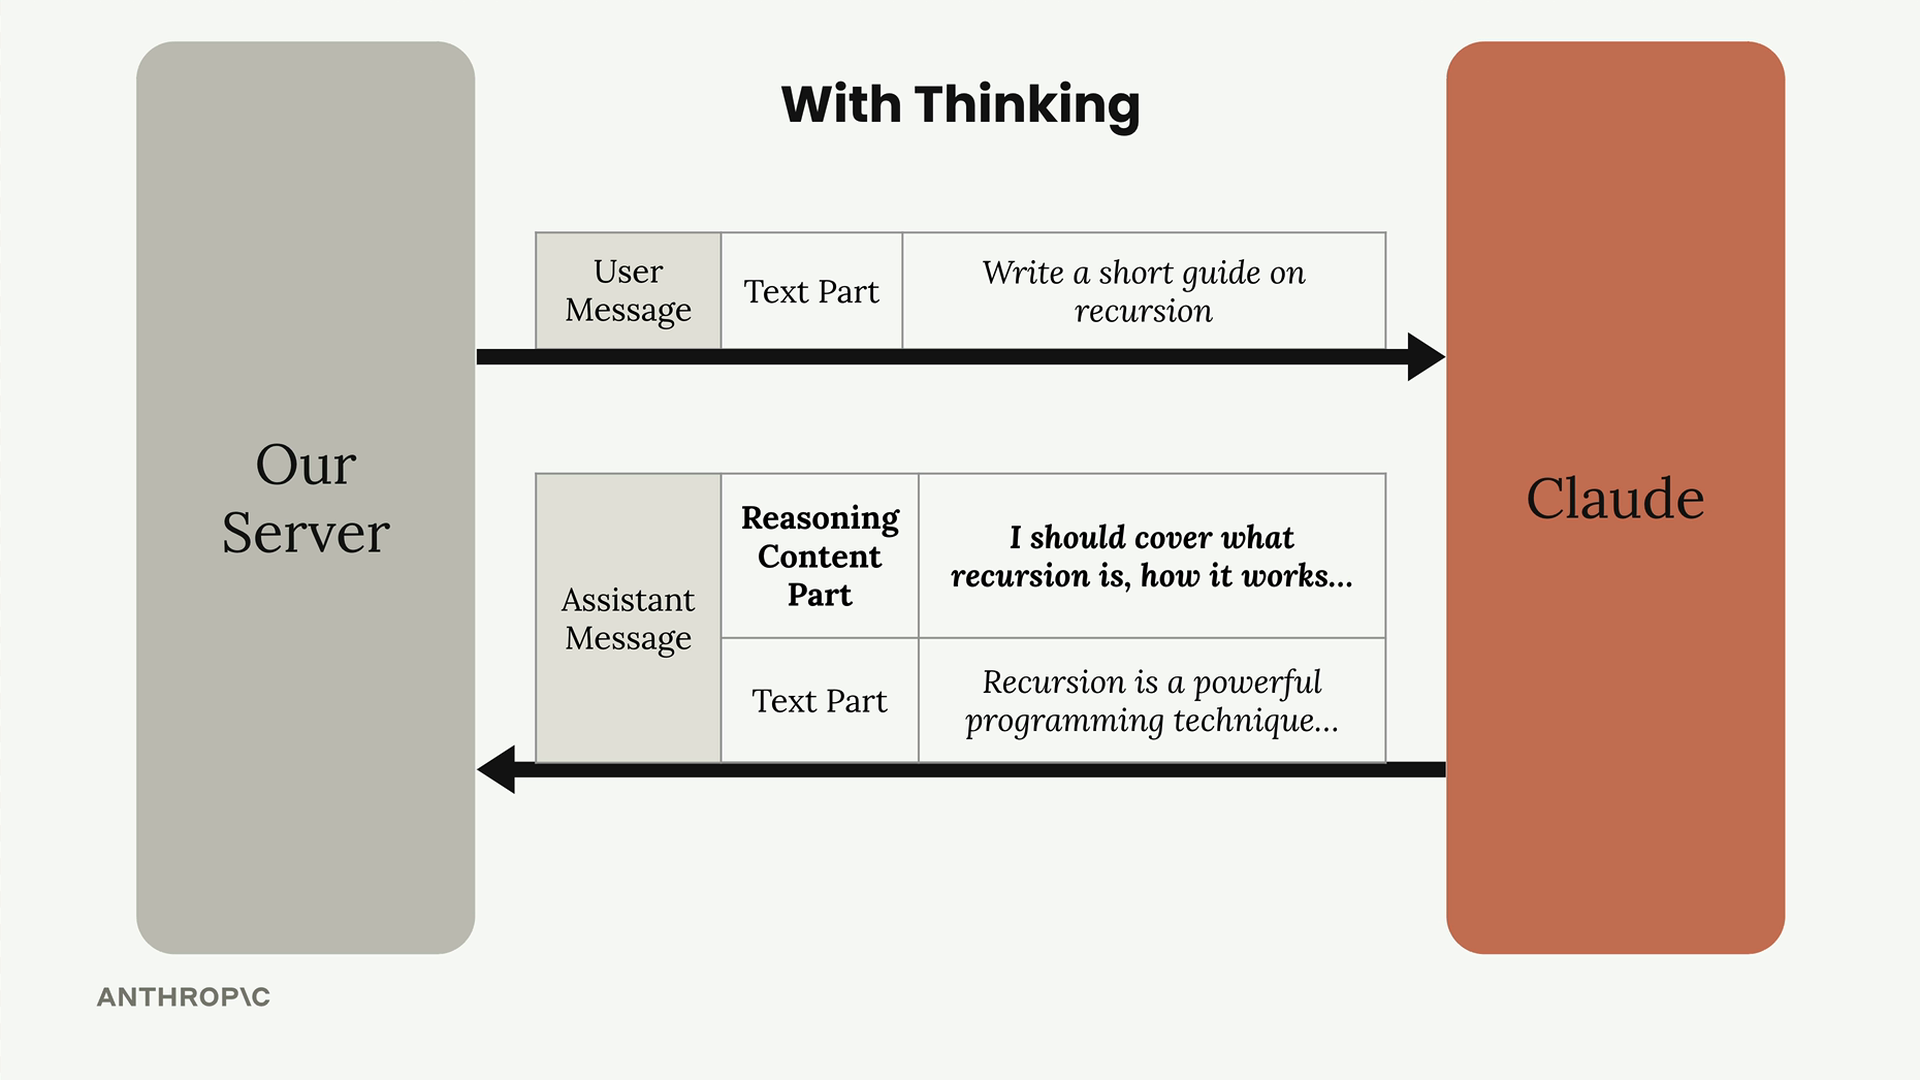
Reasoning content는 Claude가 문제를 어떻게 분해하는지, 무엇을 고려하는지, 그리고 최종 답변에 어떻게 도달하는지를 정확히 보여줍니다. 이러한 투명성은 복잡한 작업을 이해하고 디버깅하는 데 매우 유용할 수 있습니다.
고려해야 할 트레이드오프
확장 사고에는 명확한 이점과 비용이 모두 따릅니다:
- 복잡한 작업에서 더 나은 정확도
- 더 높은 비용 - 모든 사고 토큰에 대해 비용을 지불해야 함
- 증가된 지연 시간 - 사고에는 시간이 걸림
핵심 결정 포인트는 간단합니다: 평가를 활용하세요. 이미 프롬프트를 최적화했음에도 필요한 정확도를 얻지 못하고 있다면, 그때가 바로 확장 사고를 고려할 가치가 있는 시점입니다.
시그니처 시스템
즉시 눈에 띄는 중요한 세부 사항 중 하나는 reasoning content에 첨부된 암호화 서명입니다:
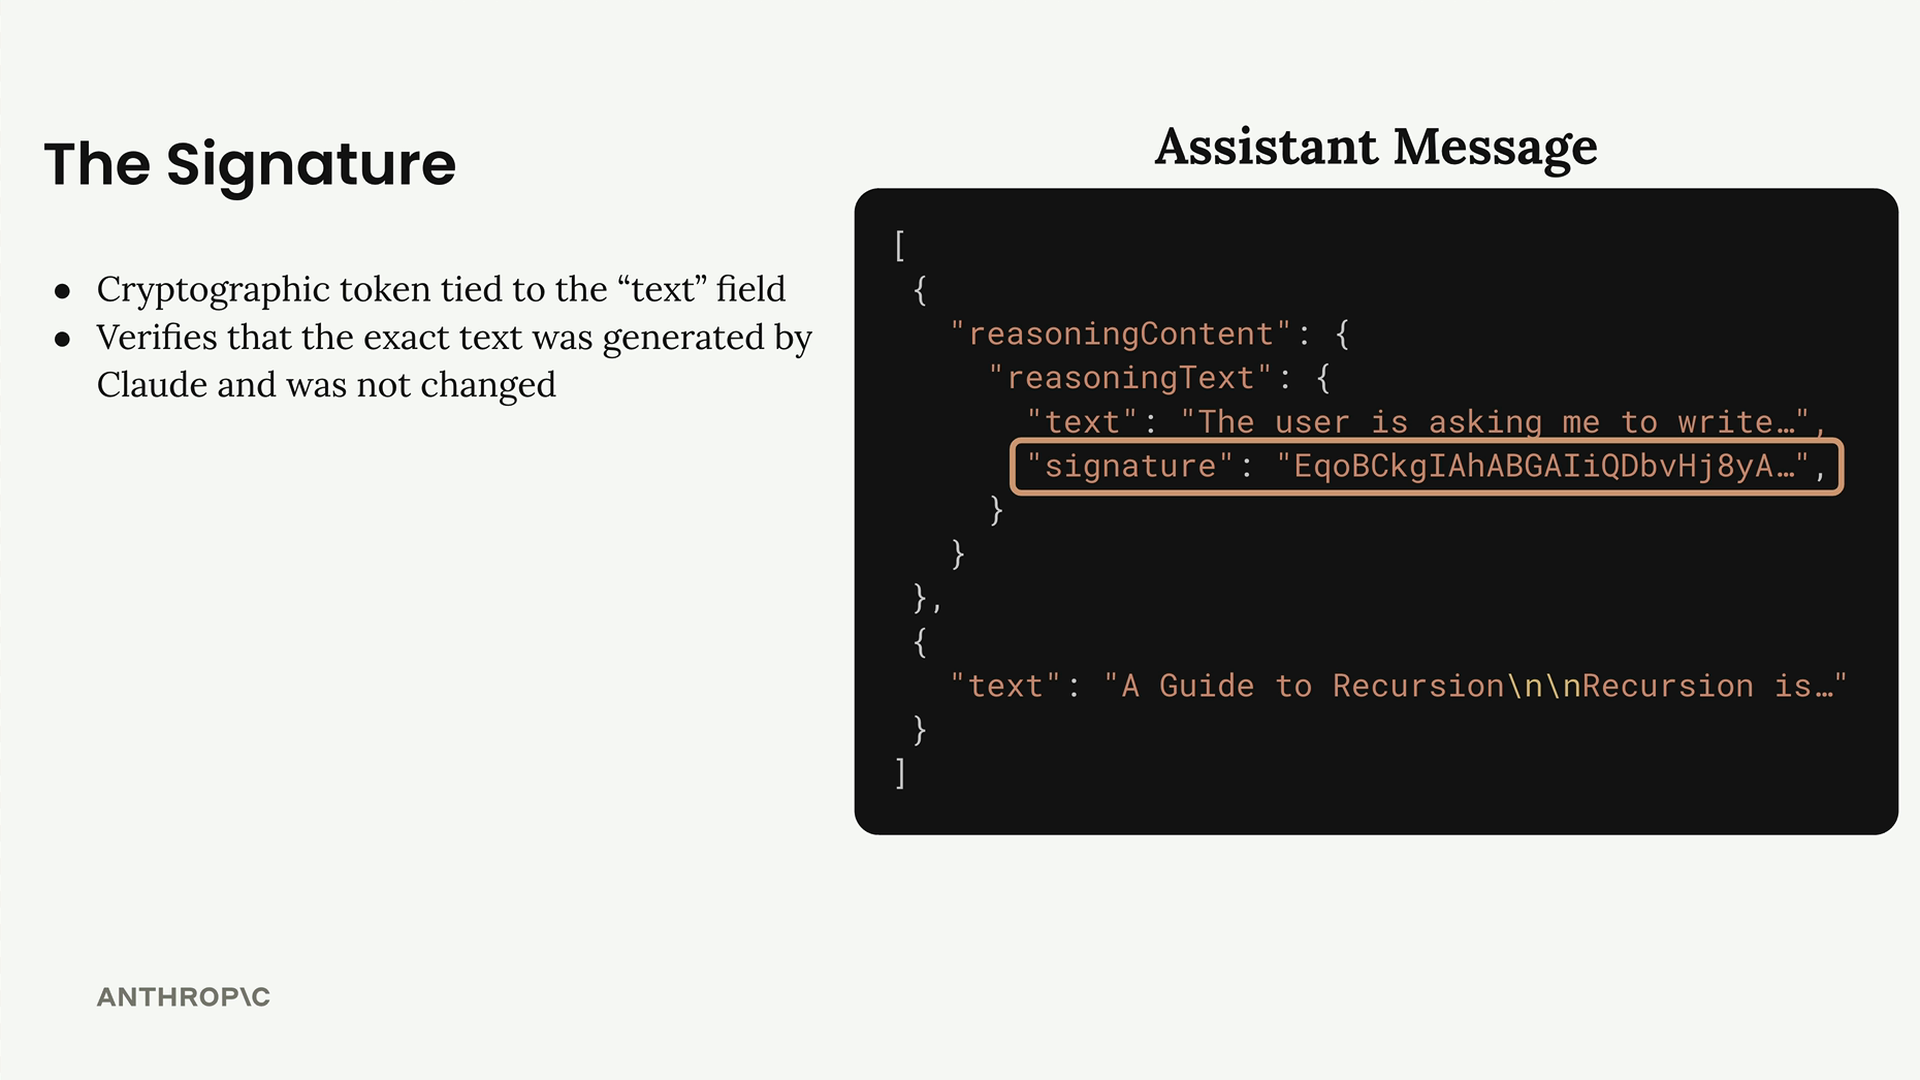
이 서명은 사고 텍스트를 수정할 수 없도록 보장합니다. 후속 대화에 Claude의 이전 추론을 포함하고 싶다면, 서명이 해당 콘텐츠가 변조되지 않았음을 검증합니다. 이는 수정된 추론 텍스트로 인한 잠재적인 안전 문제를 방지합니다.
Redacted Content
때때로 Claude의 사고는 안전 시스템에 의해 플래그가 지정됩니다. 이런 일이 발생하면 읽을 수 있는 사고 텍스트 대신 redactedContent 필드를 받게 됩니다:
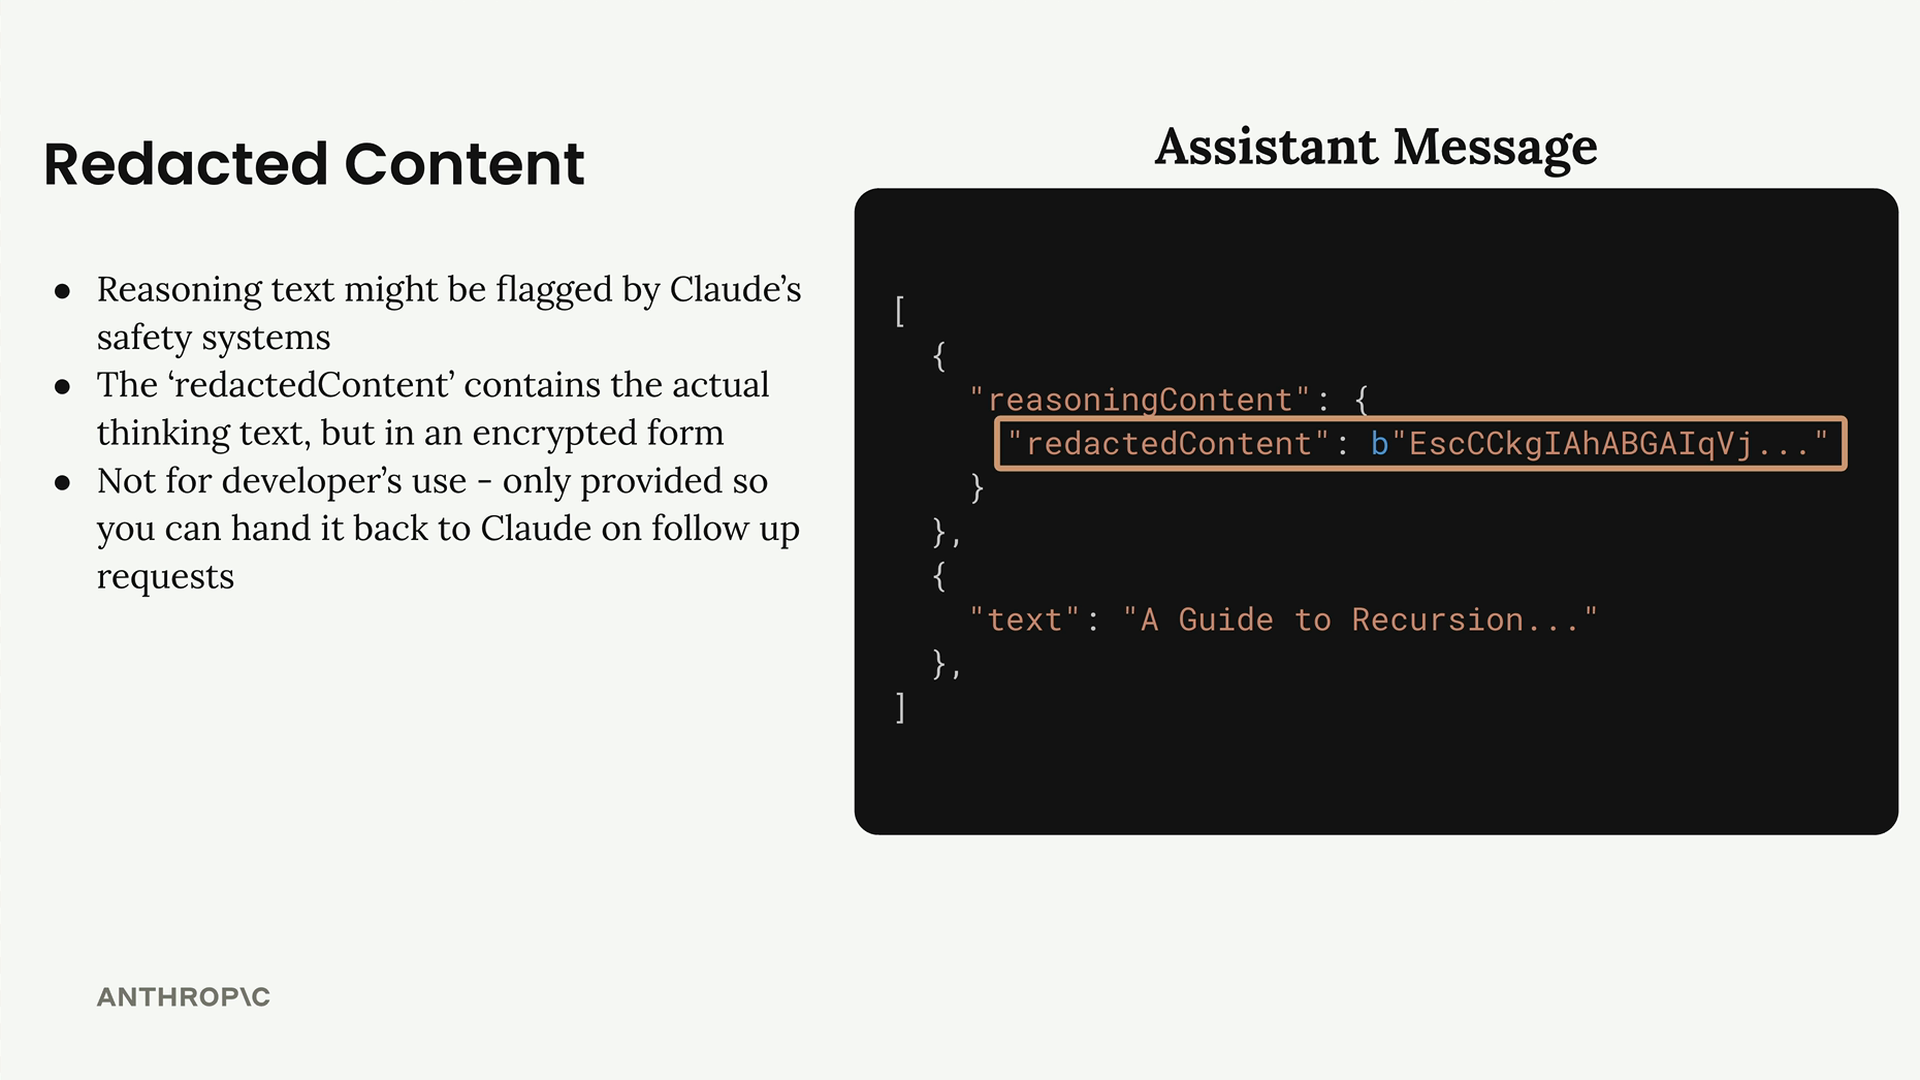
Redacted content는 암호화되어 있지만 여전히 기능적입니다 - 맥락을 잃지 않고 향후 대화에서 Claude에게 다시 전달할 수 있습니다. 단지 개발자인 여러분이 읽을 수 없을 뿐입니다.
구현
Claude Opus 5 및 Claude Sonnet 5와 같은 현재 Claude 모델에서는 사고가 adaptive thinking(적응형 사고)으로 실행되며 기본적으로 활성화되어 있습니다: Claude가 각 요청에 필요한 추론량을 결정하며, 관리해야 할 토큰 예산이 없습니다. 이러한 모델들은 여러분이 요청하지 않는 한 reasoning text를 생략하므로, 이를 보려면 display를 summarized로 설정하세요:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
adaptive thinking이 켜져 있으면, 단순한 질문은 대개 빠르게 돌아오고 더 어려운 질문은 더 많은 추론 시간을 얻습니다. Claude가 얼마나 사고할지 안내하려면 adaptive thinking과 effort 매개변수를 결합할 수 있습니다. effort 수준은 Claude의 사고 배분에 대한 부드러운 가이드 역할을 하며, 이는 여러분이 그렇지 않으면 직접 관리해야 할 수동 토큰 예산을 대신합니다.
이전에 확장 사고를 사용해 본 적이 있다면, 수동 구성이 단계적으로 폐지되고 있다는 점에 유의하세요: budget_tokens와 함께 사용하는 thinking.type: "enabled"는 Claude Opus 4.6 및 Claude Sonnet 4.6에서 지원 중단되었으며, Claude Opus 4.7 이후 모델(Claude Opus 5 및 Claude Sonnet 5 포함)은 이를 지원하지 않고 해당 요청을 400 오류로 거부합니다. 대신 effort 매개변수와 함께 thinking.type: "adaptive"를 사용하세요.
Adaptive thinking을 지원하지 않는 모델
Claude 4.5 모델(Claude Haiku 4.5, Claude Sonnet 4.5, Claude Opus 4.5) 및 그 이전 모델은 adaptive thinking을 지원하지 않습니다. 이러한 모델에서는 수동 토큰 예산으로 확장 사고를 활성화합니다:
additional_model_fields["thinking"] = {
    "type": "enabled",
    "budget_tokens": thinking_budget
}thinking_budget은 Claude가 추론에 사용할 수 있는 토큰 수를 제어합니다. 최소값은 1024 토큰이지만, 복잡한 문제에는 더 많은 토큰이 필요할 수 있습니다. Claude와 관련된 다른 모든 것과 마찬가지로, 자신의 평가를 활용하여 사용 사례에 적합한 예산을 찾으세요.
업데이트된 chat 함수는 다음과 같습니다:
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    tool_choice="auto",
    text_editor=None,
    thinking=False,
    thinking_budget=1024
):
구현 테스트하기
확장 사고를 처리하는 애플리케이션을 구축할 때는 일반적인 reasoning content와 redacted content 시나리오를 모두 테스트하고 싶을 것입니다. 실제로 Claude가 redacted content를 반환하도록 강제하는 특별한 테스트 문자열이 있습니다 - 코드가 두 경우를 모두 제대로 처리하는지 확인하는 데 유용합니다.
확장 사고에 관해 가장 중요하게 기억해야 할 점은 이를 사용할지에 대한 결정이 항상 데이터에 기반해야 한다는 것입니다. 먼저 평가를 실행하고, 프롬프트를 최적화한 다음, 복잡한 작업에서 정확도를 높이는 데 그 추가적인 효과가 필요한 경우에만 확장 사고를 고려하세요. 이러한 원칙은 단순한 습관에 기반합니다: 더 많은 역량을 동원하기 전에 무엇이 좋은 결과인지 먼저 정해두는 것입니다. 작업에 필요한 정확도를 알고 있으면, 추측하는 대신 확장 사고가 그 비용만큼의 가치가 있는지 판단할 수 있습니다.
실습: 직접 adaptive thinking 실행해보기
Adaptive thinking은 그것이 결정을 내리는 모습을 직접 지켜보면서 이해하는 것이 가장 쉽습니다. 지금까지 chat 함수를 구축해온 코드에서 이를 켜보세요:
additional_model_fields["thinking"] = {
    "type": "adaptive",
    "display": "summarized"
}
이제 동일한 구성을 통해 두 가지 요청을 보내세요. 먼저 이미 답을 알고 있는 간단한 사실 확인 질문을 해보세요. 그다음 자신의 업무에서 나온 다단계 분석 문제처럼 진짜로 어려운 질문을 해보세요. adaptive thinking을 지원하지 않는 모델로 작업하고 있다면, 위 섹션에 나온 수동 budget_tokens 구성으로 사고를 활성화하고 동일한 두 요청을 실행하세요.
사고가 무엇을 했는지 확인하기
플래그를 설정하는 것만으로는 요청이 수락되었다는 것만 증명할 뿐입니다. 다음 확인 사항들은 사고가 실제로 무엇을 했는지 알려줍니다:
- 사고가 작동했는지 확인하세요. 이제 각 응답은 텍스트만 있는 것이 아니라 reasoning content와 최종 텍스트 두 부분을 포함해야 합니다. 한 가지 예외는 앞서 본 redacted content입니다:
redactedContent필드는 사고는 실행되었지만 텍스트가 암호화되었음을 의미합니다. - Reasoning content를 읽어보세요. 질문을 단순히 반복하는 것이 아니라 실제로 그 질문에 대해 추론하고 있는지 확인하세요. 이는 나중에 복잡한 작업을 디버깅할 때 의존하게 될 것과 동일한 투명성입니다.
- 두 요청을 비교하세요. 간단한 질문은 대개 추론이 거의 없이 빠르게 돌아오는 반면, 어려운 질문은 눈에 띄게 더 많은 추론을 받습니다. 그 차이가 바로 adaptive thinking이 여러분 대신 배분 결정을 내리는 모습입니다.
- 비용을 저울질하세요. 모든 사고 토큰에 대해 비용을 지불해야 하므로, 어려운 질문에 대한 답변이 사고 없이 얻는 답변보다 더 나은지 확인하세요. 그것을 판단하는 것은 여러분의 평가이며, reasoning text가 나타나는 것을 보는 것만으로는 그것을 대체할 수 없습니다.
이 레슨에서 기억해 둘 만한 행동은 이것입니다: 새로운 작업에서 확장 사고를 활성화할 때마다, 몇 가지 대표적인 요청에 대해 reasoning content를 읽어보고 설정을 유지할지 결정하기 전에 평가를 다시 실행하세요.