시맨틱 검색(벡터 임베딩)과 렉시컬 검색(BM25)이 각각 독립적으로 작동하게 되면, 다음 단계는 이 둘을 하나의 통합 검색 파이프라인으로 결합하는 것입니다. 이 하이브리드 방식은 두 방법의 장점을 모두 활용하여 더 정확한 결과를 제공합니다.
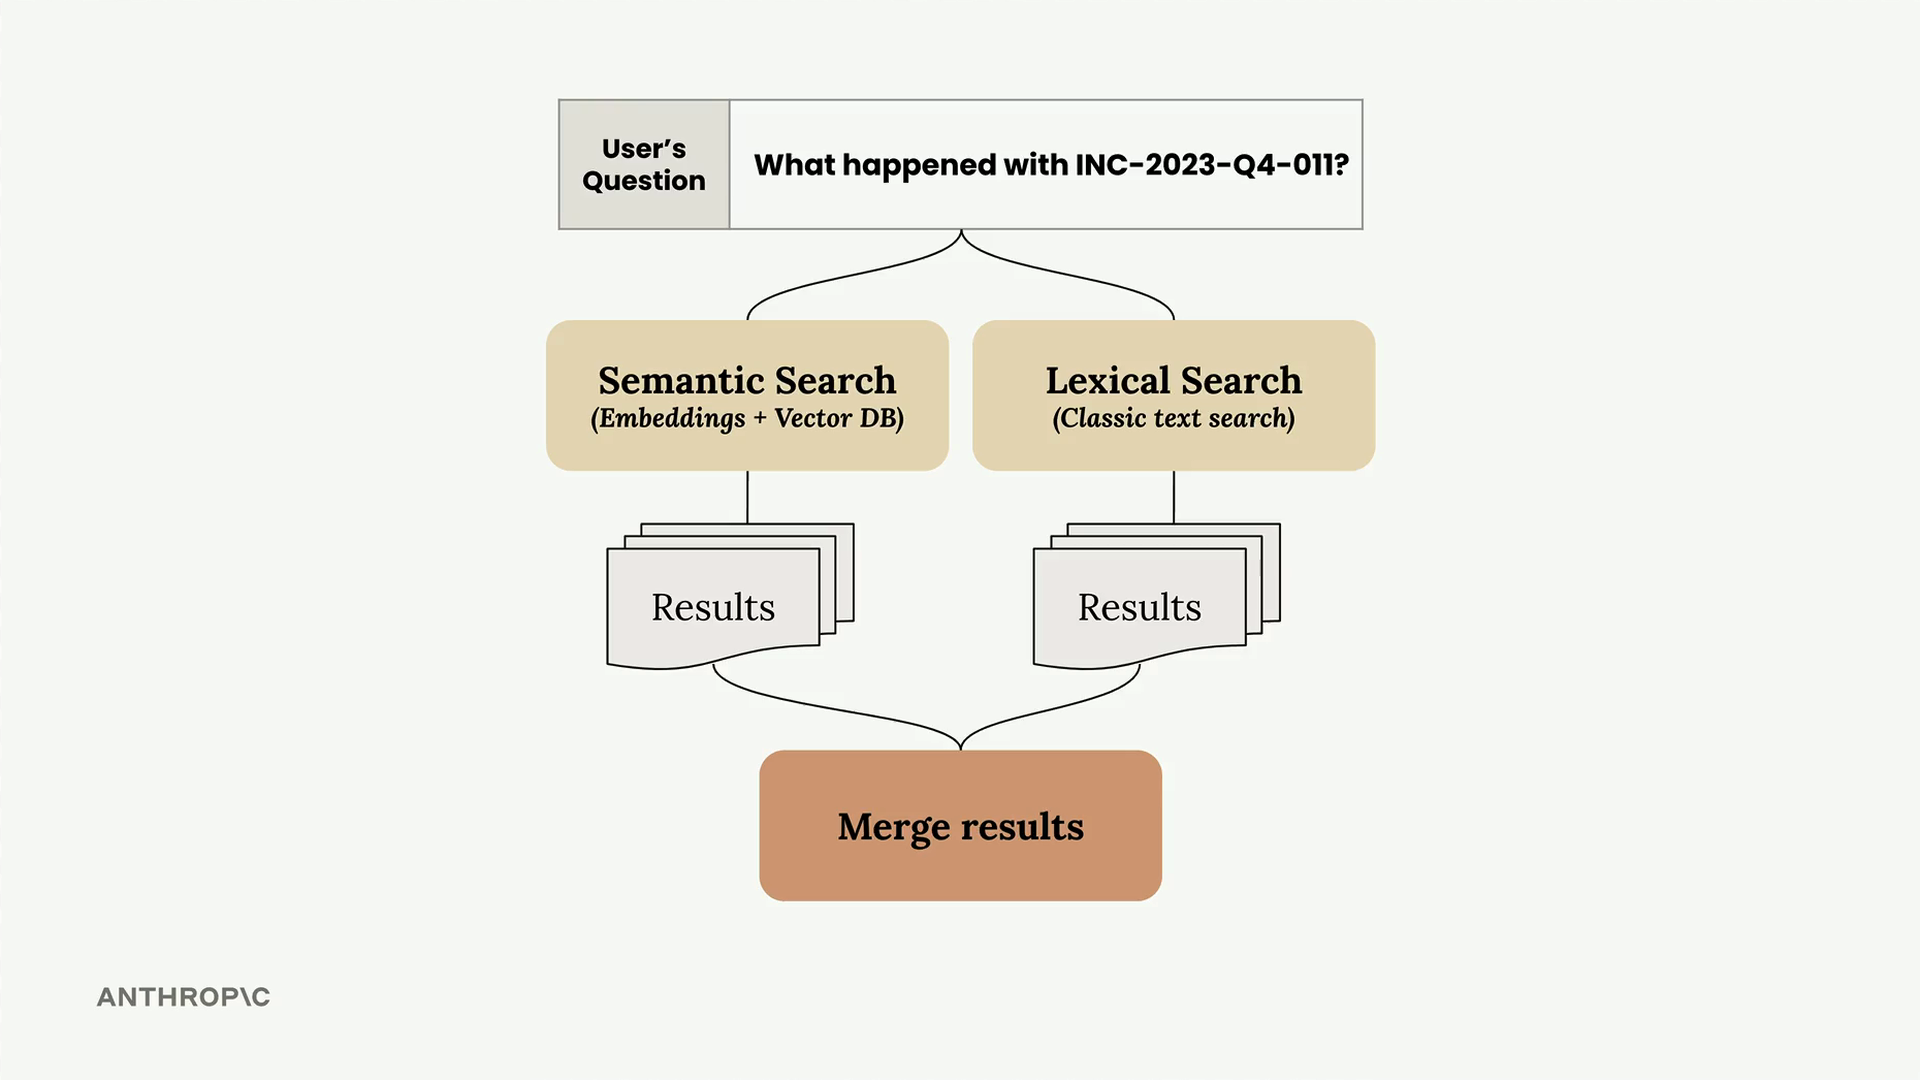
통합 인터페이스 구축하기
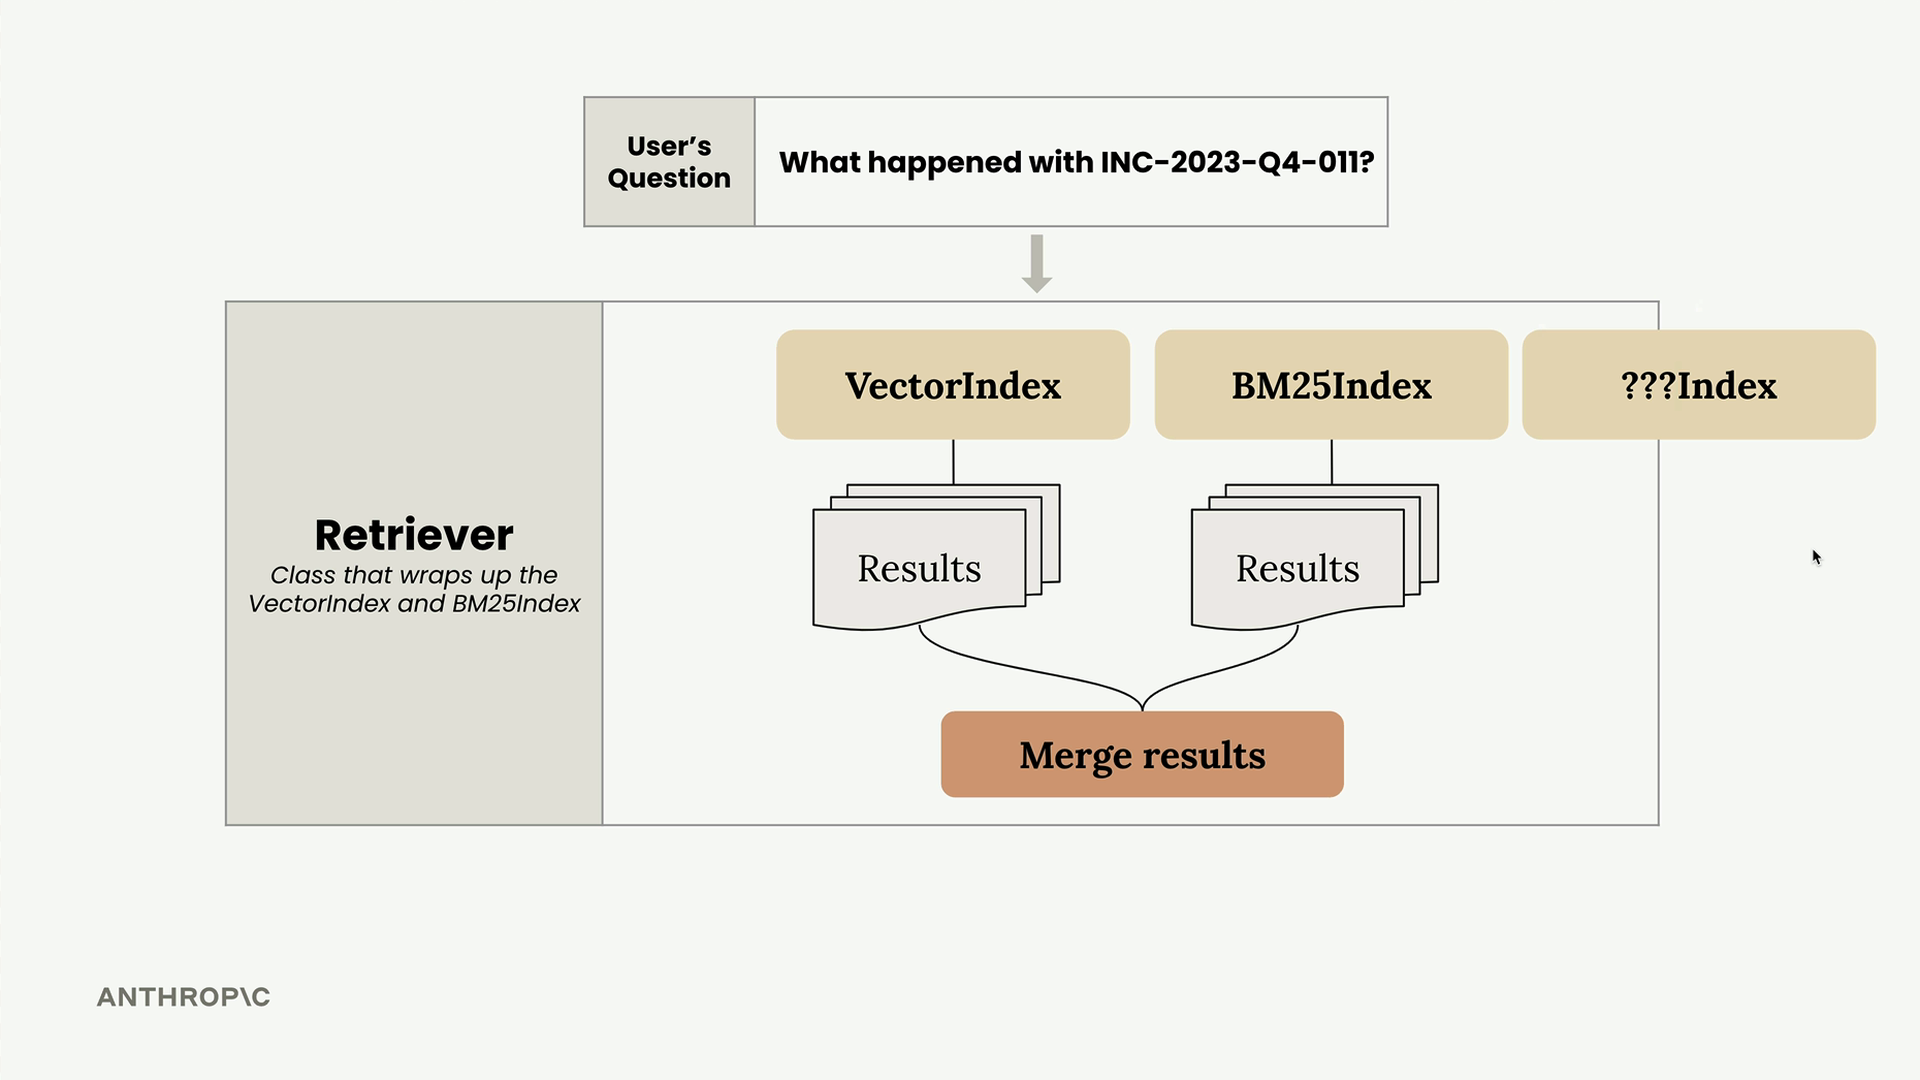
두 검색 구현체는 거의 동일한 API를 공유합니다 - 둘 다 add_document()와 search() 메서드를 가지고 있습니다. 이러한 일관성 덕분에 두 방식을 조율하는 단일 Retriever 클래스로 감싸는 작업이 쉬워집니다.
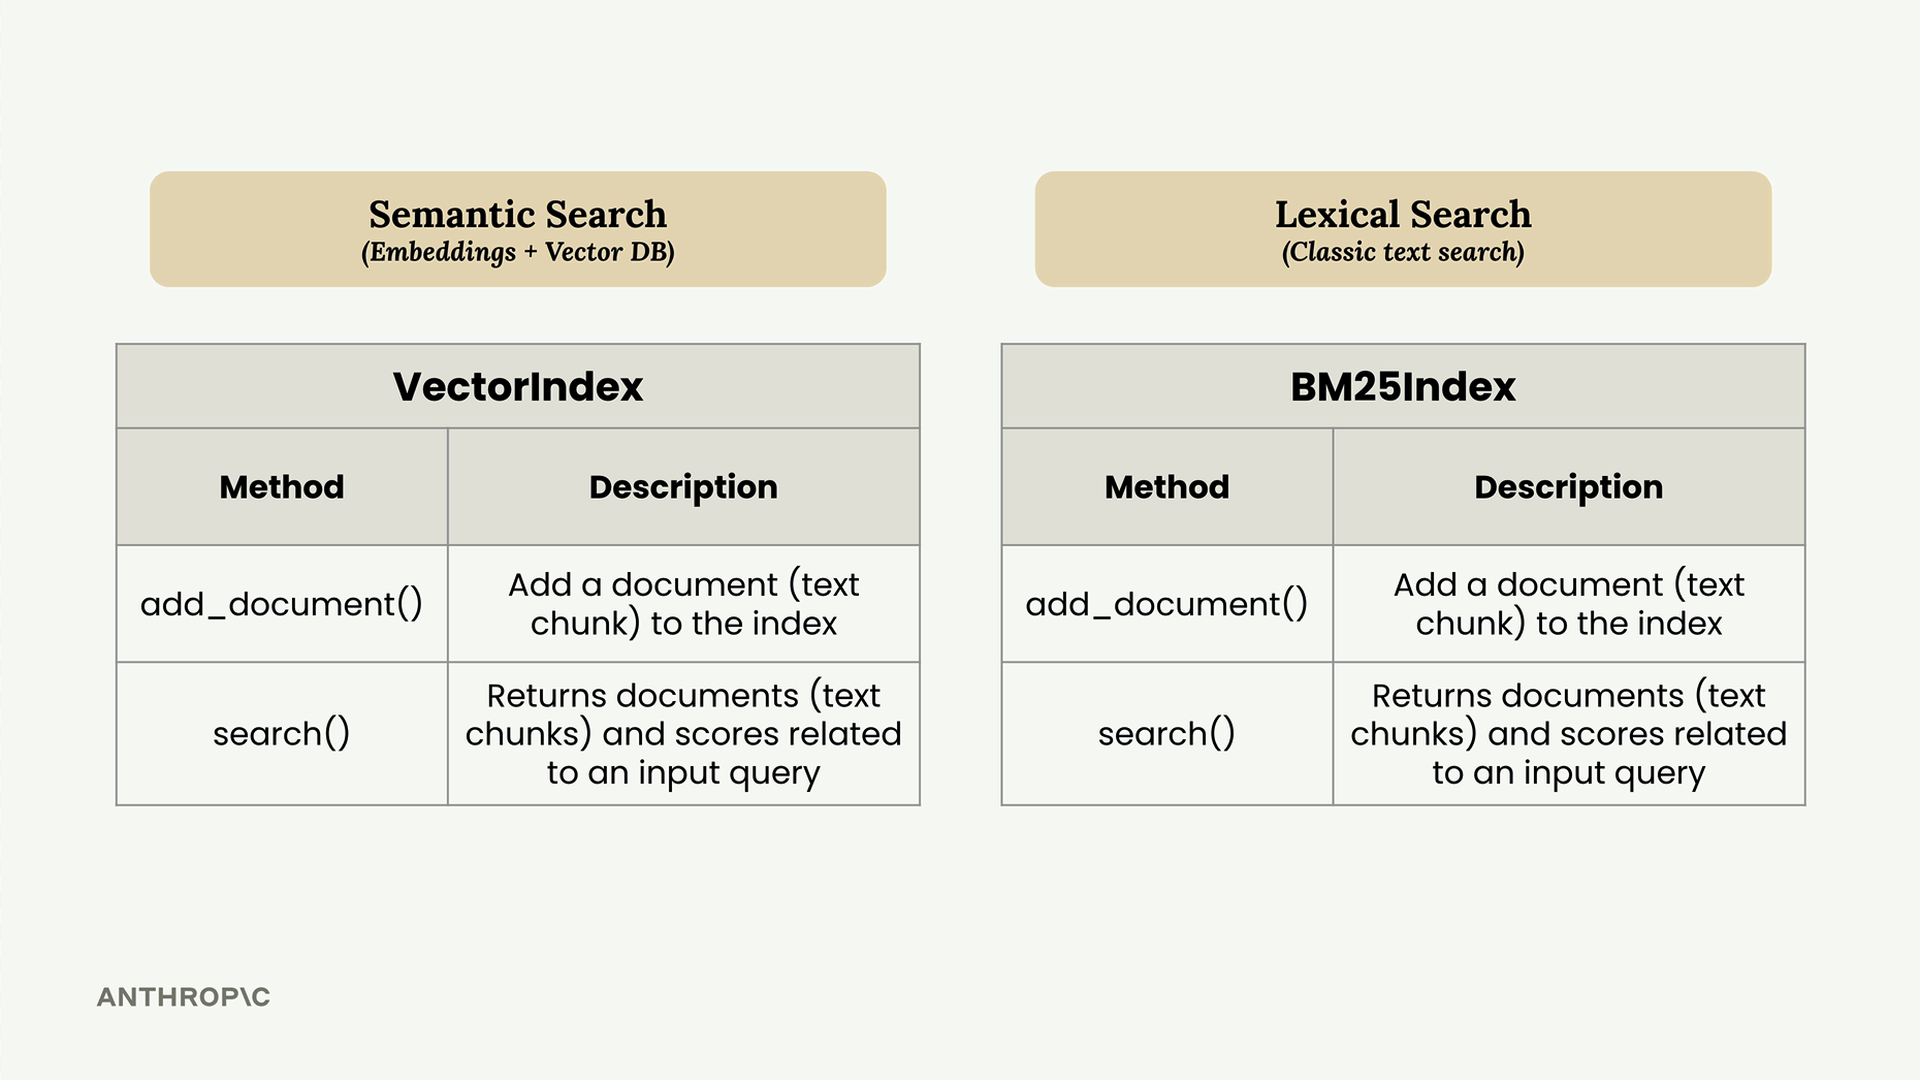
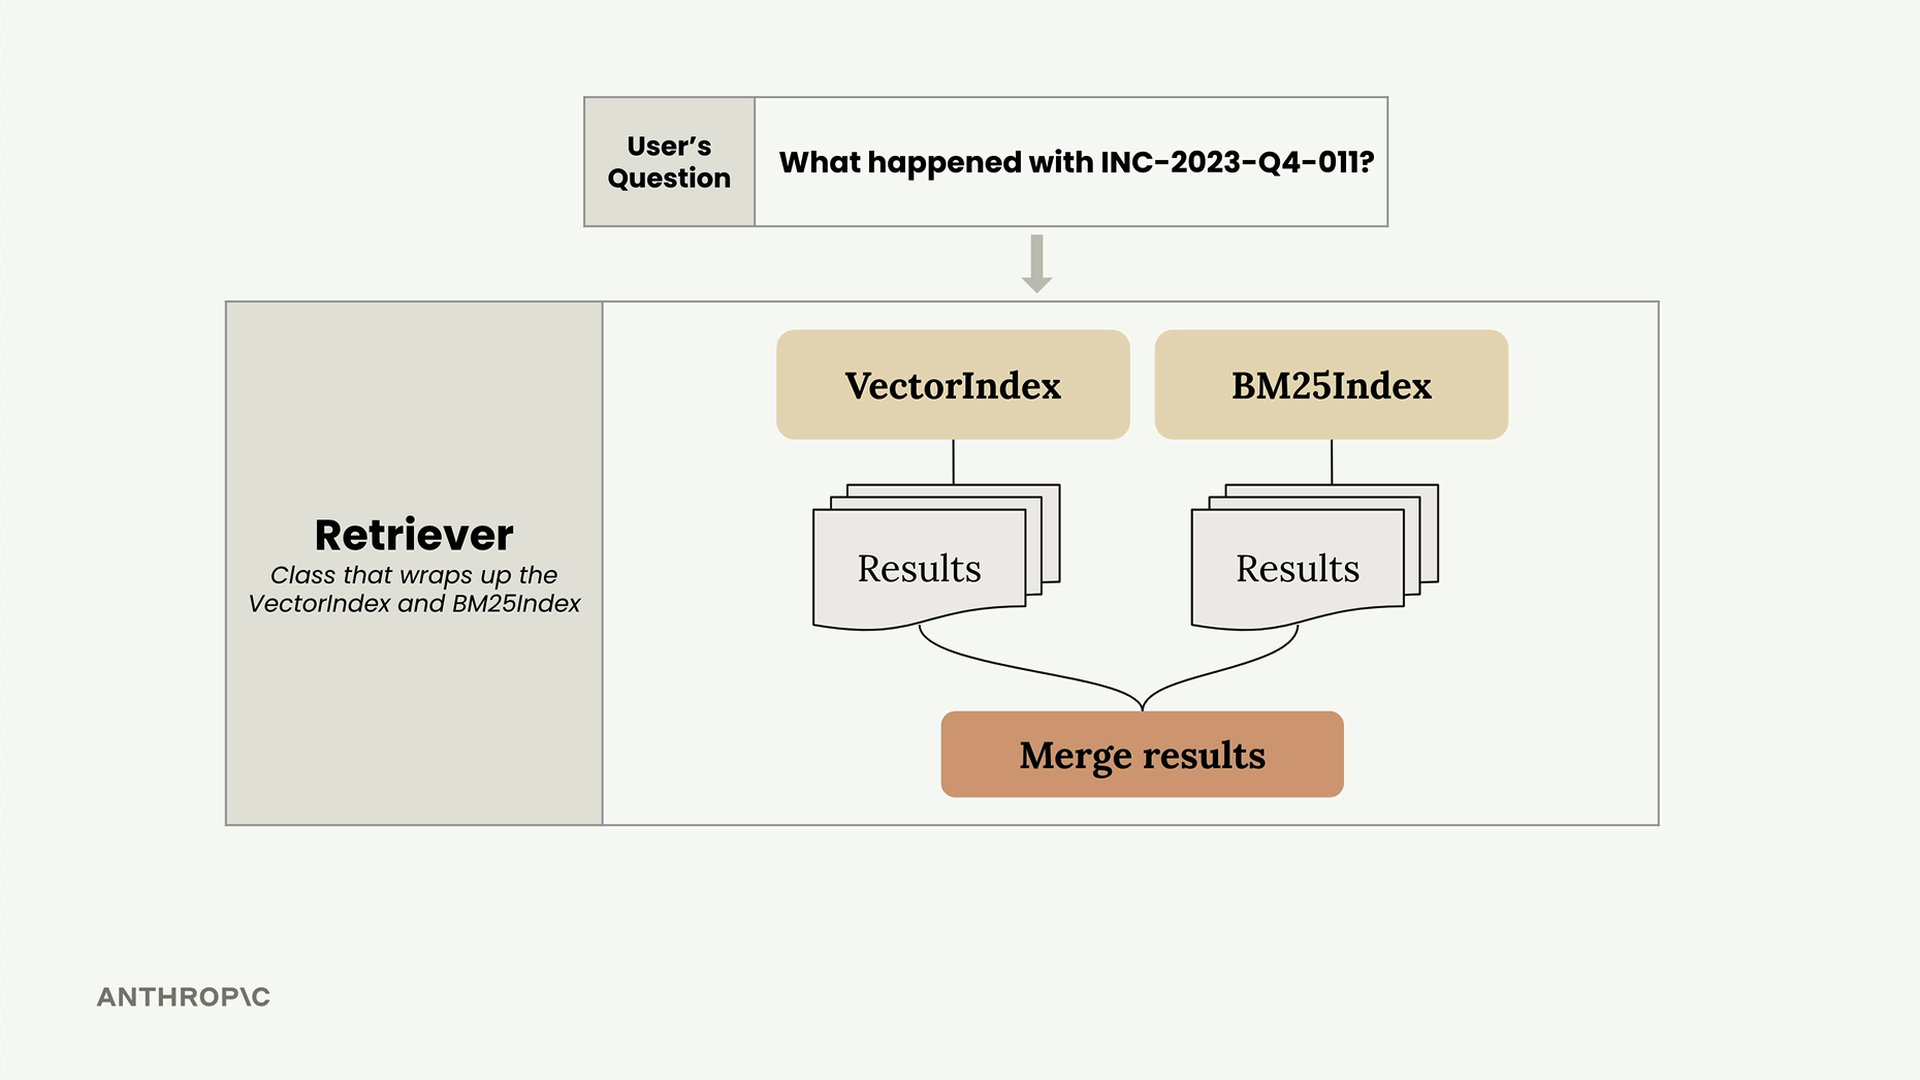
Retriever는 다음과 같은 역할을 하는 조율자입니다:
- 사용자의 질문을 수신합니다
- 이를 VectorIndex와 BM25Index 양쪽으로 전달합니다
- 두 시스템에서 결과를 수집합니다
- 랭킹 알고리즘을 사용해 결과를 병합합니다
Reciprocal Rank Fusion
어려운 점은 서로 다른 검색 방법의 결과를 병합하는 것입니다. 각 시스템은 서로 다른 점수 산정 방식으로 결과를 반환하기 때문에, 점수를 단순히 직접 합산할 수는 없습니다. 대신 Reciprocal Rank Fusion(RRF)이라는 기법을 사용합니다.
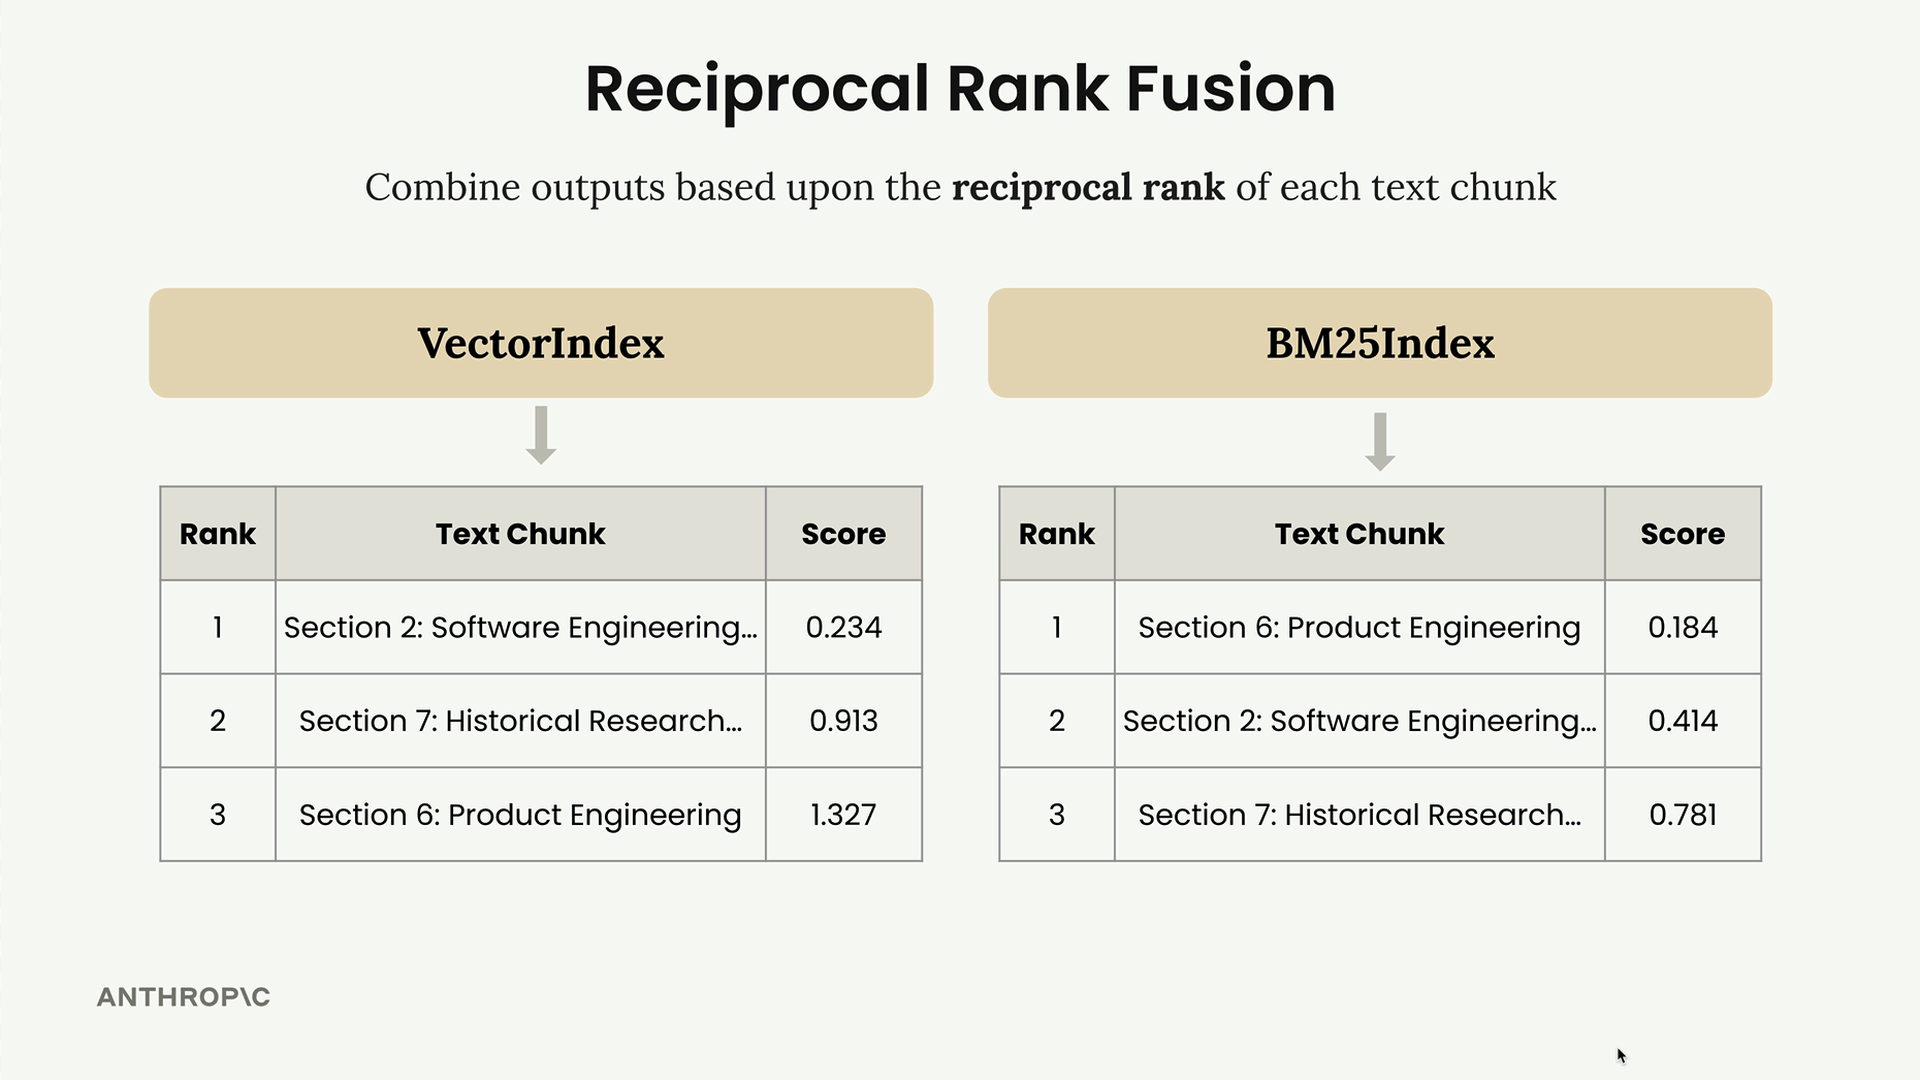
실제 예시를 통해 RRF가 어떻게 작동하는지 살펴보겠습니다. VectorIndex가 Section 2, Section 7, Section 6 순으로 결과를 반환했다고 가정해 보겠습니다. 한편, BM25Index는 Section 6, Section 2, Section 7 순으로 결과를 반환했습니다.
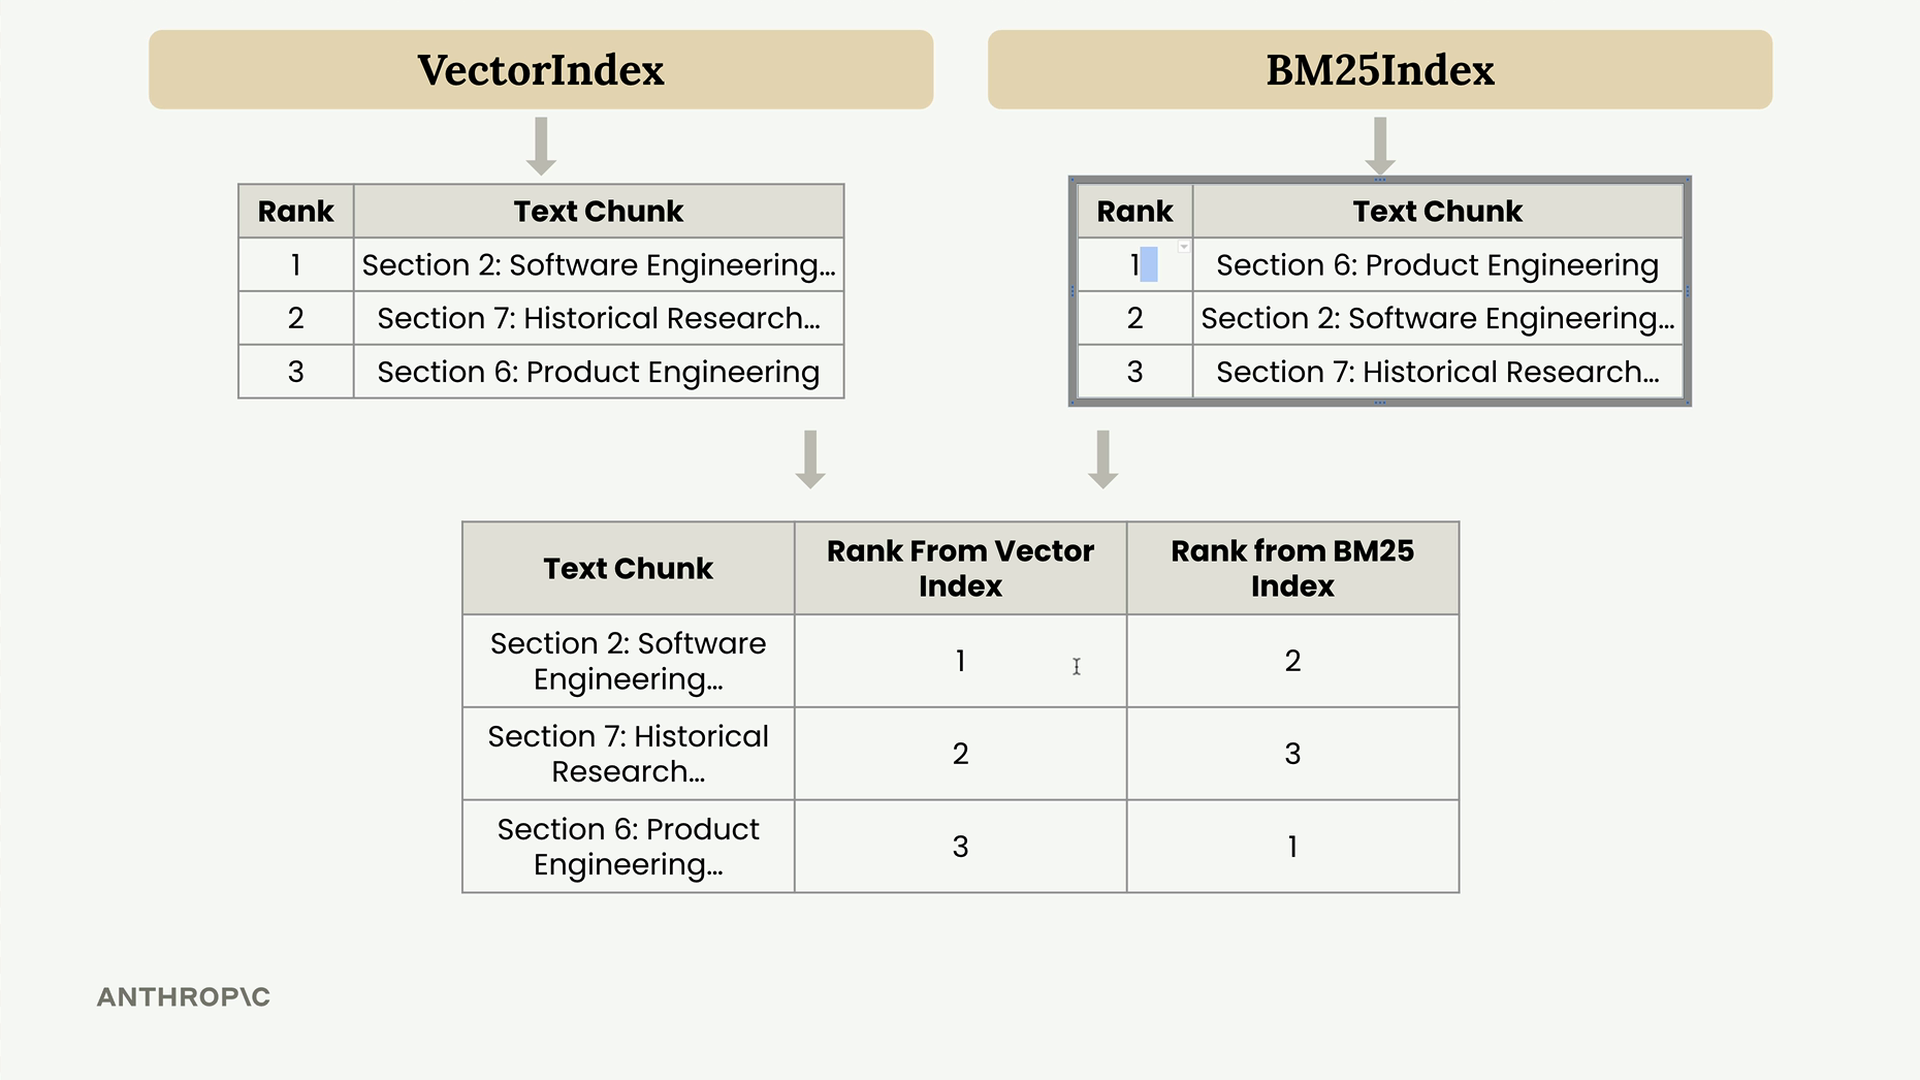
이 결과들을 병합하기 위해, 각 텍스트 청크가 두 시스템에서 각각 몇 위인지 보여주는 결합 표를 만듭니다:
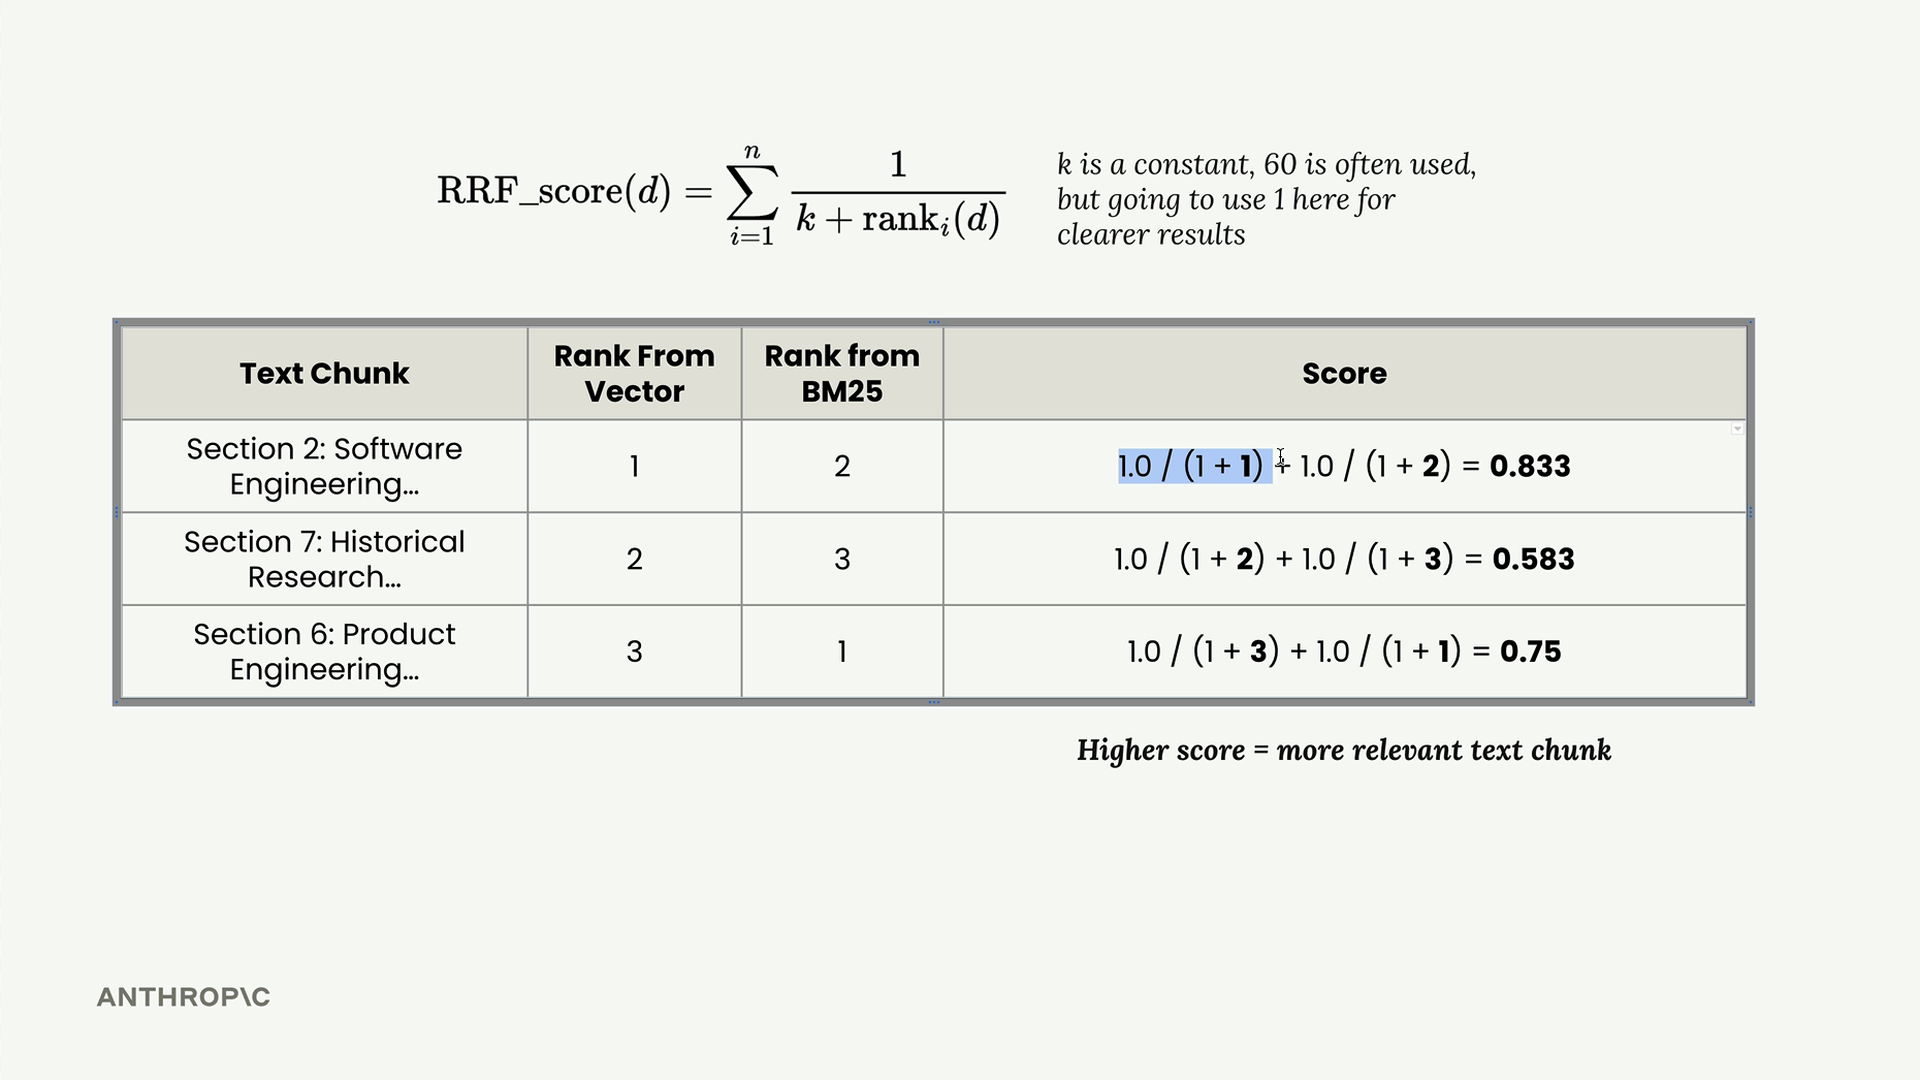
RRF 공식은 각 문서에 대한 점수를 다음과 같이 계산합니다:
RRF_score(d) = Σ(1 / (k + rank_i(d)))여기서 k는 상수(일반적으로 60이지만, 더 명확한 결과를 위해서는 1도 잘 작동합니다)이고, rank_i(d)는 i번째 랭킹 시스템에서 문서 d의 순위입니다.
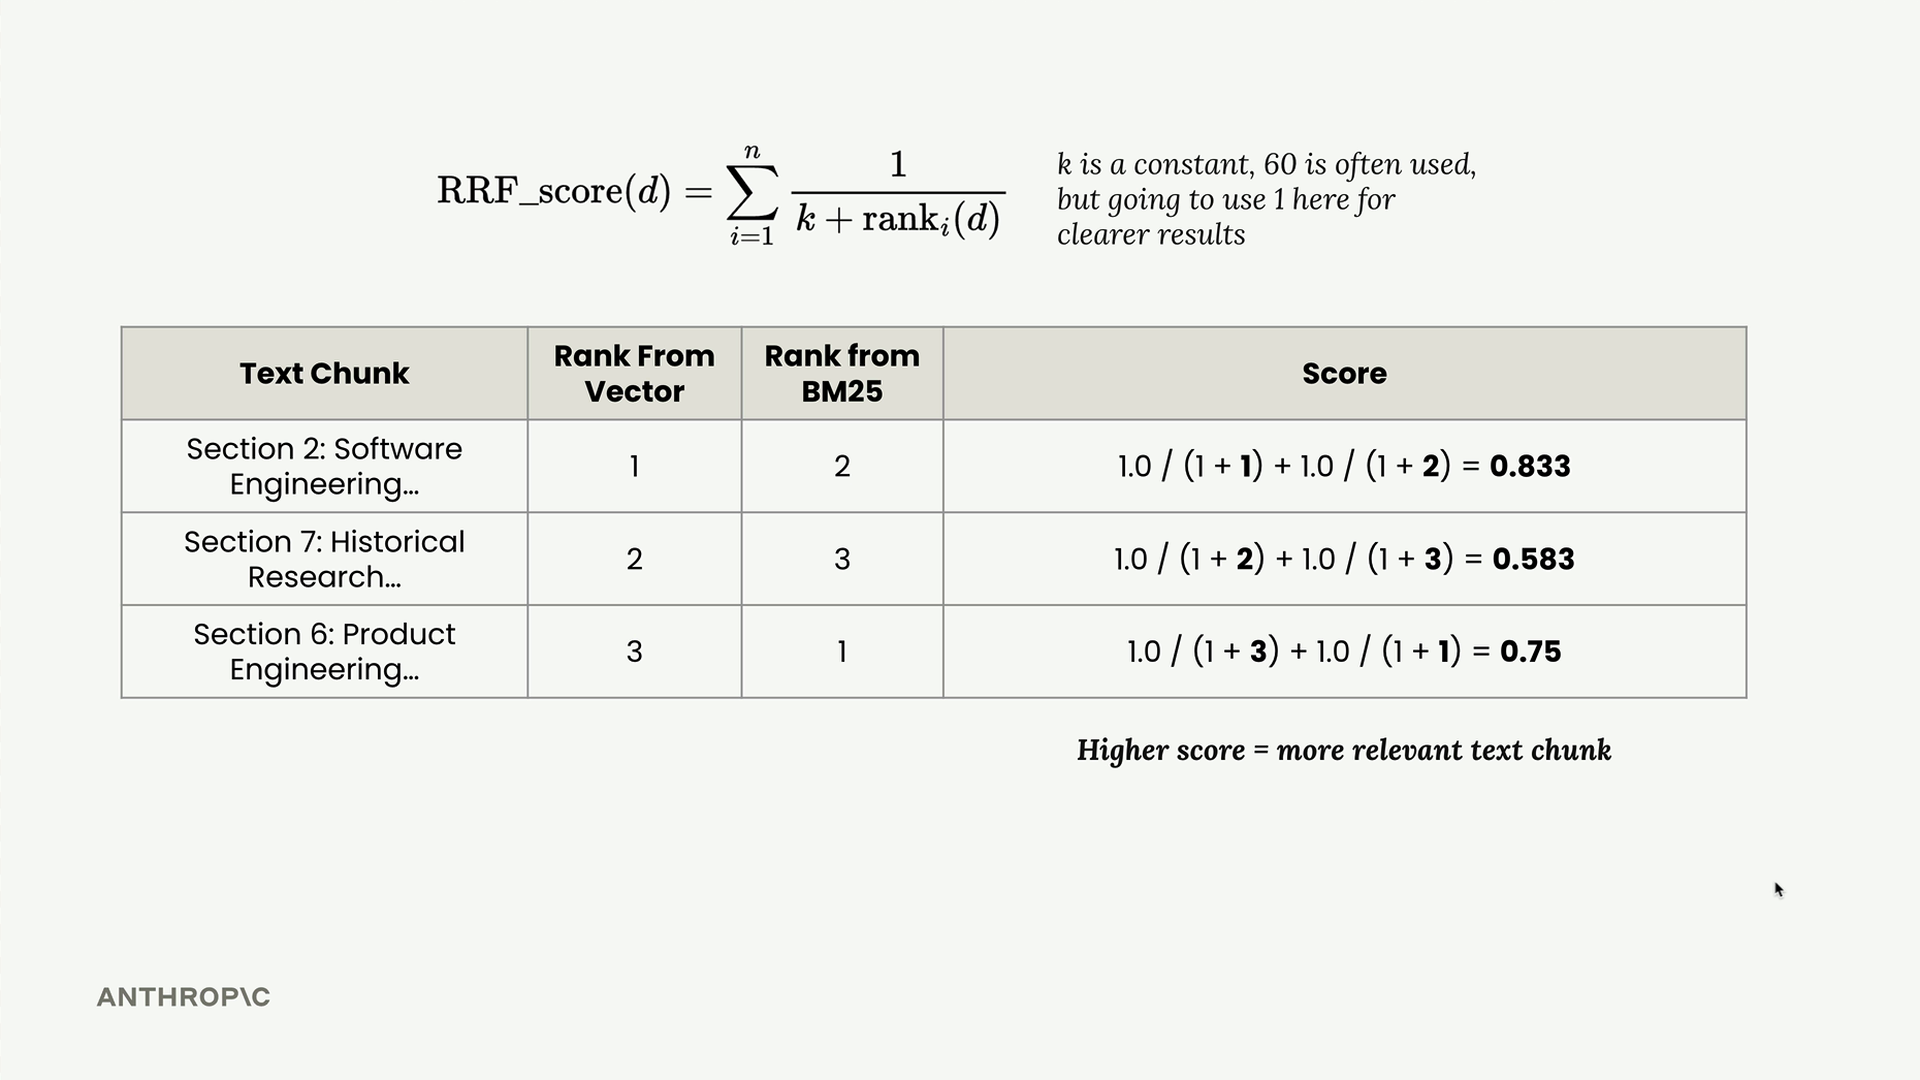
각 텍스트 청크에 대해 다음과 같이 계산합니다:
- Section 2: 1.0/(1+1) + 1.0/(1+2) = 0.833
- Section 7: 1.0/(1+2) + 1.0/(1+3) = 0.583
- Section 6: 1.0/(1+3) + 1.0/(1+1) = 0.75
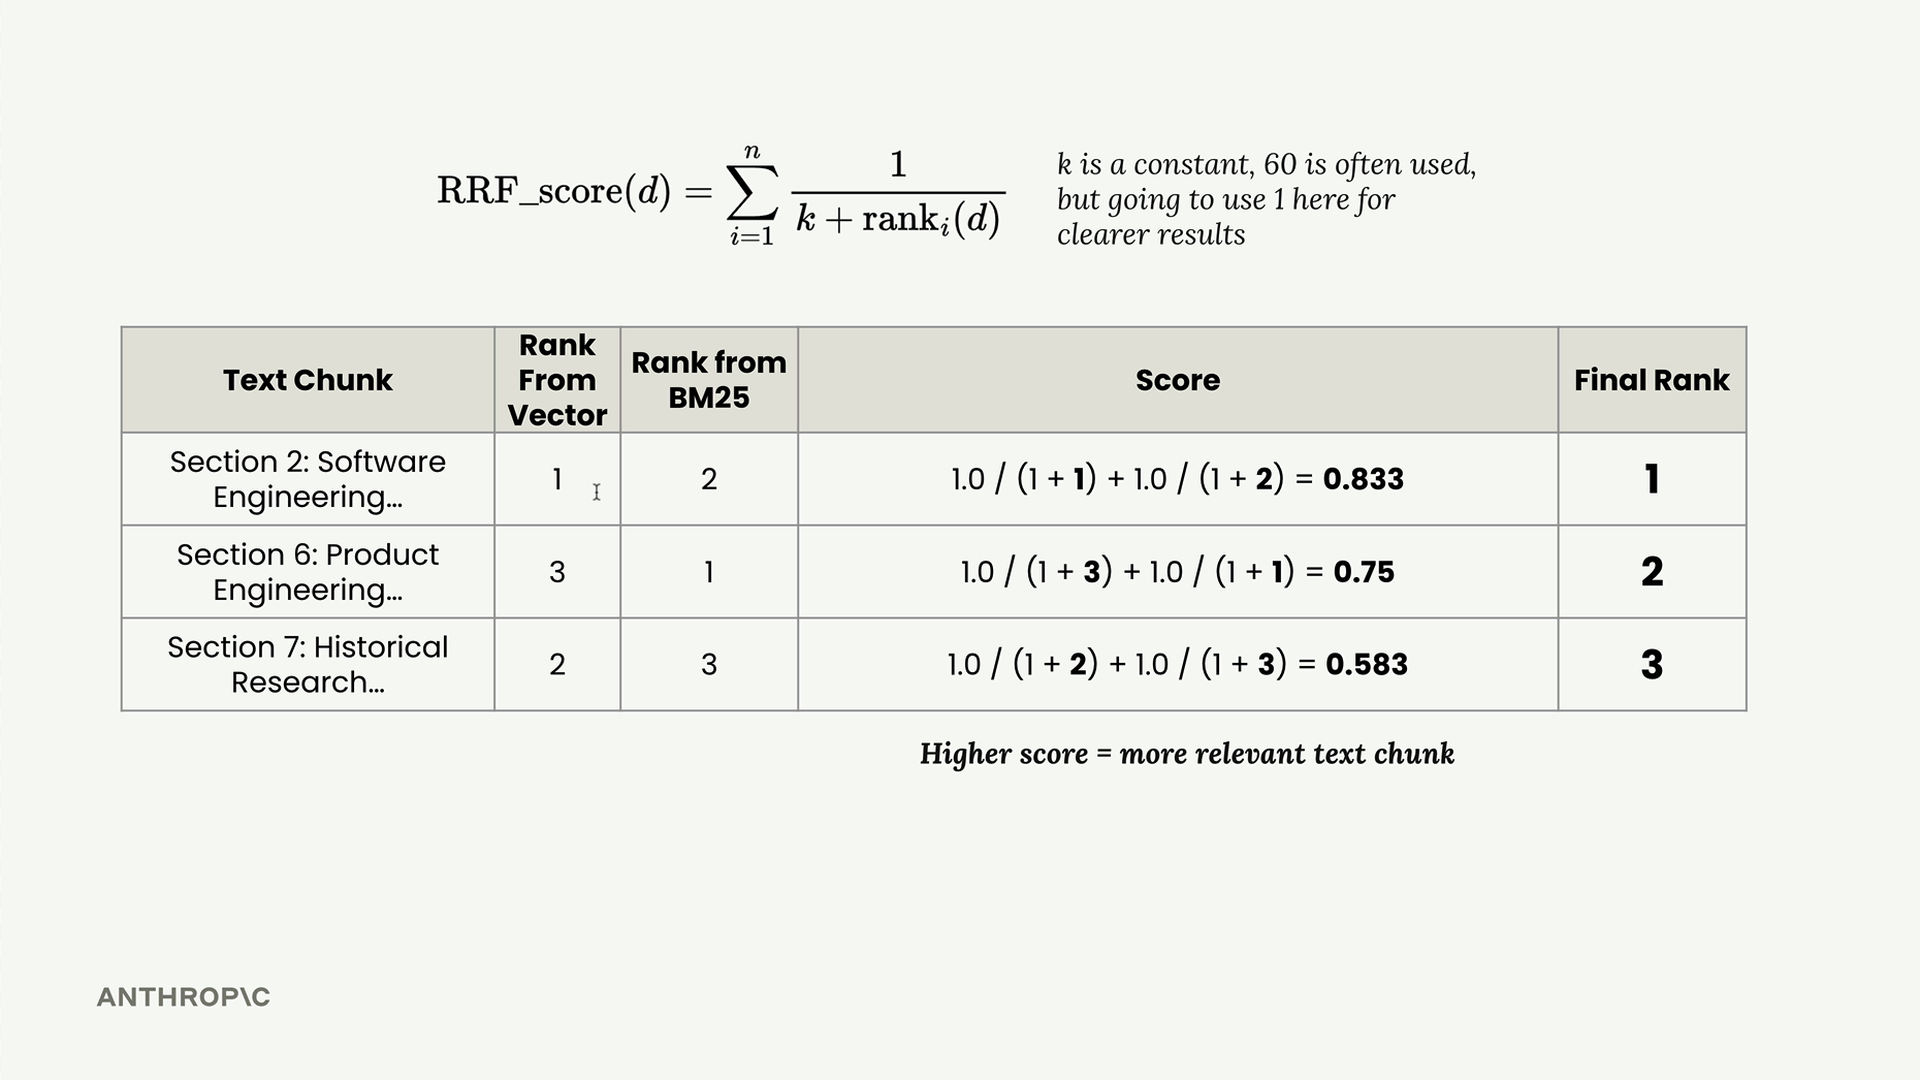
점수 기준으로 정렬하면, 최종 순위는 Section 2(1위), Section 6(2위), Section 7(3위)이 됩니다.
구현
Retriever 클래스의 구현은 간단합니다:
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # 모든 인덱스에서 결과 가져오기
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # 시스템 전반의 문서 순위 추적
                # RRF 공식 적용
                # 병합 및 정렬된 결과 반환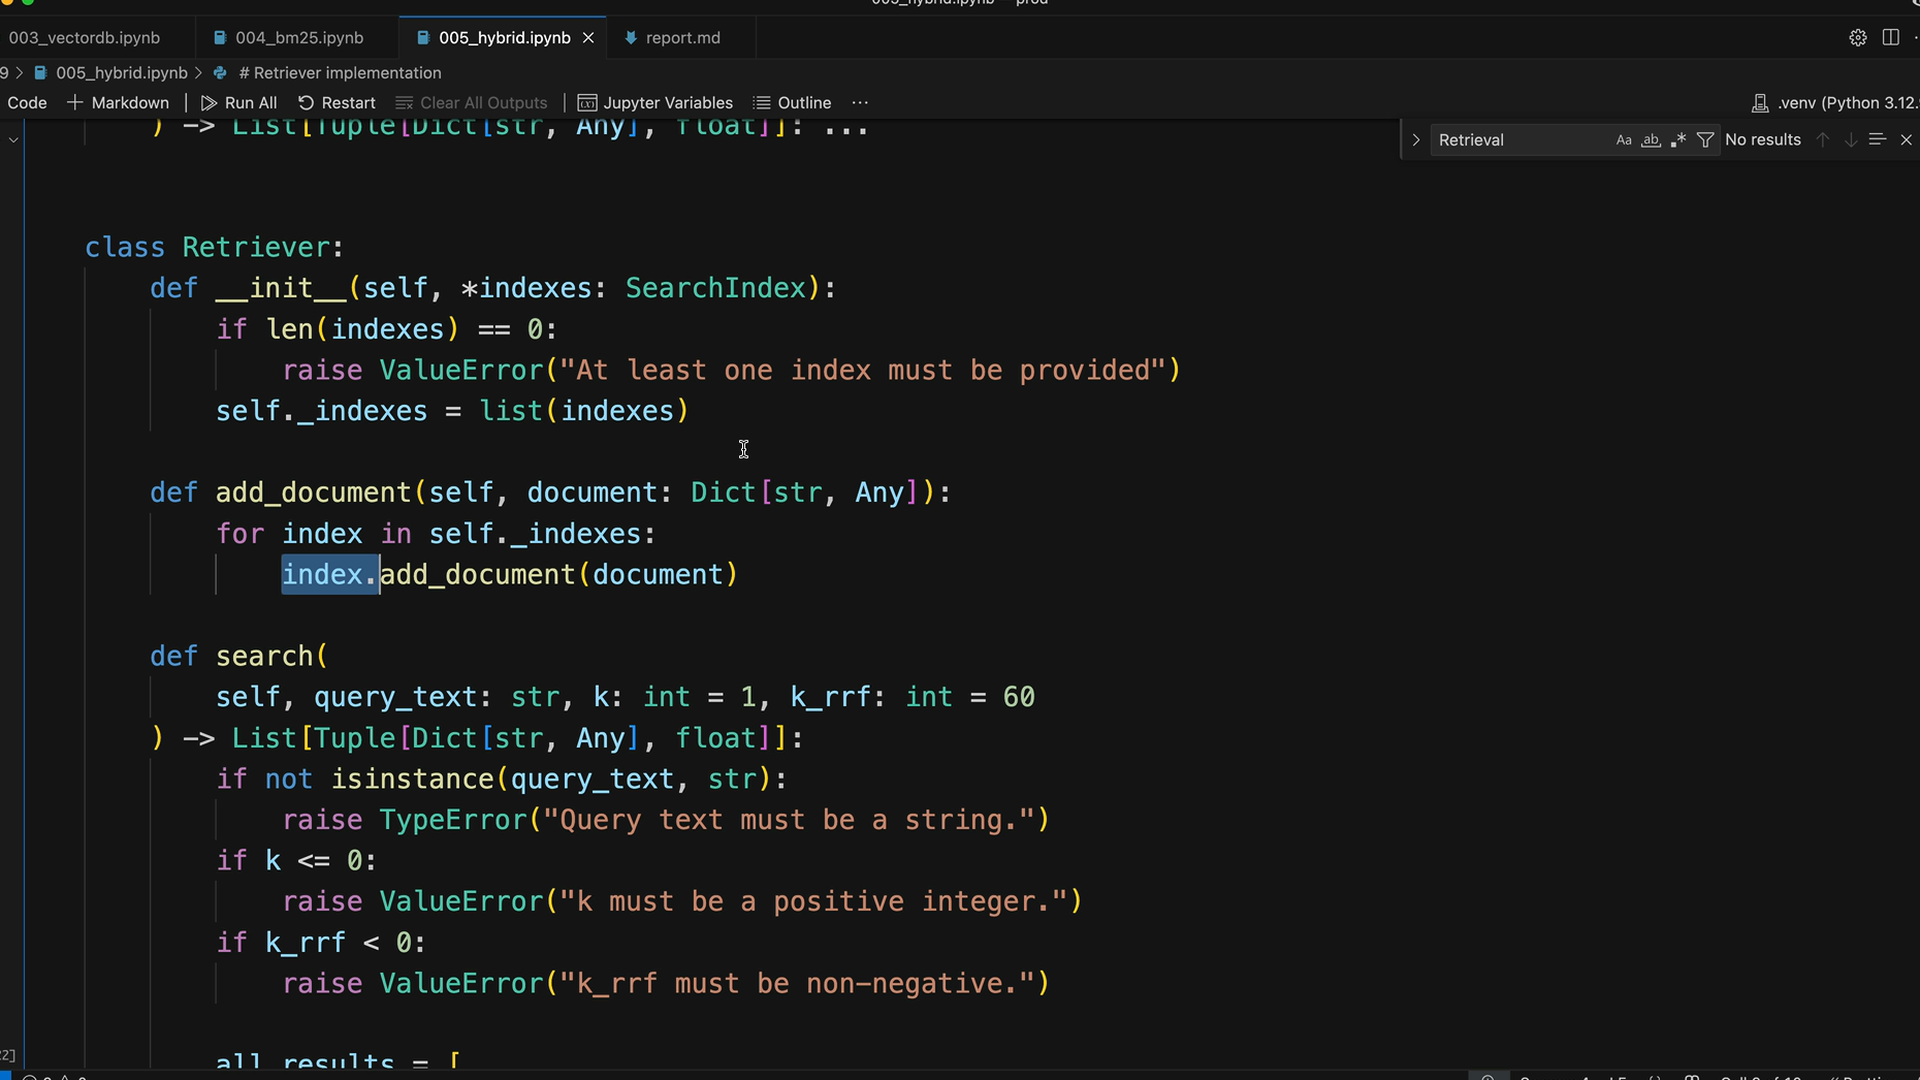
핵심 통찰은 RRF 알고리즘이 단일 점수 산정 방식에 의존하는 대신, 각 문서가 모든 검색 시스템에서 전반적으로 얼마나 좋은 성능을 보이는지를 고려하여 통합된 순위를 만든다는 점입니다.
하이브리드 방식 테스트하기
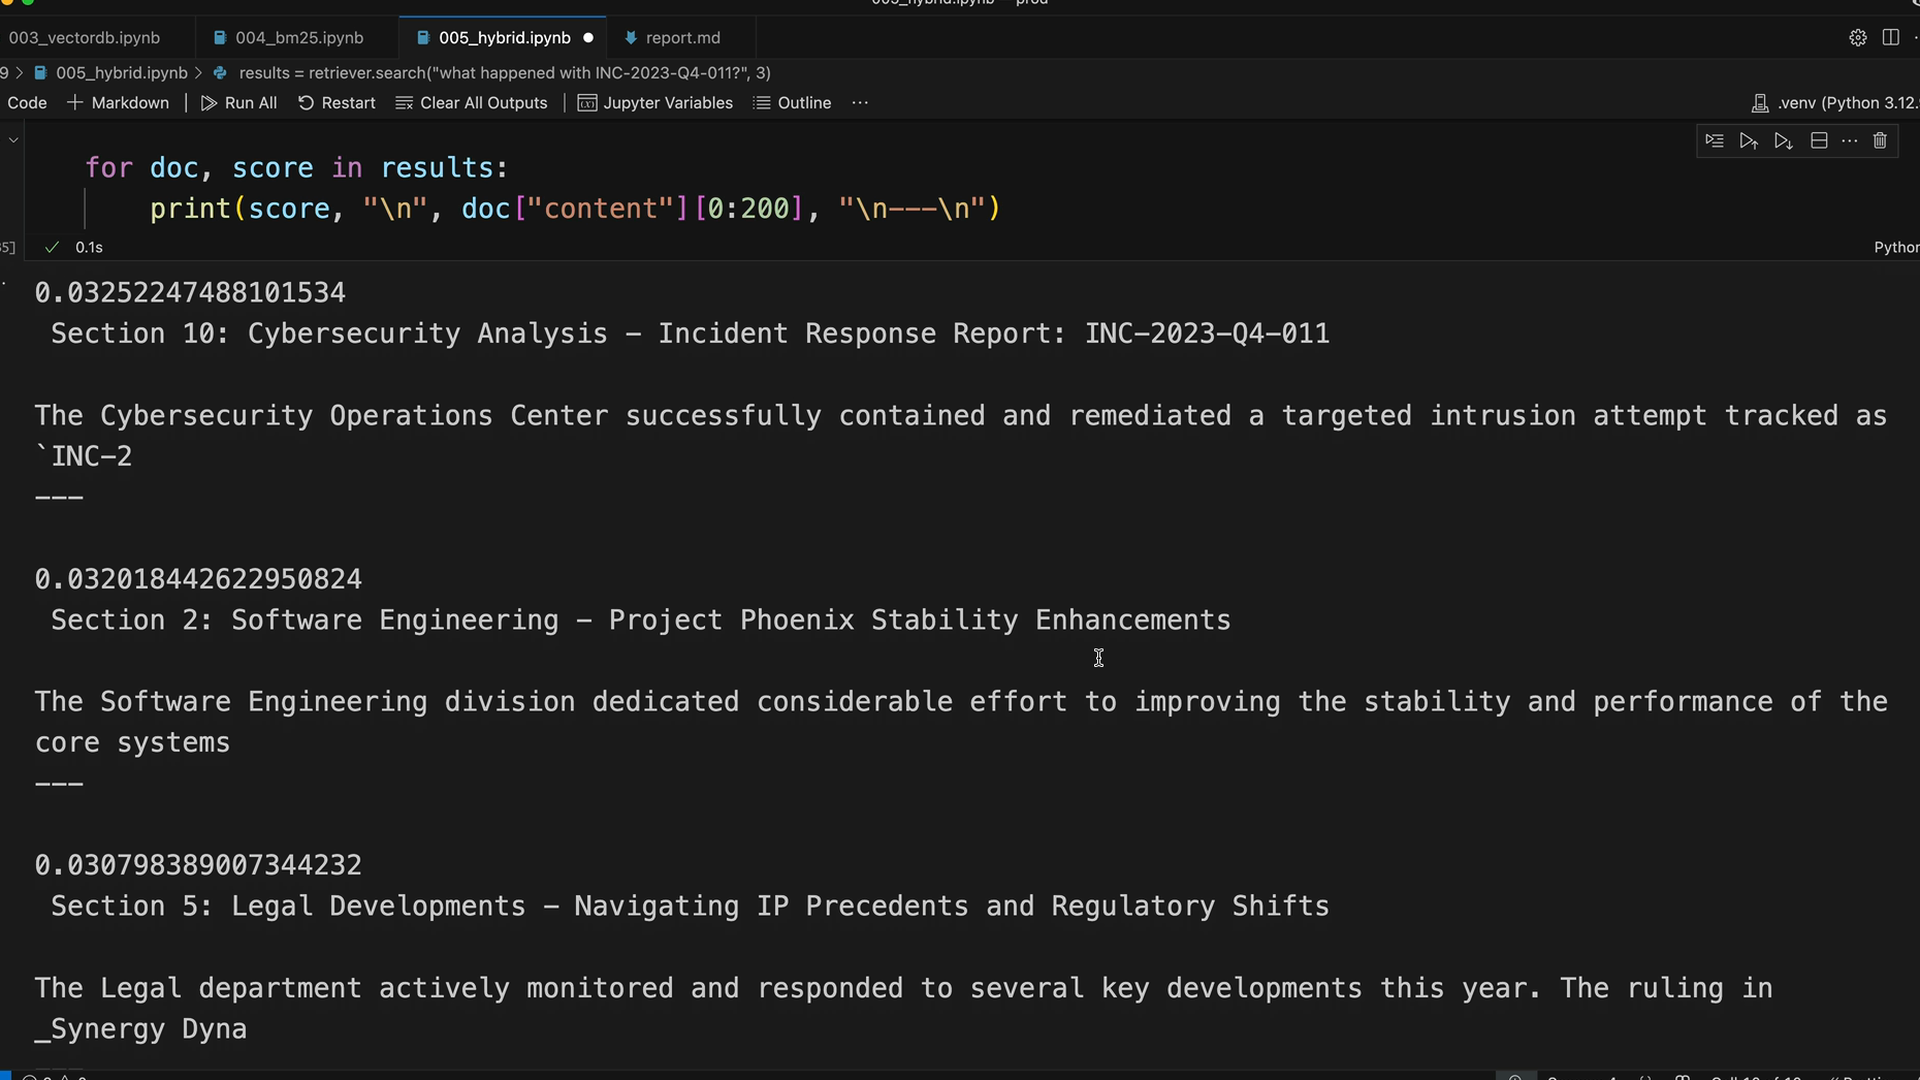
"INC-2023-Q4-011에 무슨 일이 있었나요?"와 같은 쿼리로 테스트할 때, 하이브리드 방식은 두 방법을 각각 단독으로 사용했을 때보다 훨씬 더 나은 결과를 제공합니다. 순수 벡터 검색에서 나오는 예상치 못한 결과 대신, 이제는 가장 관련성 높은 사이버보안 사고 보고서가 먼저 나오고, 그다음으로 관련된 소프트웨어 엔지니어링 콘텐츠가 이어집니다.
확장성
이 설계의 묘미는 모듈성에 있습니다. 각 검색 인덱스가 동일한 인터페이스(add_document()와 search())를 구현하기 때문에, 새로운 검색 방법론을 시스템에 쉽게 추가할 수 있습니다. 서로 다른 임베딩 모델이든, 특화된 도메인 검색이든, 그 밖의 다른 검색 기법이든, 정해진 API를 따르기만 한다면 하이브리드 파이프라인에 매끄럽게 통합됩니다.
이 하이브리드 검색 방식은 벡터 검색의 시맨틱 이해와 렉시컬 검색의 정밀한 키워드 매칭을 결합하고, 이를 수학적으로 탄탄한 RRF 랭킹 알고리즘을 통해 통합함으로써 검색 정확도에서 상당한 개선을 보여줍니다.