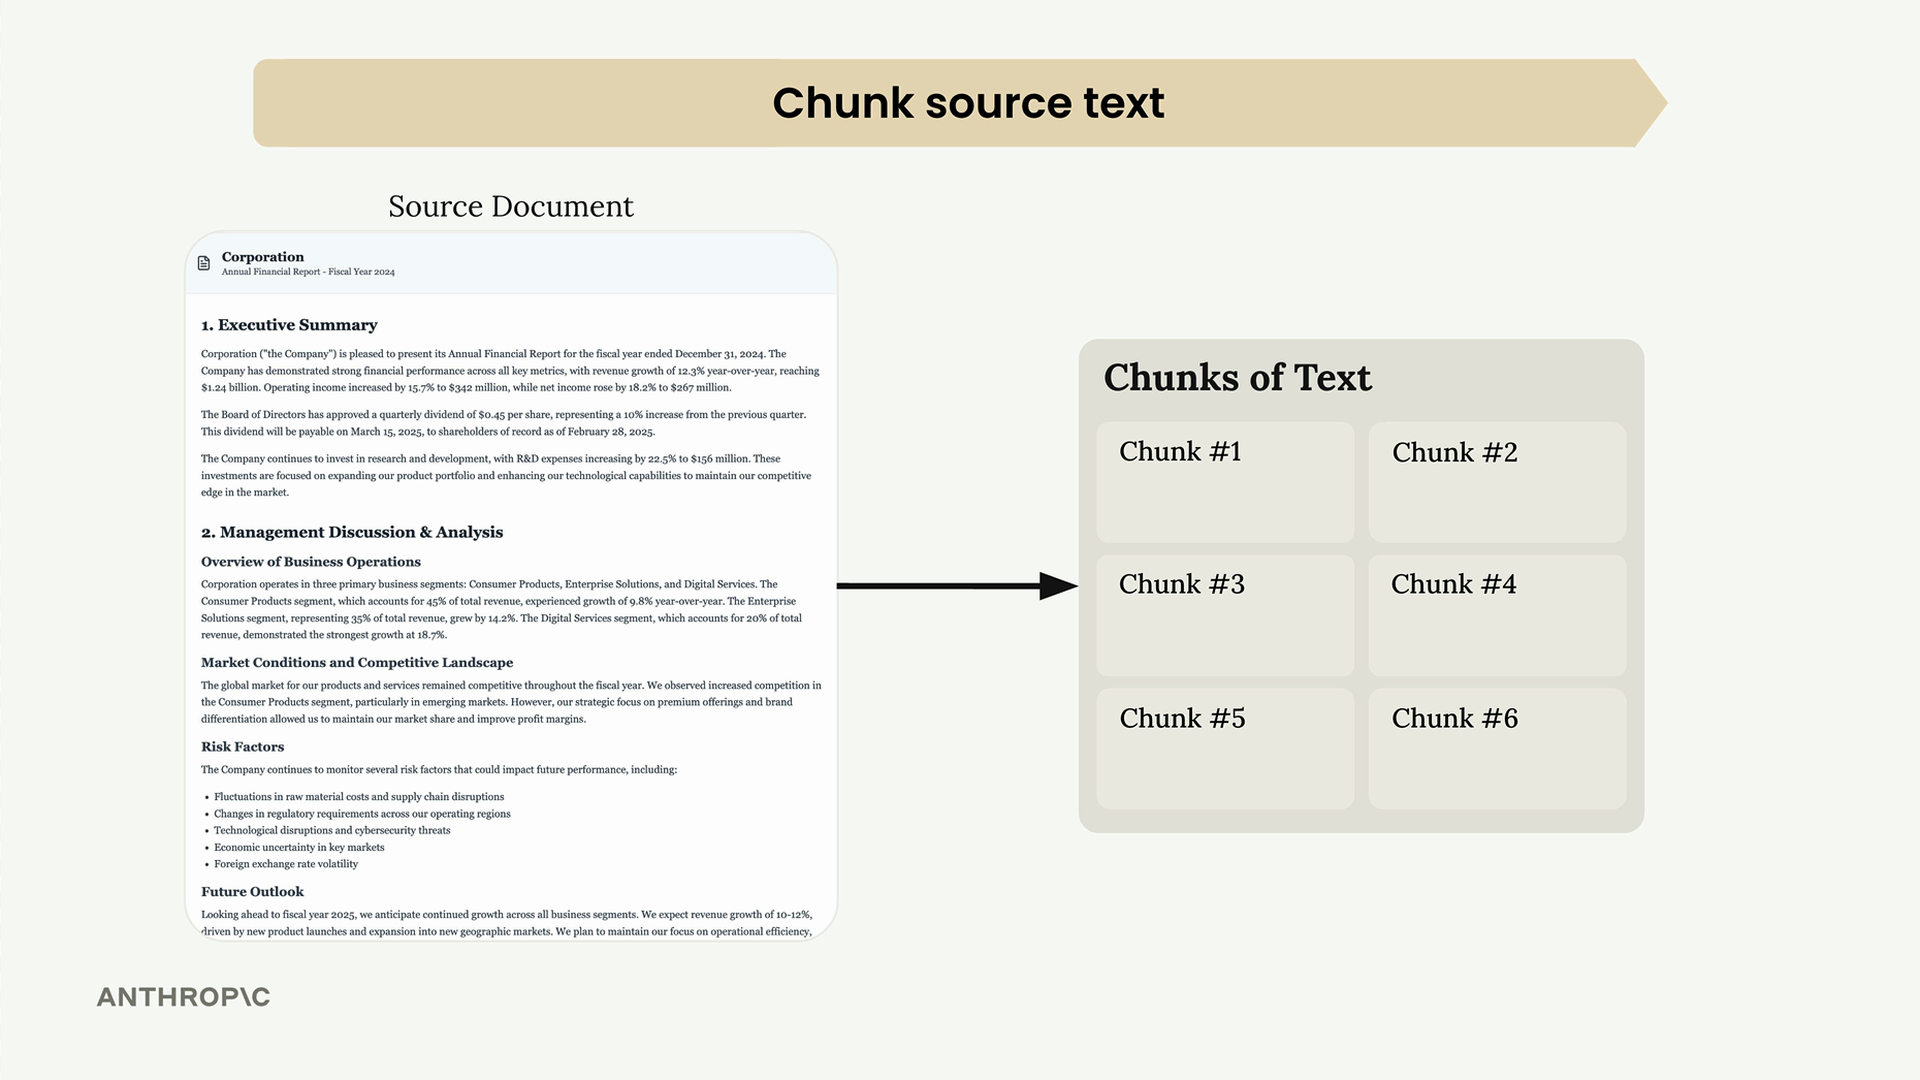
La fragmentación de texto es uno de los pasos más críticos en la construcción de un pipeline de RAG (Retrieval Augmented Generation). La forma en que divides tus documentos impacta directamente la calidad de todo tu sistema. Una estrategia de fragmentación deficiente puede hacer que se inserte contexto irrelevante en tus prompts, provocando que tu IA dé respuestas completamente incorrectas.
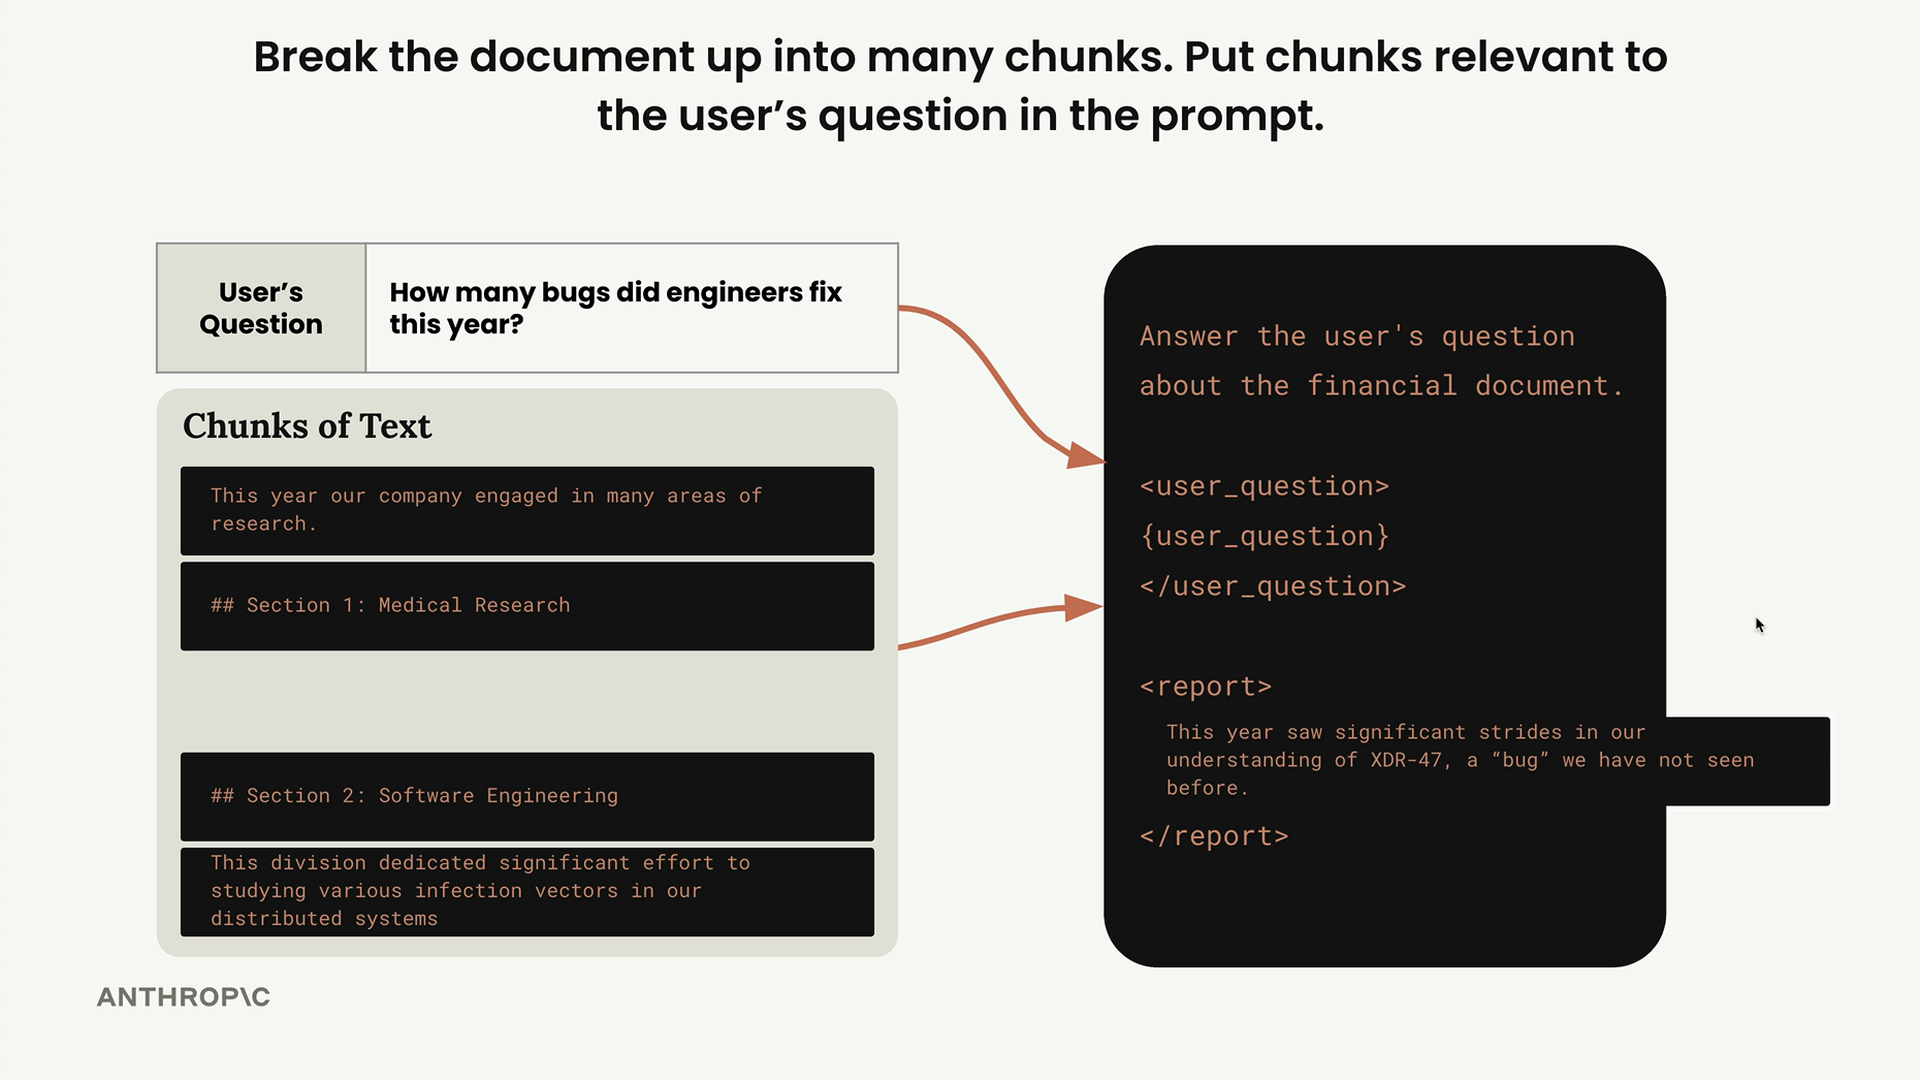
Considera este ejemplo: tienes un documento con secciones sobre investigación médica e ingeniería de software. Si fragmentas mal, un usuario que pregunte "¿Cuántos errores corrigieron los ingenieros este año?" podría obtener información sobre investigación médica en lugar de ingeniería de software, simplemente porque la sección médica contenía la palabra "bug" en un contexto diferente.
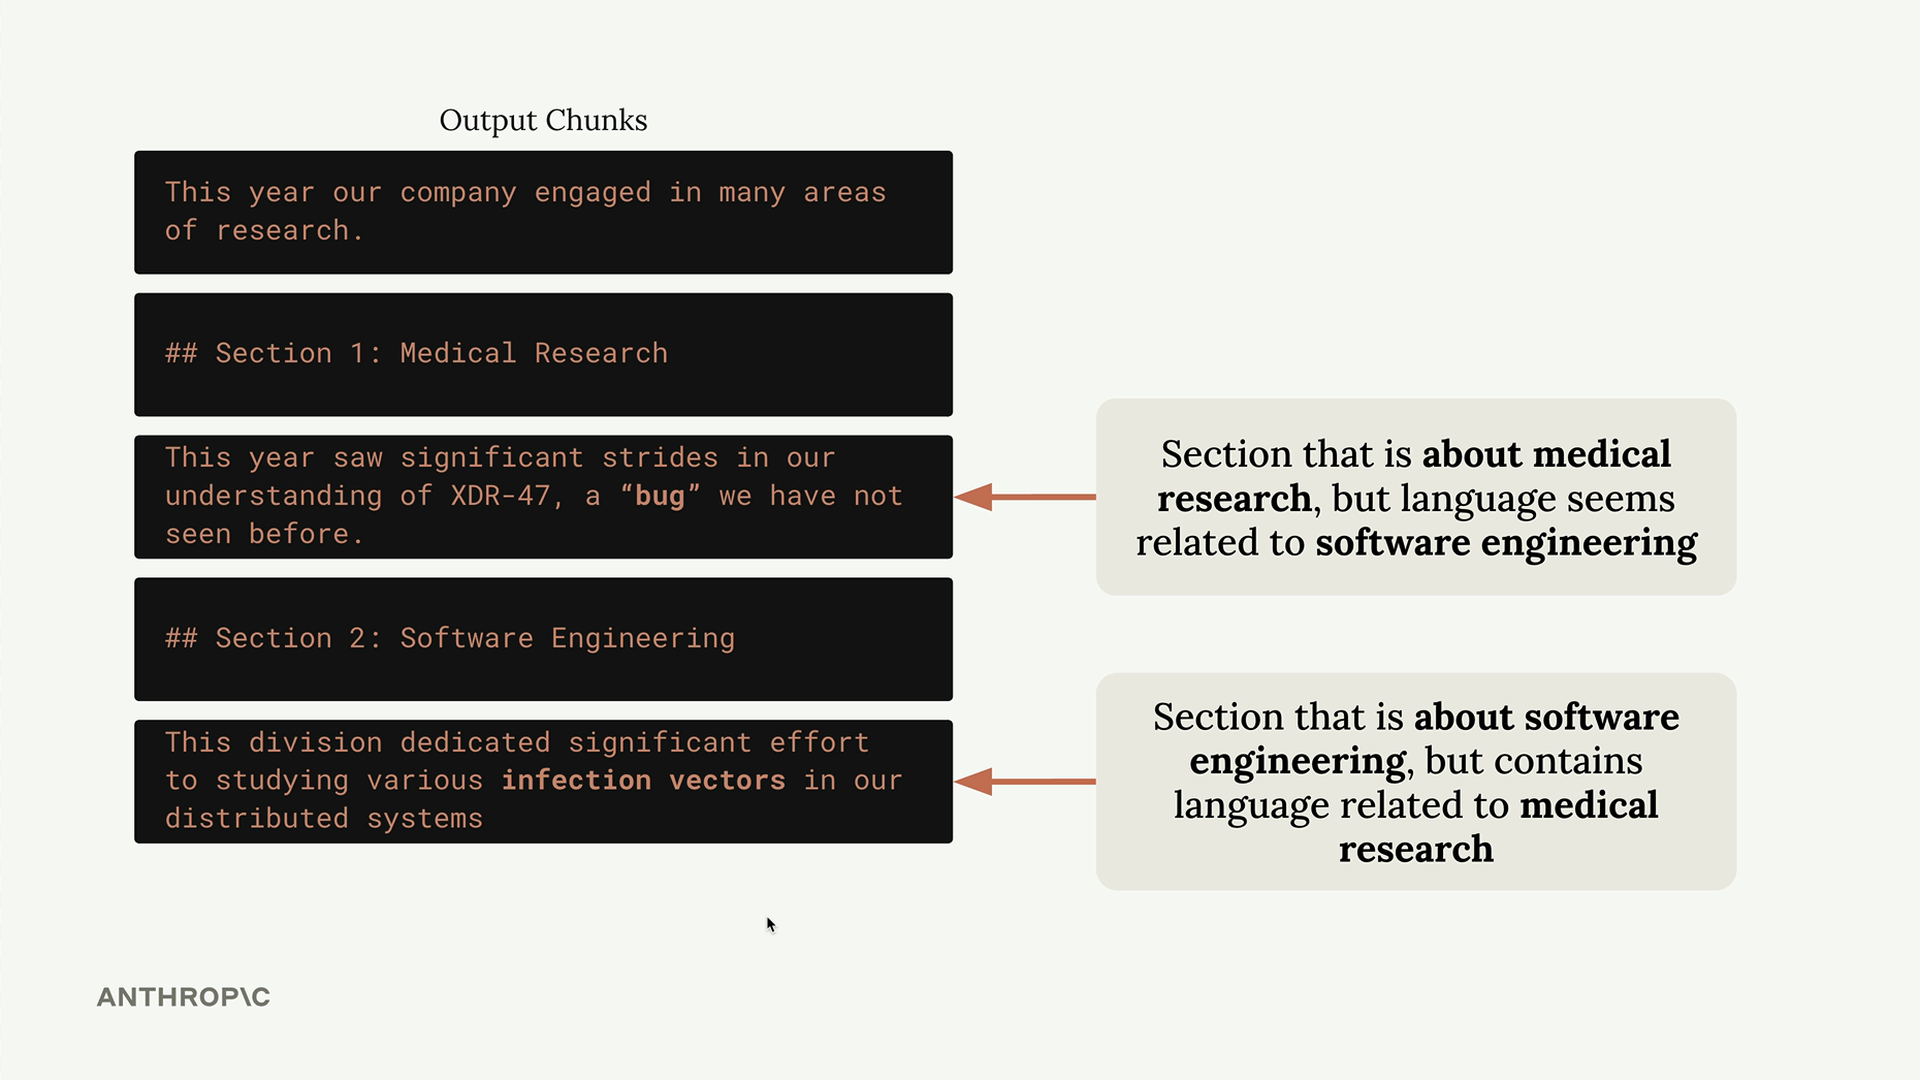
Esto demuestra por qué la estrategia de fragmentación importa tanto. El objetivo es crear fragmentos que mantengan coherencia semántica y proporcionen contexto significativo cuando se recuperen.
Tres estrategias principales de fragmentación
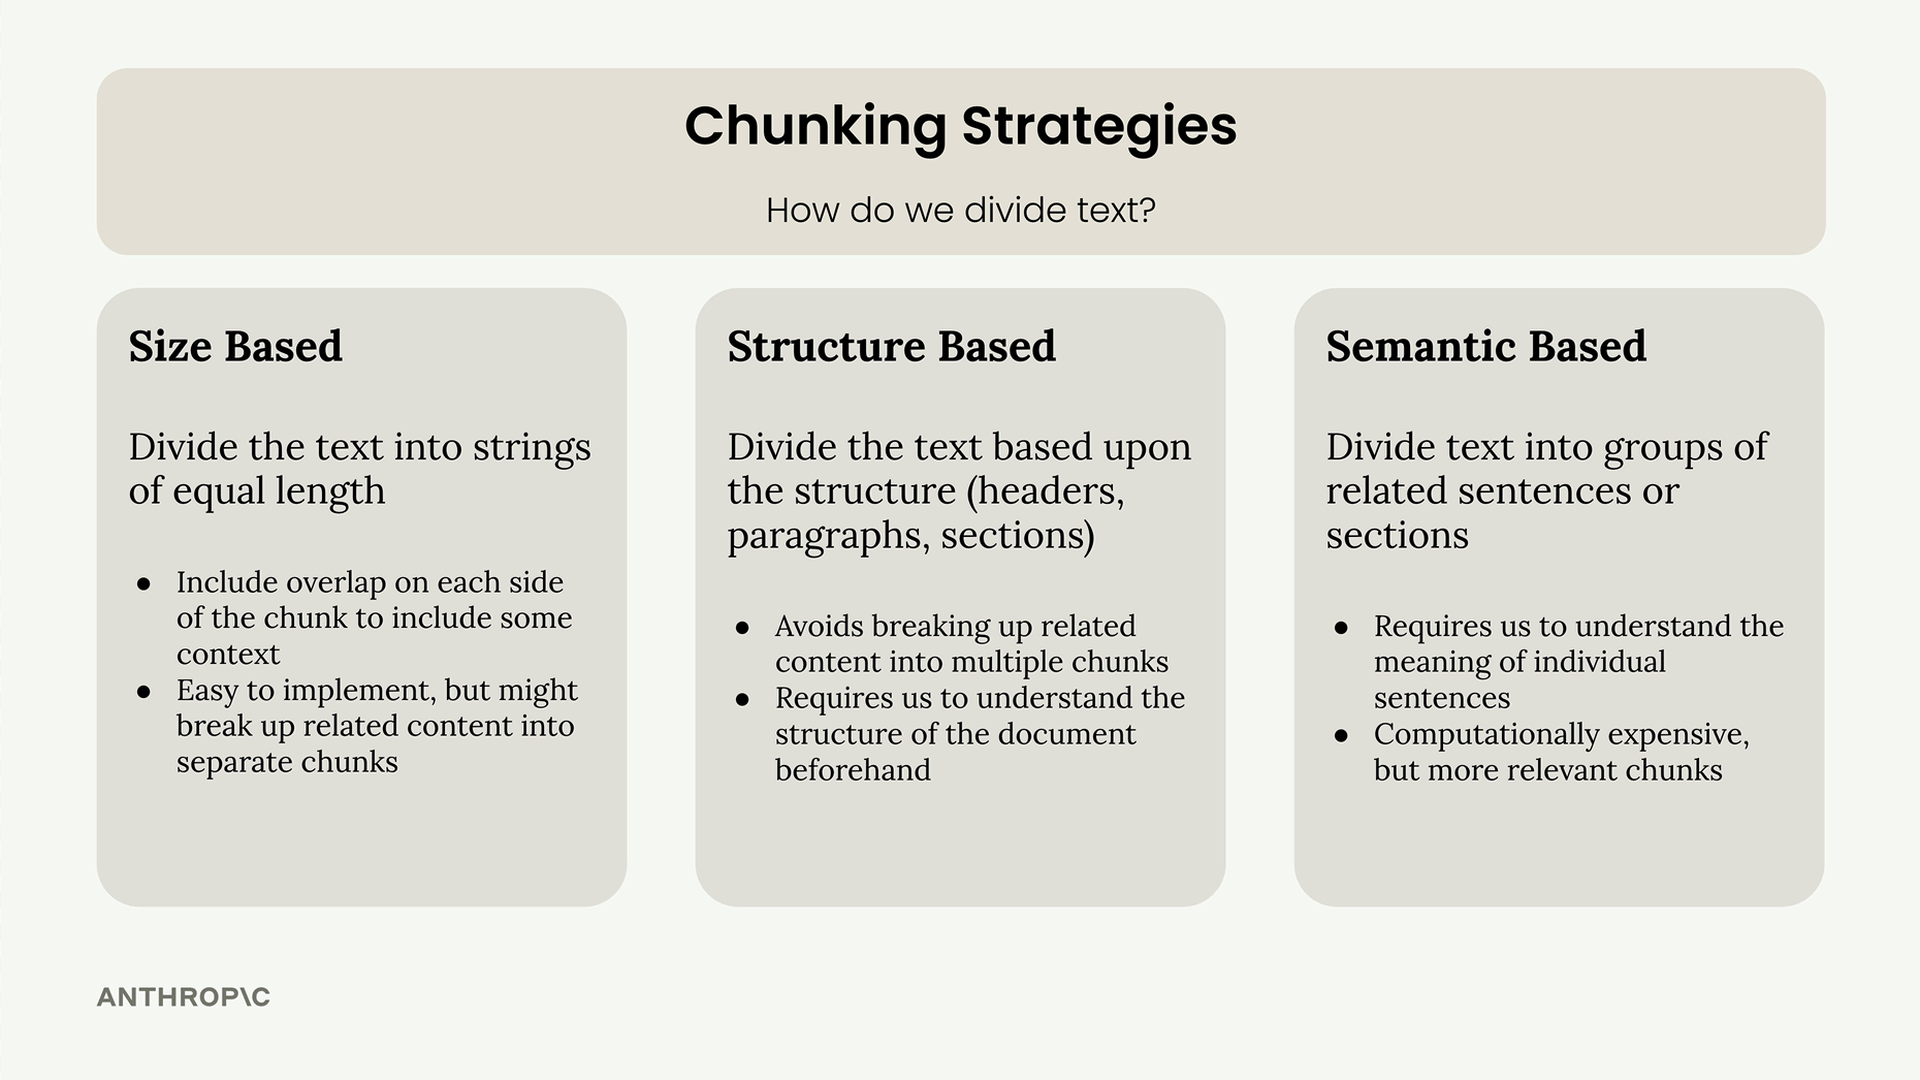
Existen tres enfoques principales para fragmentar texto, cada uno con ventajas y compensaciones distintas:
- Basado en tamaño: Divide el texto en cadenas de longitud igual
- Basado en estructura: Divide según la estructura del documento (encabezados, párrafos, secciones)
- Basado en semántica: Agrupa oraciones o secciones relacionadas usando técnicas de NLP
Fragmentación basada en tamaño
La fragmentación basada en tamaño es el enfoque más sencillo. Simplemente divides tu documento en fragmentos de un número de caracteres o palabras aproximadamente igual. Es fácil de implementar y funciona de manera confiable en diferentes tipos de documentos.
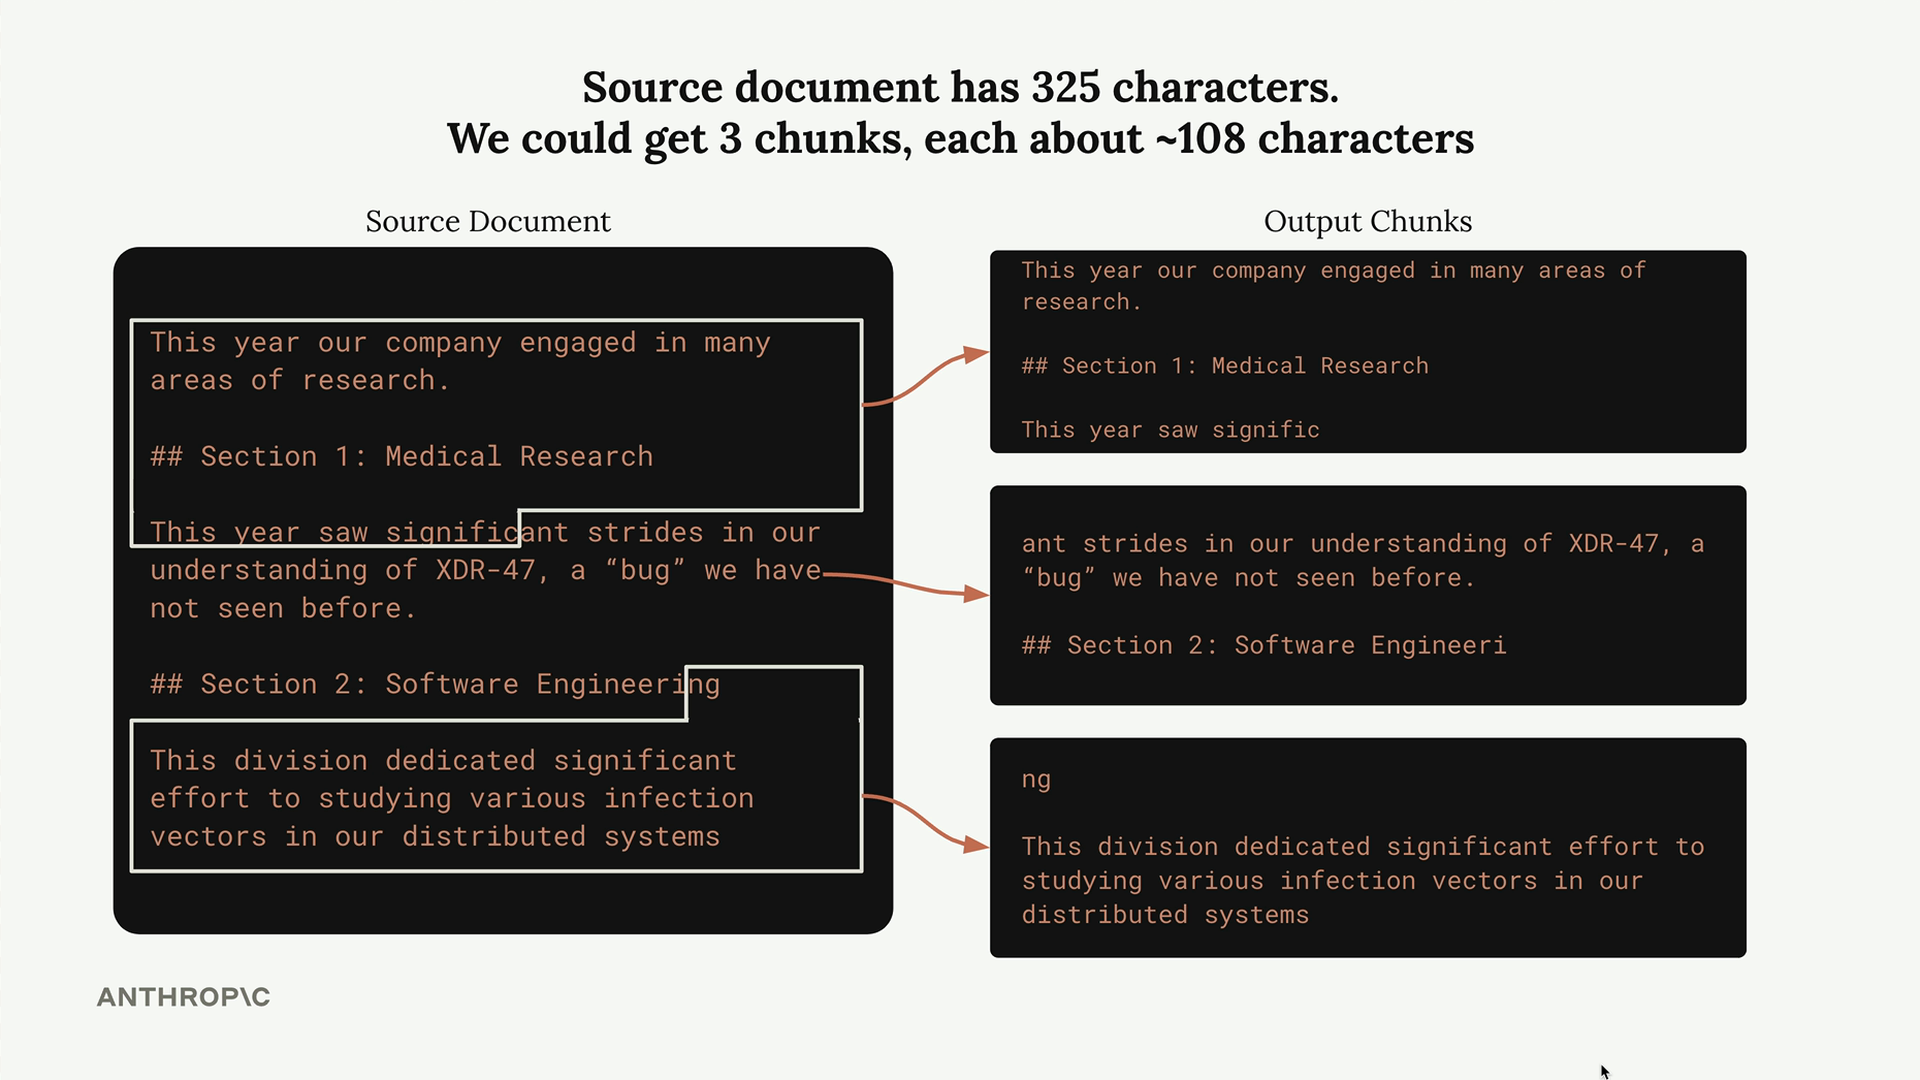
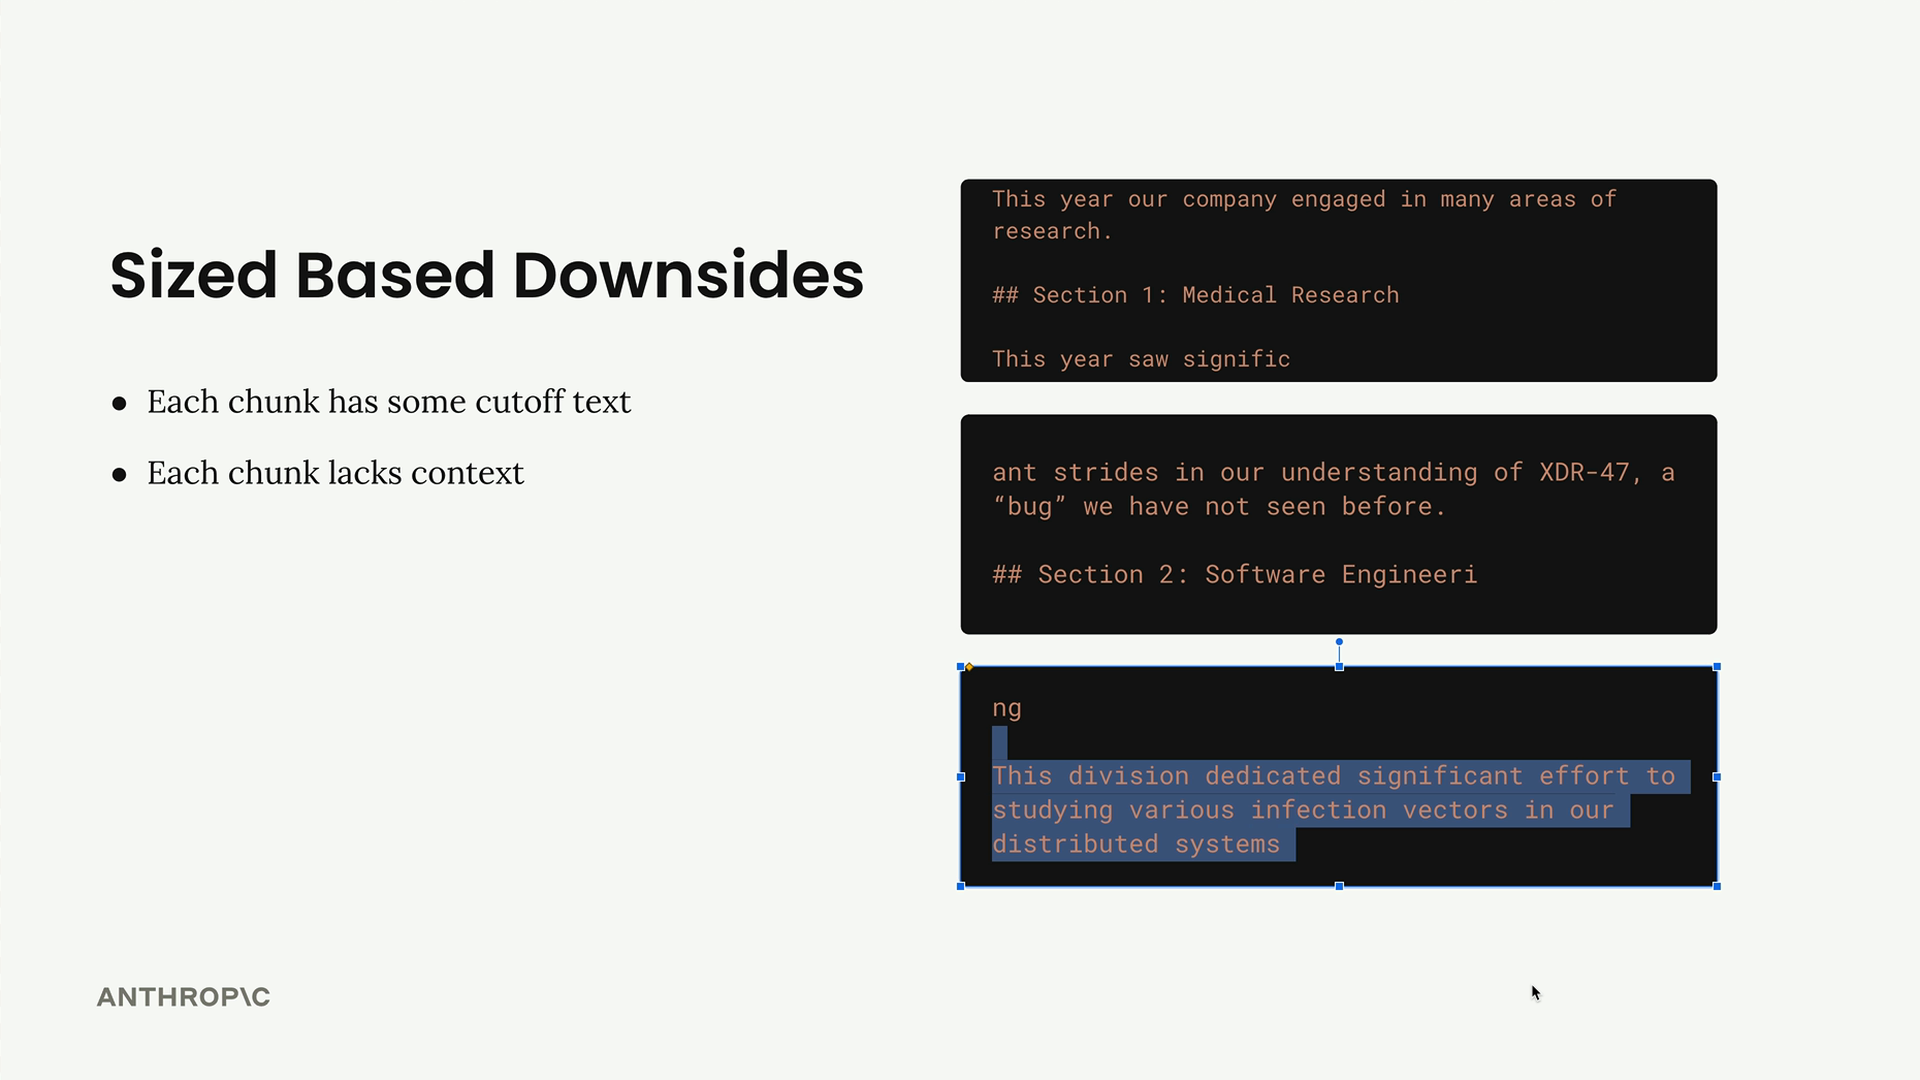
Sin embargo, este enfoque tiene desventajas claras. Las palabras quedan cortadas a mitad de oración, y los fragmentos pierden contexto importante. Por ejemplo, un fragmento podría no incluir el encabezado de sección que explicaría de qué trata realmente el contenido.
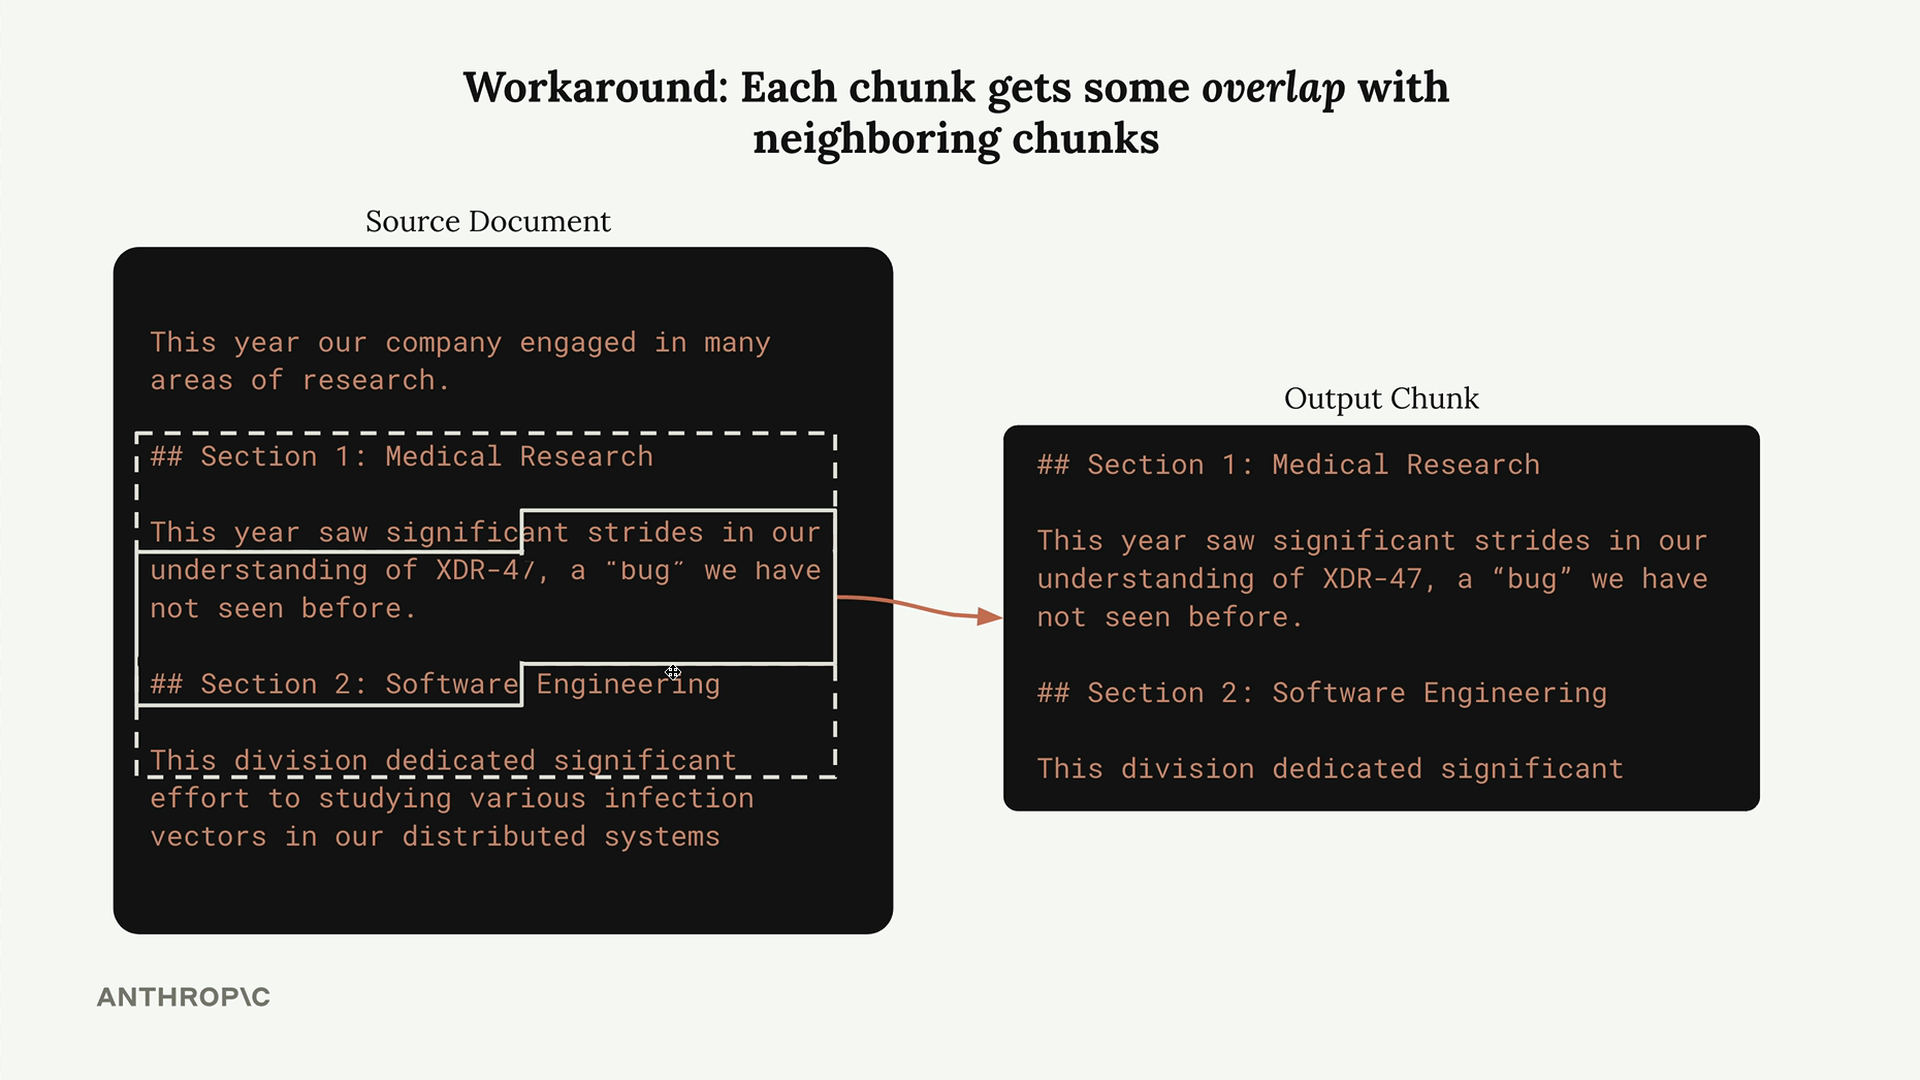
La solución es agregar superposición entre fragmentos. Cada fragmento incluye algunos caracteres de los fragmentos vecinos, asegurando una mejor preservación del contexto y evitando cortes abruptos.
Aquí tienes una implementación básica de fragmentación basada en caracteres con superposición:
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
Fragmentación basada en estructura
La fragmentación basada en estructura aprovecha la organización natural de tus documentos. Si trabajas con archivos markdown, puedes dividir por encabezados. Para otros formatos, podrías dividir por párrafos u otros elementos estructurales.
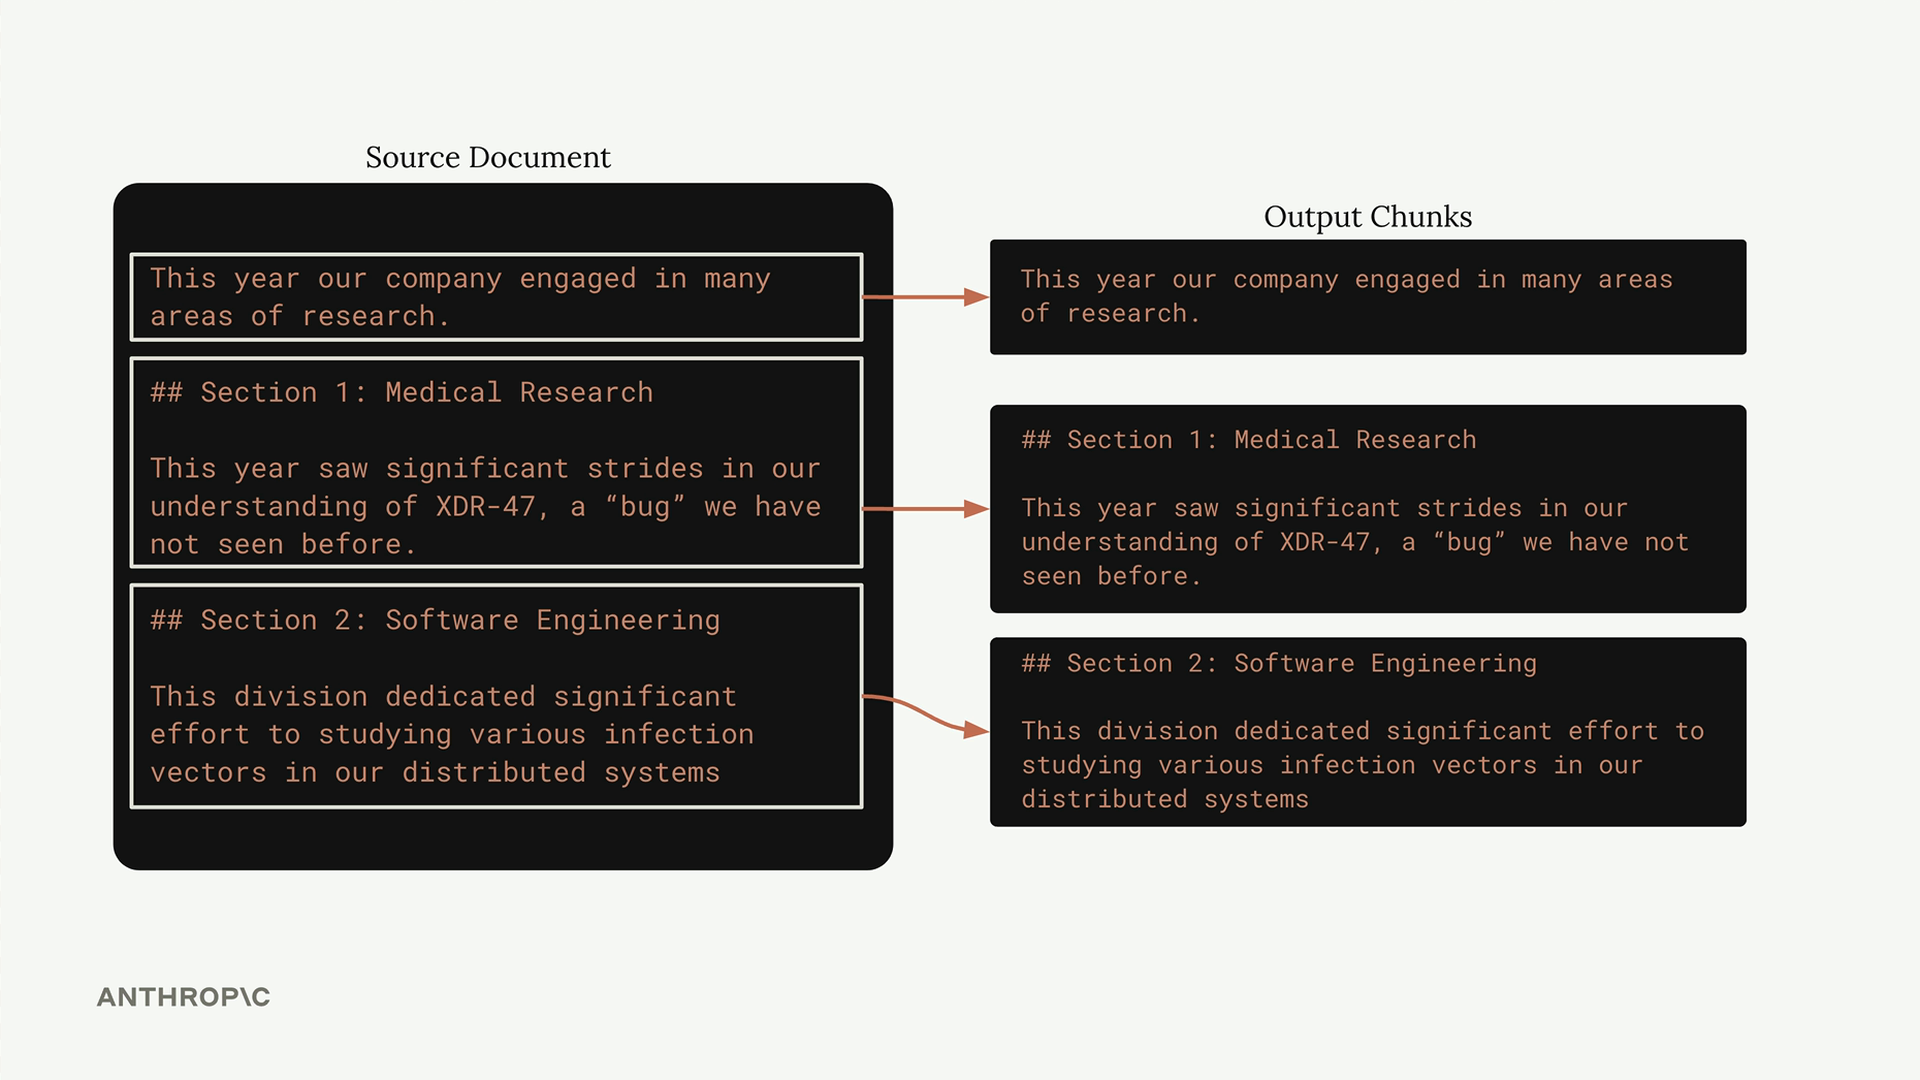
Este enfoque funciona de maravilla cuando tienes garantías sobre la estructura del documento. Para documentos markdown, puedes dividir por encabezados de sección:
import re

def chunk_by_section(document_text):
    pattern = r'\n## '
    return re.split(pattern, document_text)
La principal limitación es que muchos documentos no tienen una estructura consistente. Los archivos de texto plano, PDFs, o documentos subidos por usuarios podrían no tener marcadores estructurales claros para dividir.
Fragmentación basada en semántica
La fragmentación basada en semántica es el enfoque más sofisticado. Analiza el significado y las relaciones entre oraciones para agrupar contenido relacionado. Esto normalmente implica:
- Dividir el texto en oraciones
- Usar técnicas de NLP para medir la similitud semántica
- Agrupar oraciones relacionadas en fragmentos coherentes
Si bien esto puede producir los fragmentos de mayor calidad, es computacionalmente costoso y más complejo de implementar. Para la mayoría de las aplicaciones, los enfoques más sencillos funcionan suficientemente bien.
Implementación práctica
Aquí tienes una función de fragmentación basada en oraciones que ofrece un buen punto medio:
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r'(?<=[.!?])\s+', text)
    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(' '.join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
Elegir la estrategia correcta
Tu elección de estrategia de fragmentación depende completamente de tu caso de uso específico:
- Estructura de documento consistente: Usa la fragmentación basada en estructura para obtener los resultados más limpios
- Tipos de documentos mixtos: La fragmentación basada en oraciones suele funcionar bien
- Código o contenido técnico: La fragmentación basada en caracteres es la más confiable
- Formatos de documento desconocidos: La fragmentación basada en caracteres es tu apuesta más segura
Recuerda que la fragmentación suele ser un proceso iterativo. Comienza con un enfoque simple, pruébalo con tus documentos y casos de uso específicos, y luego refínalo según los resultados. La "mejor" estrategia de fragmentación es la que funciona de manera confiable para tus datos y requisitos particulares.