Más allá de crear mejores prompts, existen dos técnicas poderosas para controlar la salida de Claude: los mensajes de asistente prellenados y las secuencias de parada. Estos métodos te brindan un control preciso sobre cómo responde Claude y cuándo deja de generar texto.
Mensajes de asistente prellenados
El prellenado de mensajes te permite proporcionar el inicio de la respuesta de Claude, a partir del cual este continuará. Esta técnica es increíblemente útil para guiar a Claude en una dirección específica.
Así es como funciona: en lugar de simplemente enviar un mensaje de usuario, agregas un mensaje de asistente al final de tu lista de mensajes. Claude ve este mensaje de asistente y piensa "ya he comenzado a responder a esta pregunta, así que debería continuar desde donde lo dejé".
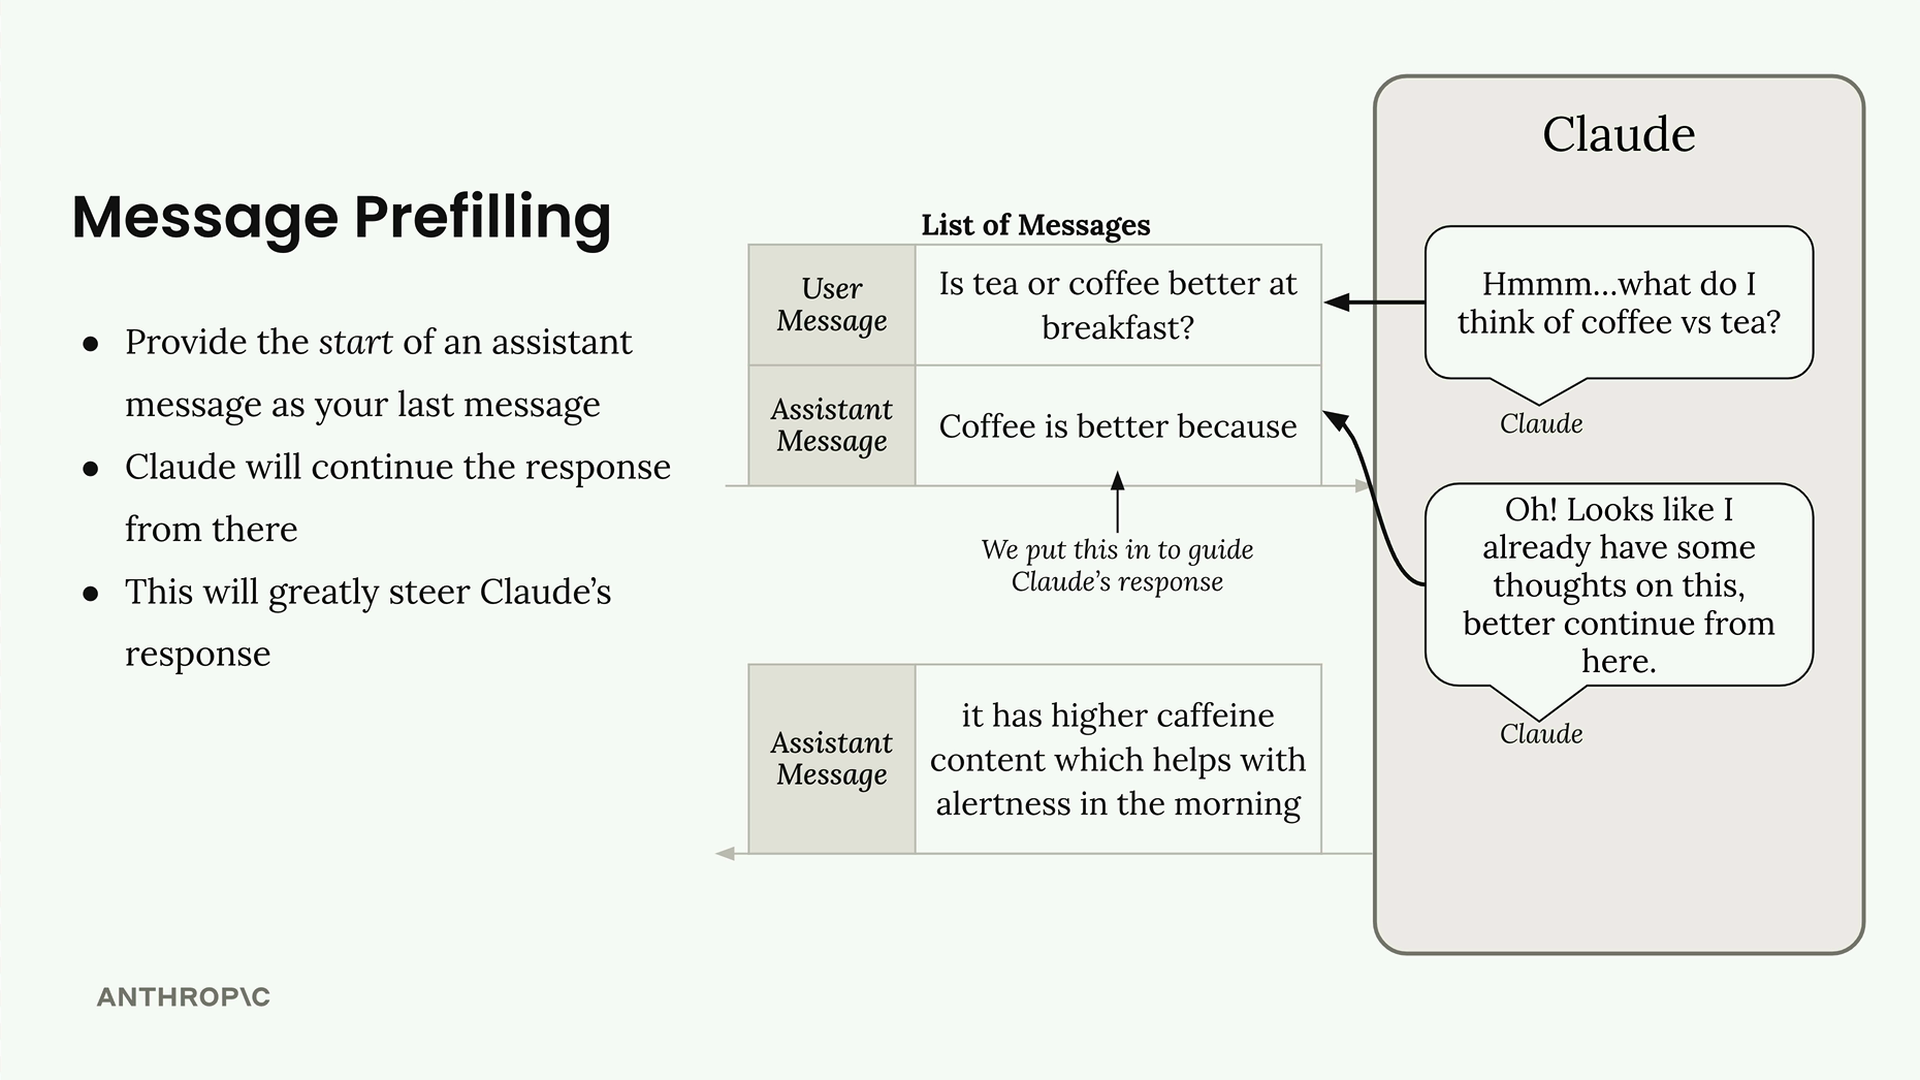
Por ejemplo, si preguntas "¿Es mejor el té o el café en el desayuno?" sin prellenado, Claude normalmente da una respuesta equilibrada que menciona ambas opciones. Pero si agregas un mensaje de asistente que diga "El café es mejor porque", Claude continuará a partir de ahí y argumentará a favor del café.
Lo fundamental que hay que entender es que Claude continúa exactamente desde donde termina tu texto prellenado. Si escribes "El café es mejor porque", Claude no repetirá ese texto; retomará justo después de "porque" y completará la idea.
Así es la estructura del código:
messages = []
add_user_message(messages, "Is tea or coffee better at breakfast?")
add_assistant_message(messages, "Coffee is better because")
answer = chat(messages)
Puedes guiar a Claude en cualquier dirección utilizando esta técnica:
- Favorecer el café: "El café es mejor porque"
- Favorecer el té: "El té es mejor porque"
- Adoptar una postura contraria: "Ninguno es muy bueno porque"
Secuencias de parada
Las secuencias de parada obligan a Claude a terminar su respuesta tan pronto como genera una cadena de caracteres específica. Esto es perfecto para controlar la longitud o el punto final de las respuestas.
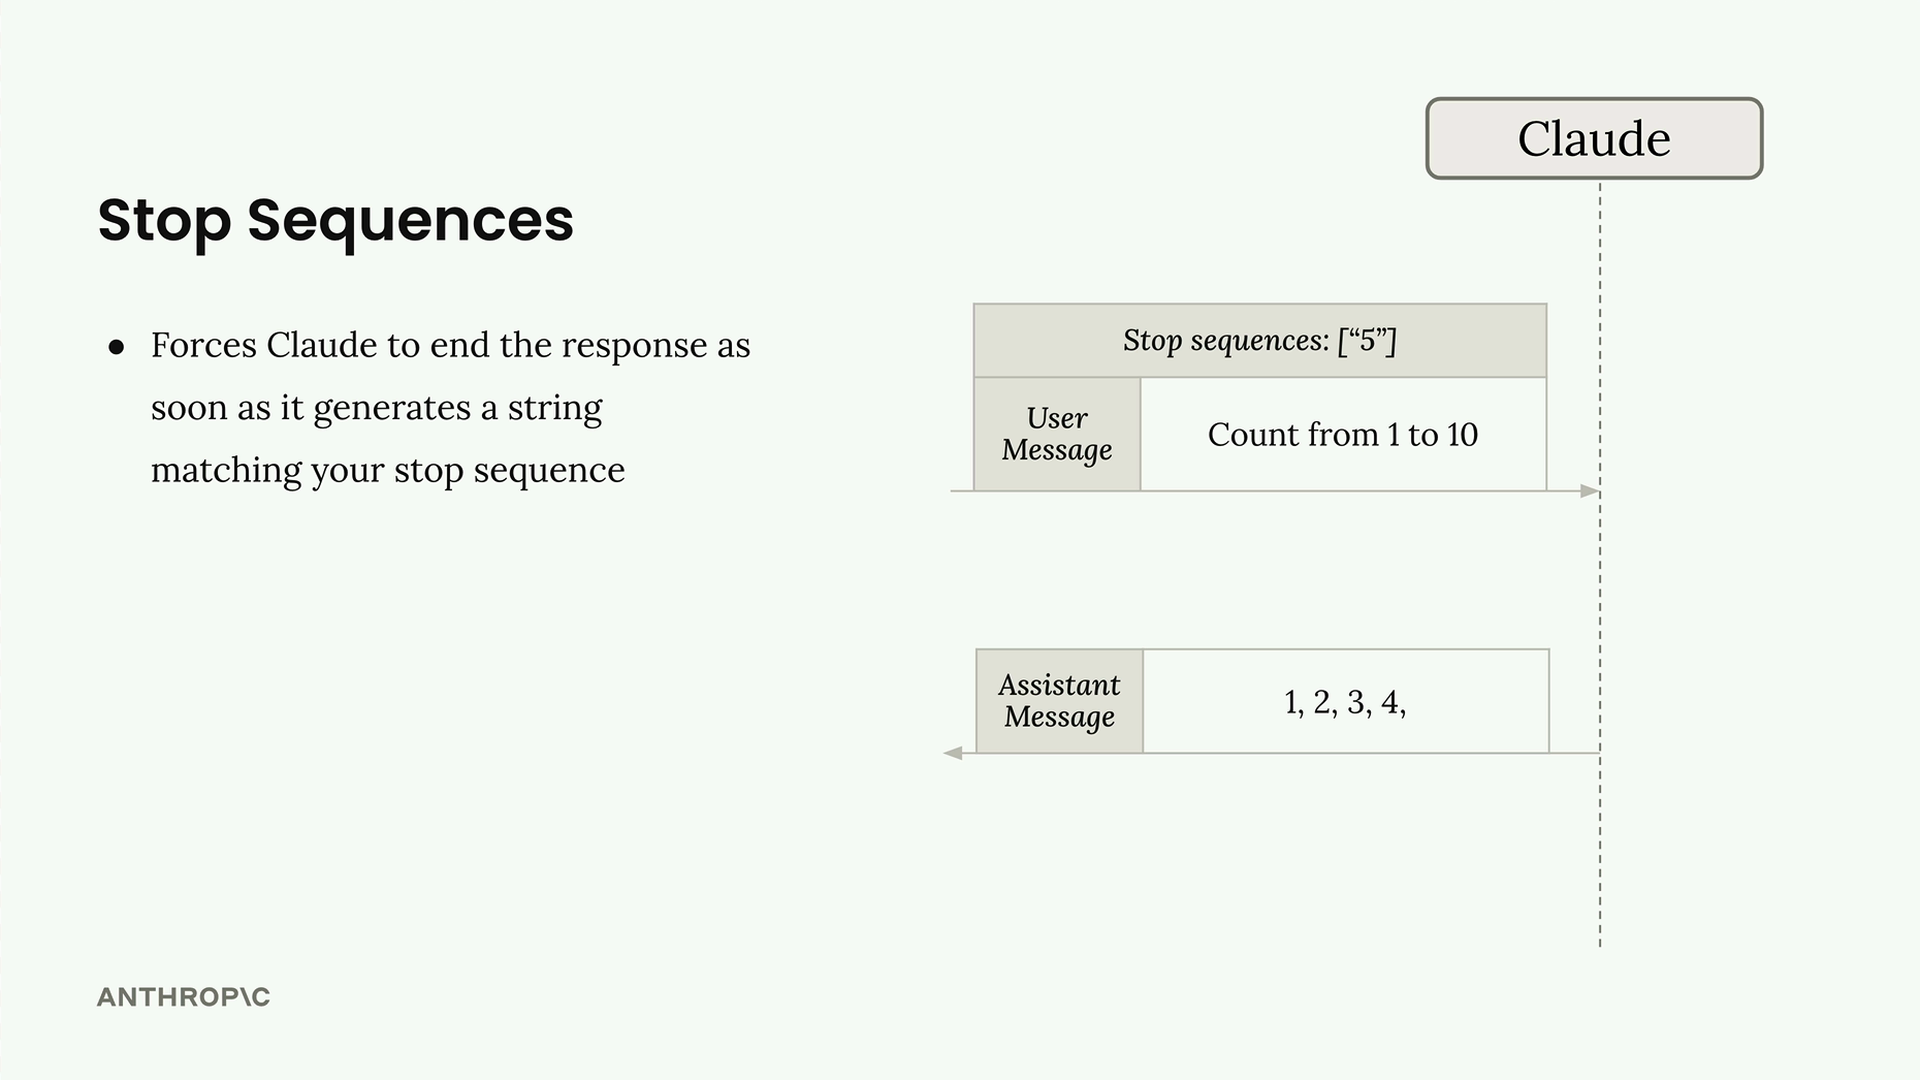
El concepto es sencillo: proporcionas una lista de cadenas, y cuando Claude genera cualquiera de esas cadenas, se detiene de inmediato y devuelve lo que haya generado hasta ese punto.
Para usar secuencias de parada, haz que tu función chat acepte una lista de ellas:
def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "model": model,
        "max_tokens": 1000,
        "messages": messages,
        "temperature": temperature
    }
    if system:
        params["system"] = system
    if stop_sequences:
        params["stop_sequences"] = stop_sequences

    message = client.messages.create(**params)
    return message.content[0].text
Por ejemplo, pídele a Claude que "Cuente del 1 al 10" con una secuencia de parada de "5":
add_user_message(messages, "Count from 1 to 10")
answer = chat(messages, stop_sequences=["5"])
Esto devuelve: "1, 2, 3, 4, " - deteniéndose justo antes de que el "5" se incluya en la salida.
Puedes ser más preciso con tus secuencias de parada. Si quieres evitar la coma y el espacio finales, usa stop_sequences=[", 5"] en su lugar. Esto te dará un resultado más limpio: "1, 2, 3, 4".
Las secuencias de parada son particularmente útiles para:
- Limitar la longitud de las listas
- Detenerse en marcadores o delimitadores específicos
- Crear formatos de salida consistentes
- Evitar respuestas excesivamente largas
Ambas técnicas te brindan un control detallado sobre el comportamiento de Claude, lo que te permite crear respuestas más predecibles y específicas para tus aplicaciones.