Ahora que entendemos el flujo de RAG a nivel conceptual, implementémoslo paso a paso usando un ejemplo práctico. Trabajaremos a través de las cinco etapas del proceso de RAG, desde dividir el texto en fragmentos hasta encontrar documentos relevantes para las consultas de los usuarios.
Configurando la base de datos vectorial
Para esta implementación, usaremos una clase personalizada VectorIndex que proporciona la funcionalidad básica que necesitamos para almacenar y buscar embeddings. La clase maneja el almacenamiento de vectores, los cálculos de distancia (usando similitud de coseno) y la recuperación de documentos.
La implementación de RAG en cinco pasos
Repasemos cada paso del proceso de RAG:
Paso 1: Dividir el texto por sección
Primero, necesitamos dividir nuestro documento fuente en fragmentos manejables. Usaremos el mismo enfoque de fragmentación basado en secciones que vimos anteriormente:
chunks = chunk_by_section(text)Esto divide nuestro archivo report.md en secciones lógicas que podemos procesar individualmente.
Paso 2: Generar embeddings para cada fragmento
A continuación, convertimos cada fragmento de texto en un embedding numérico que captura su significado semántico:
embeddings = generate_embedding(chunks)Estos embeddings nos permiten realizar comparaciones matemáticas entre diferentes piezas de texto.
Paso 3: Almacenar los embeddings en la base de datos vectorial
Ahora creamos nuestro almacén de vectores y lo poblamos con nuestros embeddings y su texto asociado:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
Observa que almacenamos tanto el embedding como el contenido de texto original. Esto es crucial porque, cuando recuperemos embeddings similares más adelante, necesitaremos acceso al texto real, no solo a los vectores numéricos. El embedding por sí solo no nos resulta útil como desarrolladores; necesitamos el contenido legible para humanos que representa.
Paso 4: Generar un embedding para la consulta del usuario
Cuando un usuario hace una pregunta, necesitamos convertir su consulta en el mismo espacio de embeddings que nuestros documentos almacenados:
user_embedding = generate_embedding("What did the software engineering dept do last year?")Paso 5: Buscar documentos relevantes
Finalmente, buscamos en nuestro almacén de vectores para encontrar los fragmentos más relevantes:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
Esto devuelve los dos fragmentos más similares junto con sus puntuaciones de distancia de coseno.
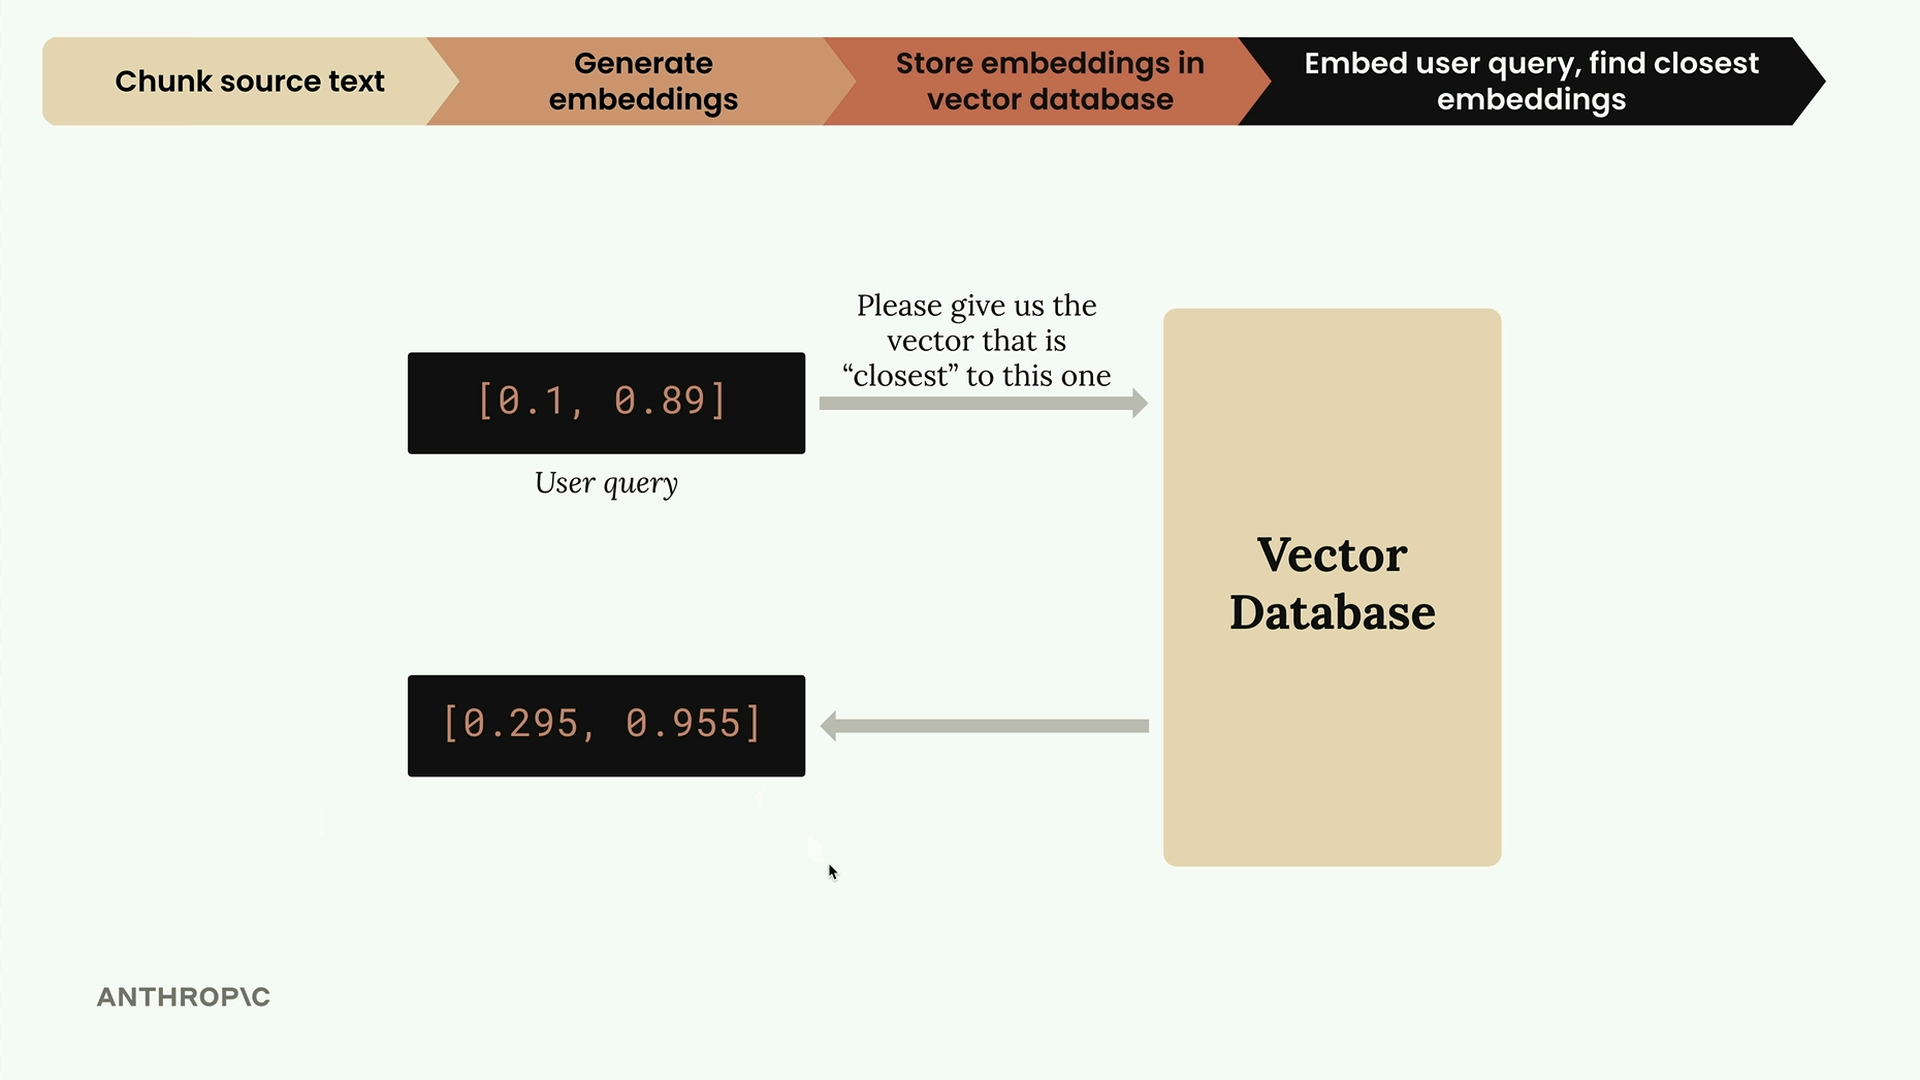
El diagrama anterior ilustra cómo la base de datos vectorial procesa una consulta del usuario. Cuando hacemos una pregunta, esta se convierte en un vector de embedding, y la base de datos encuentra los vectores almacenados que están "más cerca" de él en el espacio de alta dimensionalidad.
Entendiendo los resultados
Cuando ejecutamos este ejemplo con la consulta sobre el departamento de ingeniería de software, obtenemos dos secciones relevantes:
- Sección 2: Ingeniería de software - Mejoras de estabilidad del Proyecto Phoenix (distancia: 0.71)
- Sección de metodología (distancia: 0.72)
Cuanto menor sea la puntuación de distancia, más similar es el contenido a nuestra consulta. Ambos resultados son relevantes para nuestra pregunta sobre lo que logró el departamento de ingeniería de software.
Por qué almacenar el contenido junto con los embeddings
Podrías preguntarte por qué almacenamos el texto original junto a cada embedding. La razón es práctica: los embeddings son solo arreglos de números que no tienen un significado directo para los humanos. Cuando nuestra búsqueda devuelve los embeddings más similares, necesitamos el contenido de texto real para entender qué se encontró y usarlo al generar respuestas.
Algunas implementaciones almacenan solo un ID que apunta de vuelta al texto original, pero, por simplicidad, nosotros almacenamos el contenido directamente con cada vector.
Qué sigue
Esta implementación cubre el flujo de trabajo principal de RAG, pero aún hay mejoras que podemos hacer. En aplicaciones del mundo real, podrías encontrarte con escenarios en los que este enfoque básico no funcione como se espera, y exploraremos esos refinamientos en las próximas secciones.