Al construir flujos de trabajo de evaluación de prompts, los sistemas de calificación proporcionan señales objetivas sobre la calidad de la salida. Un calificador (grader) toma la salida del modelo y devuelve algún tipo de retroalimentación medible, típicamente un número entre 1 y 10, donde 10 representa alta calidad y 1 representa baja calidad.
Tipos de calificadores
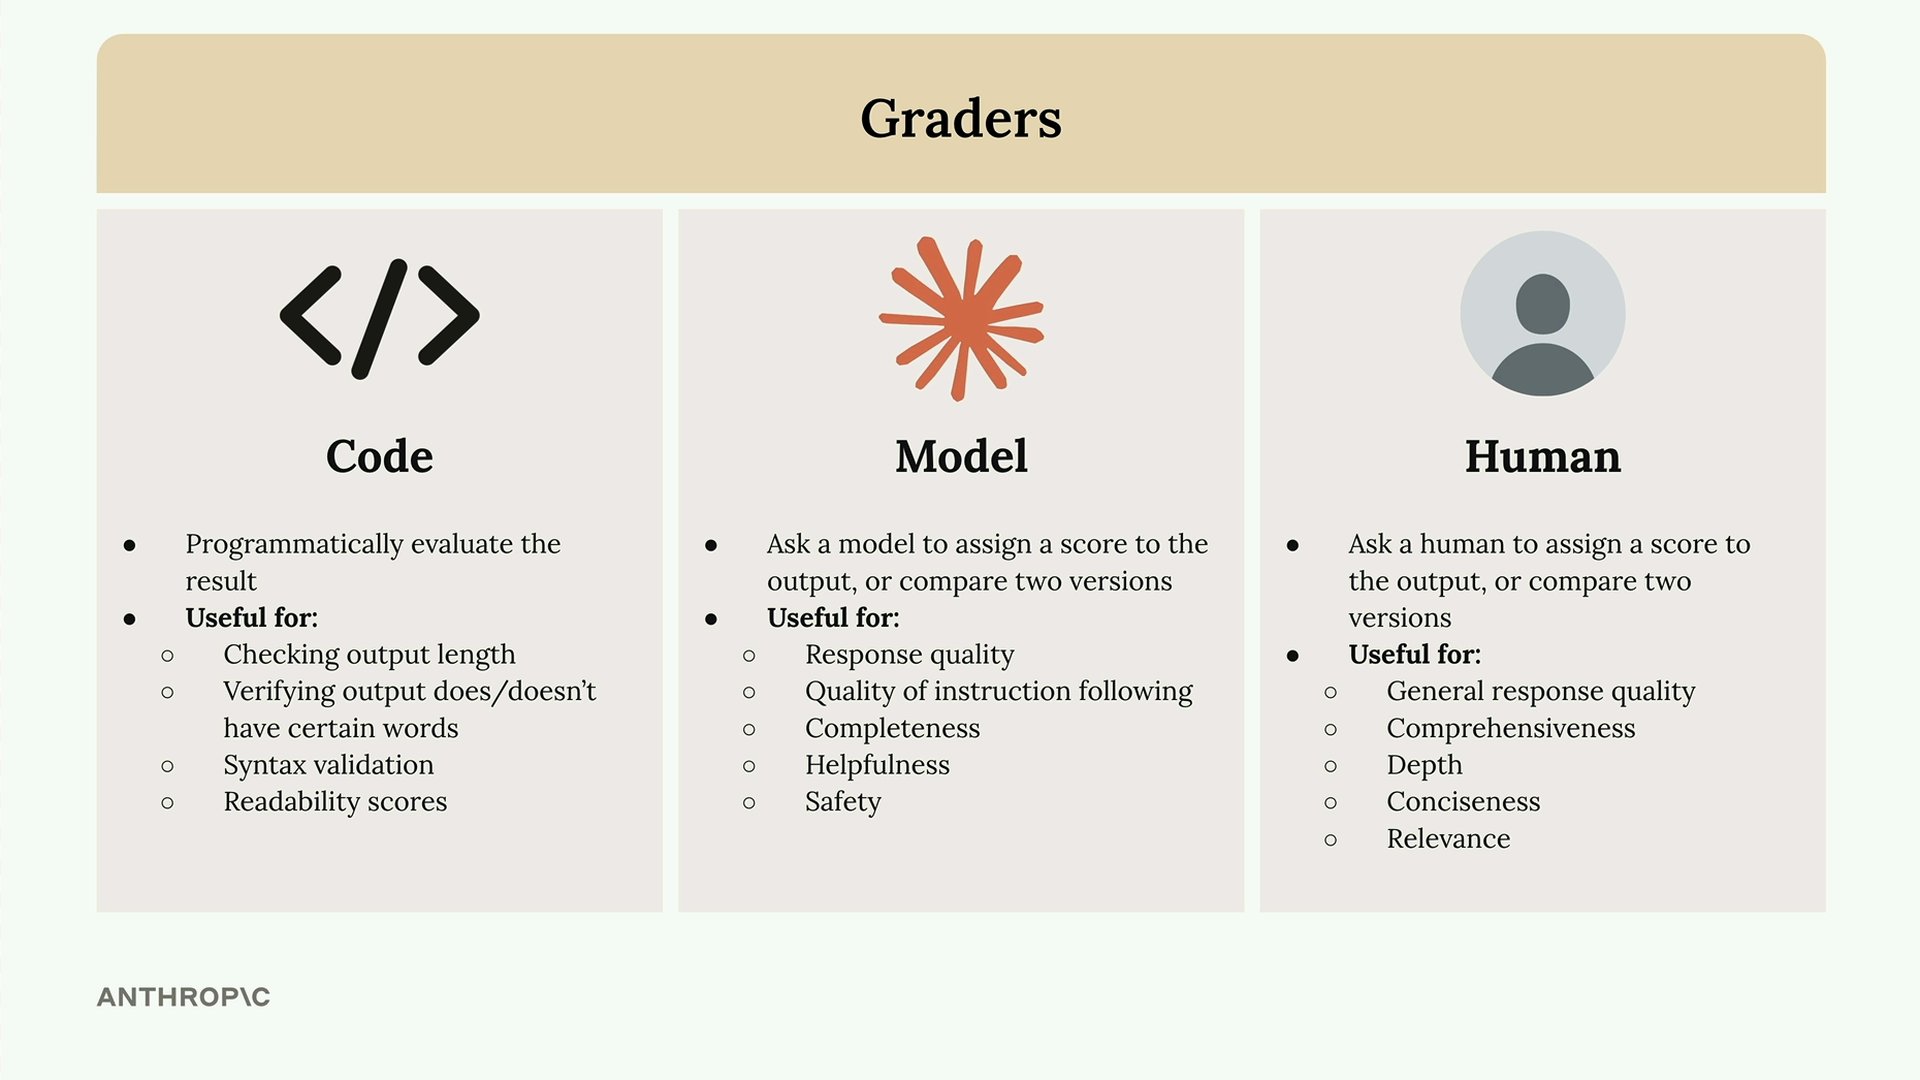
Existen tres enfoques principales para calificar las salidas de los modelos:
- Calificadores de código - Evalúan las salidas de forma programática usando código personalizado
- Calificadores de modelo - Usan otro modelo de IA para evaluar la calidad
- Calificadores humanos - Personas revisan y puntúan manualmente las salidas
Calificadores de código
Los calificadores de código te permiten implementar cualquier verificación programática que puedas imaginar. Los usos comunes incluyen:
- Comprobar la longitud de la salida
- Verificar que la salida contenga o no ciertas palabras
- Validación de sintaxis para JSON, Python o regex
- Puntuaciones de legibilidad para asegurar niveles de lectura apropiados
Calificadores de modelo
Los calificadores de modelo ofrecen una gran flexibilidad al usar una llamada adicional a la API para evaluar las salidas. Son útiles para evaluar:
- Calidad de la respuesta
- Calidad del seguimiento de instrucciones
- Completitud
- Utilidad
- Seguridad
Calificadores humanos
Los calificadores humanos ofrecen la mayor flexibilidad, pero conllevan desventajas significativas. Si bien las personas pueden evaluar las respuestas según cualquier criterio imaginable, el proceso consume mucho tiempo y resulta tedioso.
Definición de los criterios de evaluación
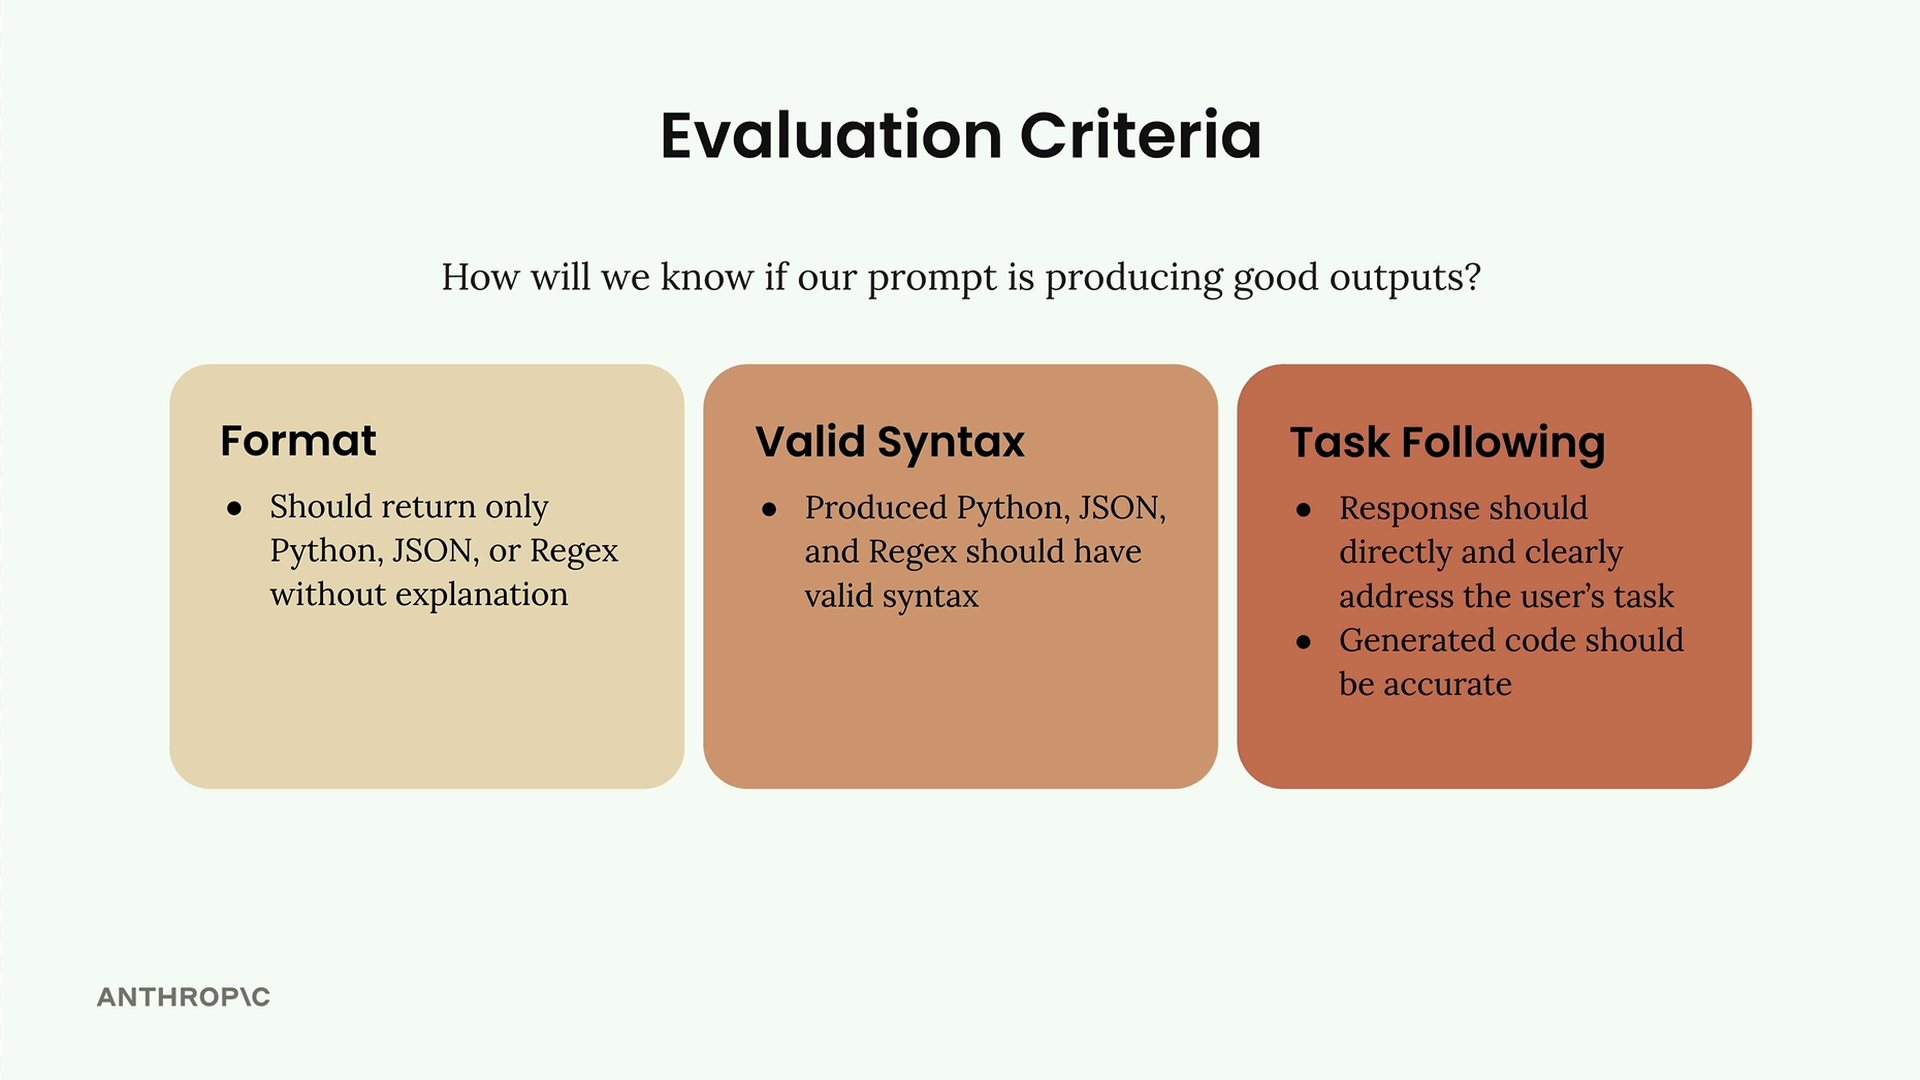
Antes de implementar cualquier calificador, necesitas criterios de evaluación claros. Para un prompt de generación de código, podrías enfocarte en:
- Formato - Debe devolver únicamente Python, JSON o Regex sin explicación
- Sintaxis válida - El código producido debe tener una sintaxis válida
- Seguimiento de la tarea - La respuesta debe abordar directamente la tarea del usuario con código preciso
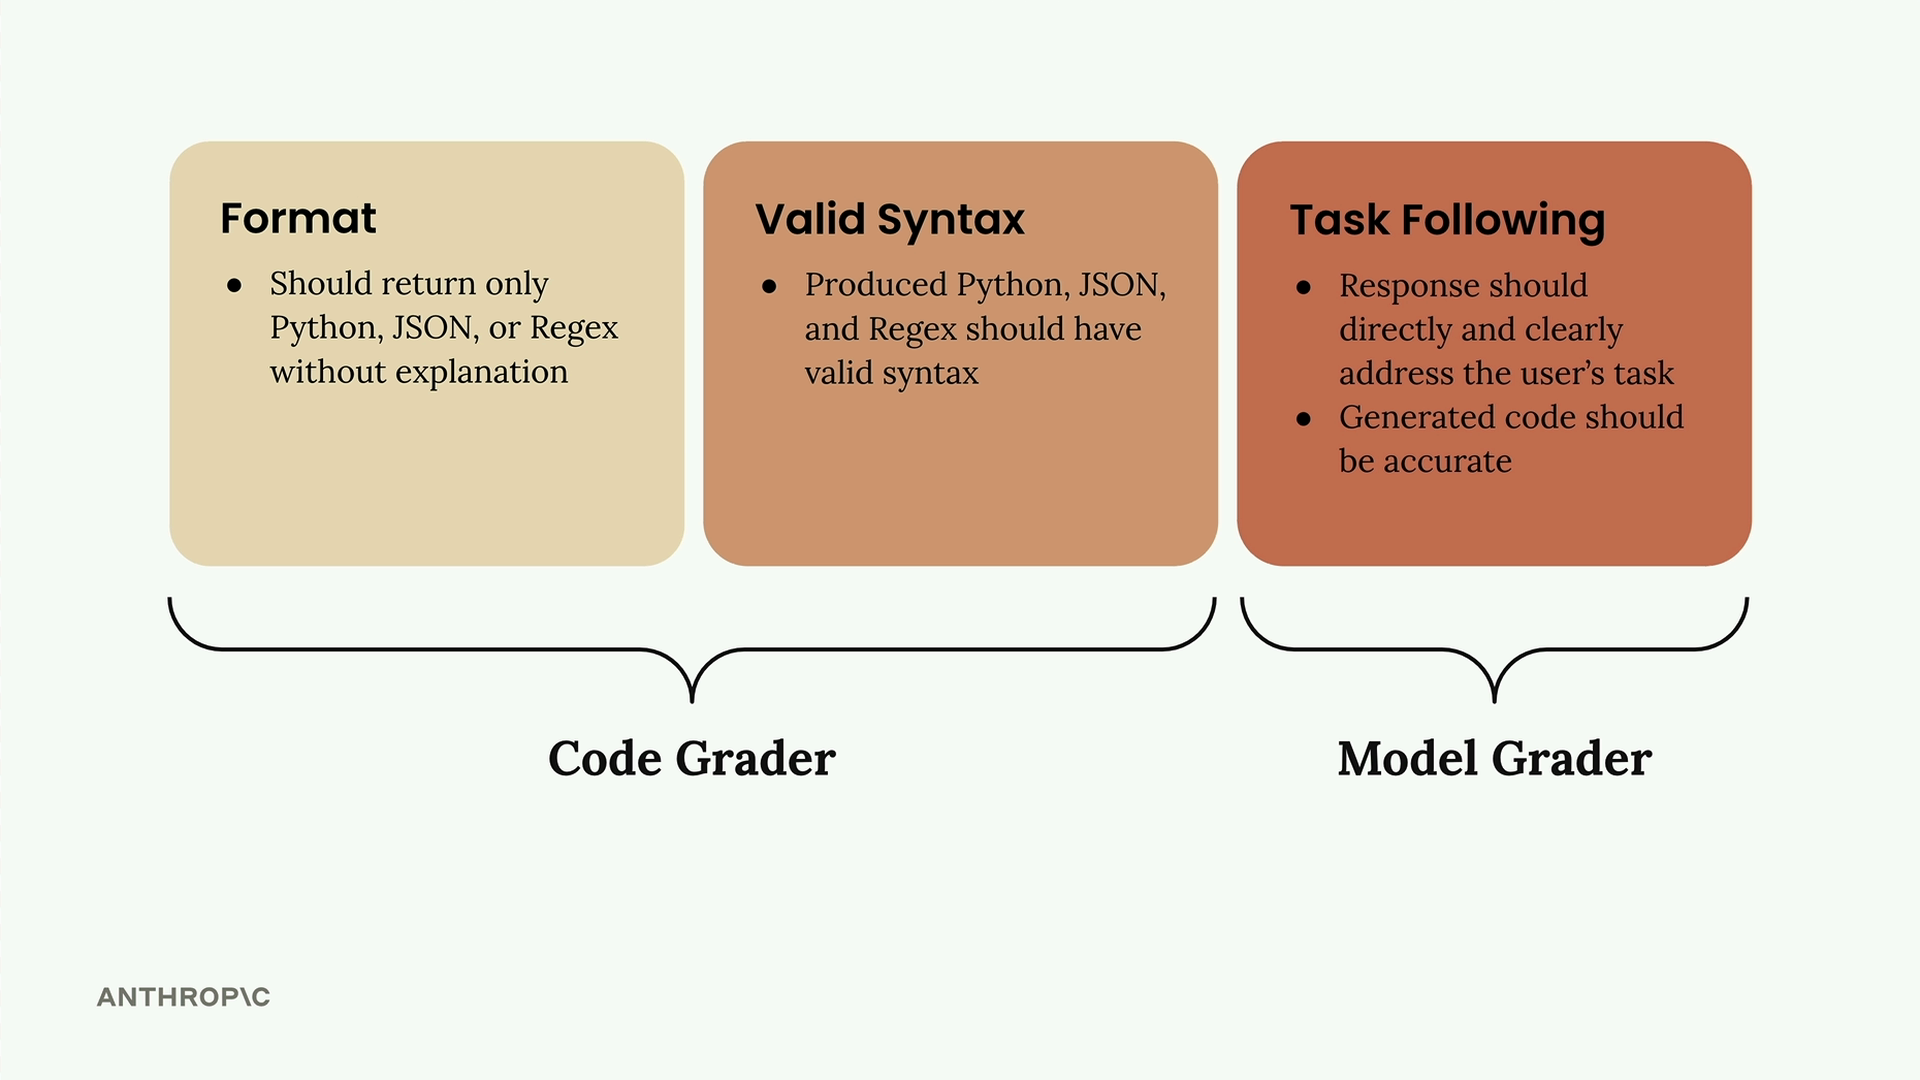
Los dos primeros criterios funcionan bien con calificadores de código, mientras que el seguimiento de la tarea se adapta mejor a los calificadores de modelo debido a su flexibilidad.
Implementación de un calificador de modelo
Los calificadores de modelo suelen ser los más fáciles de implementar. Aquí tienes una estructura básica:
def grade_by_model(test_case, output):
    eval_prompt = f"""
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {test_case["task"]}
    Solution: {output}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")
    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)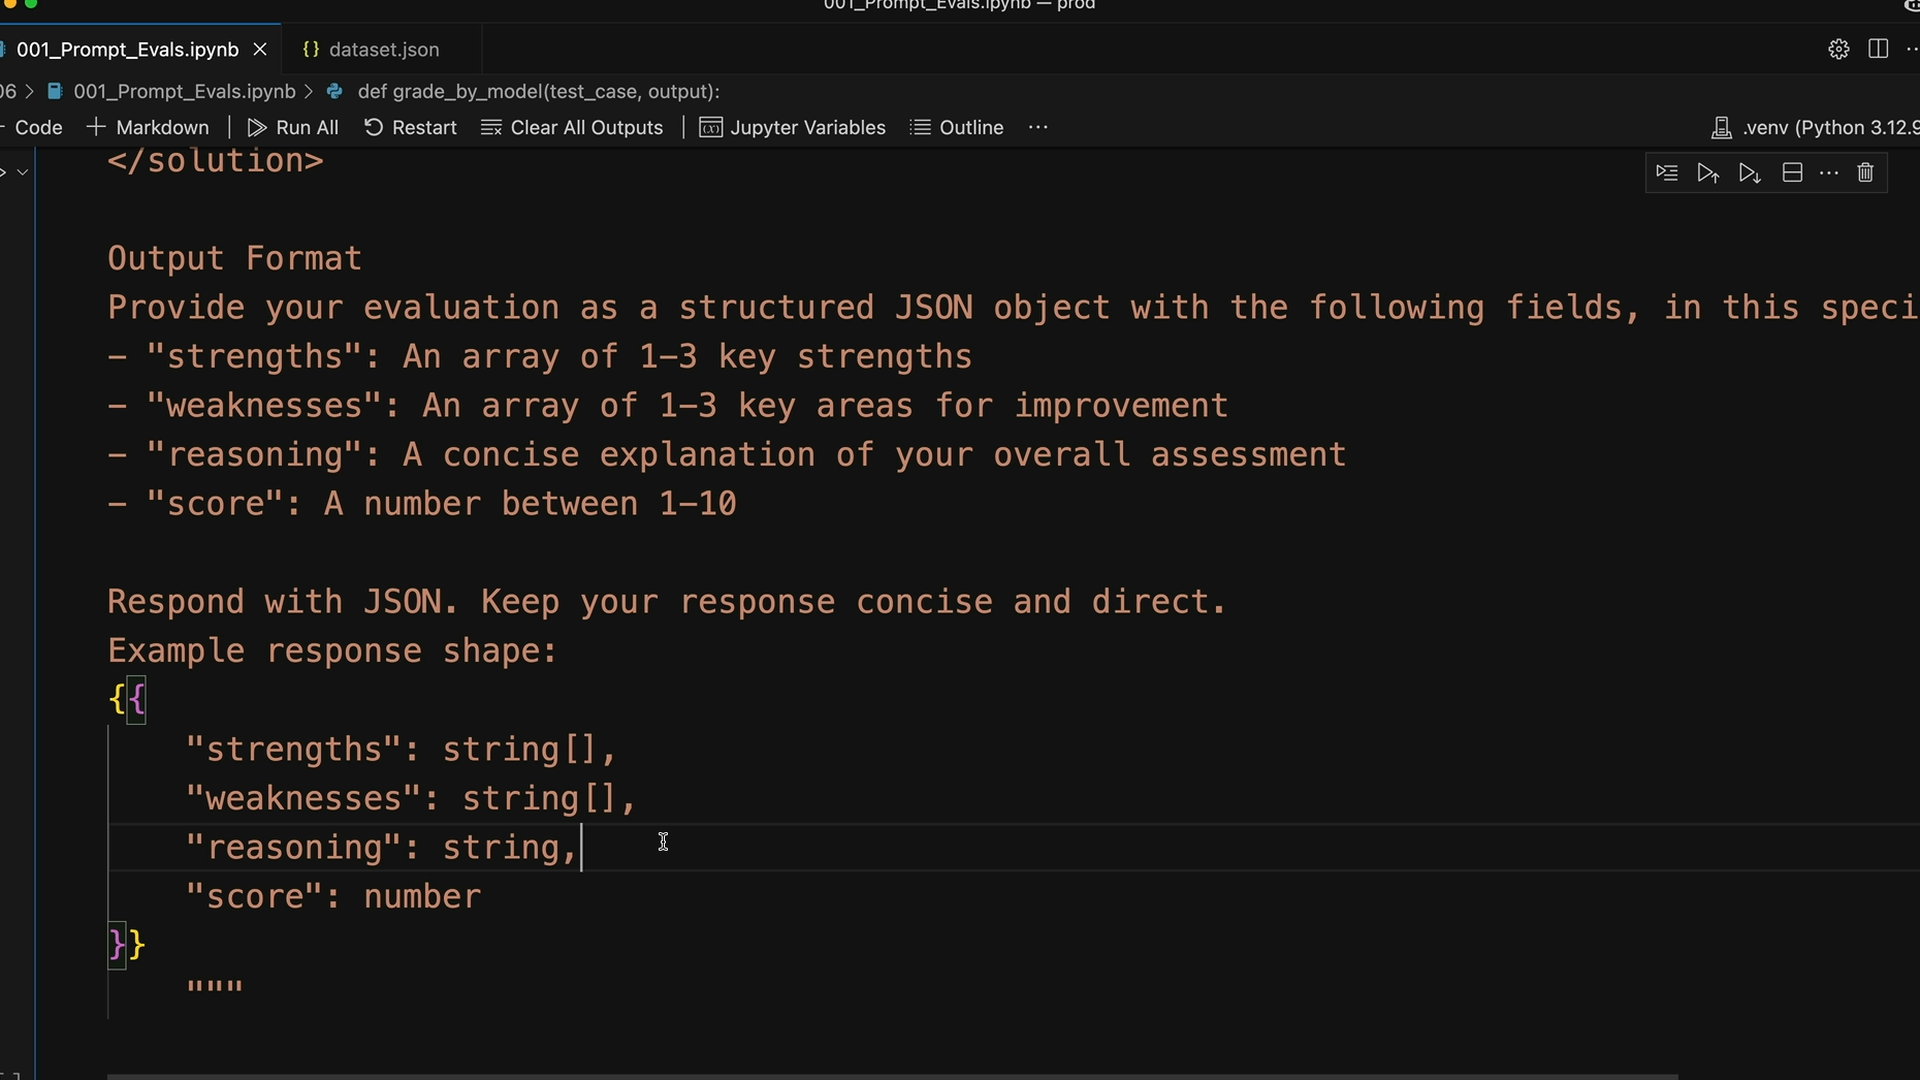
El prompt de calificación debe ser exhaustivo e incluir:
- Una definición clara del rol del calificador
- La tarea original
- La solución generada por la IA a evaluar
- Requisitos específicos del formato de salida
Pide más que solo una puntuación. Solicita fortalezas, debilidades y razonamiento junto con la puntuación numérica. Esto evita que el modelo recurra por defecto a puntuaciones mediocres como 6 y obliga a una evaluación más reflexiva.
Integración de calificadores en tu flujo de trabajo
Una vez que tengas una función calificadora, intégrala en tu ejecutor de casos de prueba:
def run_test_case(test_case):
    output = run_prompt(test_case)

    # Llama al evaluador del modelo
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
Después de ejecutar todos los casos de prueba, calcula una puntuación promedio para obtener una métrica objetiva del rendimiento de tu prompt:
from statistics import mean

def run_eval(dataset):
    results = []
    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
Esto te proporciona un número concreto en el que enfocarte para mejorar. Aunque los calificadores de modelo pueden ser algo caprichosos y podrían beneficiarse de mejores indicaciones, ofrecen un punto de partida para una evaluación objetiva que puedes iterar y mejorar.