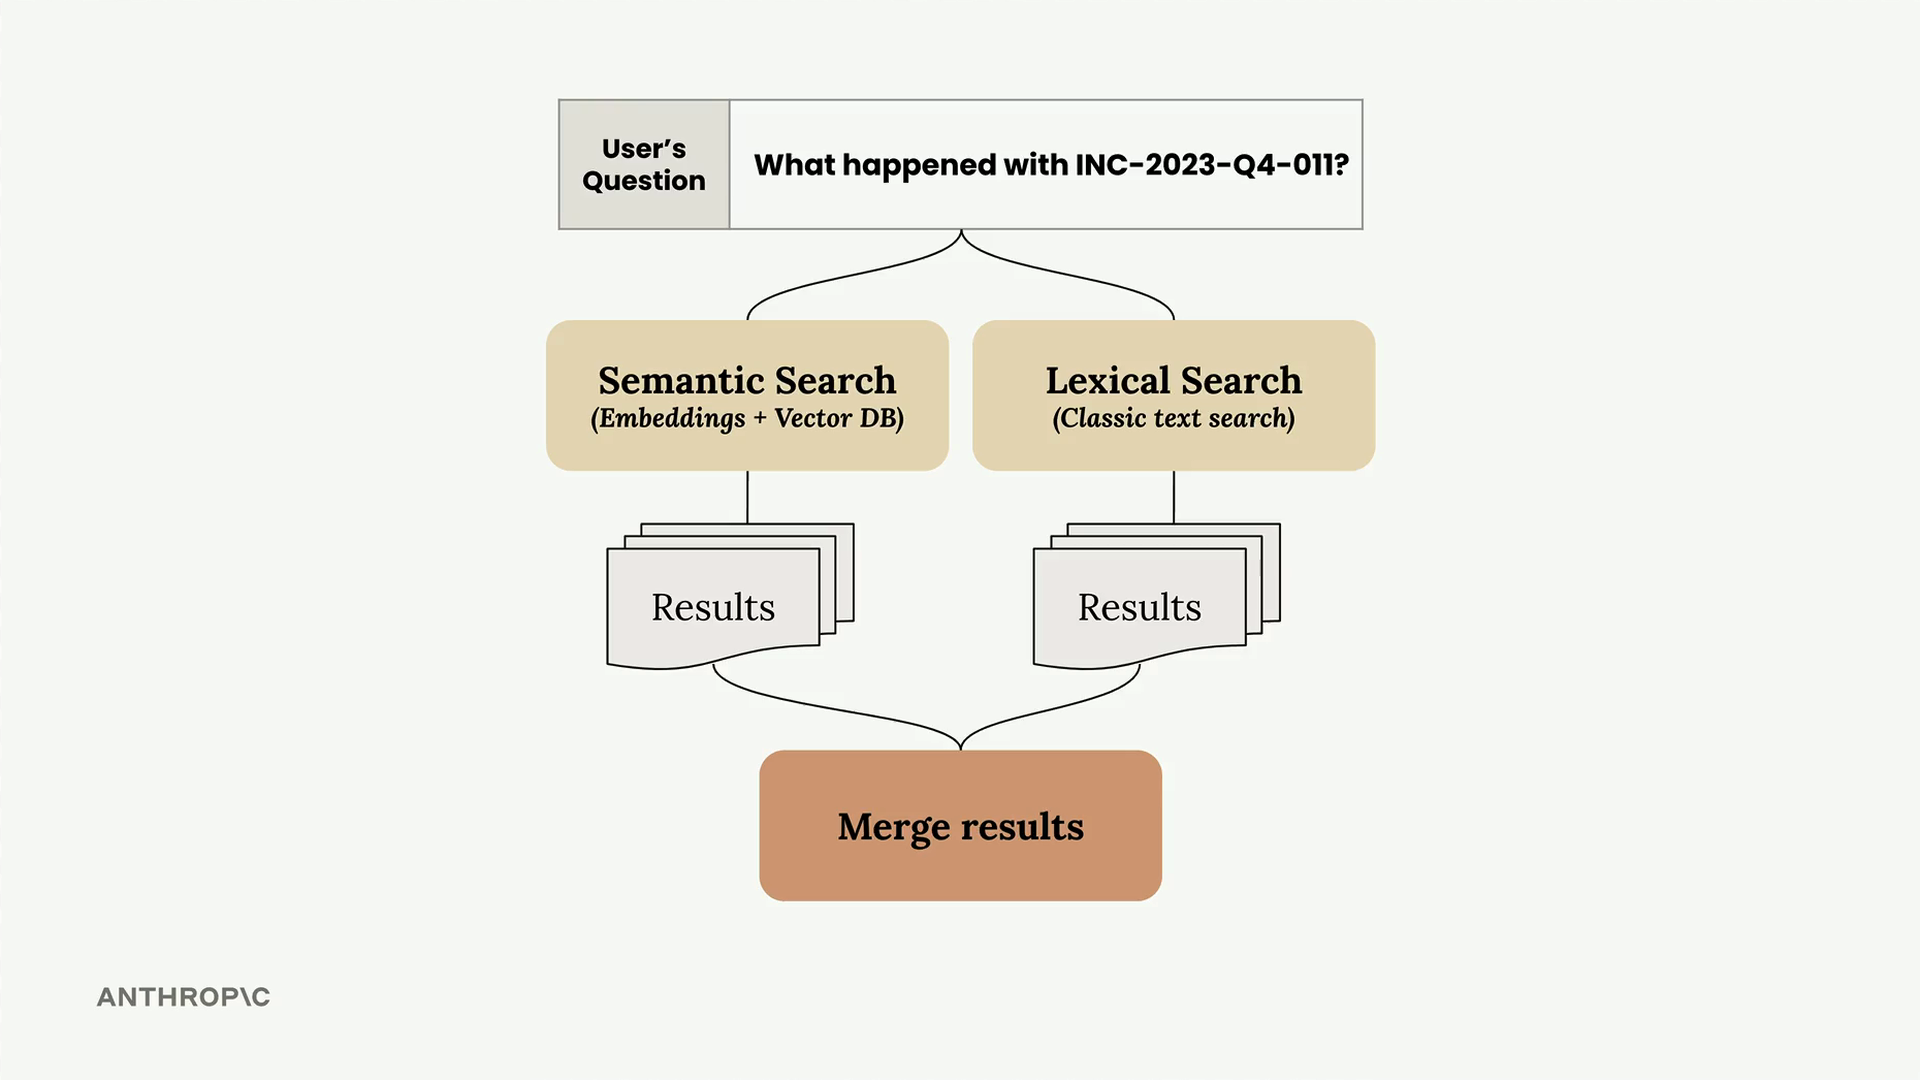
Cuando tienes tanto la búsqueda semántica (embeddings vectoriales) como la búsqueda léxica (BM25) funcionando de forma independiente, el siguiente paso es combinarlas en un pipeline de búsqueda unificado. Este enfoque híbrido aprovecha las fortalezas de ambos métodos para ofrecer resultados más precisos.
Creación de una interfaz unificada
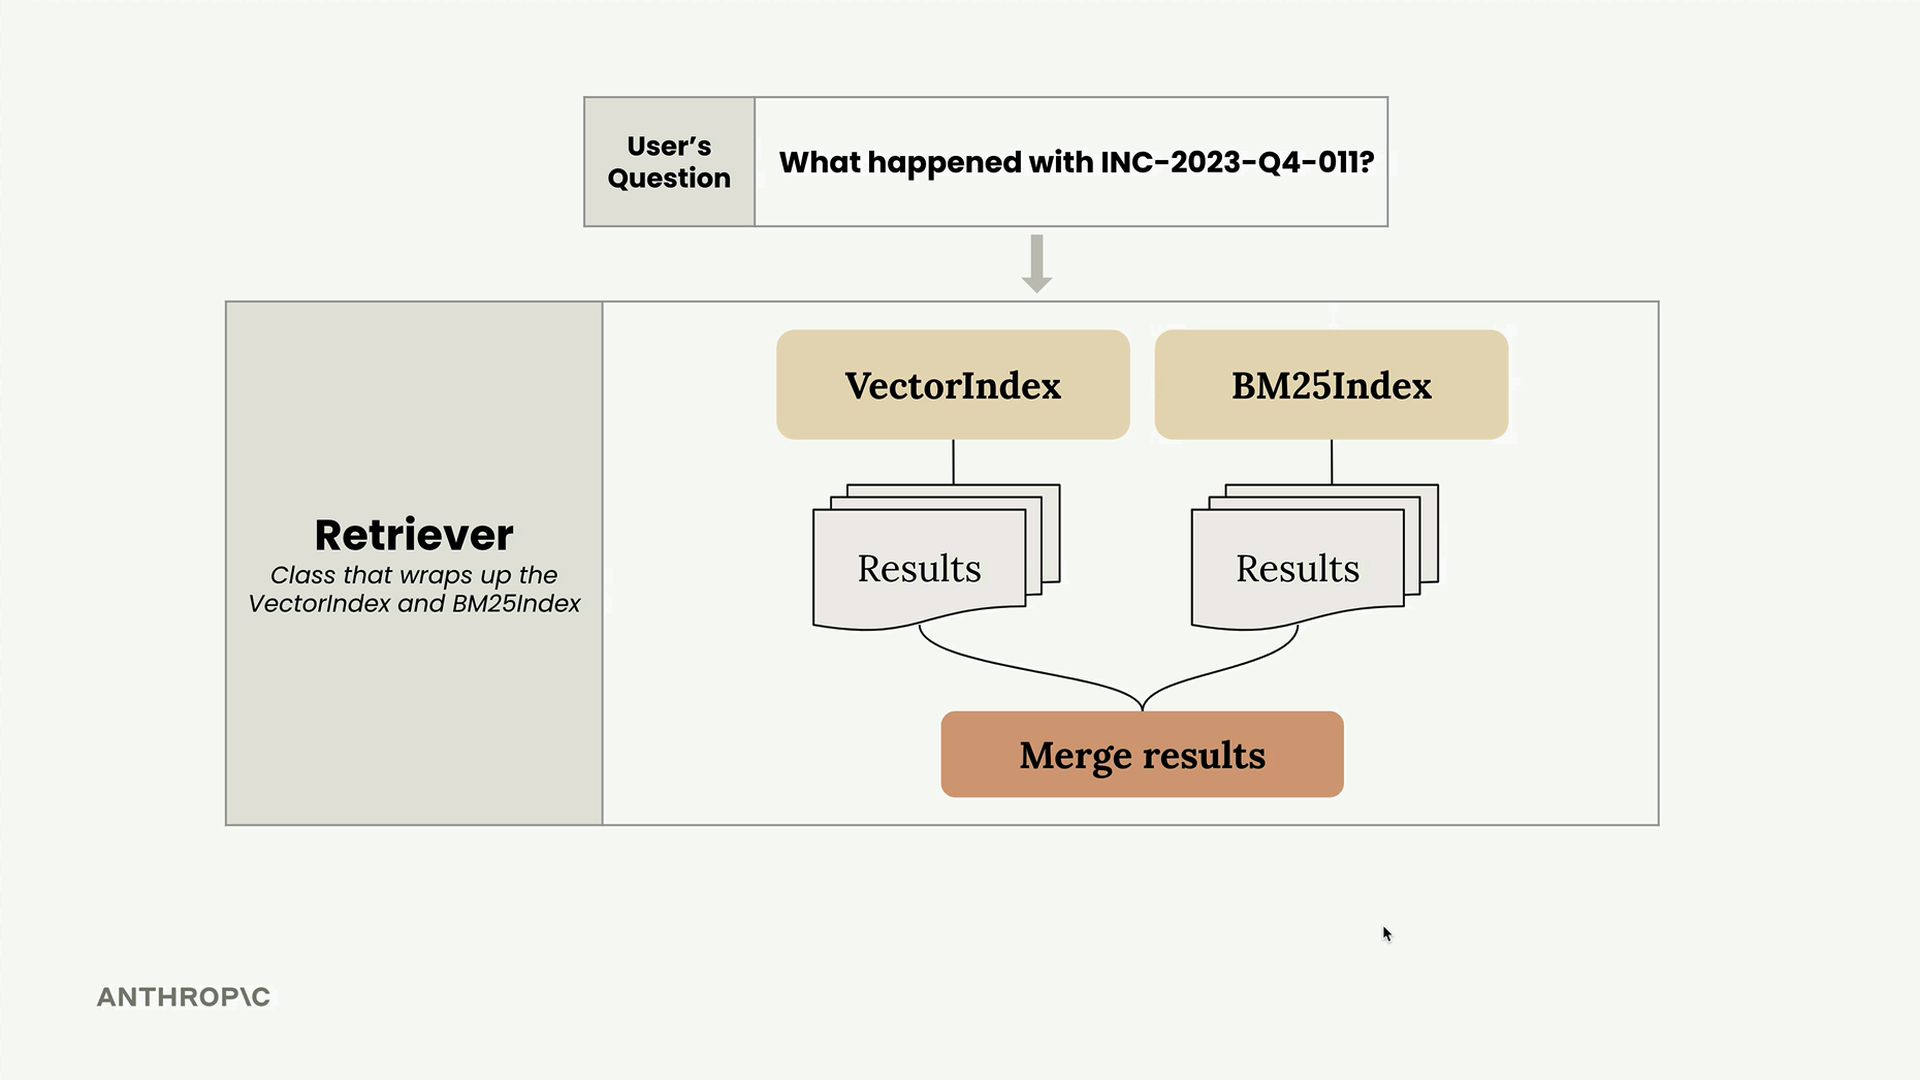
Ambas implementaciones de búsqueda comparten APIs casi idénticas: ambas tienen los métodos add_document() y search() que funcionan de la misma manera. Esta consistencia facilita envolverlas en una única clase Retriever.
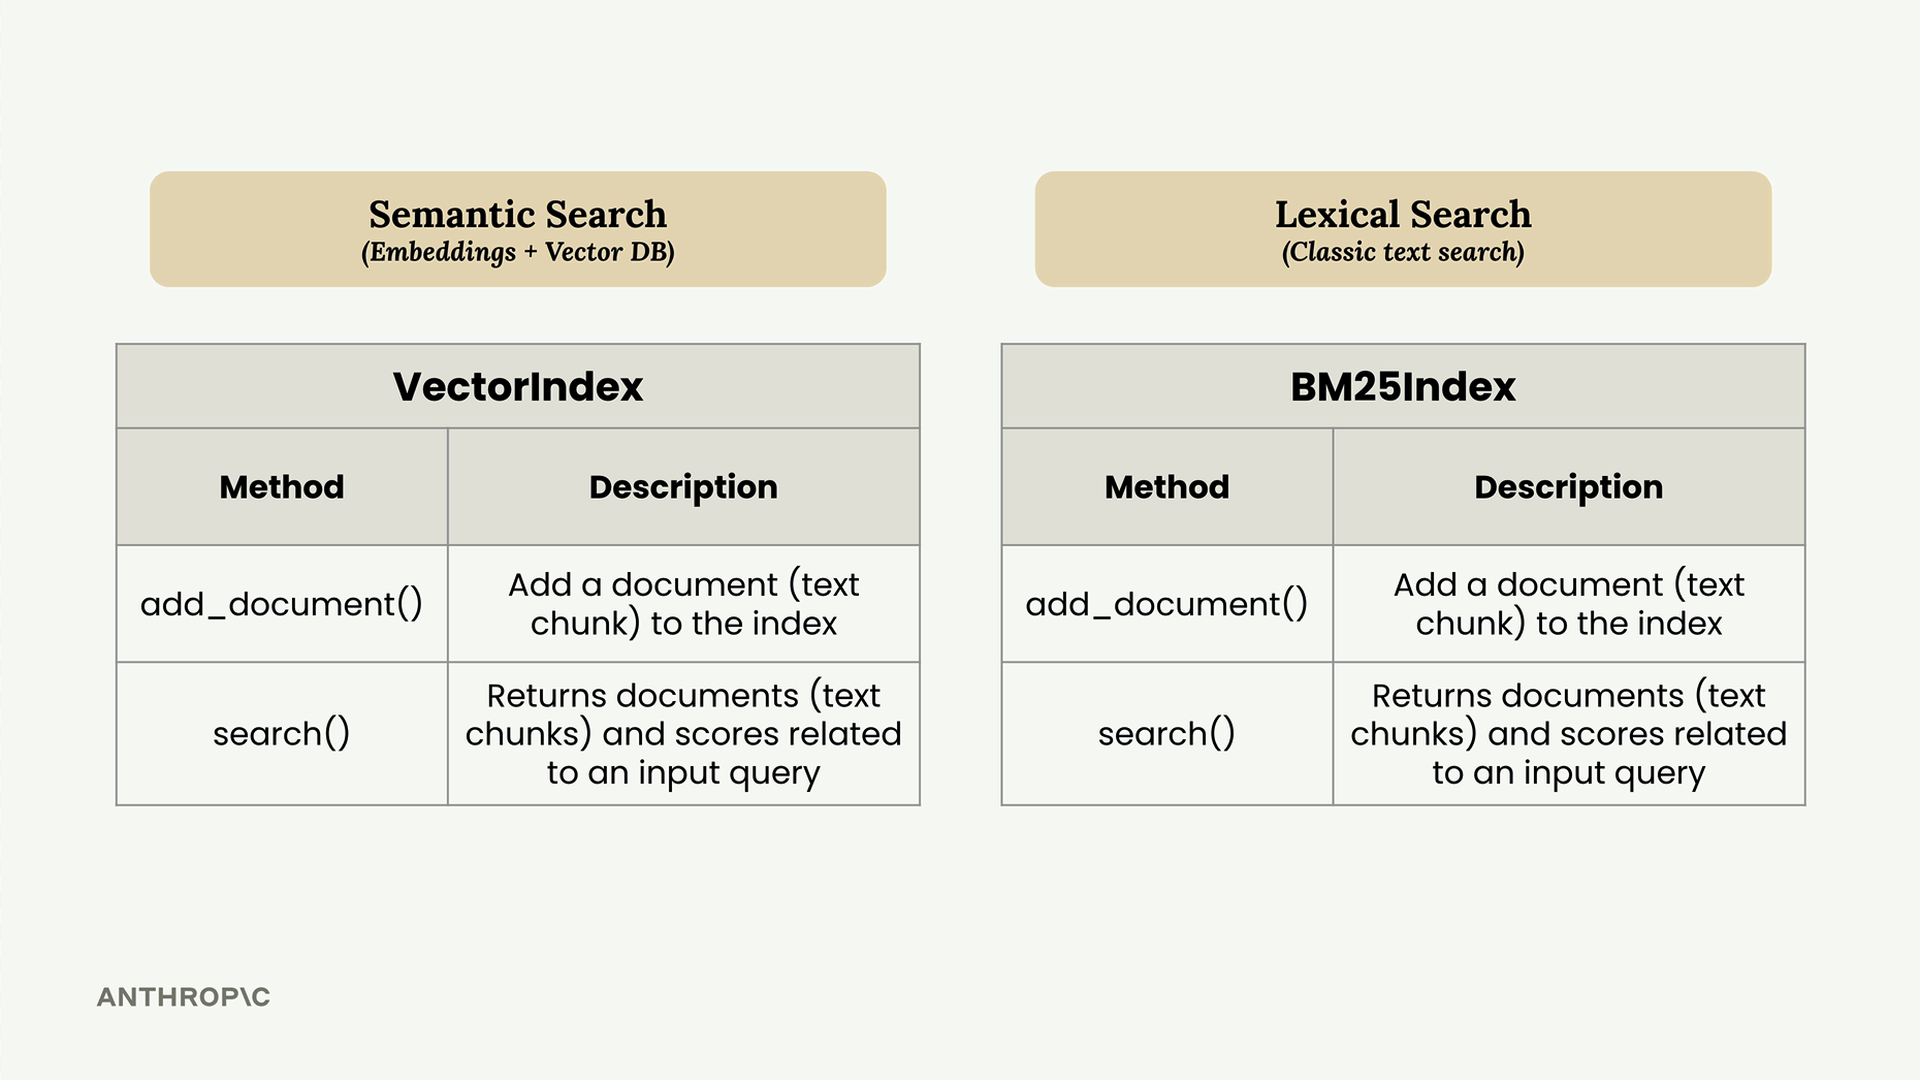
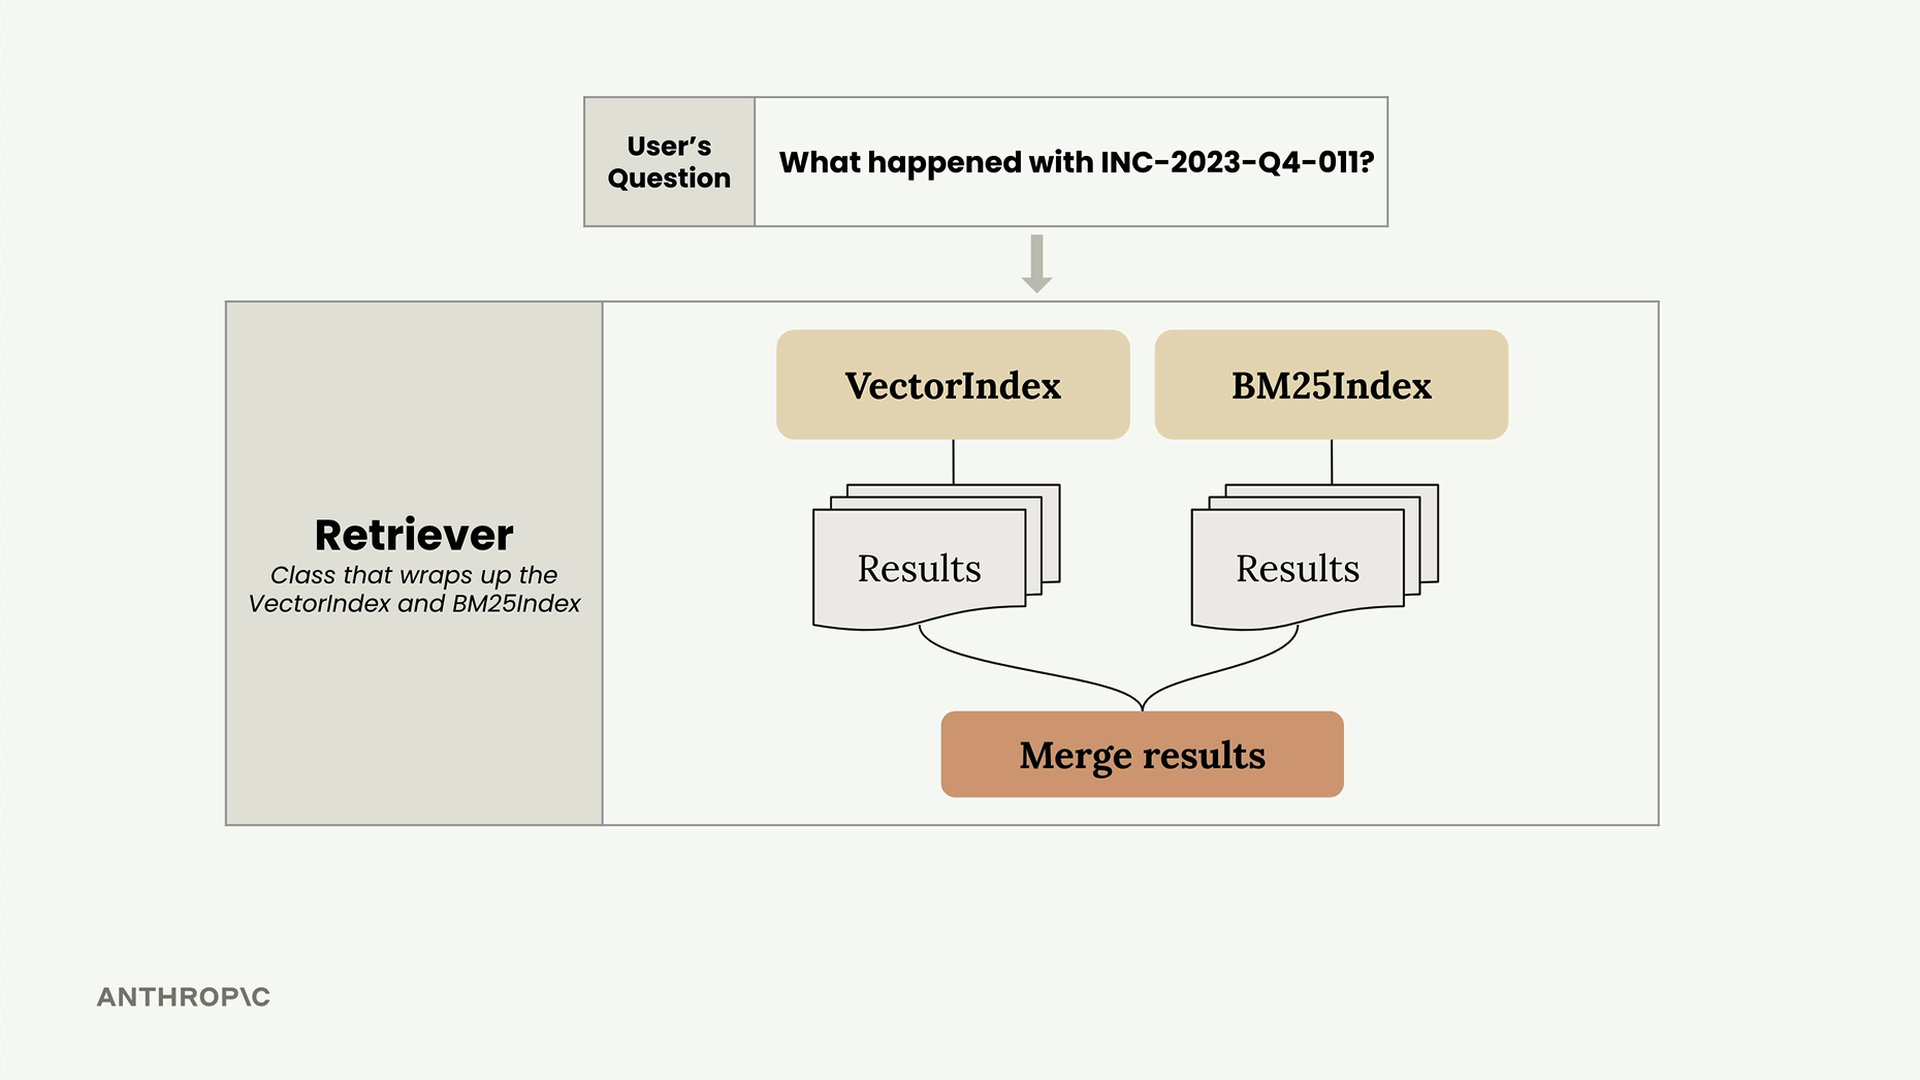
El Retriever actúa como un coordinador que reenvía las consultas del usuario a ambos índices, recopila sus resultados y los fusiona en una única lista clasificada.
Reciprocal Rank Fusion
El reto consiste en fusionar resultados de diferentes métodos de búsqueda que usan sistemas de puntuación distintos. La búsqueda vectorial devuelve puntuaciones de similitud de coseno, mientras que BM25 devuelve puntuaciones de relevancia; no puedes simplemente combinar estos números directamente.
En su lugar, usamos una técnica llamada Reciprocal Rank Fusion (RRF). Este método se centra en la posición de rango de los resultados en lugar de sus puntuaciones brutas.
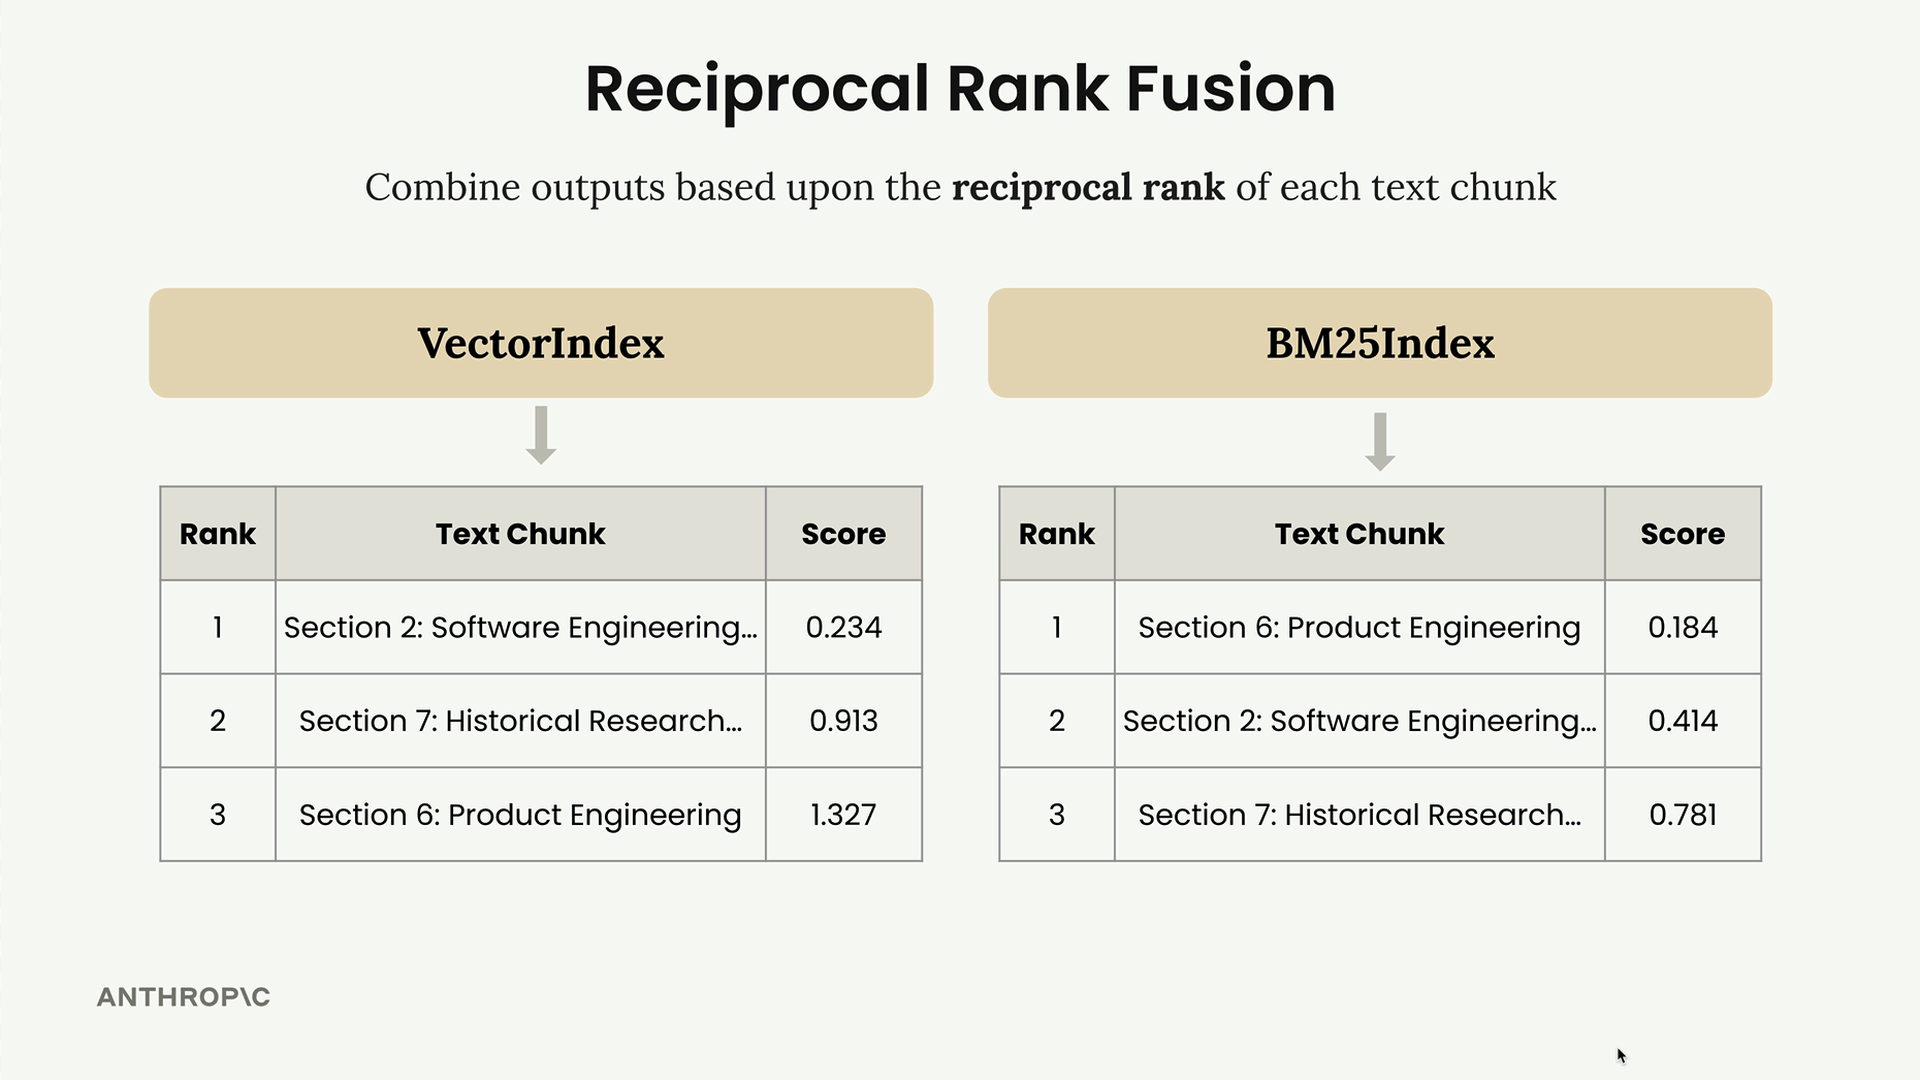
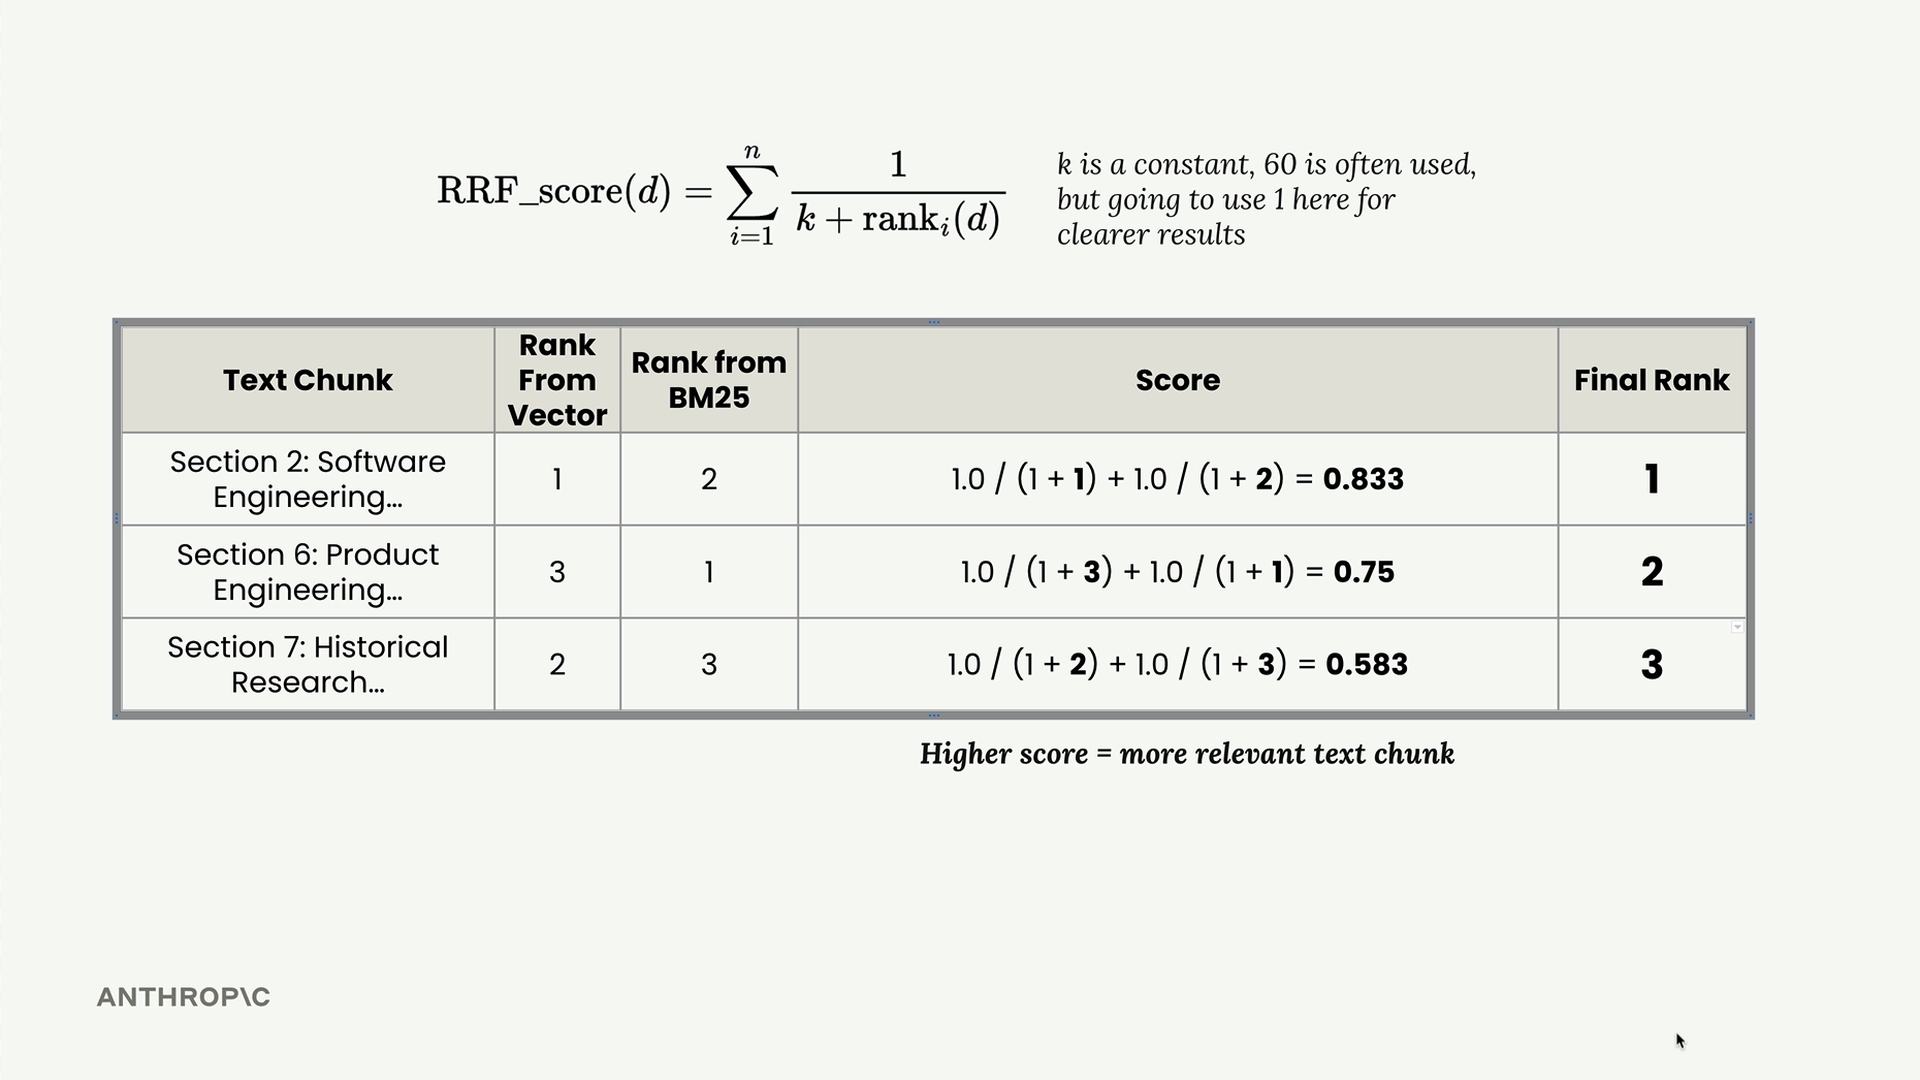
Así es como funciona con un ejemplo. Supongamos que tu búsqueda vectorial devuelve las secciones 2, 7 y 6 en ese orden, mientras que BM25 devuelve las secciones 6, 2 y 7. Para fusionar esto:
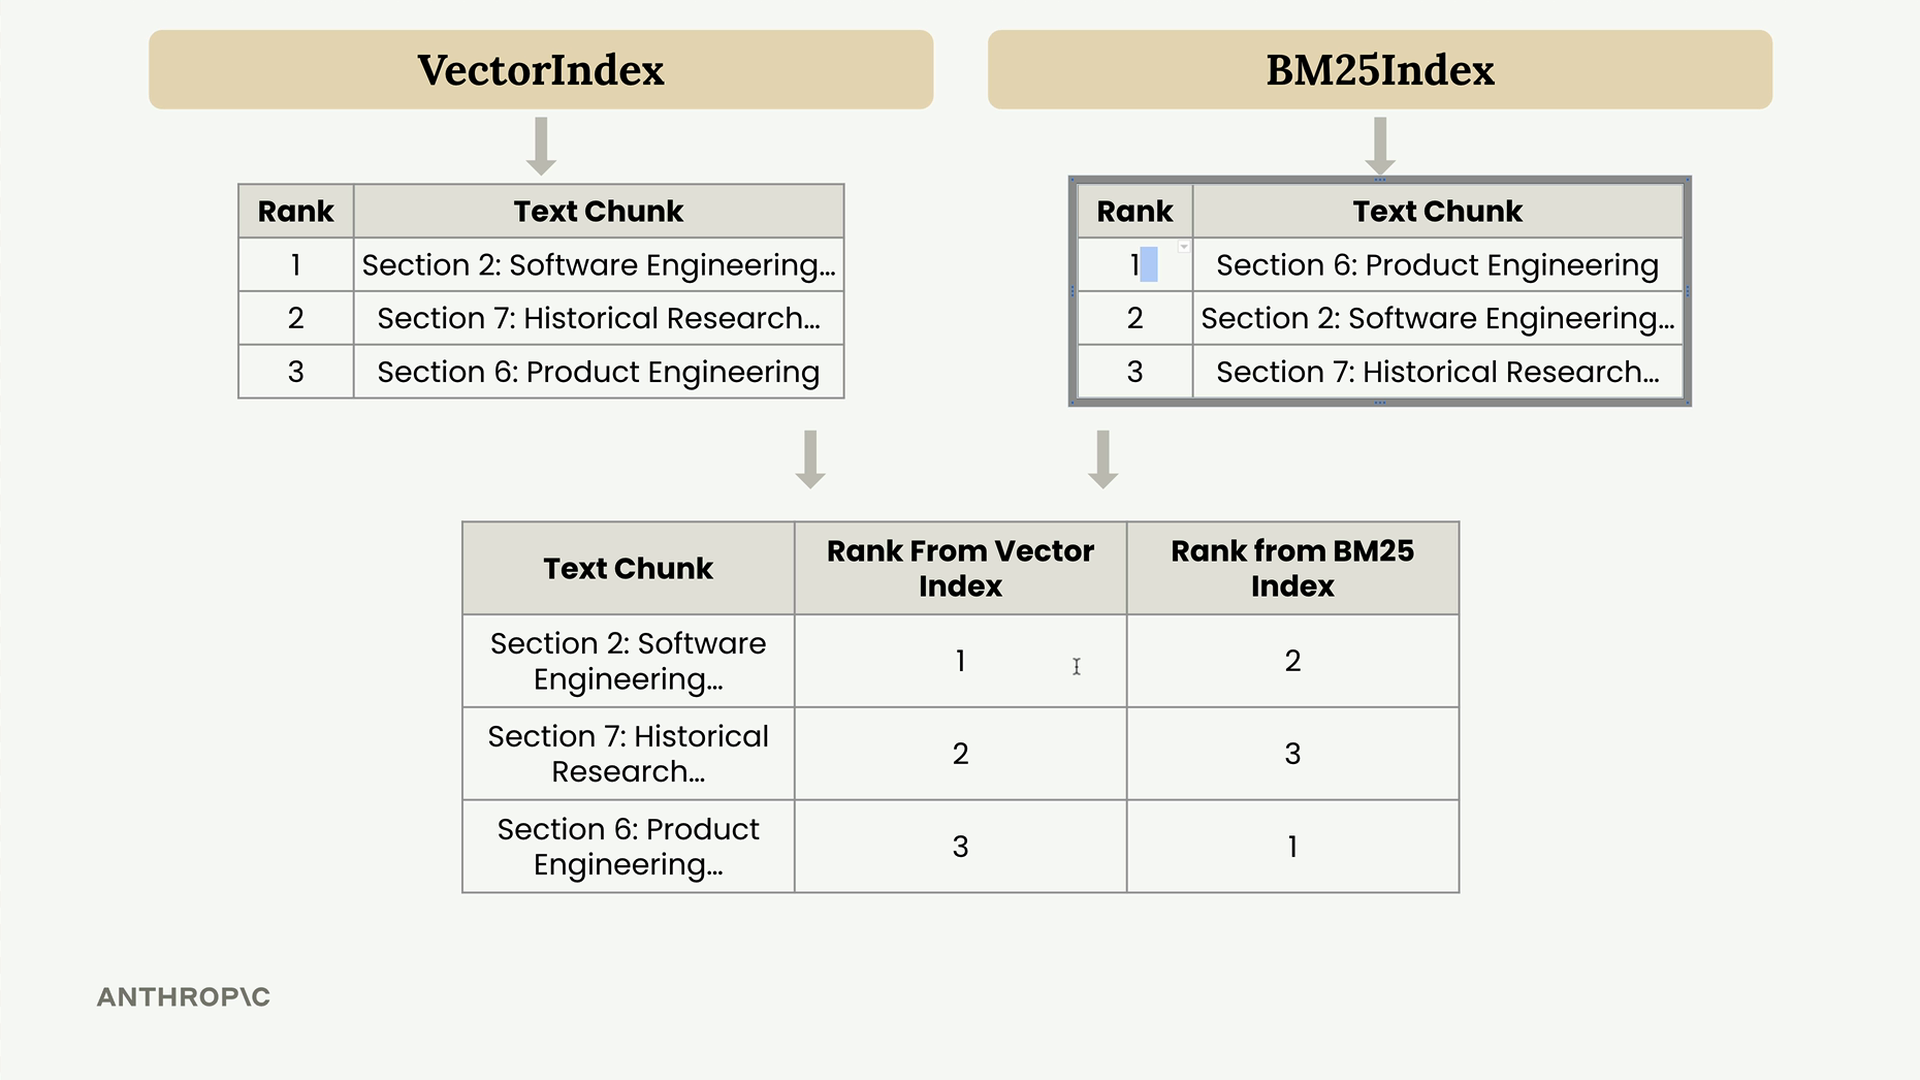
Primero, crea una tabla que muestre cada fragmento de texto y su rango en ambos métodos de búsqueda:
- Sección 2: Rango 1 en vector, rango 2 en BM25
- Sección 7: Rango 2 en vector, rango 3 en BM25
- Sección 6: Rango 3 en vector, rango 1 en BM25
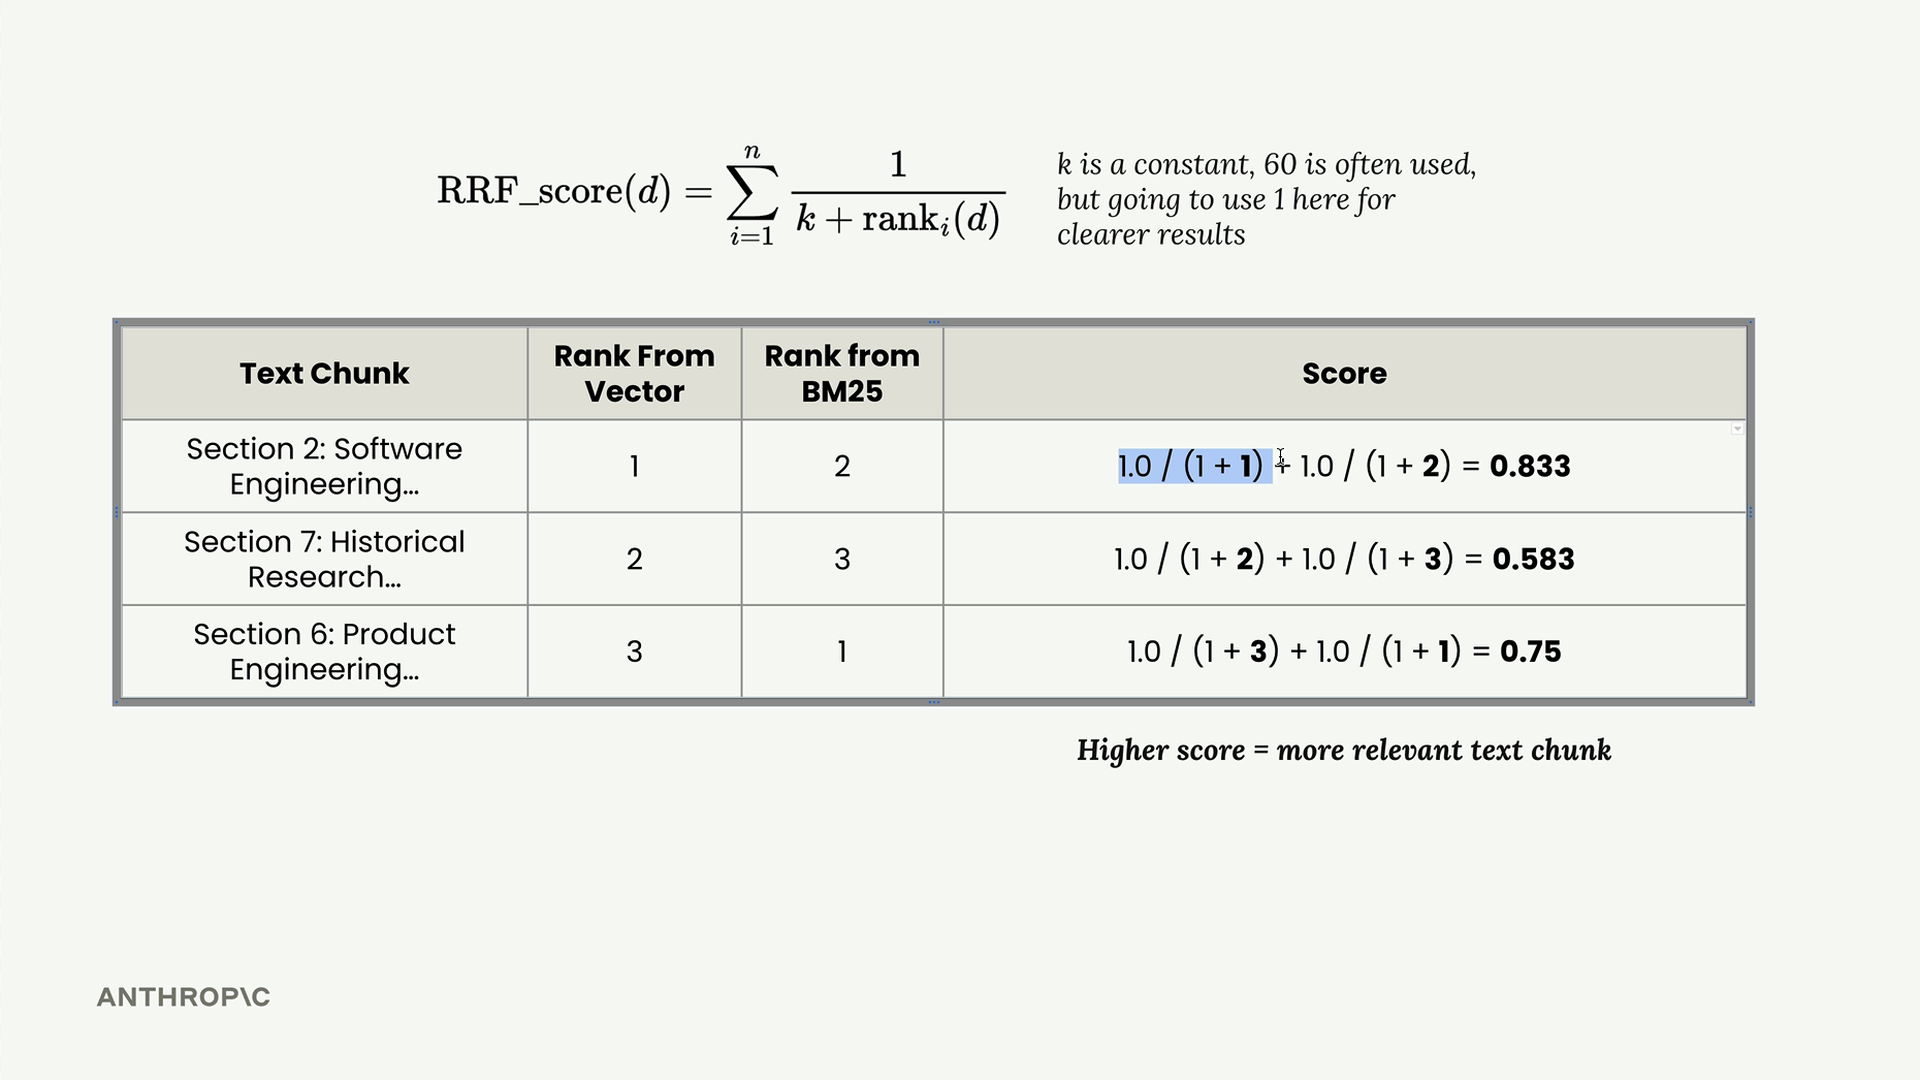
Luego aplica la fórmula RRF para calcular una puntuación combinada para cada fragmento:
RRF_score(d) = Σ(1 / (k + rank_i(d)))Donde k es una constante (típicamente 60, pero usaremos 1 para resultados más claros) y rank_i(d) es el rango del documento d en el i-ésimo resultado de búsqueda.
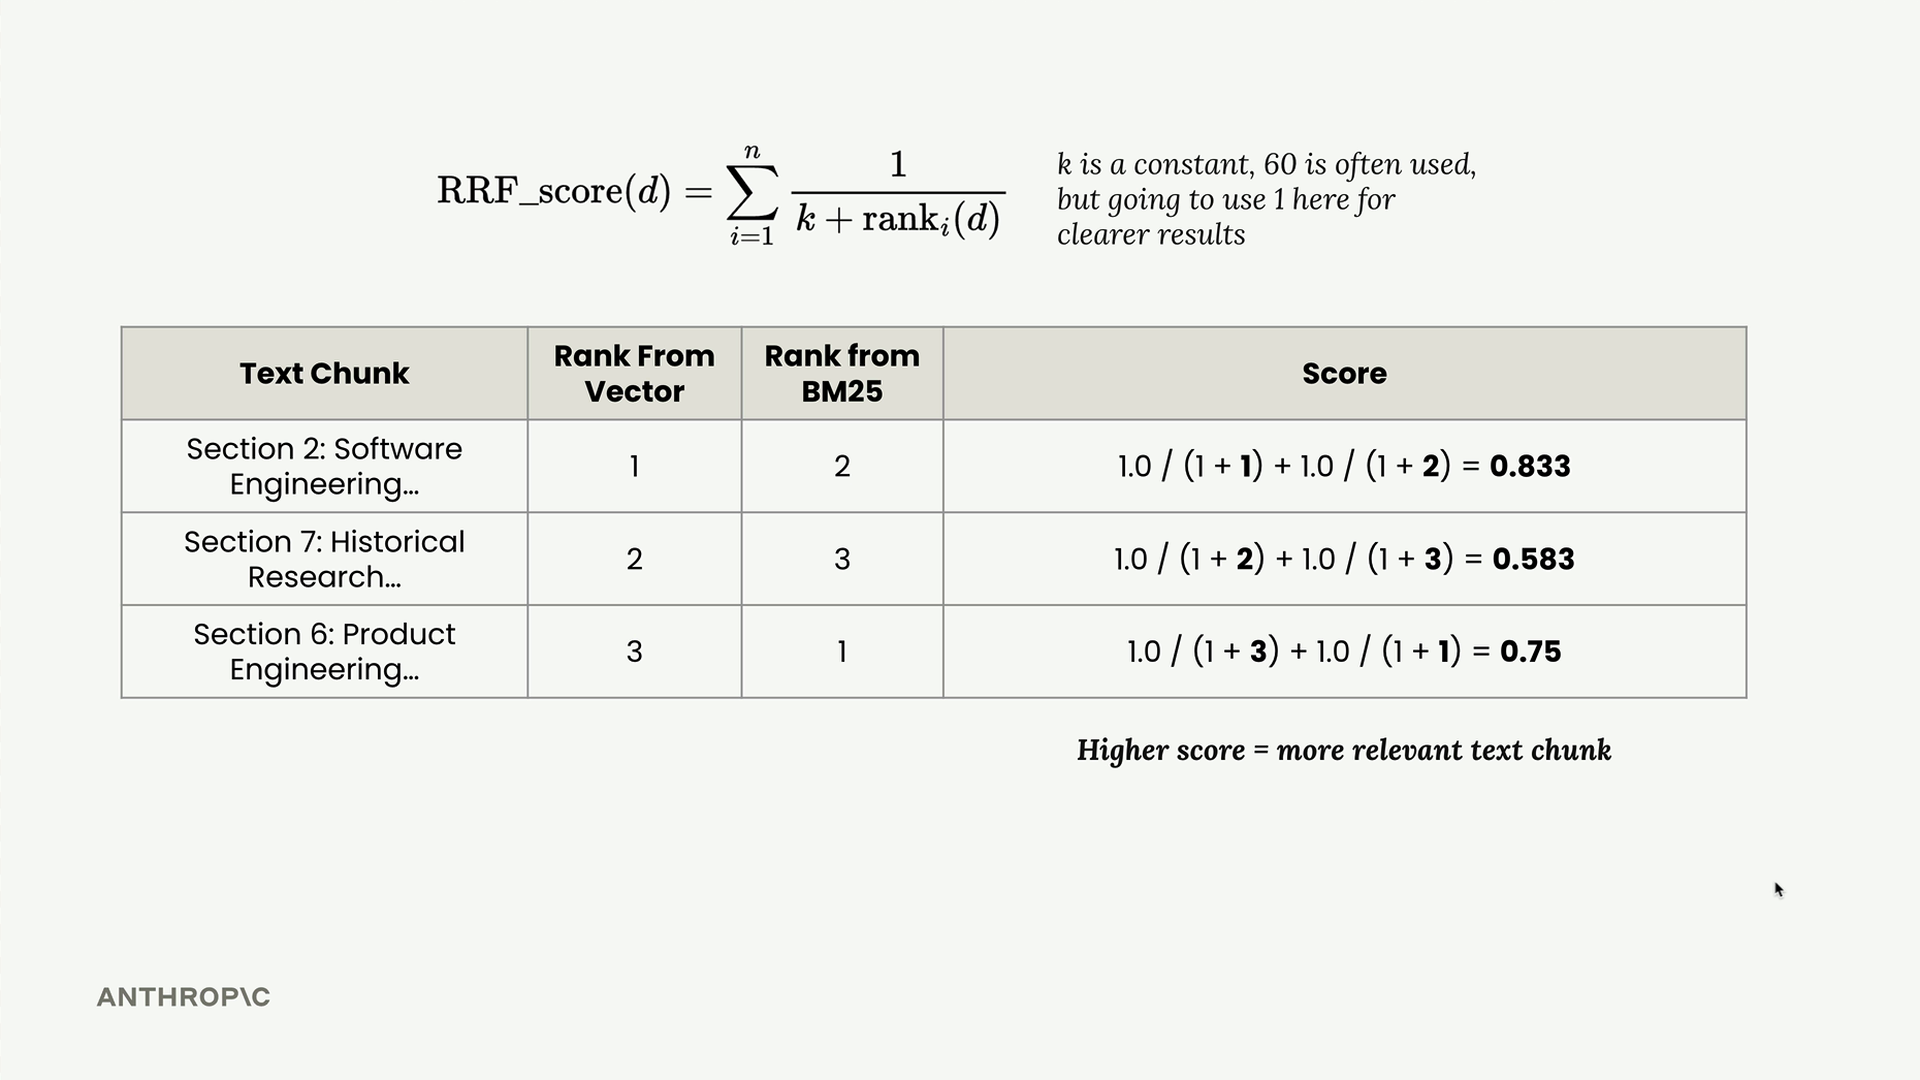
Para nuestro ejemplo:
- Sección 2: 1.0/(1+1) + 1.0/(1+2) = 0.833
- Sección 7: 1.0/(1+2) + 1.0/(1+3) = 0.583
- Sección 6: 1.0/(1+3) + 1.0/(1+1) = 0.75
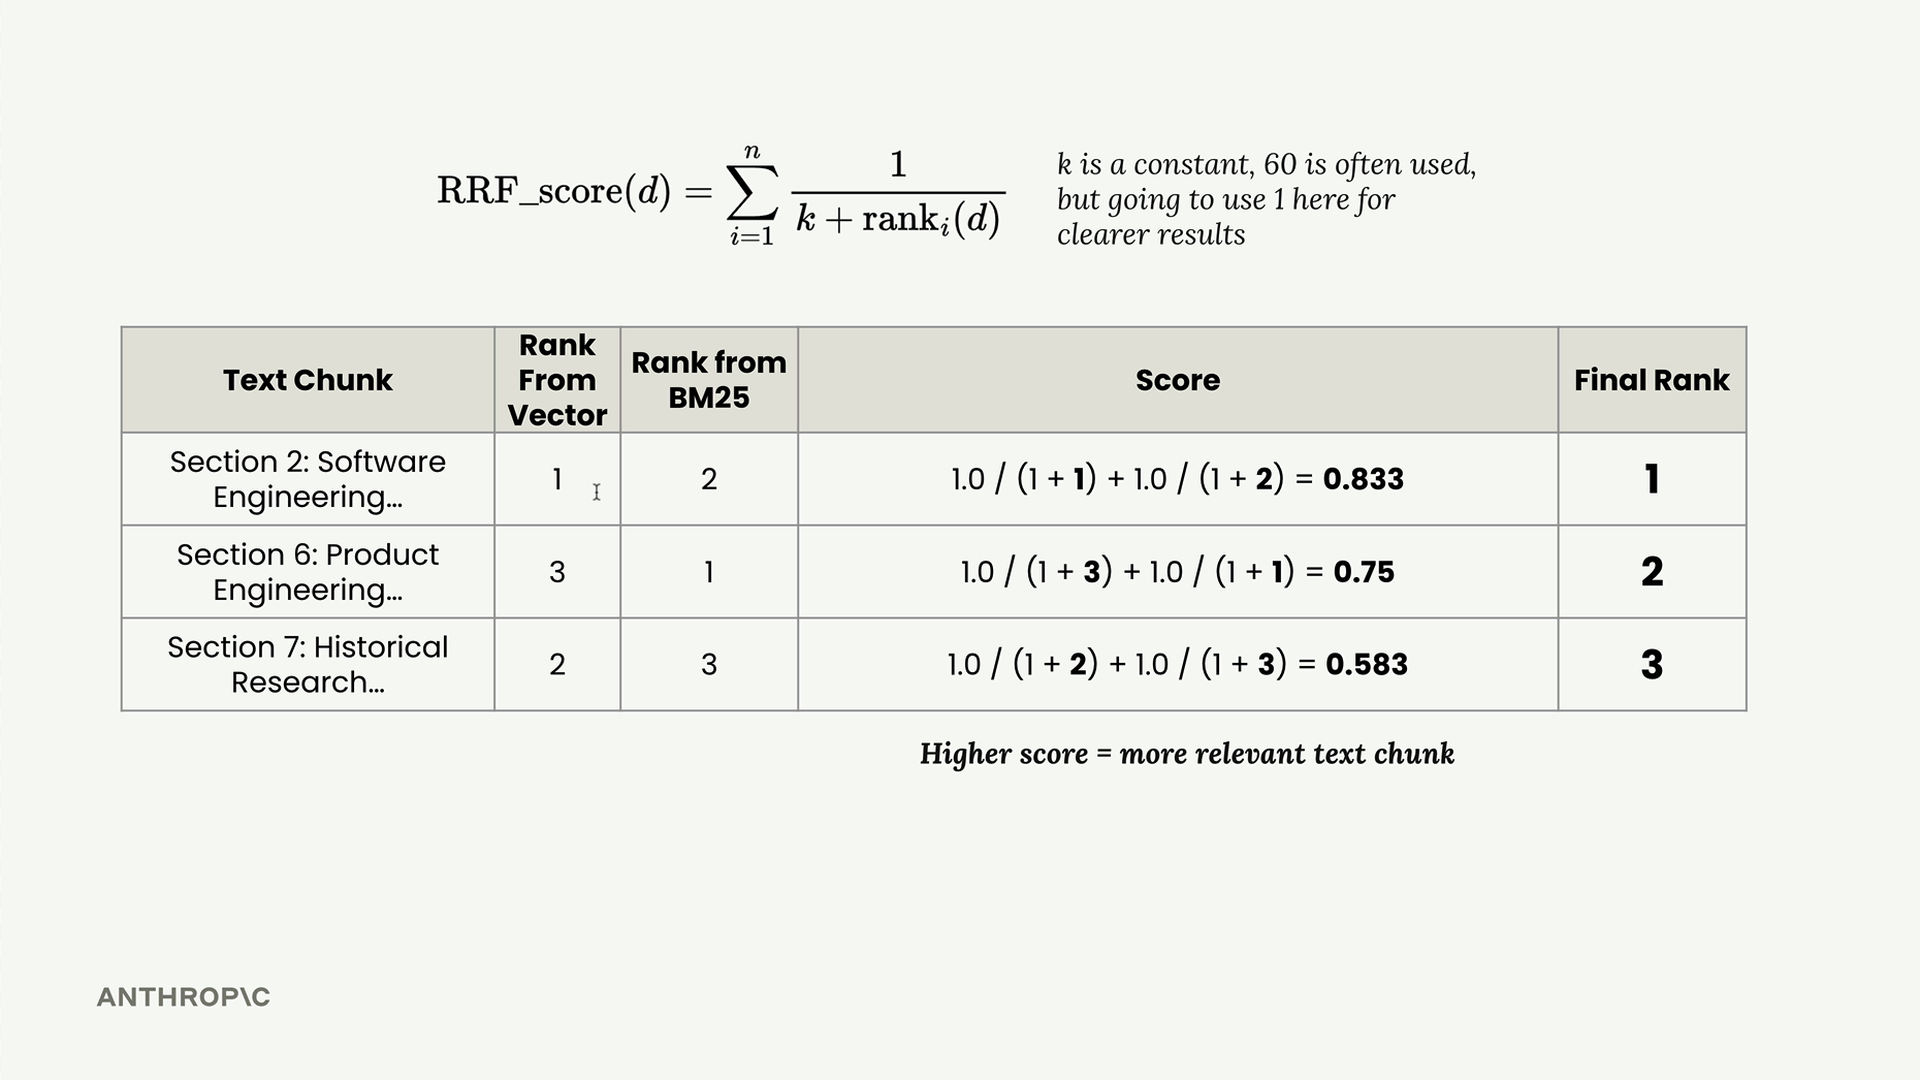
El ranking final queda así: Sección 2 (0.833), Sección 6 (0.75), Sección 7 (0.583). Esto tiene sentido intuitivo: la Sección 2 tuvo buen desempeño en ambas búsquedas, la Sección 6 tuvo resultados mixtos, y la Sección 7 quedó más abajo en general.
Implementación
La implementación de la clase Retriever es directa:
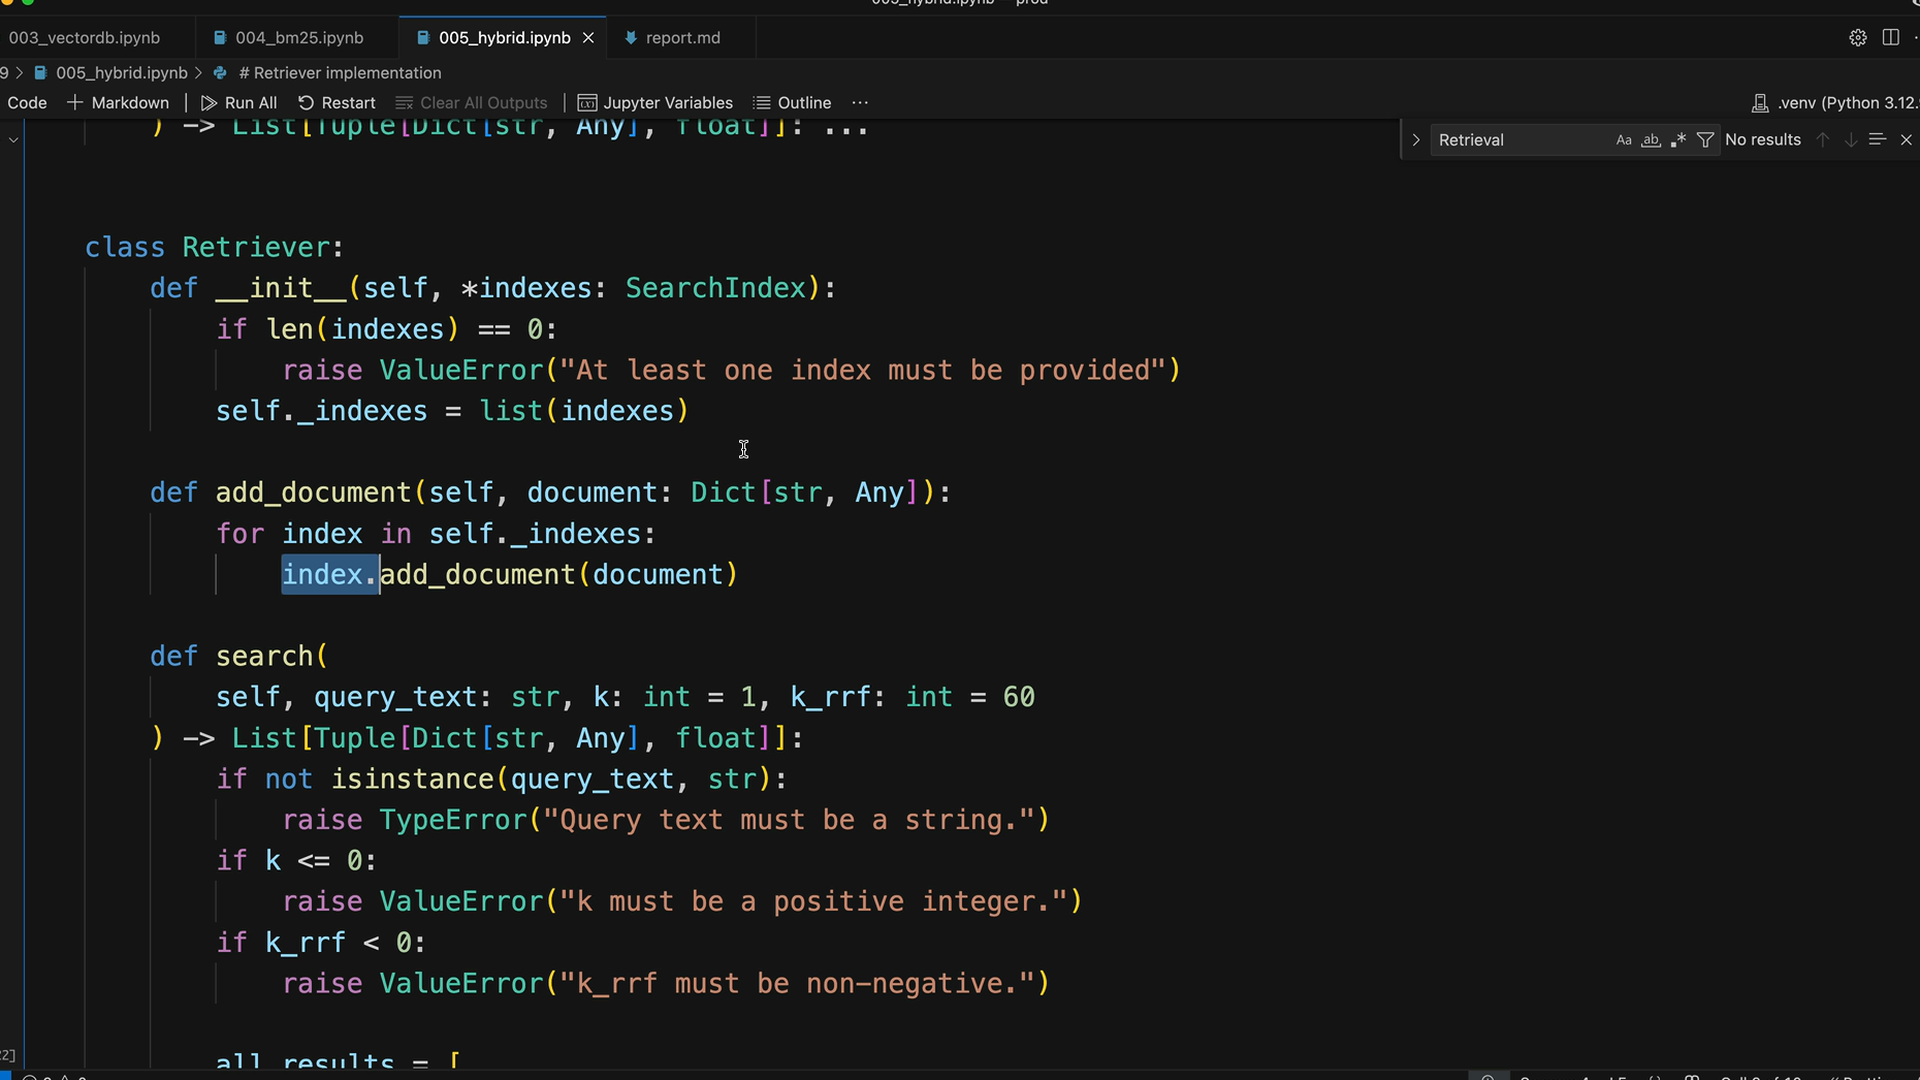
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # Obtener resultados de todos los índices
        all_results = [index.search(query_text, k) for index in self._indexes]

        # Aplicar fusión de rango recíproco
        # ... lógica de fusión aquí ...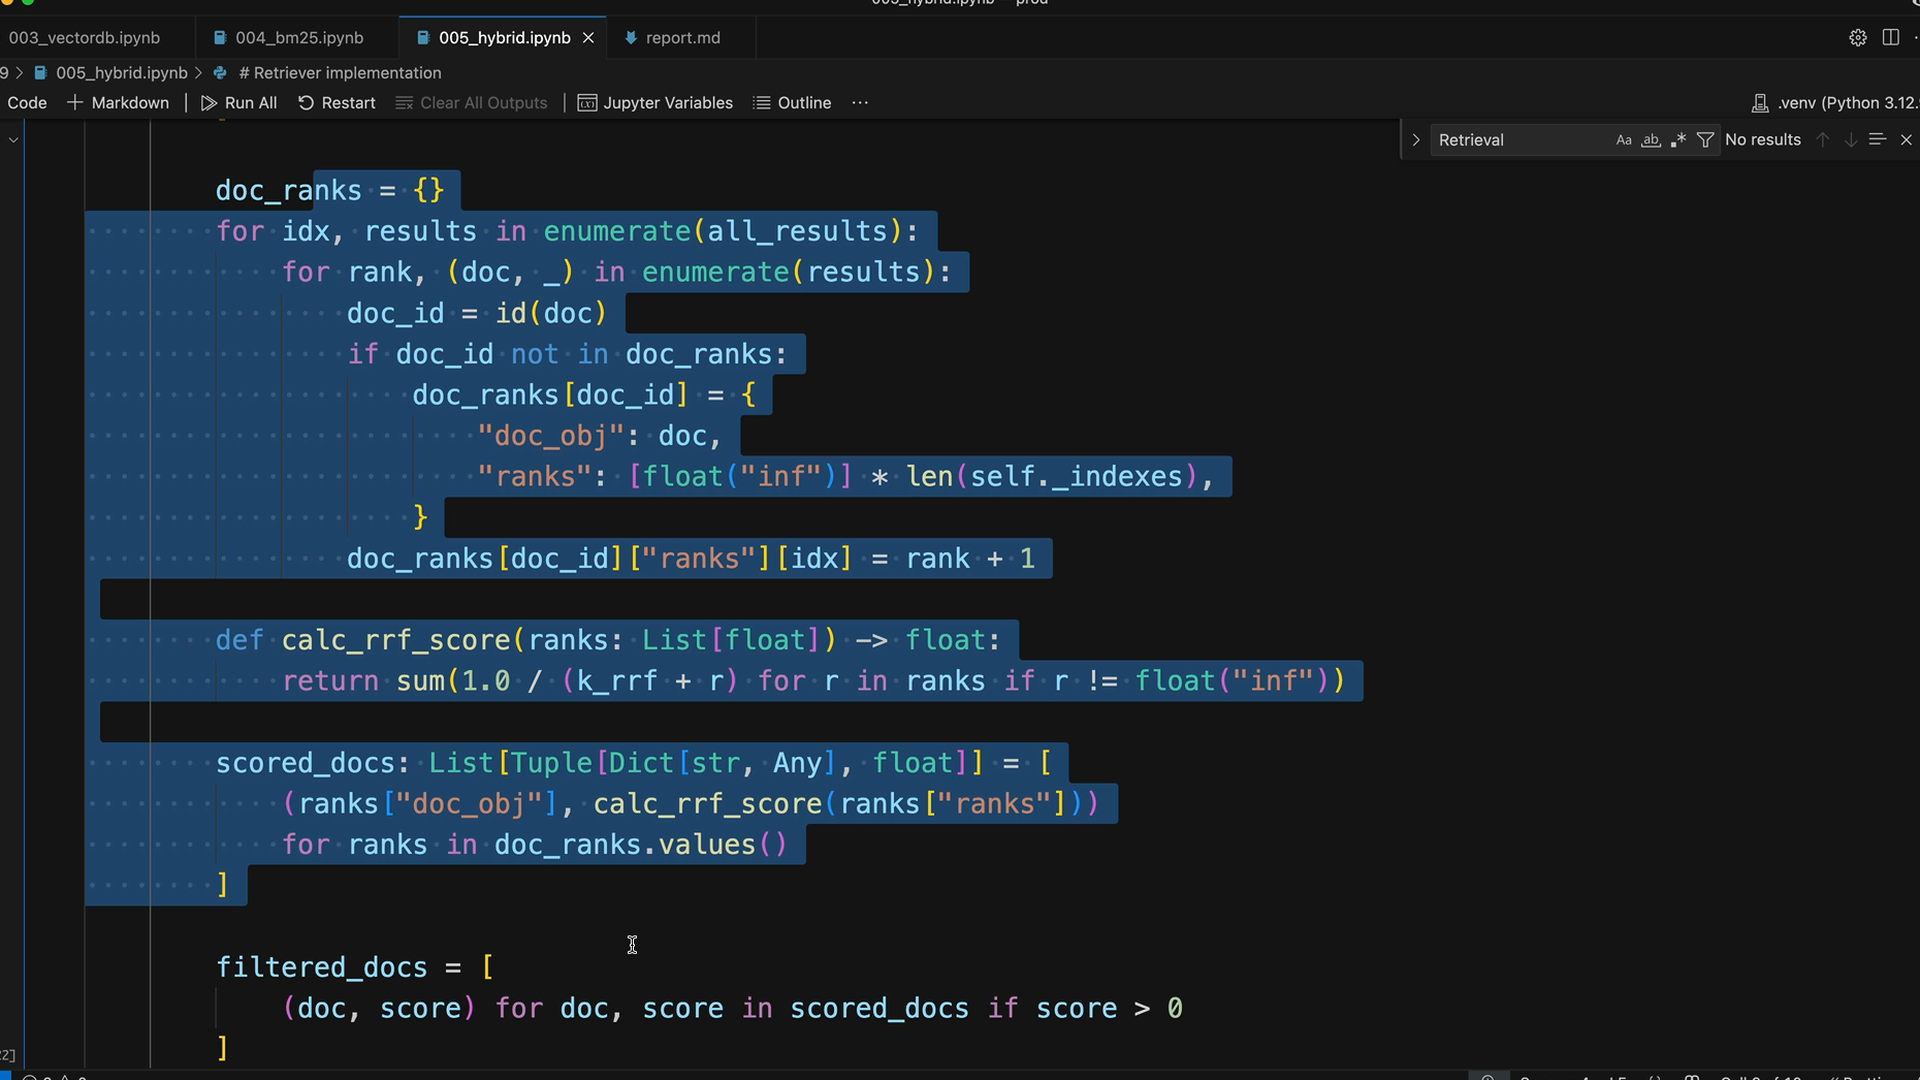
La lógica de fusión rastrea los rangos de los documentos en todos los resultados de búsqueda, calcula las puntuaciones RRF y devuelve los k mejores documentos ordenados por sus puntuaciones combinadas.
Prueba del enfoque híbrido
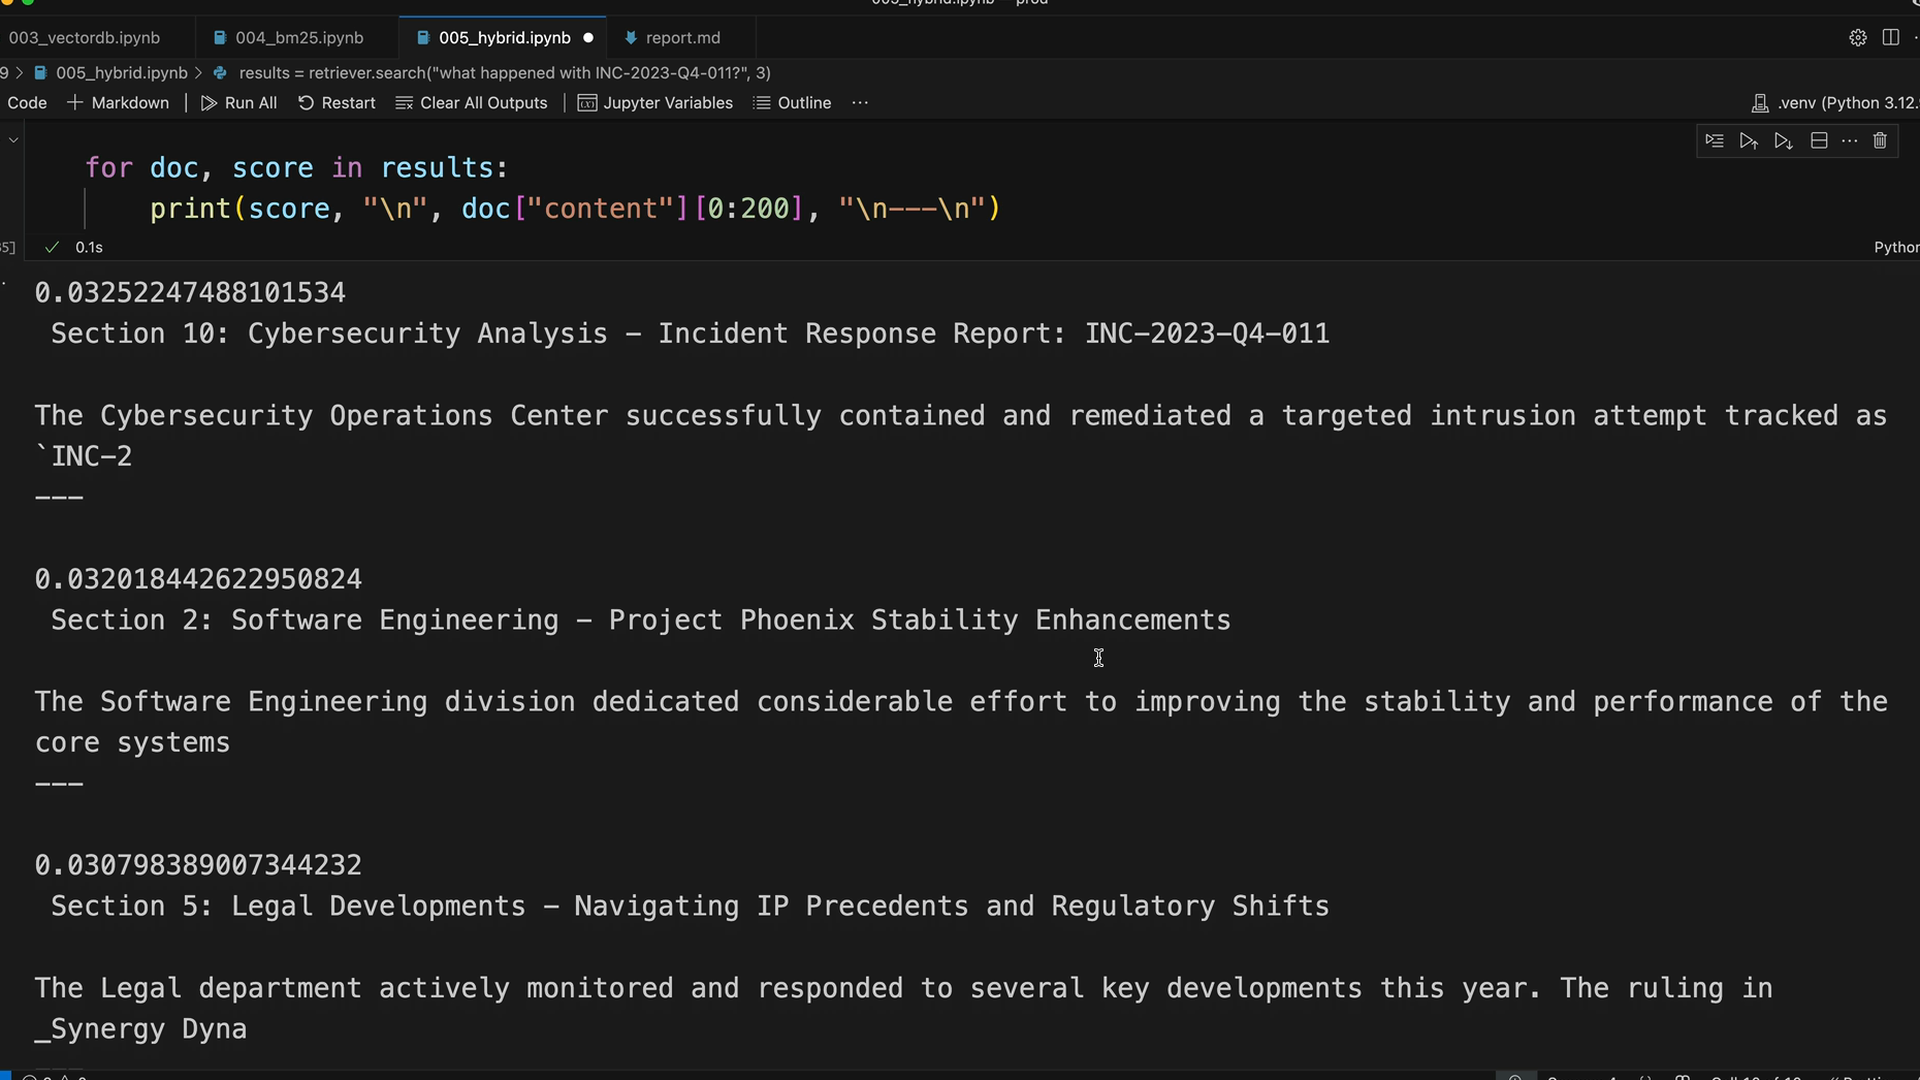
Al probar con la consulta "¿qué pasó con INC-2023-Q4-011?", el enfoque híbrido ofrece resultados mucho mejores que la búsqueda vectorial sola:
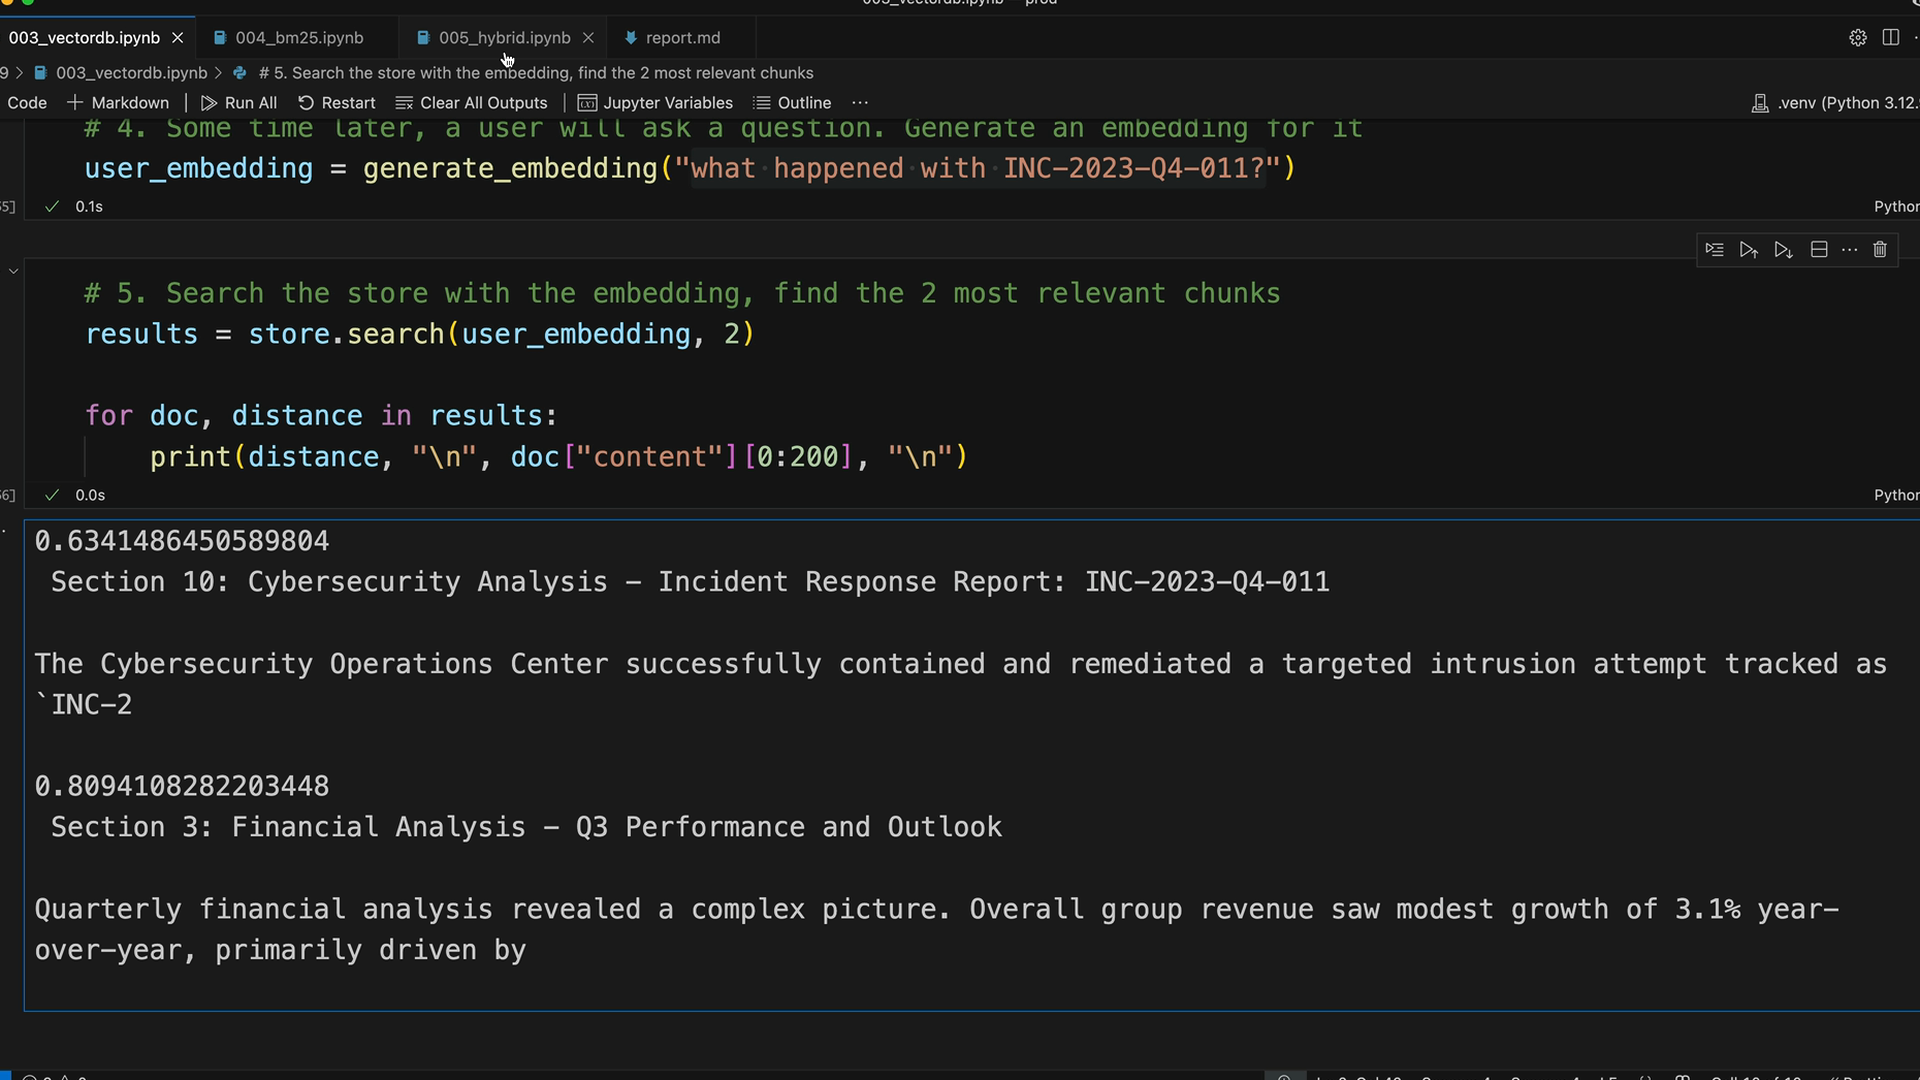
Los resultados ahora priorizan correctamente:
- Sección 10: Análisis de Ciberseguridad (el informe real del incidente)
- Sección 2: Ingeniería de Software (contexto relevante)
- Sección 5: Desarrollos Legales (menos relevante pero aún relacionado)
Beneficios de la arquitectura híbrida
Este diseño ofrece varias ventajas:
- Diseño modular: Cada índice de búsqueda se implementa de forma independiente con la misma API
- Fácil extensibilidad: Puedes agregar nuevos métodos de búsqueda implementando la misma interfaz
search()yadd_document() - Mejor precisión: Combina la comprensión semántica con la coincidencia exacta de palabras clave
- Fusión flexible: El algoritmo RRF funciona sin importar cuántos índices de búsqueda combines
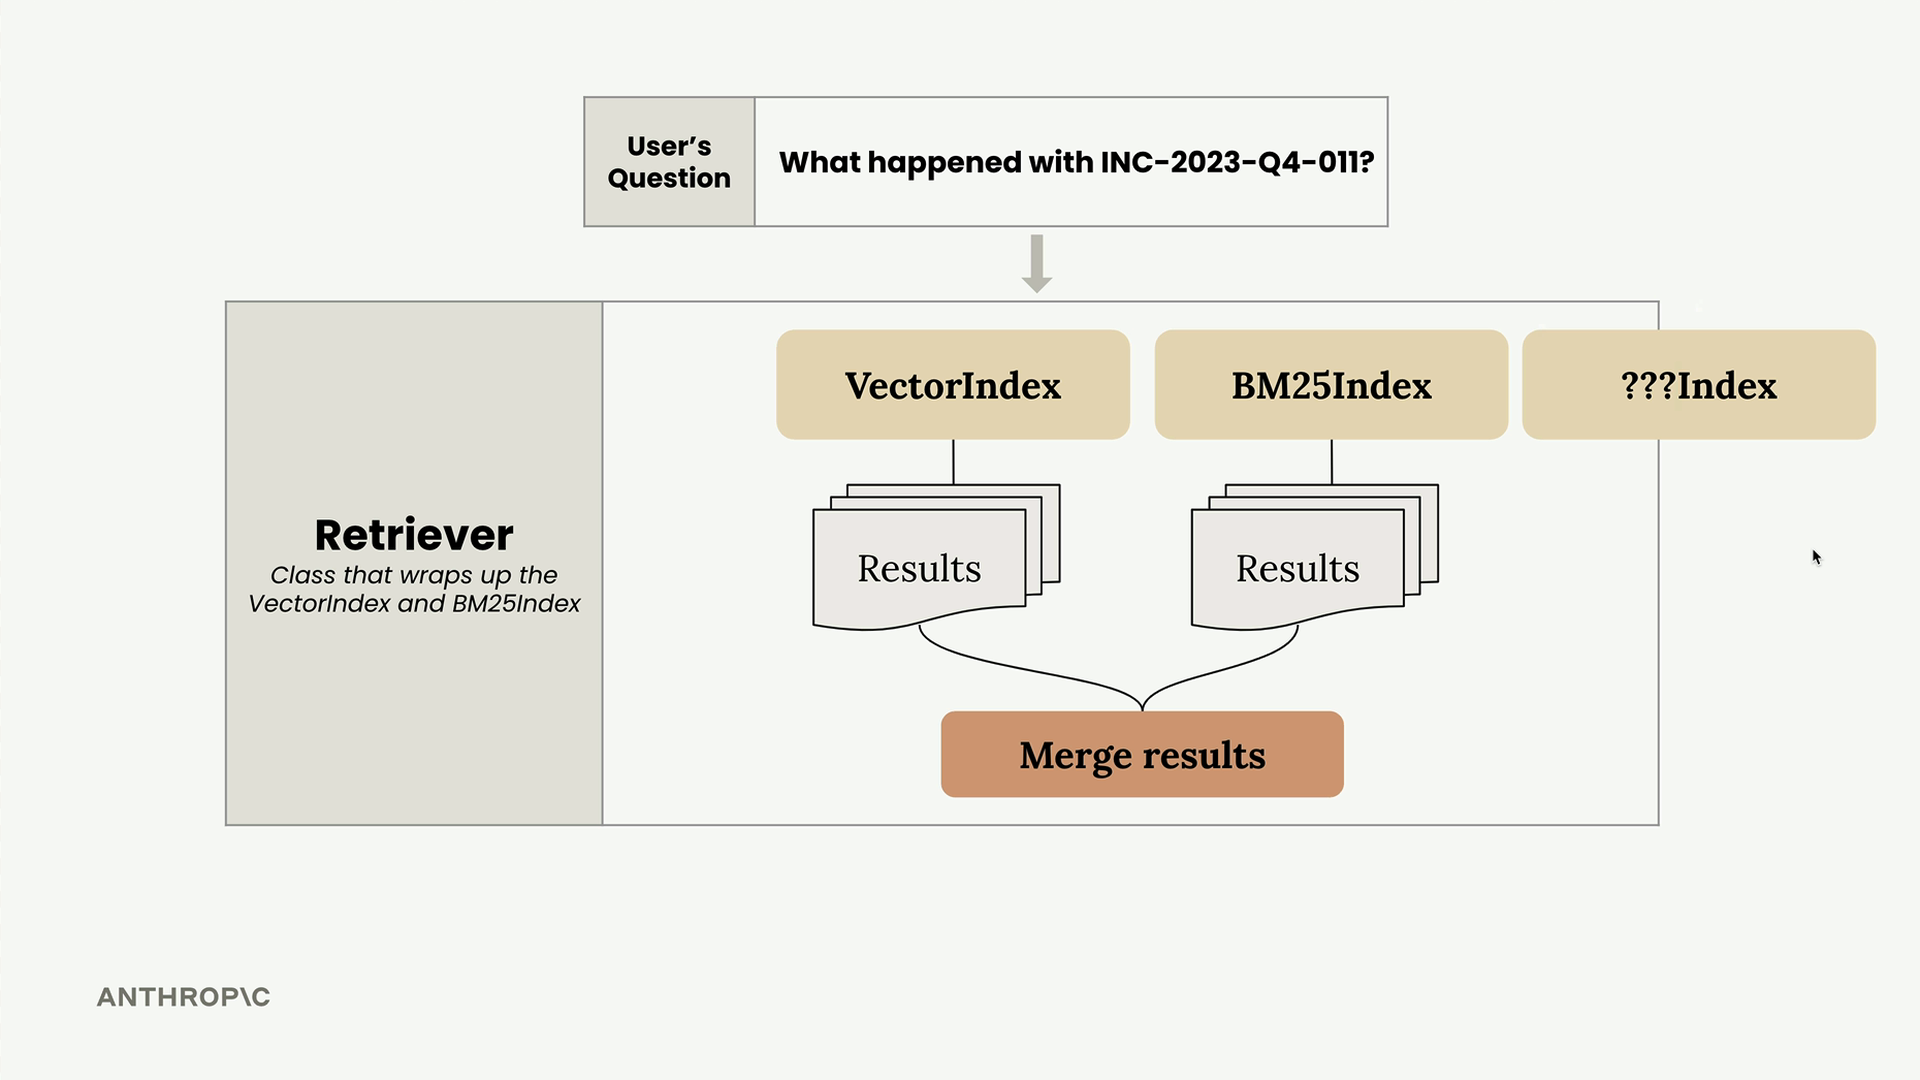
La API consistente significa que podrías agregar fácilmente un tercer índice de búsqueda, quizás uno que se especialice en reconocimiento de entidades nombradas o que maneje tipos específicos de documentos, y el Retriever incorporaría automáticamente sus resultados en el ranking final.
Esta base de búsqueda híbrida proporciona una recuperación significativamente más robusta que cualquiera de los dos métodos por sí solo, preparando tu pipeline de RAG para un mejor rendimiento en una gama más amplia de tipos de consultas.