El enfoque de recuperación híbrida que hemos construido funciona bien, pero aún tiene algunos aspectos por pulir. Cuando buscamos "¿qué hizo el equipo de ingeniería con INC-2023-Q4-011?", esperaríamos que la sección de Ingeniería de Software se clasificara más alto, ya que menciona específicamente al equipo de ingeniería y el incidente. Sin embargo, la sección de Ciberseguridad sigue apareciendo primero.
Aquí es donde entra en juego la reclasificación ("re-ranking"), una técnica de posprocesamiento que puede mejorar significativamente la precisión de la recuperación.
Cómo funciona la reclasificación
La reclasificación añade un paso adicional después de tu proceso de búsqueda híbrida. En lugar de simplemente devolver los resultados combinados de tus índices vectorial y BM25, pasas esos resultados a través de un LLM para una reordenación inteligente.
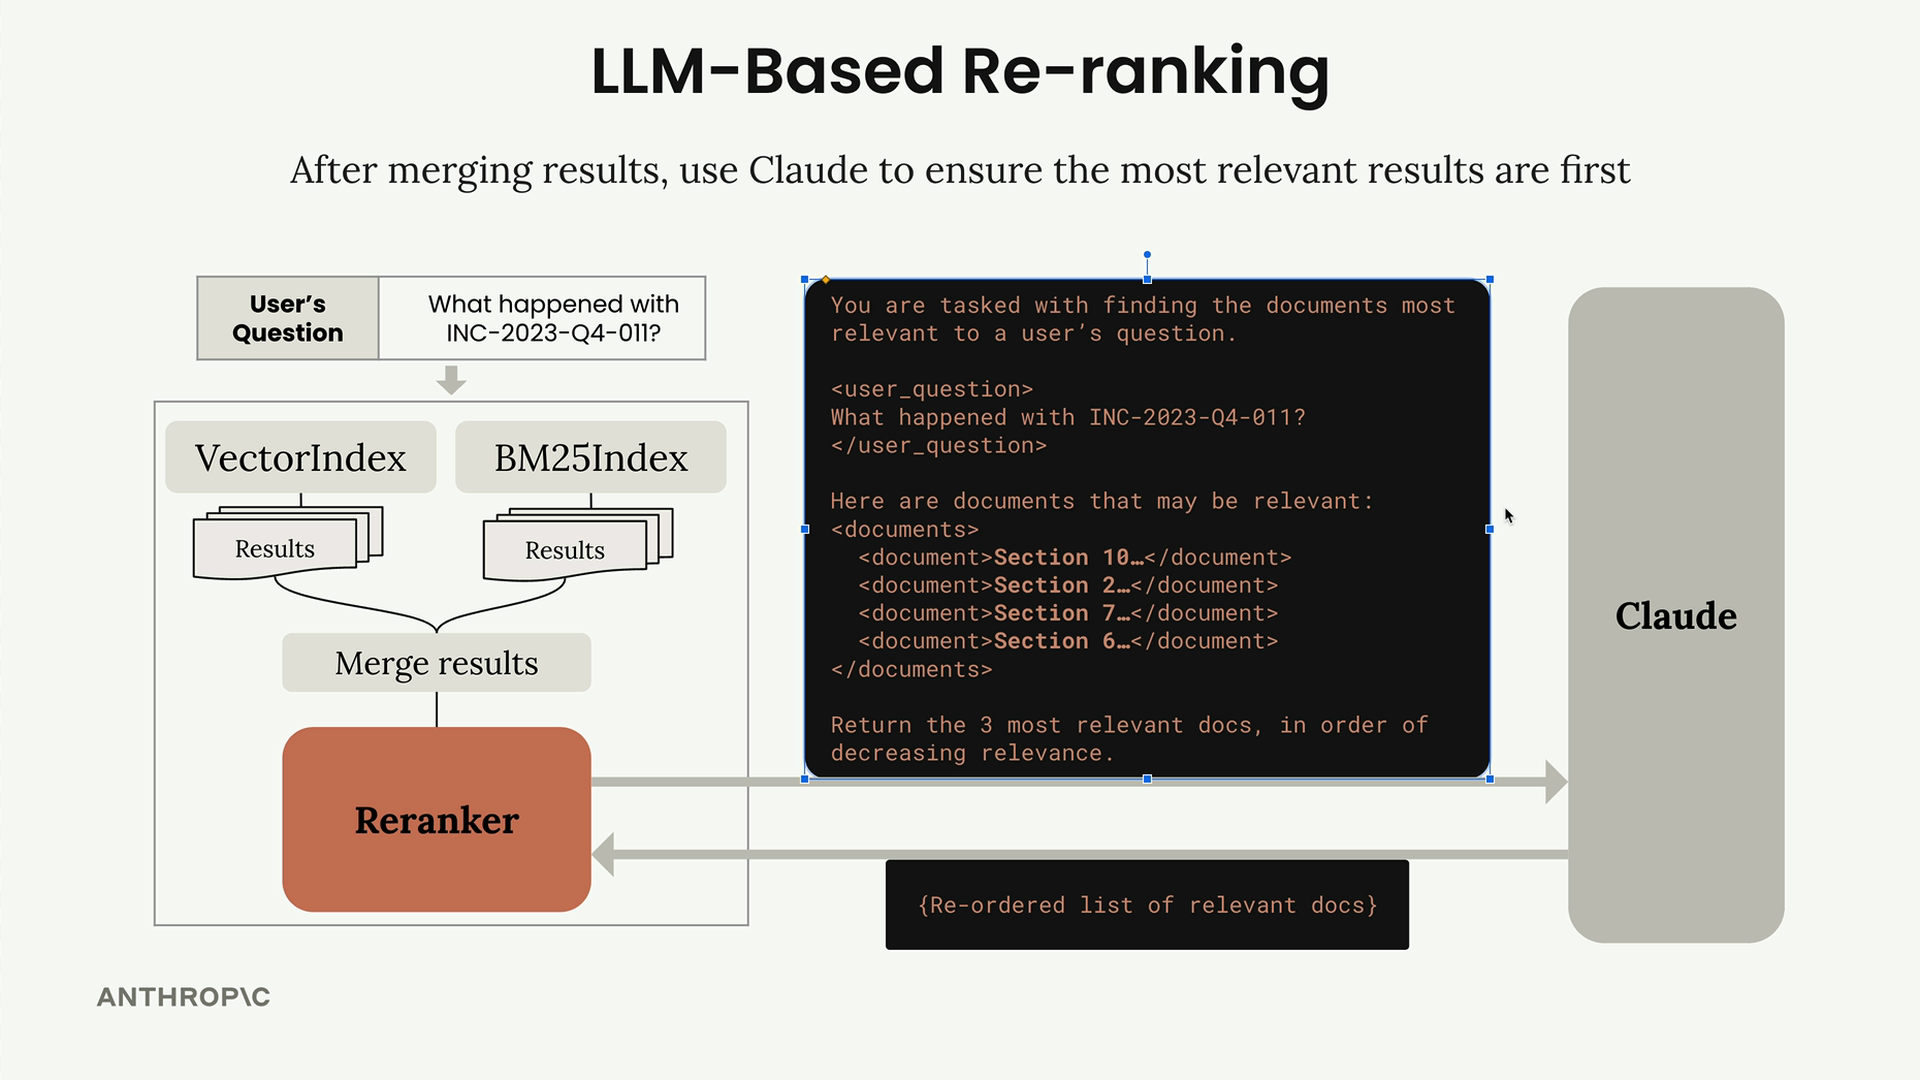
El proceso es sencillo:
- Ejecuta tu búsqueda híbrida existente (vectorial + BM25)
- Combina los resultados como antes
- Envía los resultados combinados a Claude con una indicación de reclasificación
- Recibe una lista reordenada de los documentos más relevantes
La indicación de reclasificación
La estructura de la indicación es simple pero eficaz. Le proporcionas a Claude la pregunta del usuario y todos los documentos candidatos, y luego le pides que devuelva los más relevantes en orden decreciente de relevancia.
You are about to be given a set of documents, along with an id of each.
Your task is to select the {k} most relevant documents to answer the user's question.

Here is the user's question:
<question>
{query_text}
</question>

Here are the documents to select from:
<documents>
{joined_docs}
</documents>

Respond in the following format:
```json
{
  "document_ids": str[] # List document ids, {k} elements long, sorted in order of decreasing relevance
}
```Consideraciones de eficiencia
Una optimización clave es usar IDs de documento en lugar de pedirle a Claude que devuelva fragmentos de texto completos. Si le pidieras a Claude que devolviera el texto completo de cada documento relevante, perderías tiempo esperando a que copie grandes cantidades de texto.
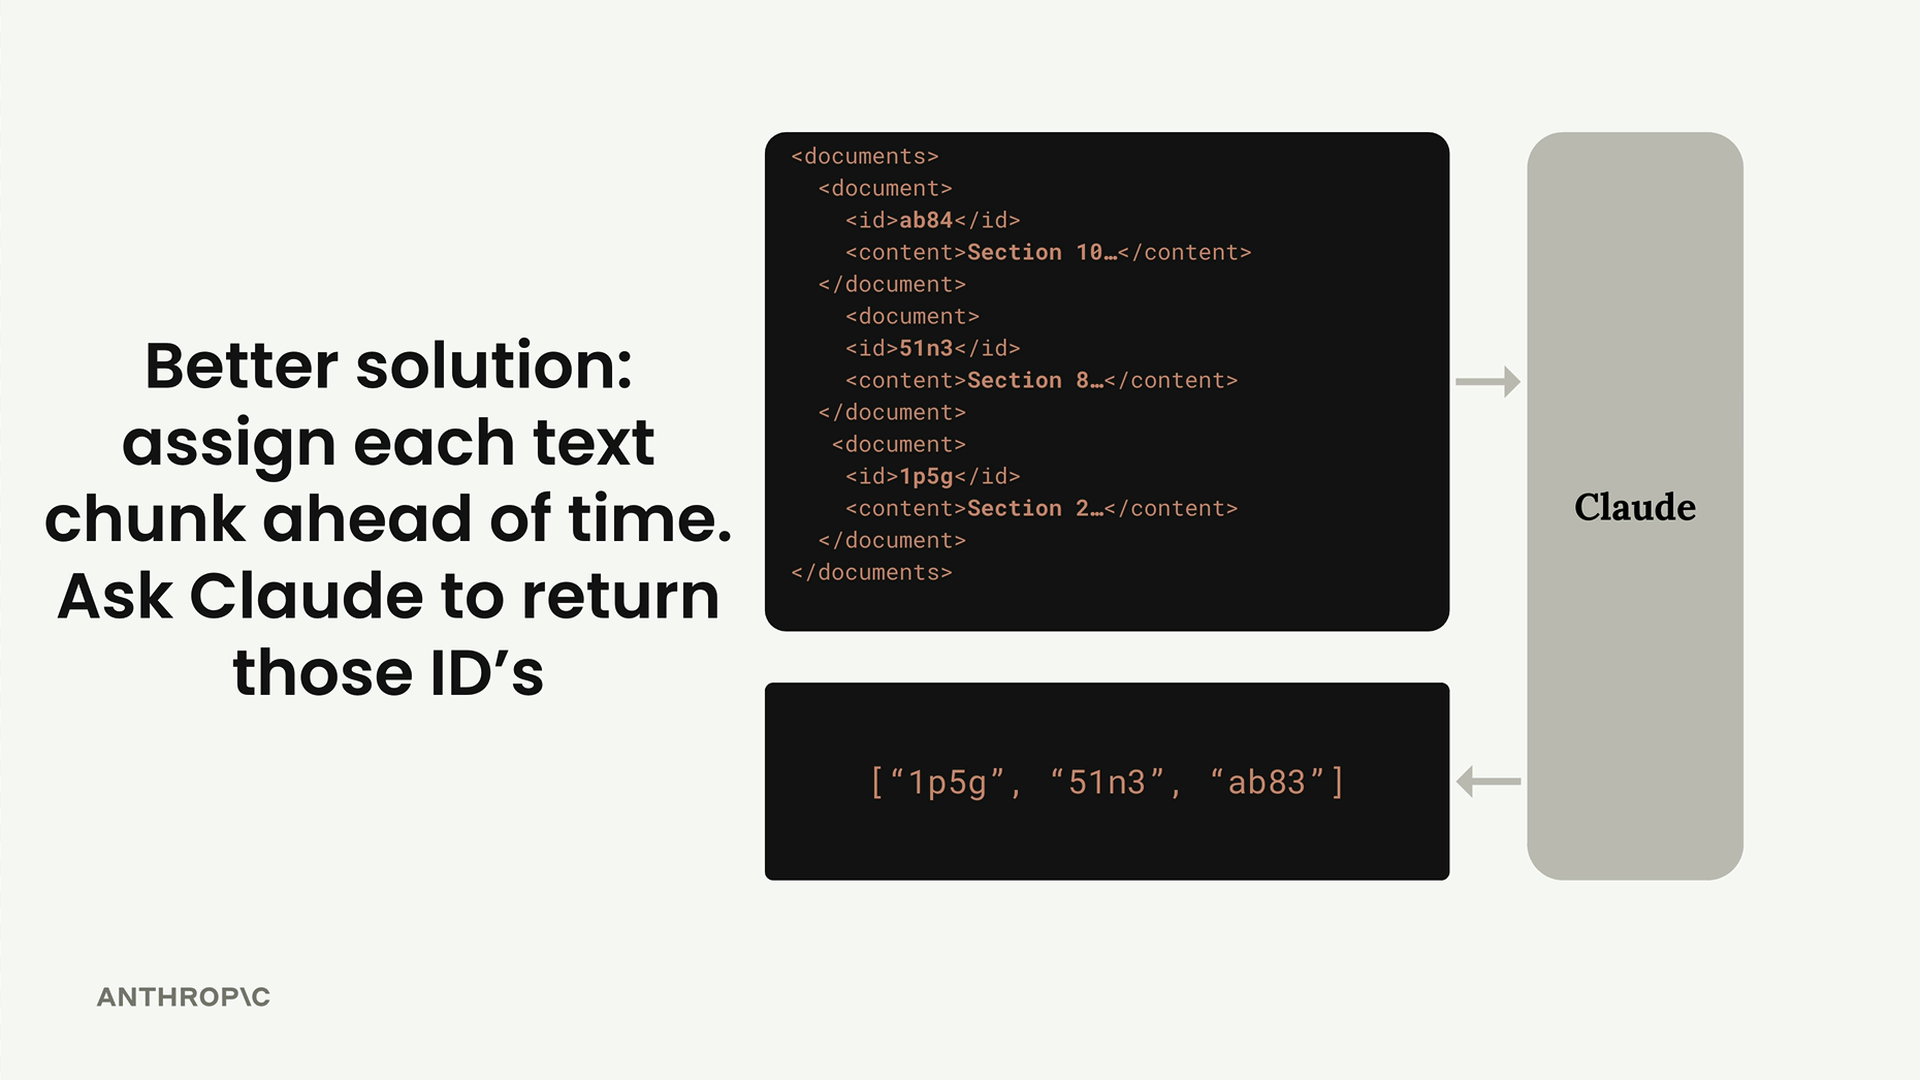
En su lugar, asigna a cada fragmento de texto un ID único de antemano, y luego pídele a Claude que devuelva solo esos IDs en el orden preferido. Esto hace que el proceso de reclasificación sea mucho más rápido, sin dejar de ofrecerte los resultados reordenados que necesitas.
Implementación
La función de reclasificación se llama automáticamente después de que se completa tu búsqueda híbrida inicial. Esta es la estructura básica:
def reranker_fn(docs, query_text, k):
    joined_docs = "\n".join([
        f"""
        <document>
        <document_id>{doc["id"]}</document_id>
        <document_content>{doc["content"]}</document_content>
        </document>
        """
        for doc in docs
    ])

    # Construir prompt con la pregunta del usuario y los documentos
    # Enviar a Claude con formato de respuesta JSON
    # Analizar y devolver los IDs de documentos reordenados
Puedes integrar esto en tu recuperador pasando la función de reclasificación como parámetro:
retriever = Retriever(bm25_index, vector_index, reranker_fn=reranker_fn)Resultados
El enfoque de reclasificación muestra mejoras claras. Al probar la consulta "¿qué hizo el equipo de ingeniería con INC-2023-Q4-011?", la sección de Ingeniería de Software ahora aparece correctamente en primer lugar, por delante de la sección de Ciberseguridad. Claude identificó con éxito que el usuario preguntaba específicamente sobre la participación del equipo de ingeniería en el incidente.
Compensaciones
La reclasificación conlleva compensaciones a considerar:
- Mayor latencia: ahora necesitas esperar a que se complete una llamada adicional al LLM
- Mayor precisión: el LLM puede entender el contexto y la intención mejor que las puntuaciones de similitud puras
- Consideraciones de costo: cada búsqueda ahora requiere una llamada a la API del LLM
Para muchas aplicaciones, la mejora en precisión justifica la latencia y el costo adicionales, especialmente cuando la recuperación precisa es fundamental para tu caso de uso.