Al crear aplicaciones con Claude, comprender el ciclo de vida completo de la solicitud te ayuda a diseñar mejores sistemas y a depurar problemas de manera más efectiva. Repasemos qué sucede cuando un usuario envía un mensaje a tu aplicación de chat impulsada por IA.
El flujo completo de la solicitud
El trayecto desde la entrada del usuario hasta la respuesta de la IA implica cinco pasos distintos: Solicitud al Servidor, Solicitud a Vertex, Procesamiento del Modelo, Respuesta al Servidor y Respuesta al Cliente. Cada paso desempeña un papel crucial en la entrega de esa respuesta "mágica" que los usuarios esperan.
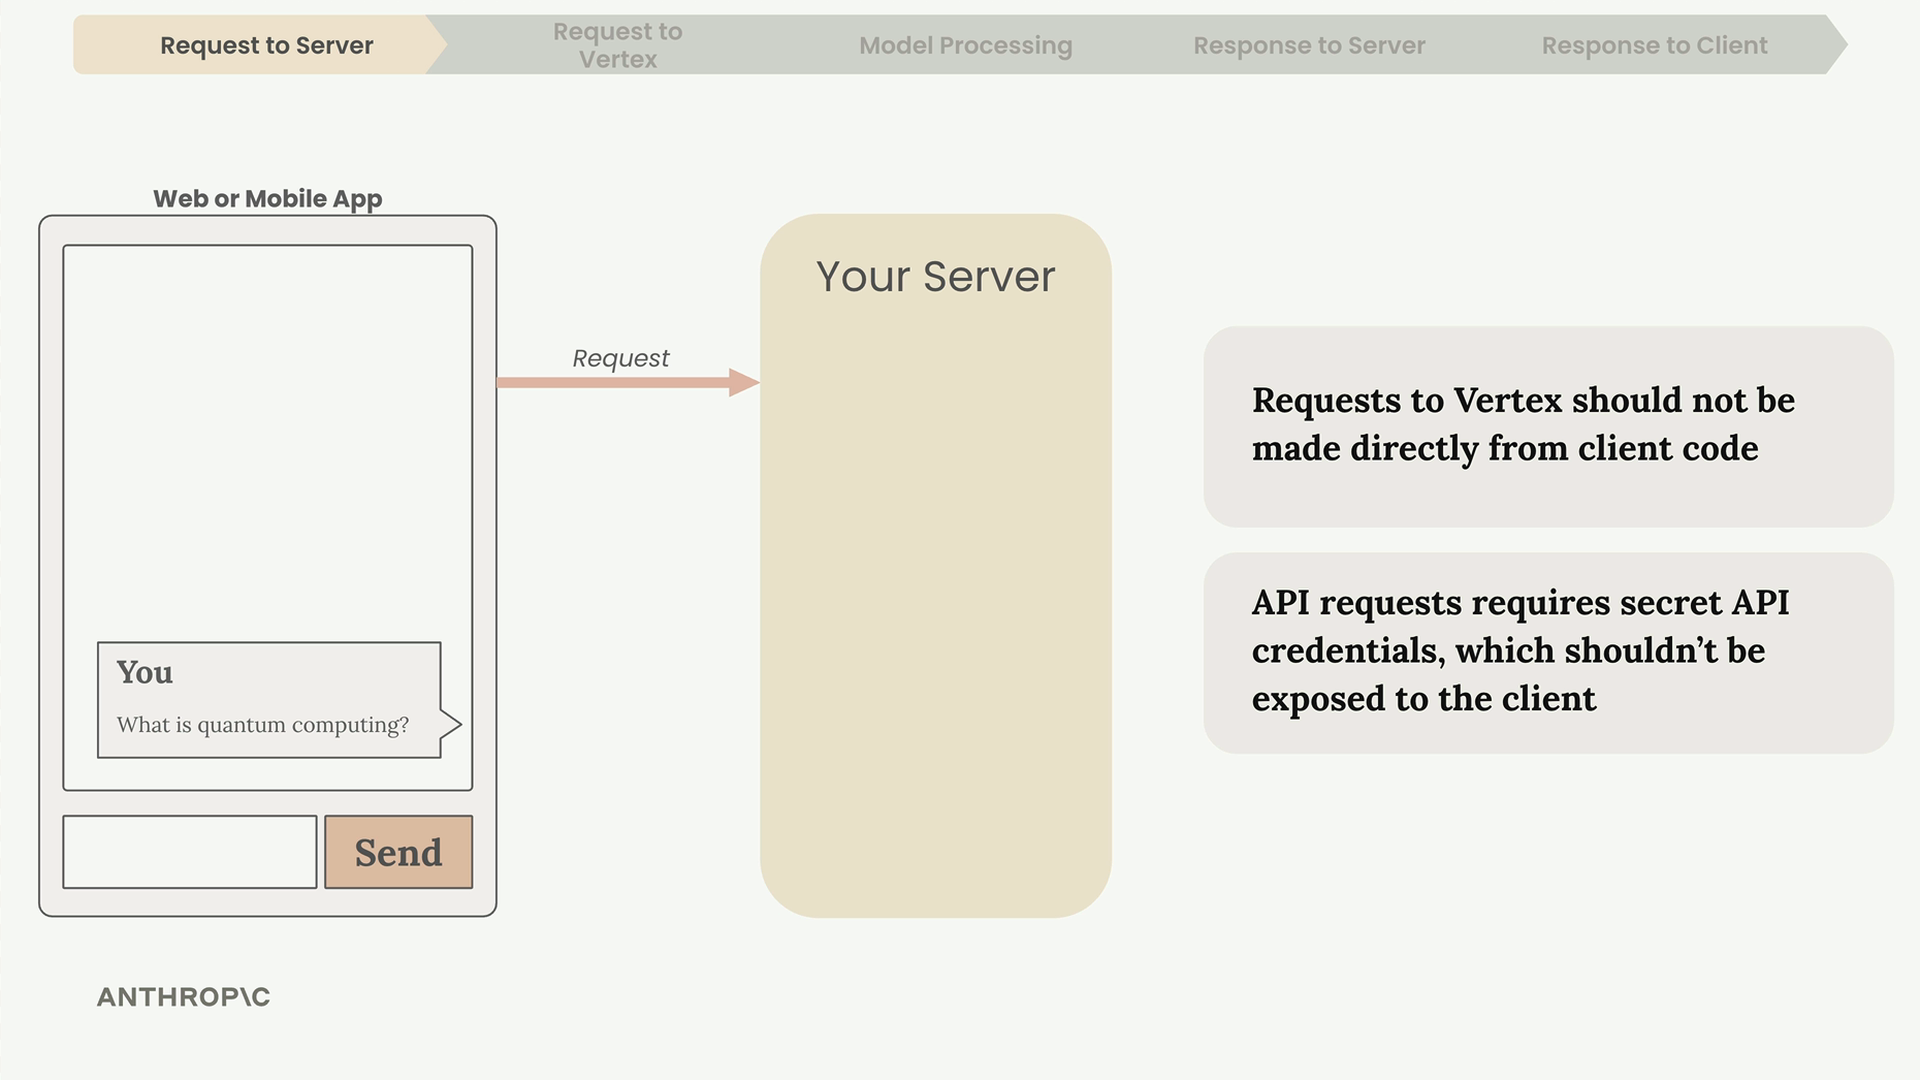
Por qué necesitas un servidor
Nunca hagas solicitudes a la API directamente desde código del lado del cliente. Aquí está el motivo:
- Las solicitudes a la API requieren credenciales secretas que deben mantenerse seguras
- Exponer credenciales en código de cliente las hace visibles para cualquiera
- Tu servidor actúa como un intermediario seguro entre tu aplicación y Vertex
Siempre enruta las solicitudes a través de tu propio servidor, que tú controlas y proteges.
Cómo hacer la solicitud a la API
Tu servidor se comunica con Vertex usando los SDKs de Anthropic o los SDKs oficiales de Vertex de Google. Anthropic ofrece SDKs oficiales para Python, TypeScript, Go y Ruby.
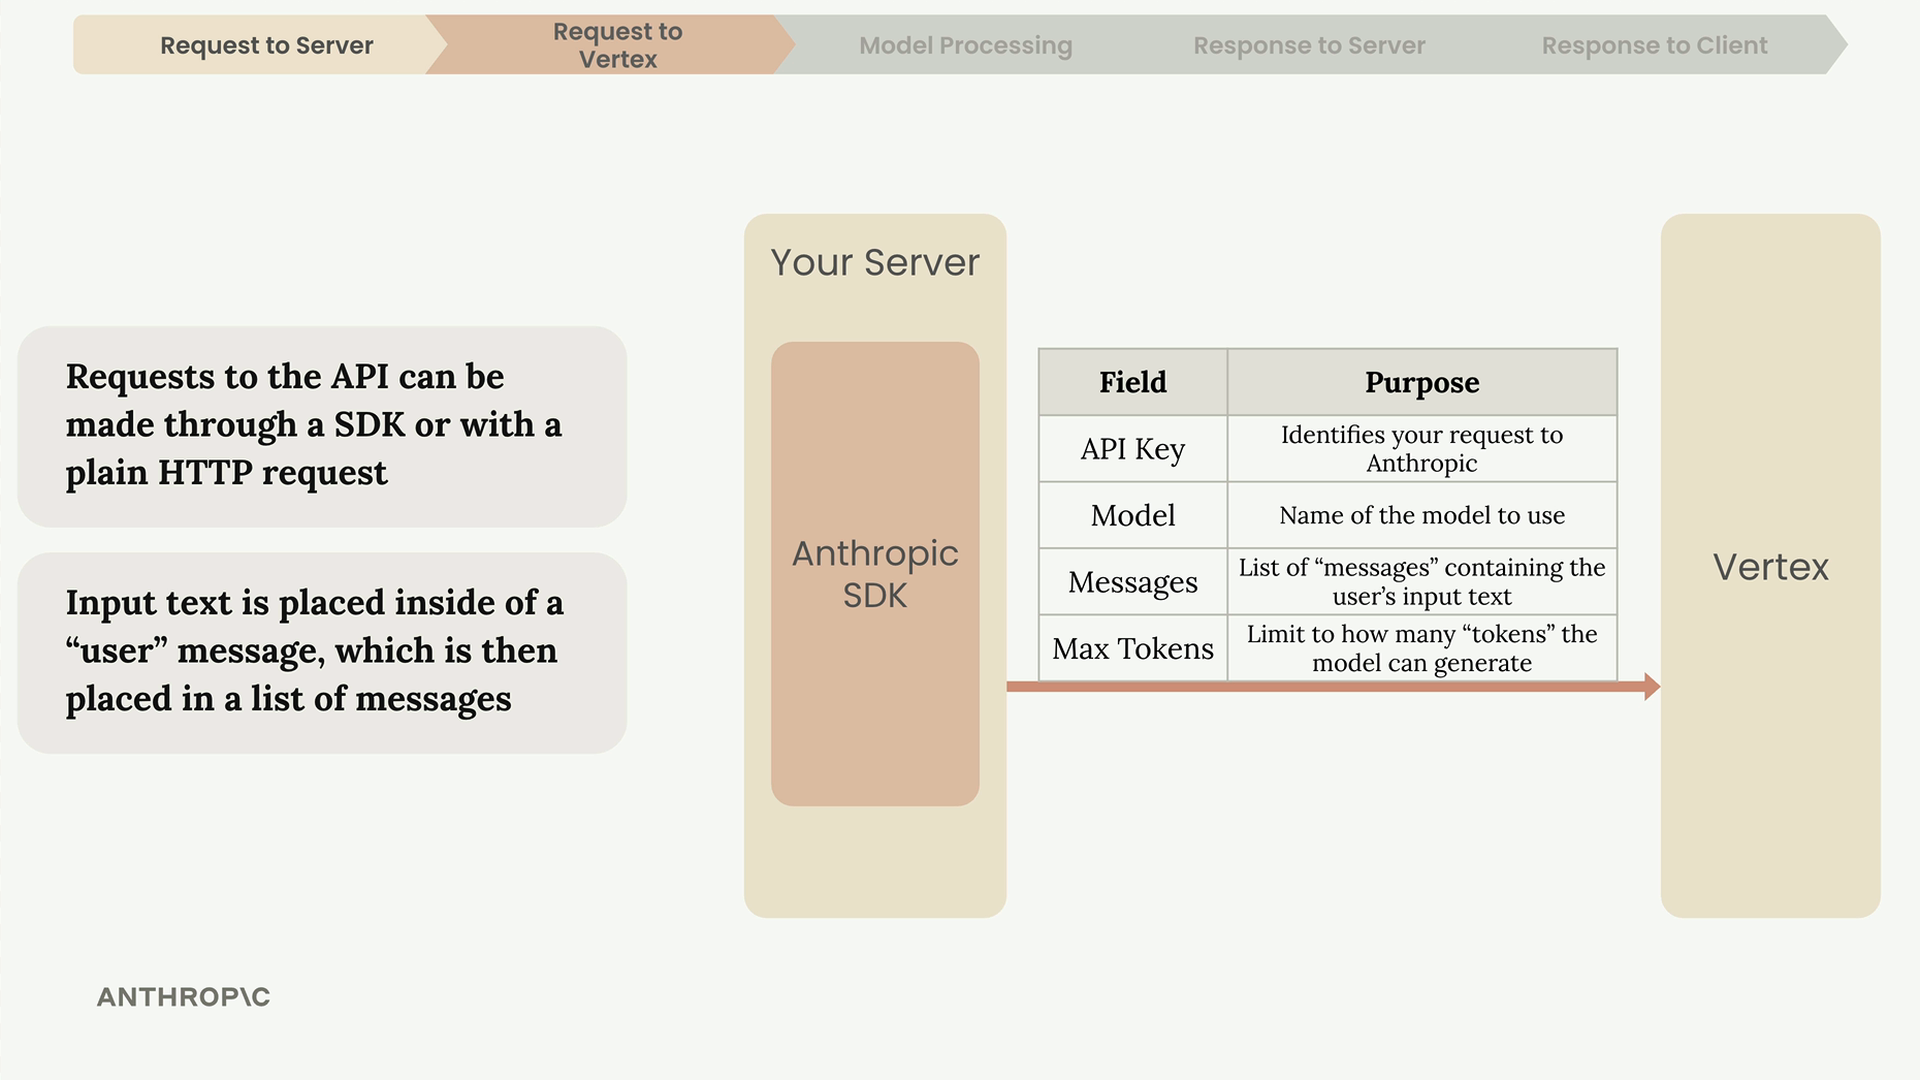
Toda solicitud debe incluir estos campos clave:
- Credenciales de Google Cloud: autoriza tu solicitud en Google Cloud
- Modelo: nombre del modelo específico a usar
- Mensajes: lista que contiene el texto de entrada del usuario
- Max Tokens: limita cuántos tokens puede generar el modelo
El texto de entrada del usuario se coloca dentro de un mensaje de "usuario", que luego se incluye en una lista de mensajes enviada a la API.
Dentro de Claude: proceso de generación de texto
Una vez que Vertex recibe tu solicitud, Claude la procesa a través de cuatro etapas: Tokenización, Embedding, Contextualización y Generación.
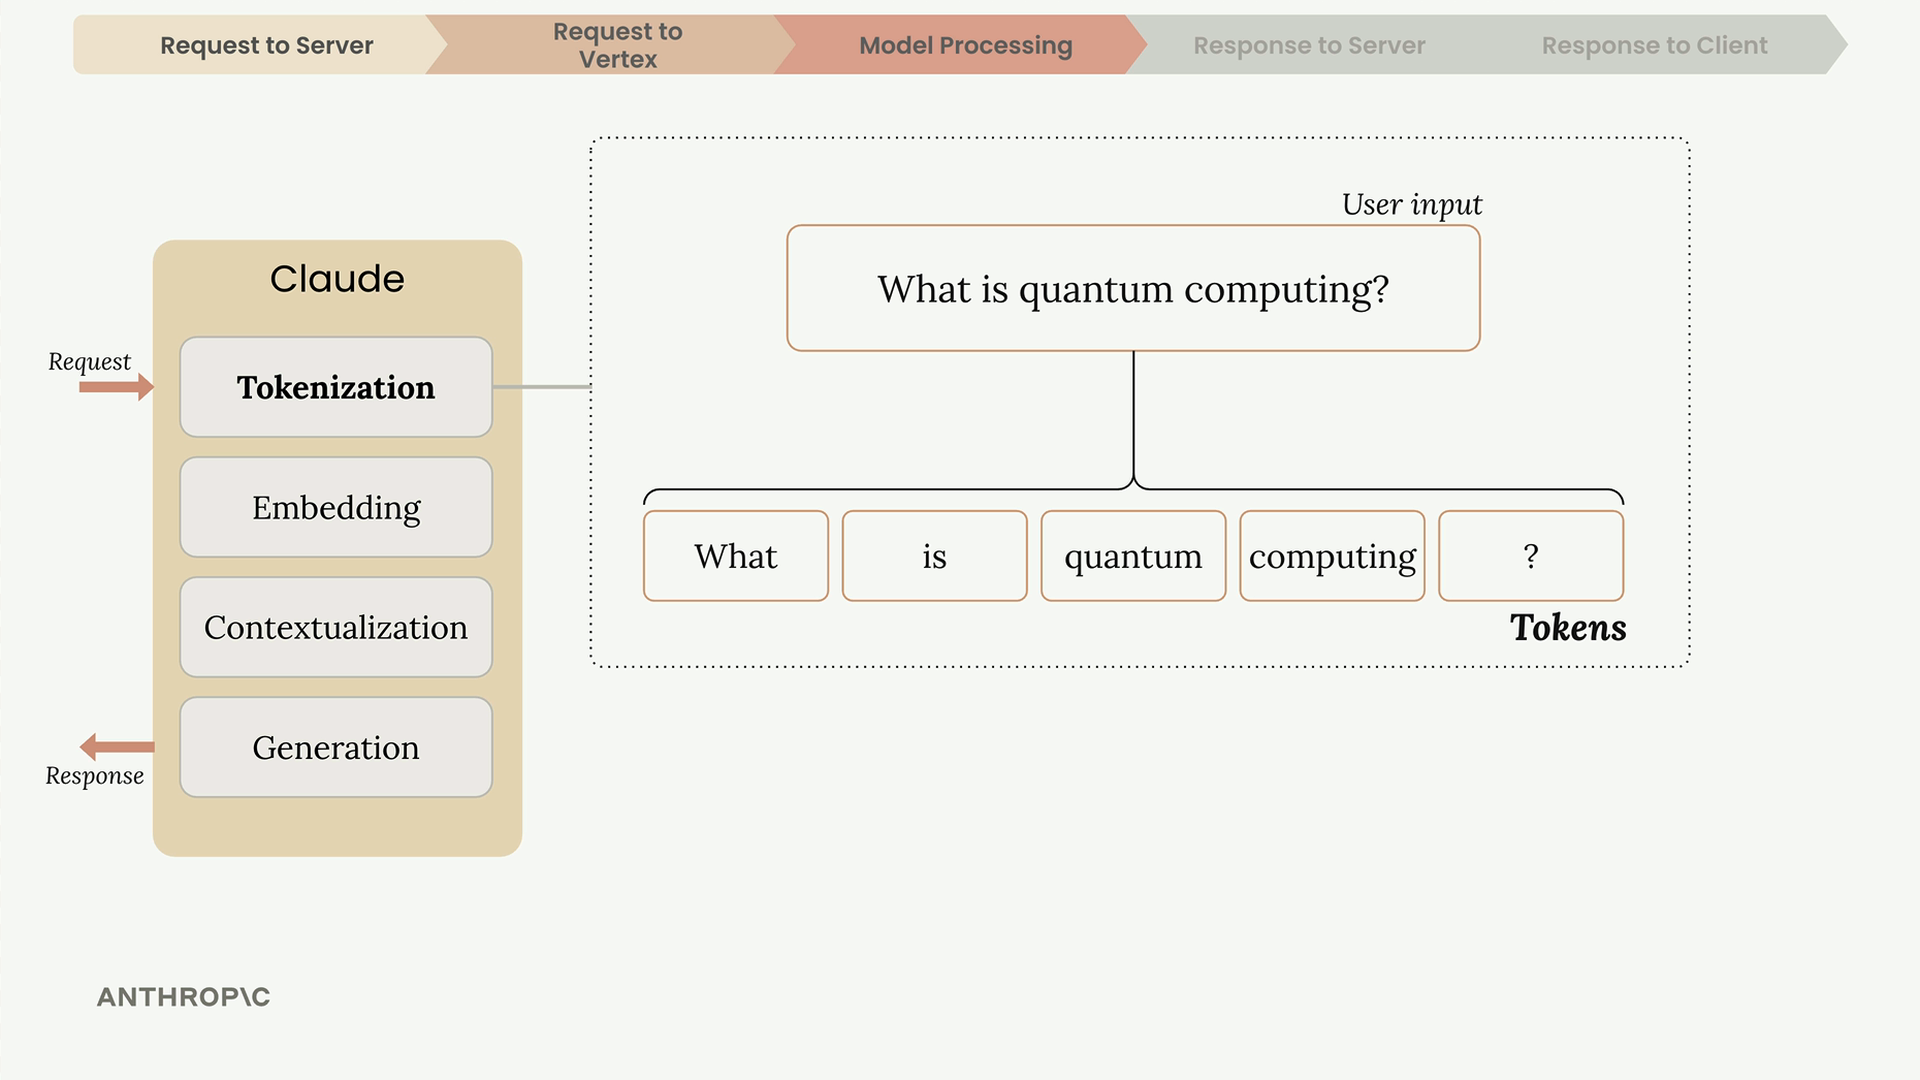
Tokenización
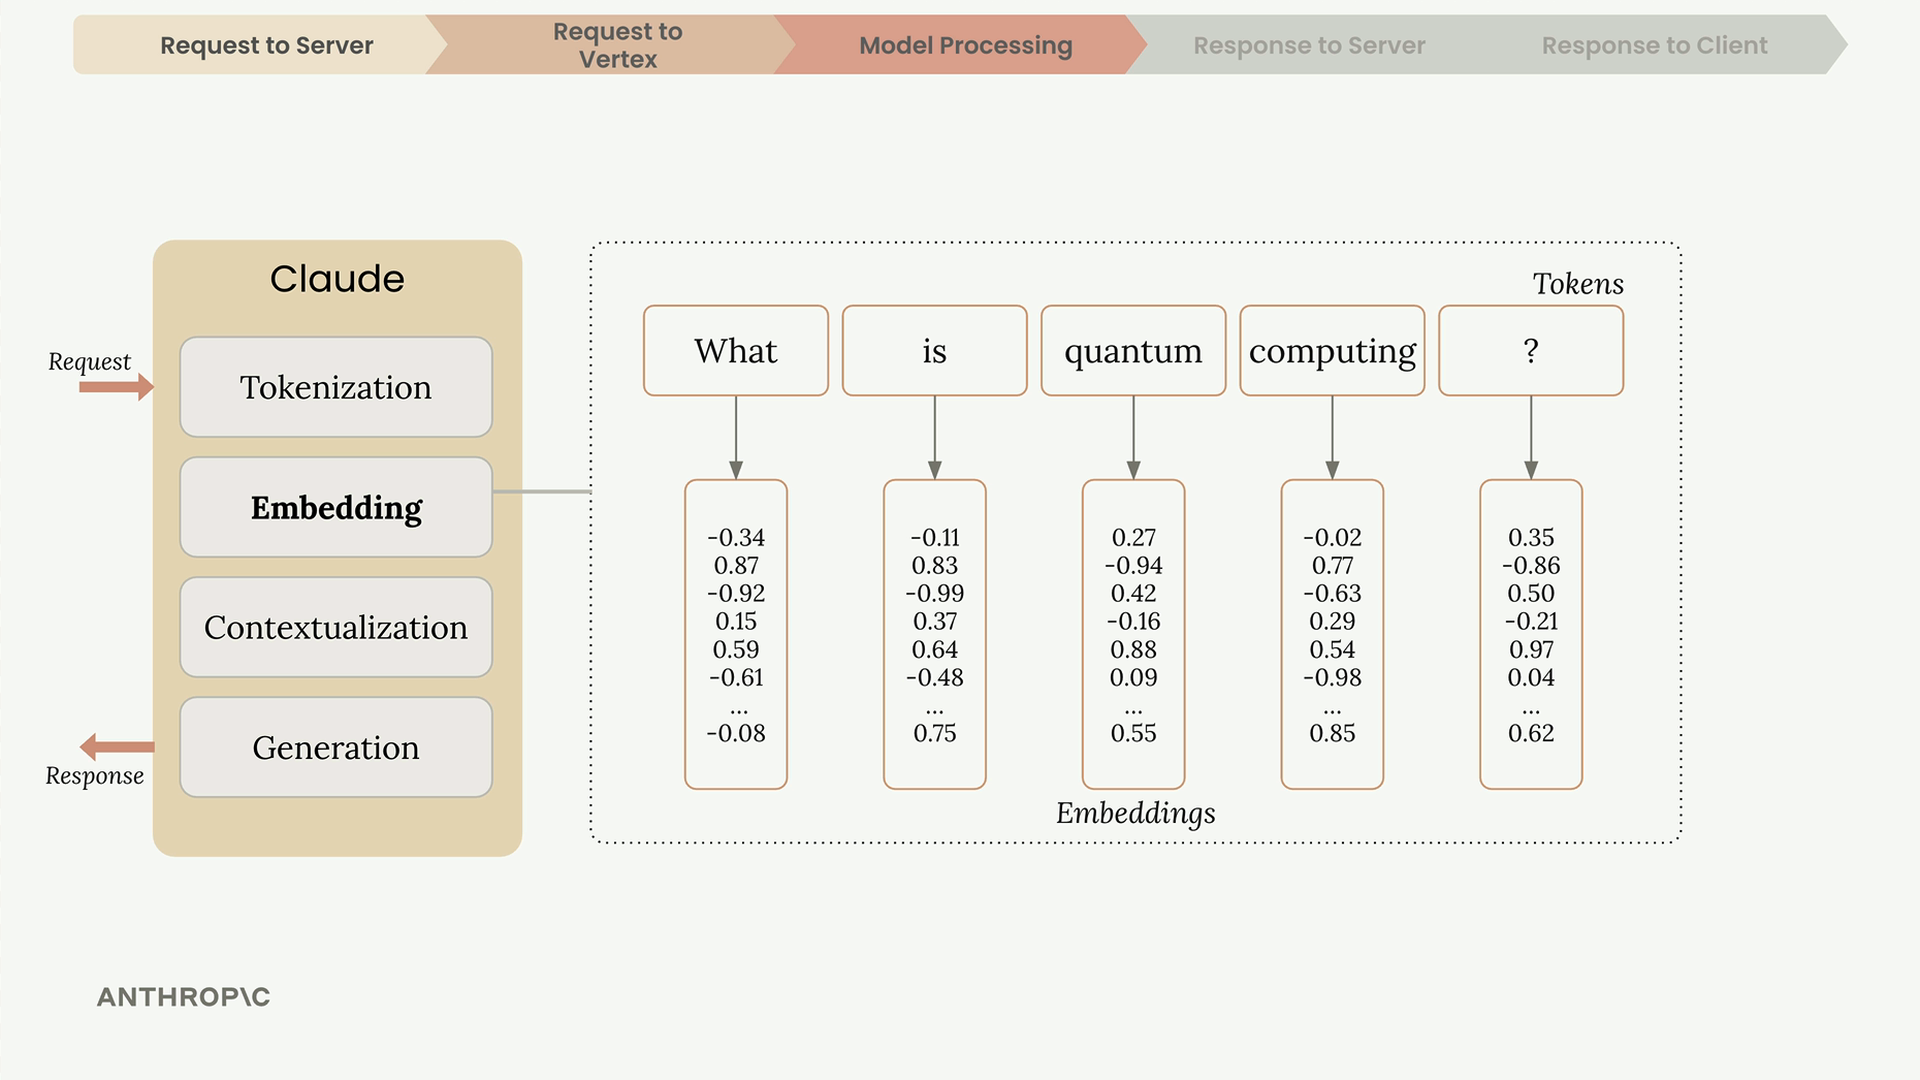
Claude primero descompone el texto de entrada en fragmentos más pequeños llamados tokens. Estos pueden ser palabras completas, partes de palabras, espacios o símbolos. Para simplificar, piensa en cada palabra como un token.
Embedding
Cada token se convierte en un embedding, una larga lista de números que representa todos los posibles significados de esa palabra. Piensa en los embeddings como definiciones basadas en números.
Contextualización
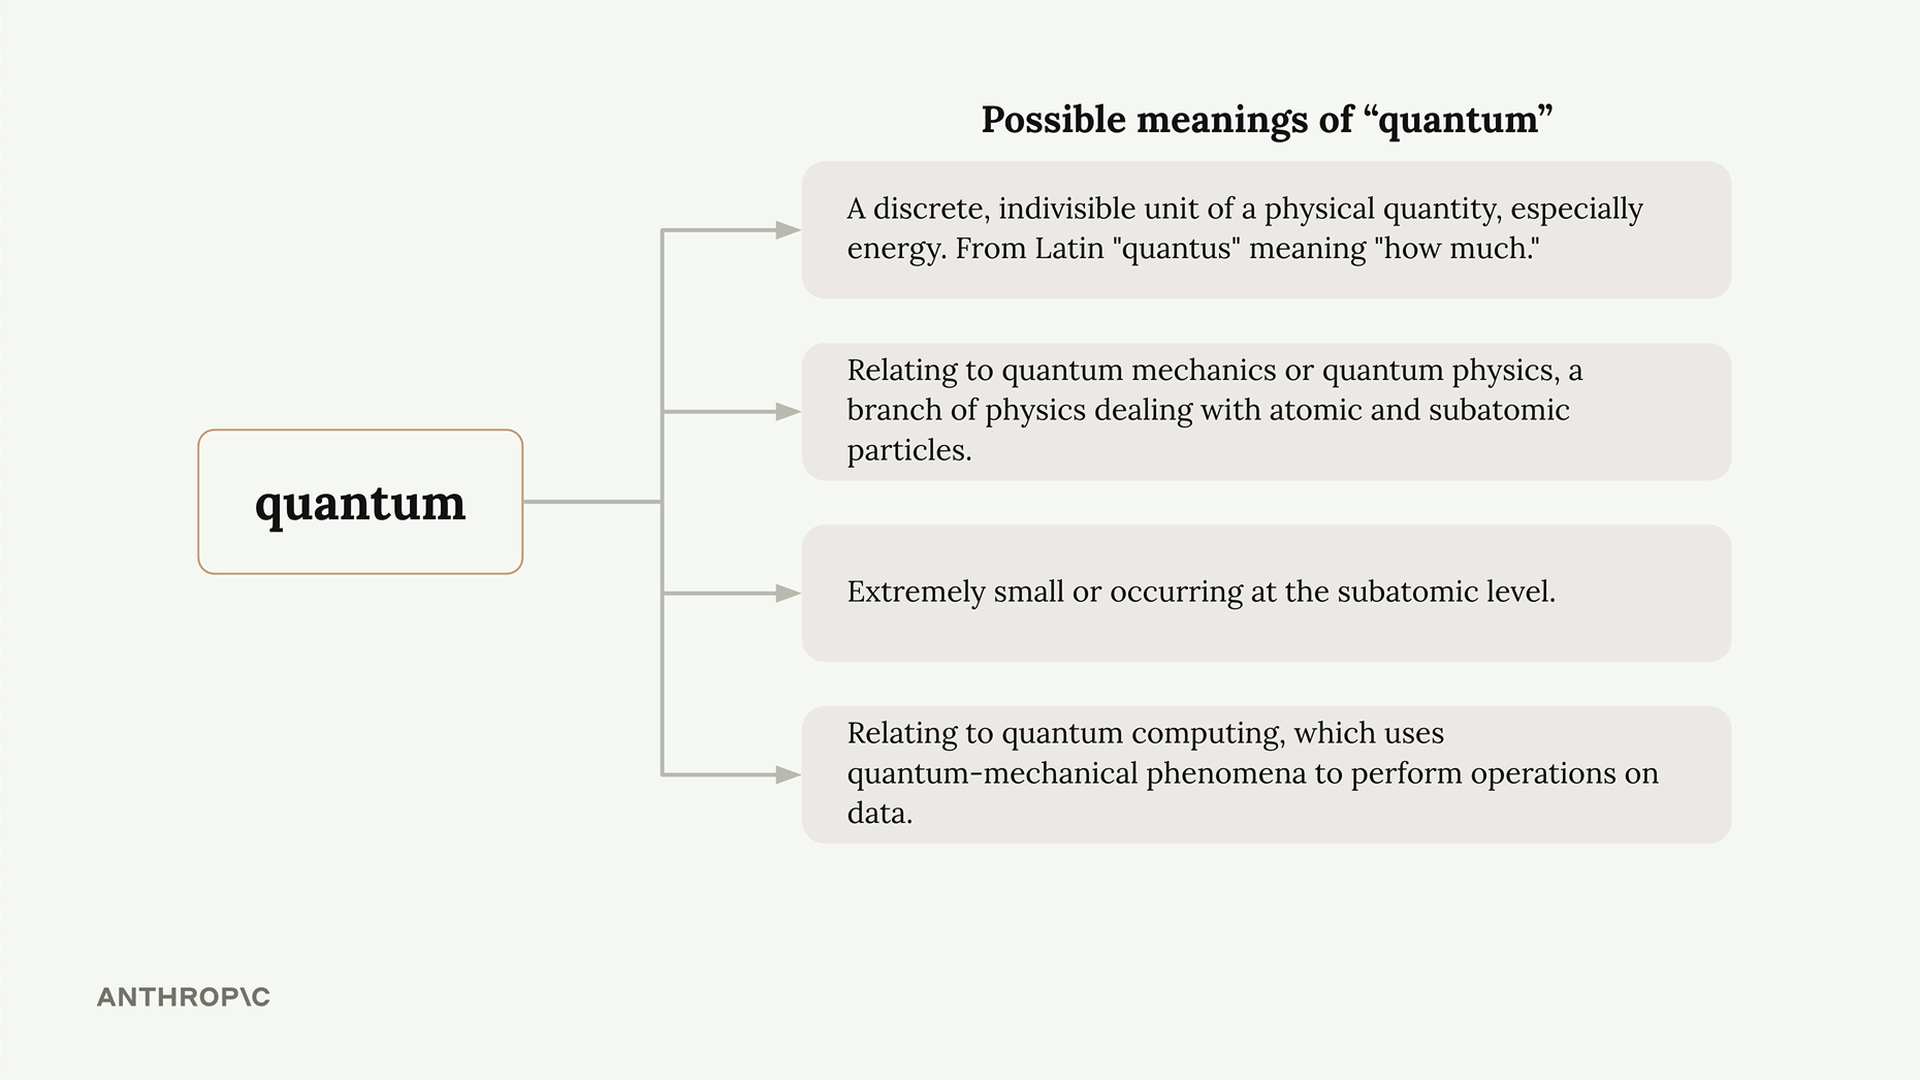
Dado que las palabras pueden tener múltiples significados, Claude usa el contexto para determinar la interpretación correcta. La palabra "cuántica" podría referirse a la física, la computación, o simplemente significar "muy pequeña"; el contexto de las palabras circundantes aclara el significado deseado.
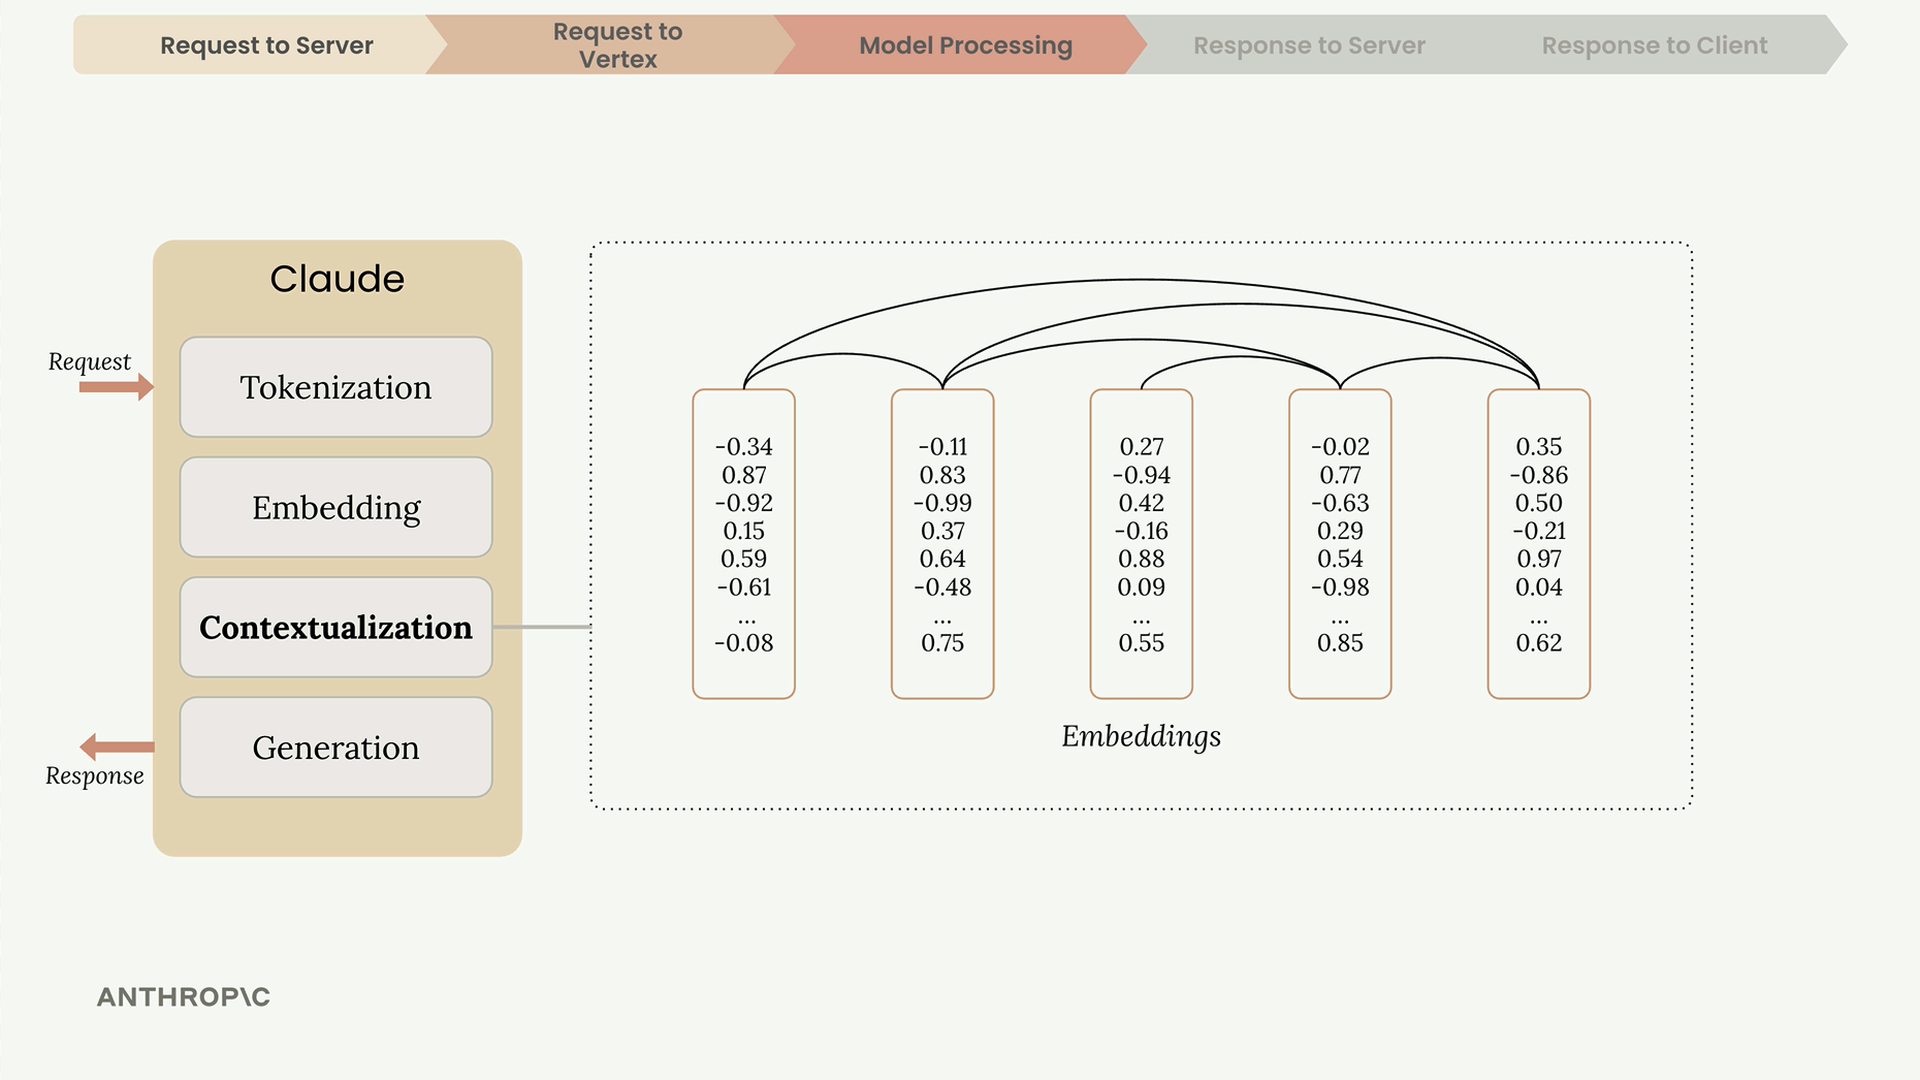
Durante la contextualización, cada embedding se ajusta en función de sus vecinos, resaltando el significado que tiene más sentido dado el contexto.
Generación
Los embeddings contextualizados pasan por una capa de salida que produce probabilidades para cada posible palabra siguiente. Claude no siempre elige la palabra con mayor probabilidad; utiliza una combinación de probabilidad y aleatoriedad para crear respuestas más naturales y variadas.
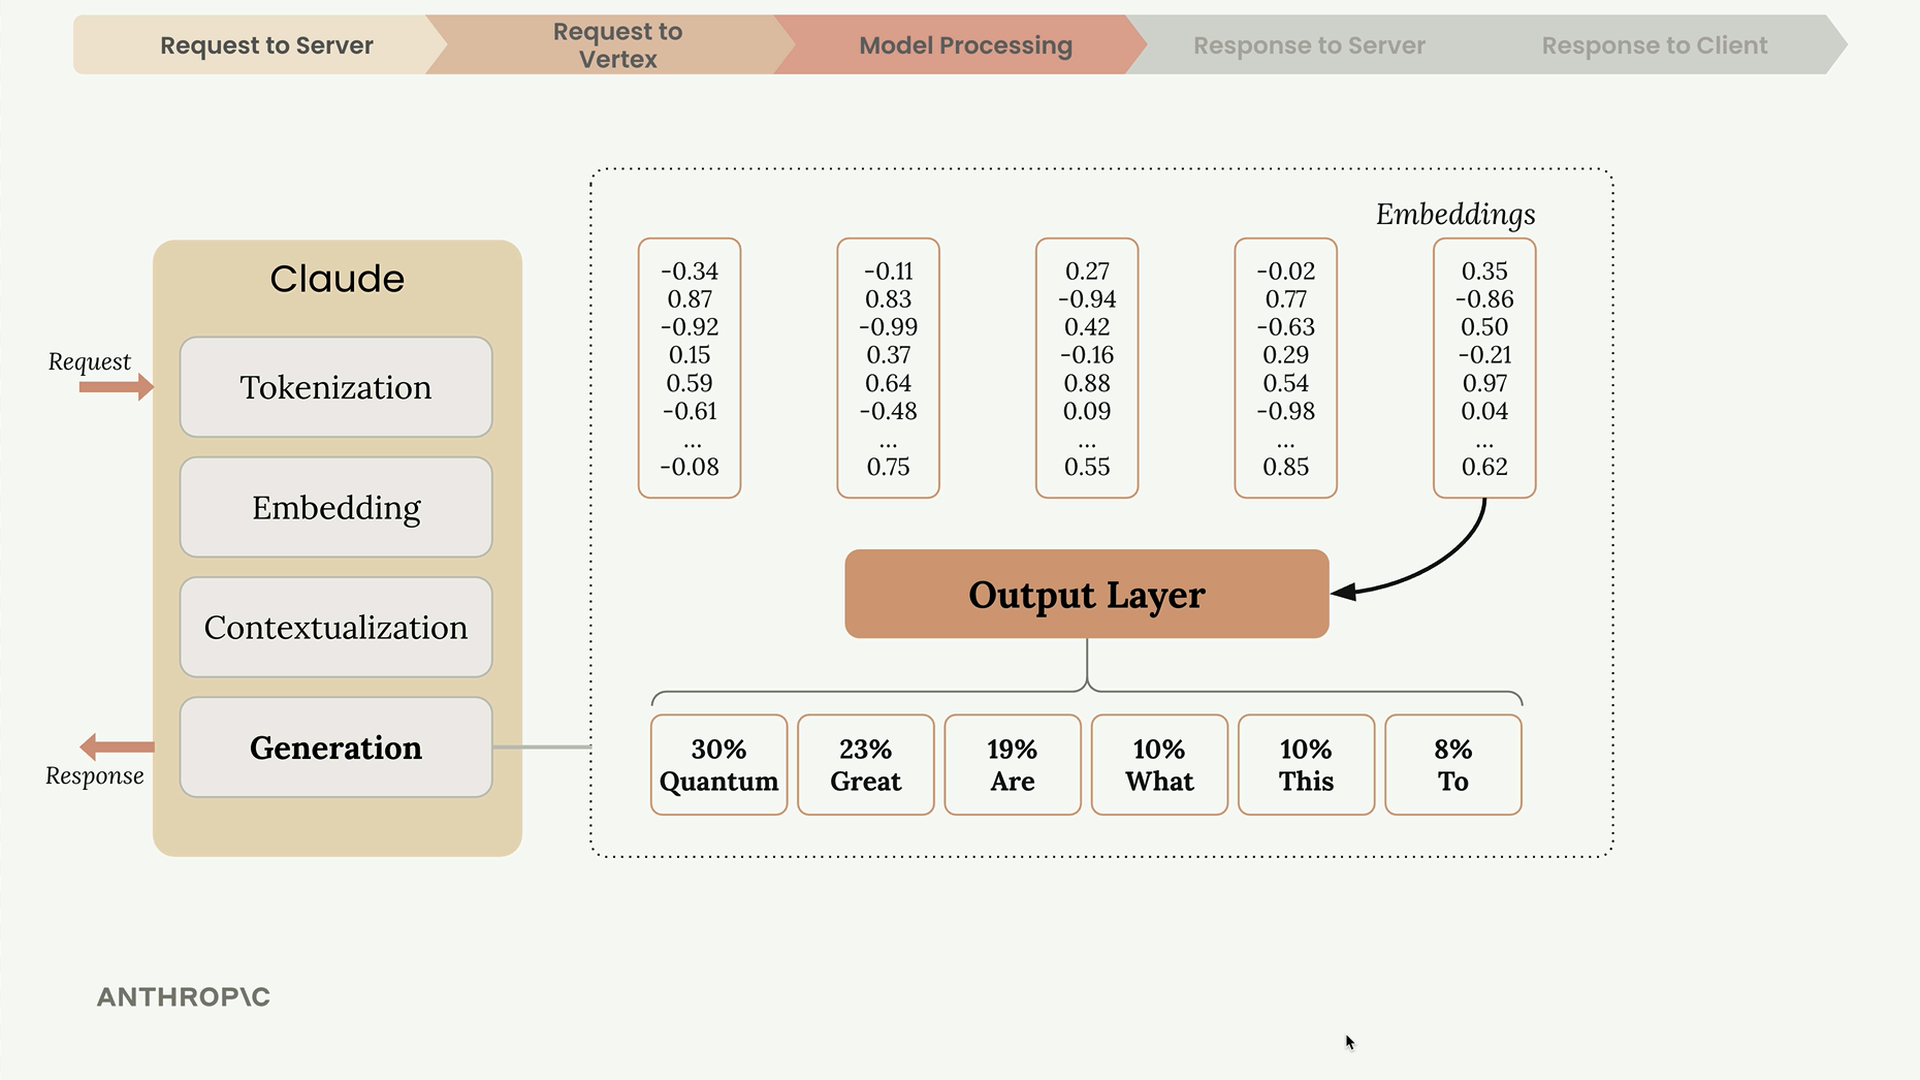
Después de seleccionar una palabra, Claude la agrega a la secuencia y repite todo el proceso para la siguiente palabra.
Cuándo se detiene la generación
Después de generar cada token, Claude comprueba varias condiciones para decidir si continúa:
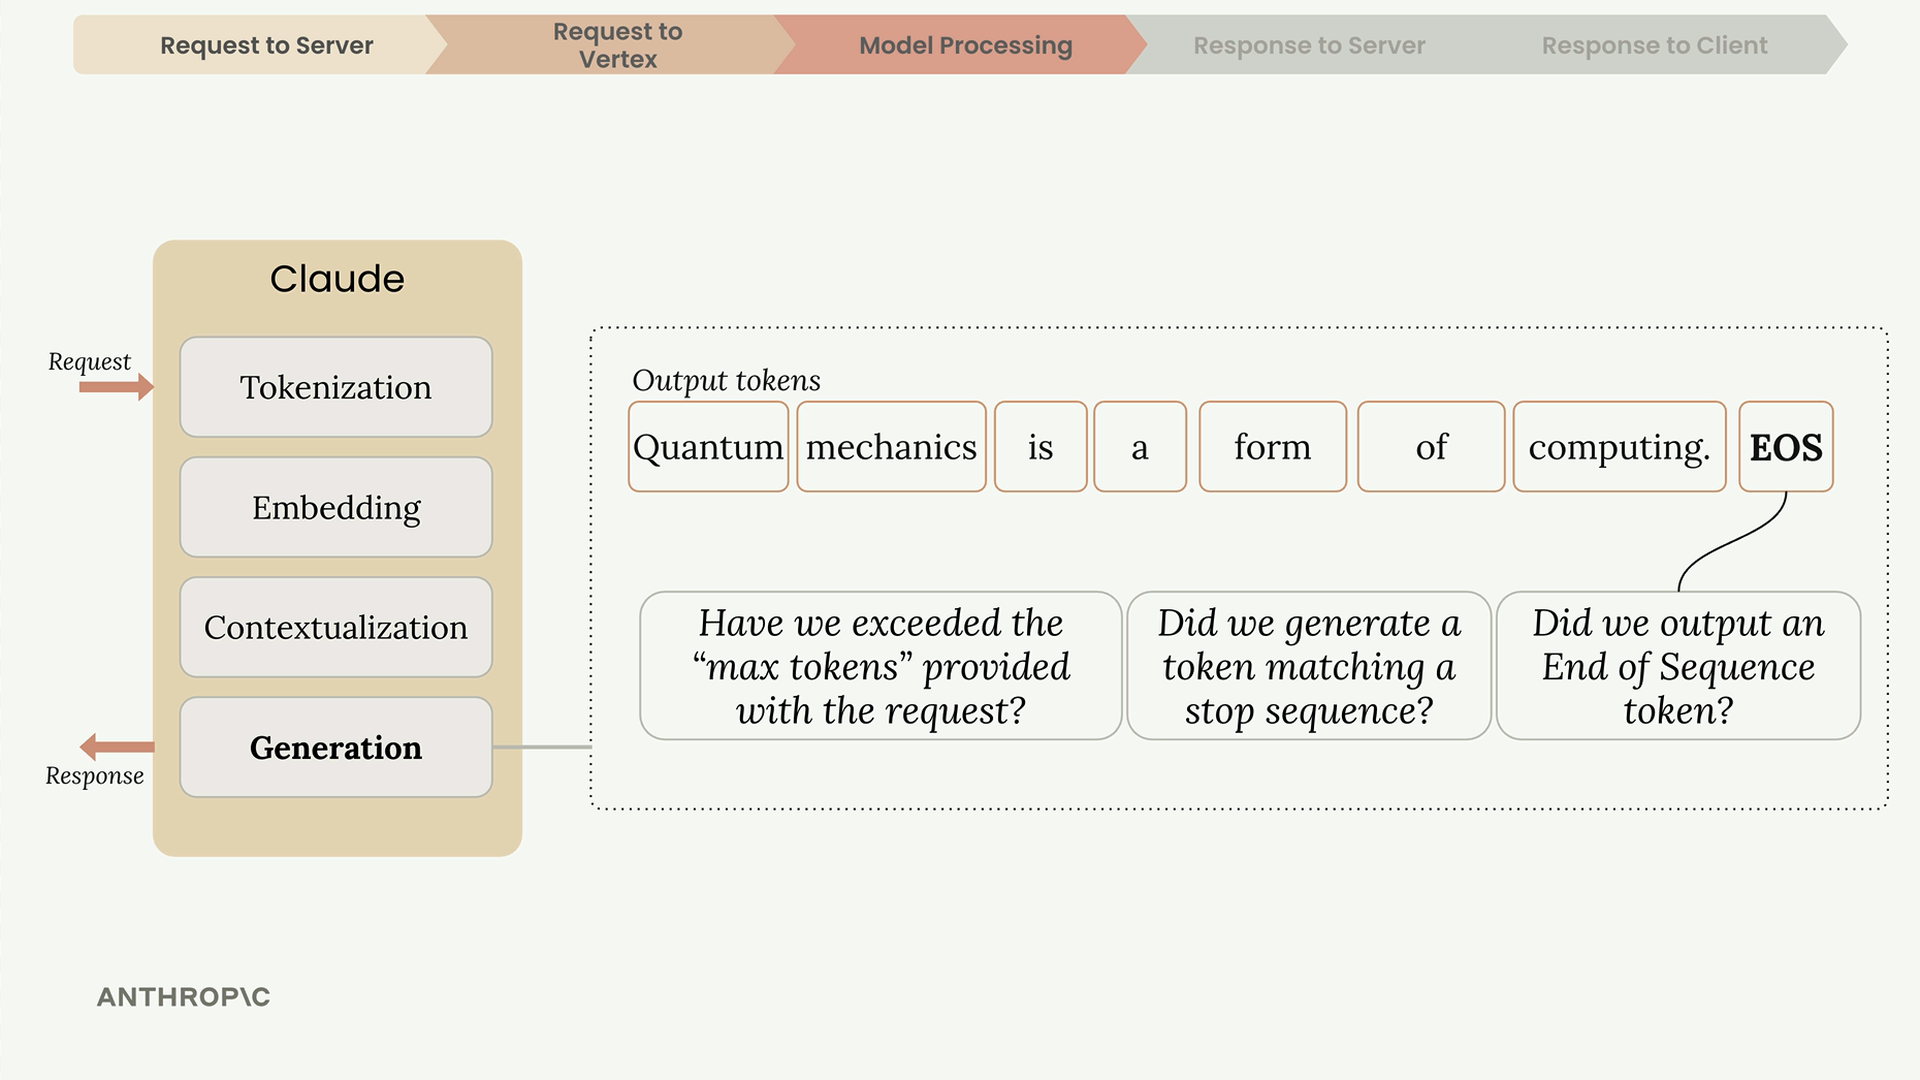
- Límite de tokens alcanzado: ¿se ha alcanzado el límite que especificaste?
- Final natural: ¿se generó un token de fin de secuencia?
- Secuencia de parada: ¿se encontró una frase de parada predefinida?
El token de fin de secuencia es una señal especial (no es texto visible) que Claude usa para indicar que ha llegado a una conclusión natural.
La respuesta
Una vez que finaliza la generación, Vertex envía una respuesta de vuelta a tu servidor que contiene:
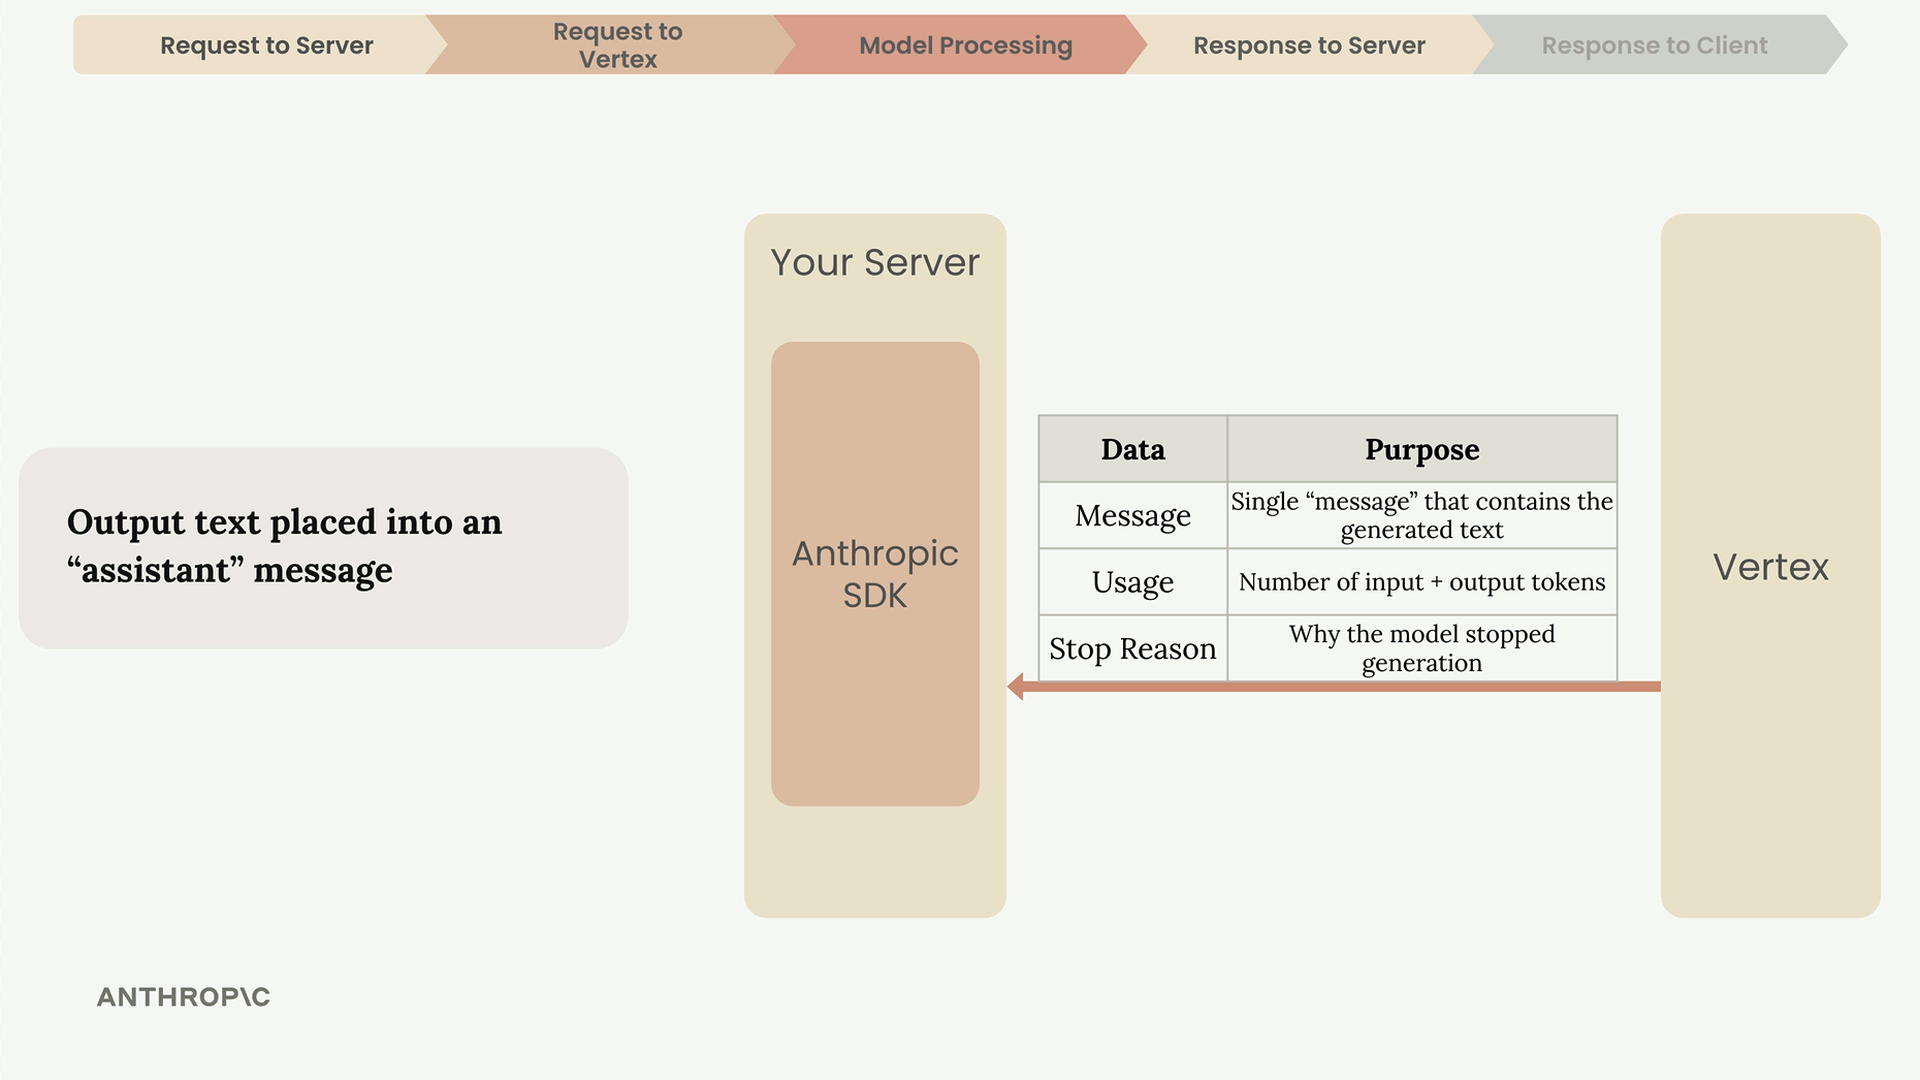
- Message: el texto generado
- Usage: conteo de tokens de entrada y salida
- Stop Reason: por qué el modelo dejó de generar
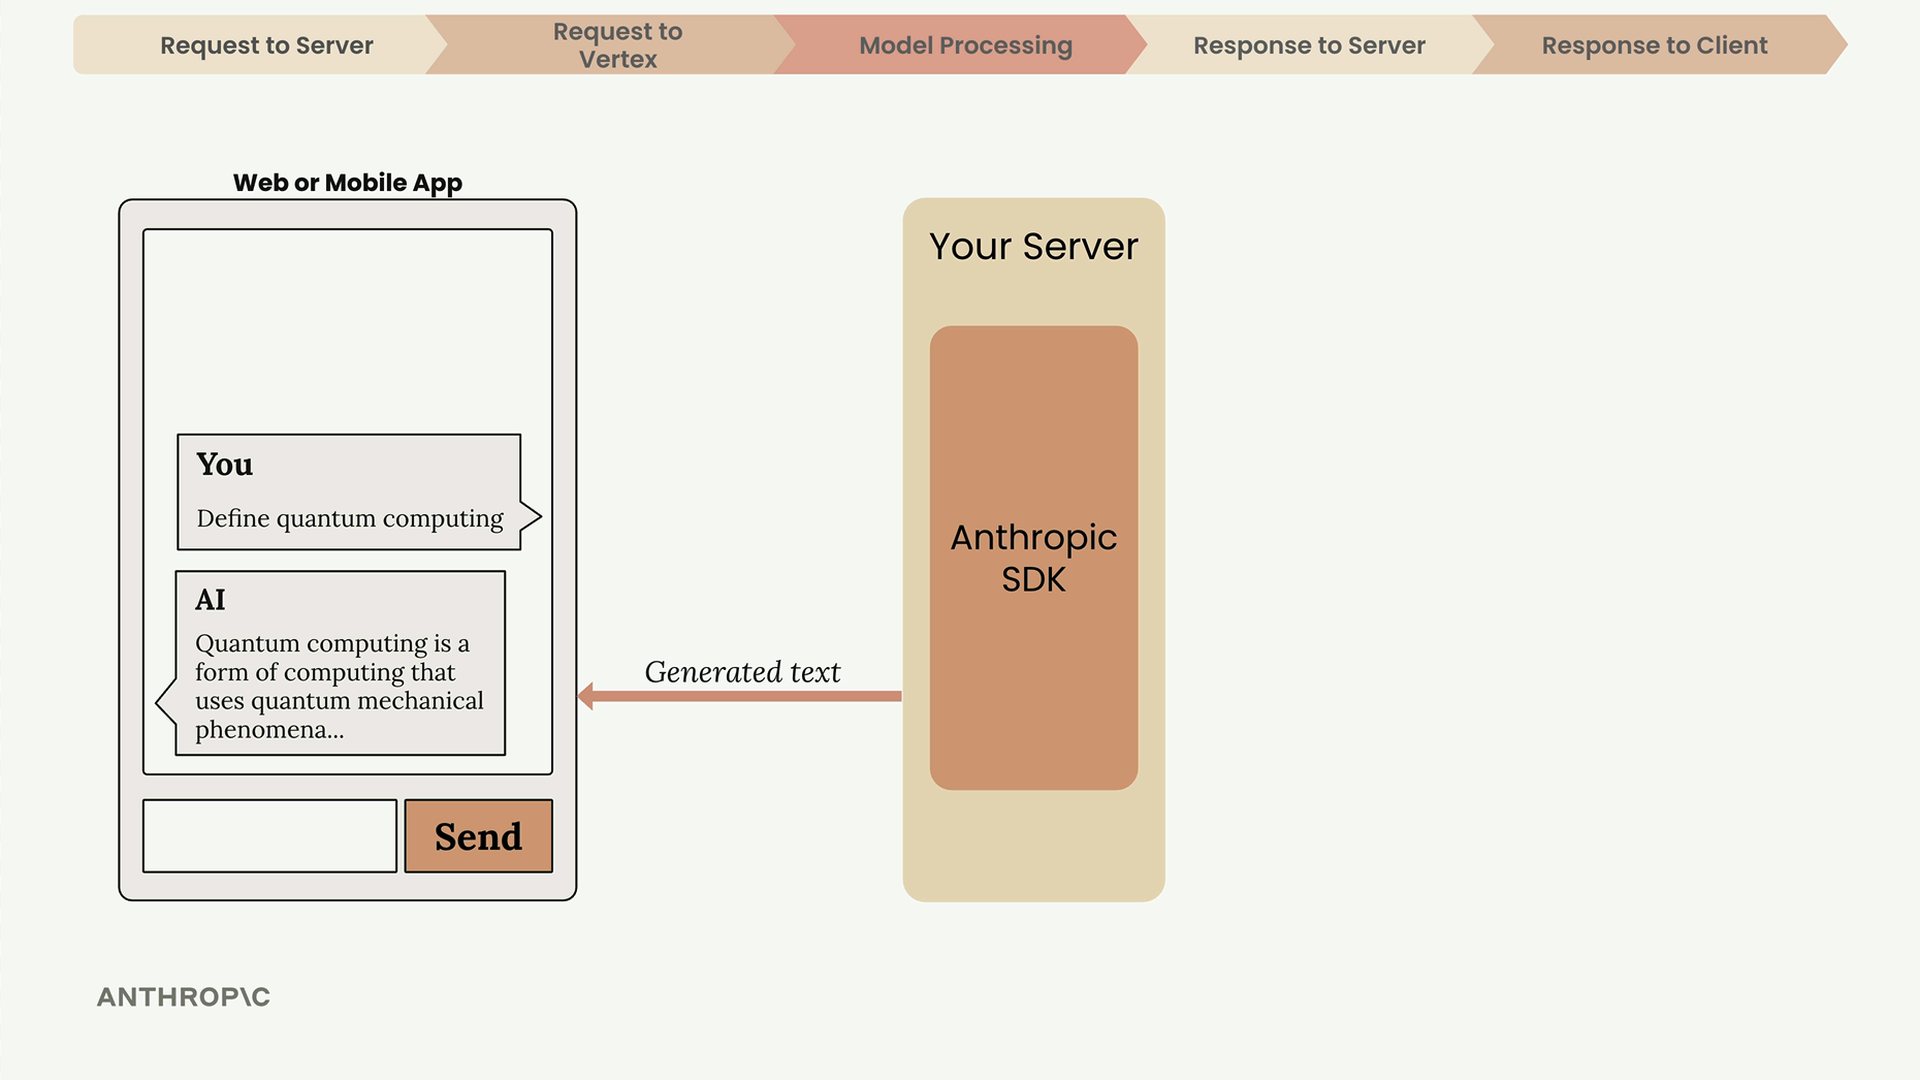
Tu servidor luego reenvía el texto generado a tu aplicación cliente, donde aparece en la interfaz de chat.
La imagen completa
Todo este proceso, desde la entrada del usuario pasando por la tokenización, el embedding, la contextualización, la generación y de vuelta al usuario, ocurre en segundos. Comprender este flujo te ayuda a crear aplicaciones más robustas y a solucionar problemas cuando surgen.
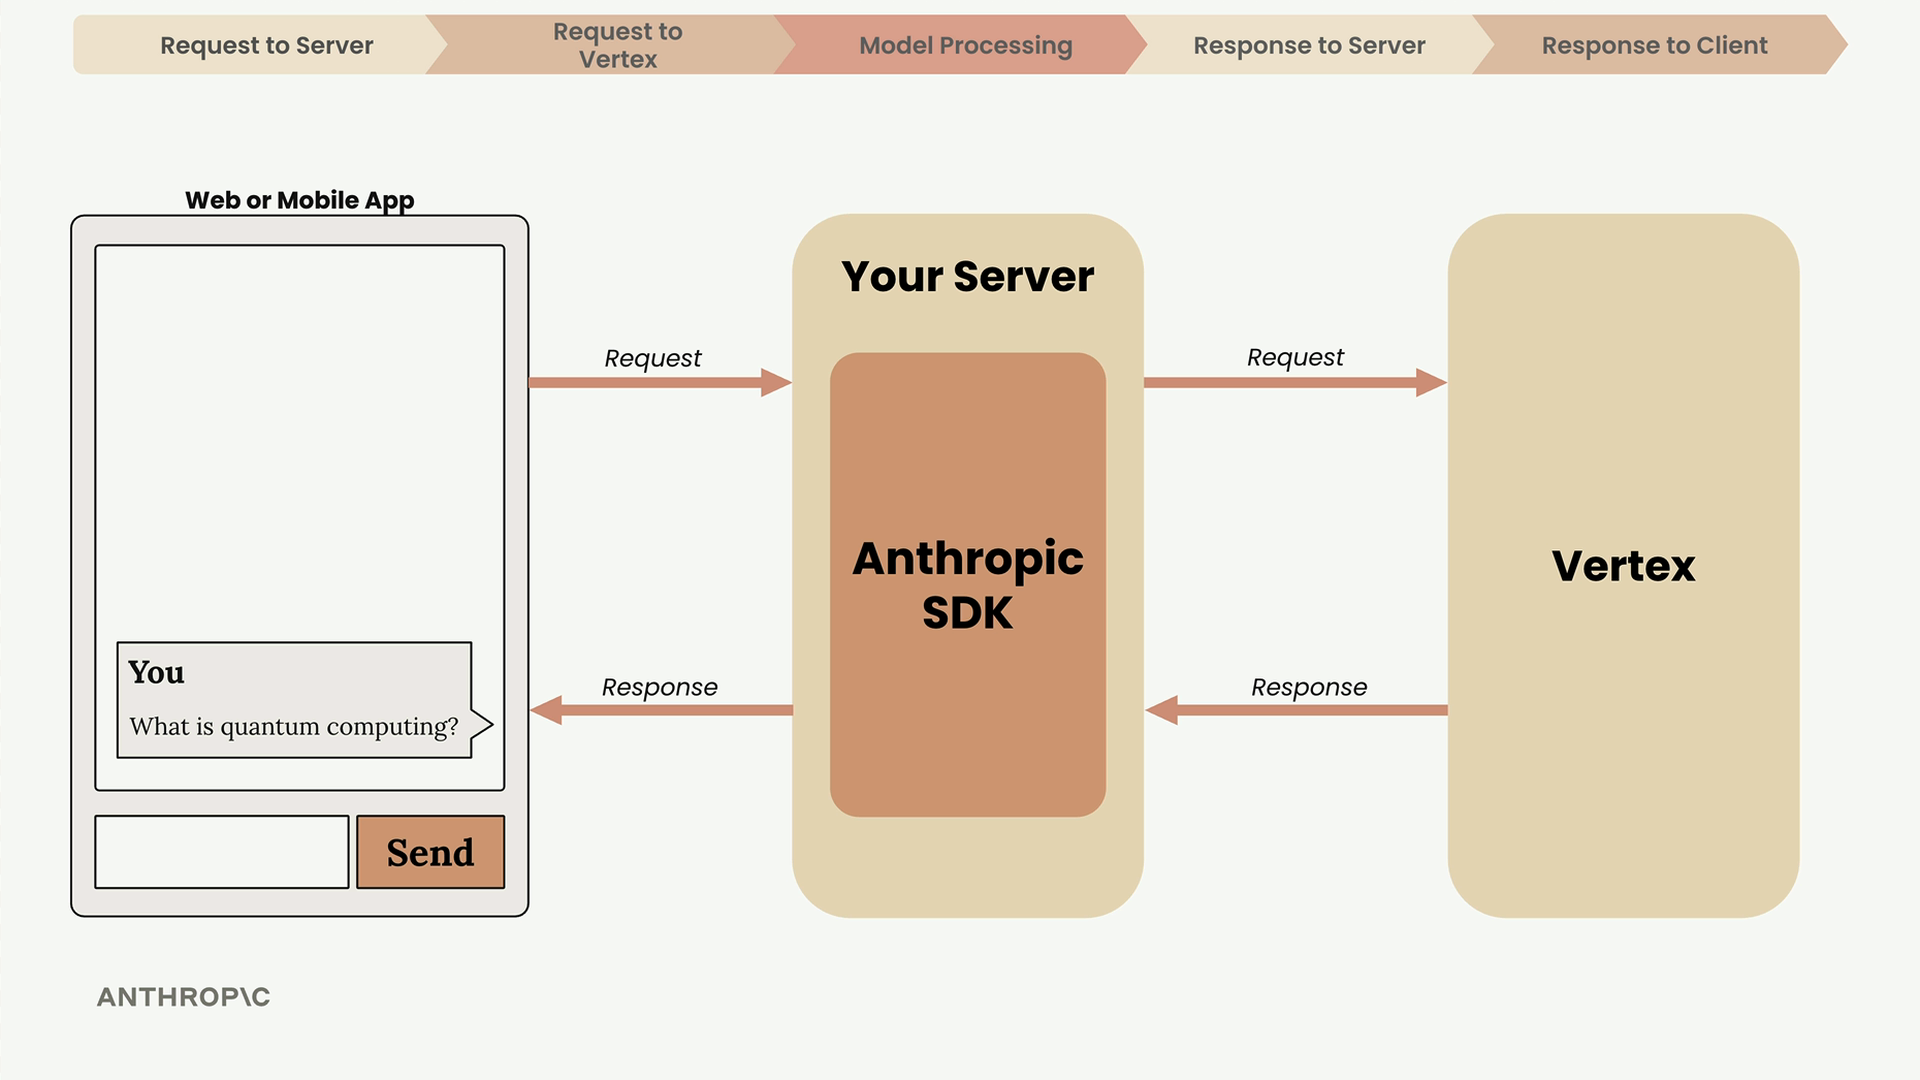
La conclusión clave: usa siempre un servidor como intermediario, comprende que la generación de texto es un proceso iterativo y presta atención a los metadatos de la respuesta para monitorear el uso y comprender el comportamiento del modelo.