La recuperación contextual es una técnica que mejora la precisión del pipeline de RAG al resolver un problema fundamental: cuando divides un documento en fragmentos, cada fragmento pierde su conexión con el contexto más amplio del documento.
El problema con la fragmentación estándar
Cuando tomas un documento fuente y lo divides en fragmentos para tu base de datos vectorial, cada pieza individual ya no sabe de dónde proviene ni cómo se relaciona con el resto del documento. Esto puede perjudicar la precisión de la recuperación porque a los fragmentos les falta información contextual importante.
Cómo funciona la recuperación contextual
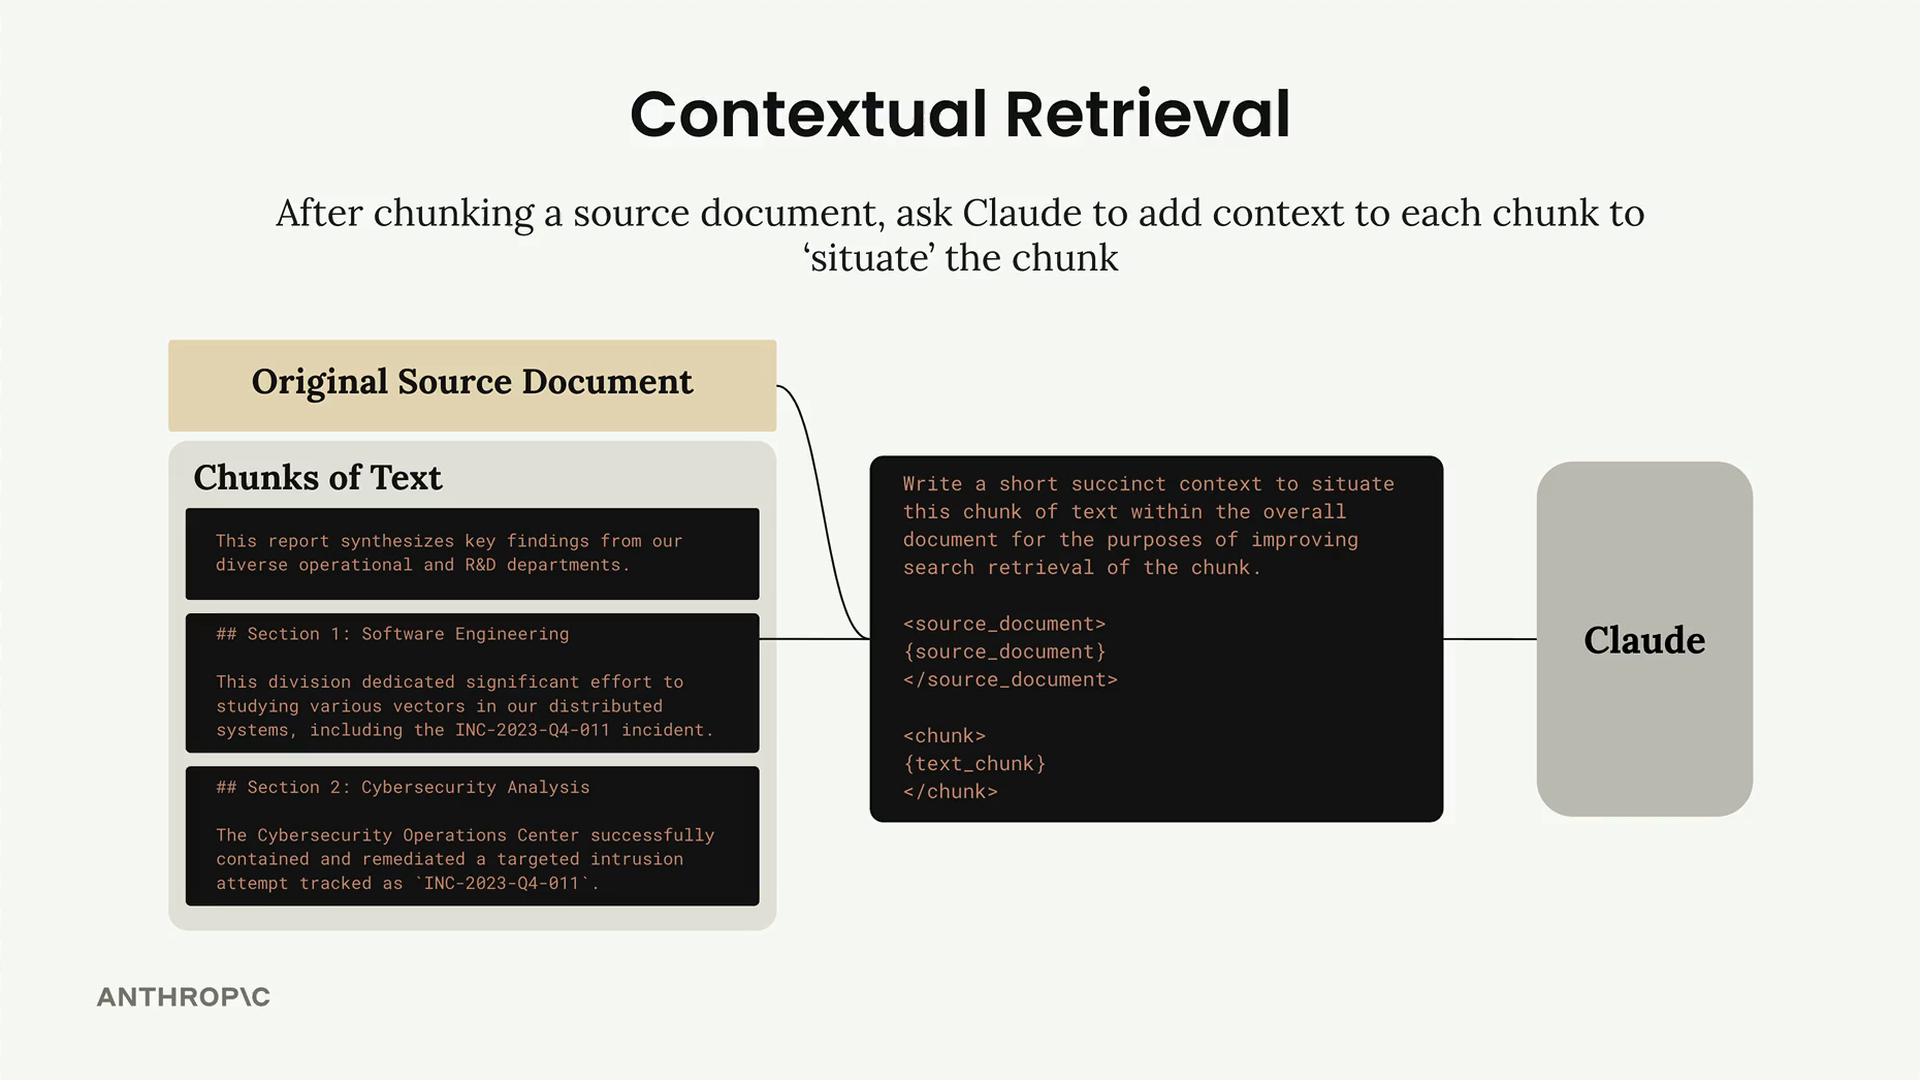
La recuperación contextual agrega un paso de preprocesamiento antes de insertar los fragmentos en tu base de datos de recuperación. Así es el proceso:
- Toma cada fragmento individual y el documento fuente original
- Envía ambos a Claude con una indicación específica que le pide que agregue contexto
- Claude genera un breve fragmento que "sitúa" el fragmento dentro del documento más amplio
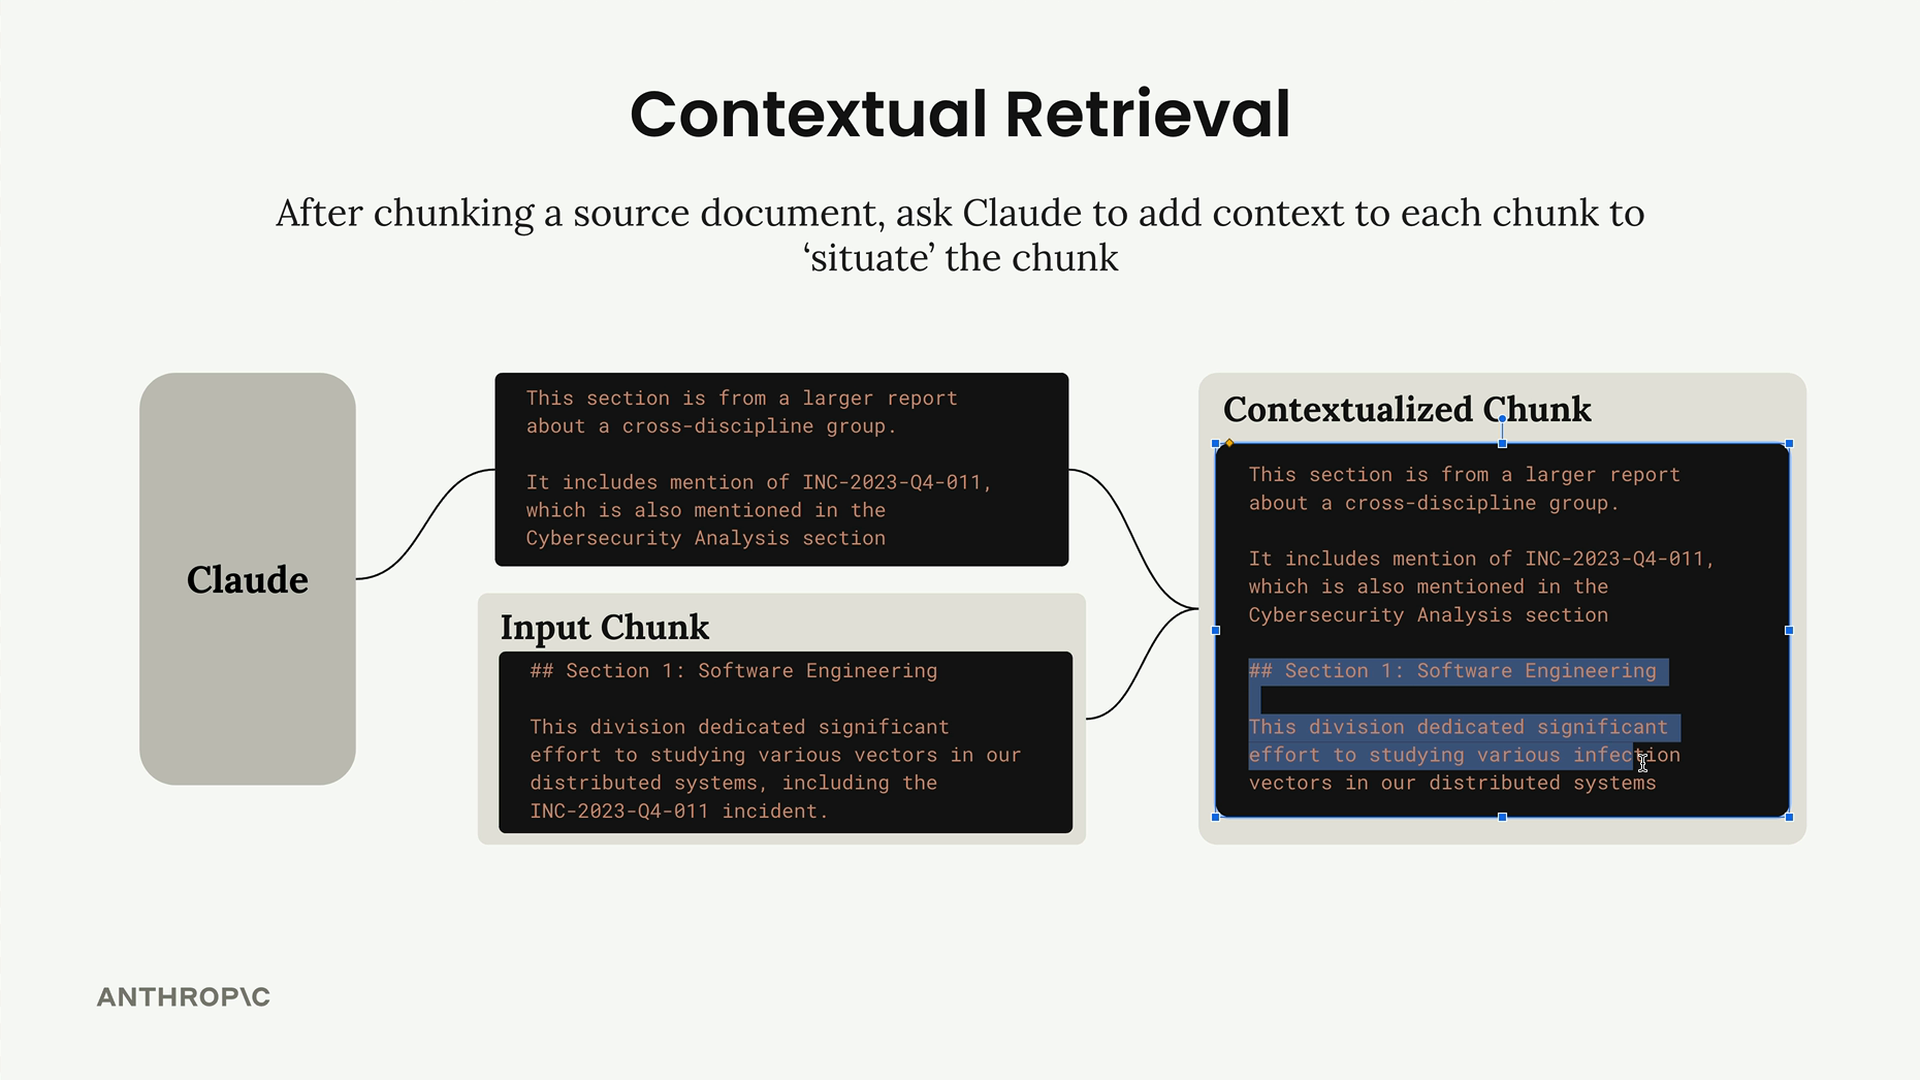
- Combina este contexto con el fragmento original para crear un "fragmento contextualizado"
- Usa el fragmento contextualizado en tus índices vectoriales y BM25
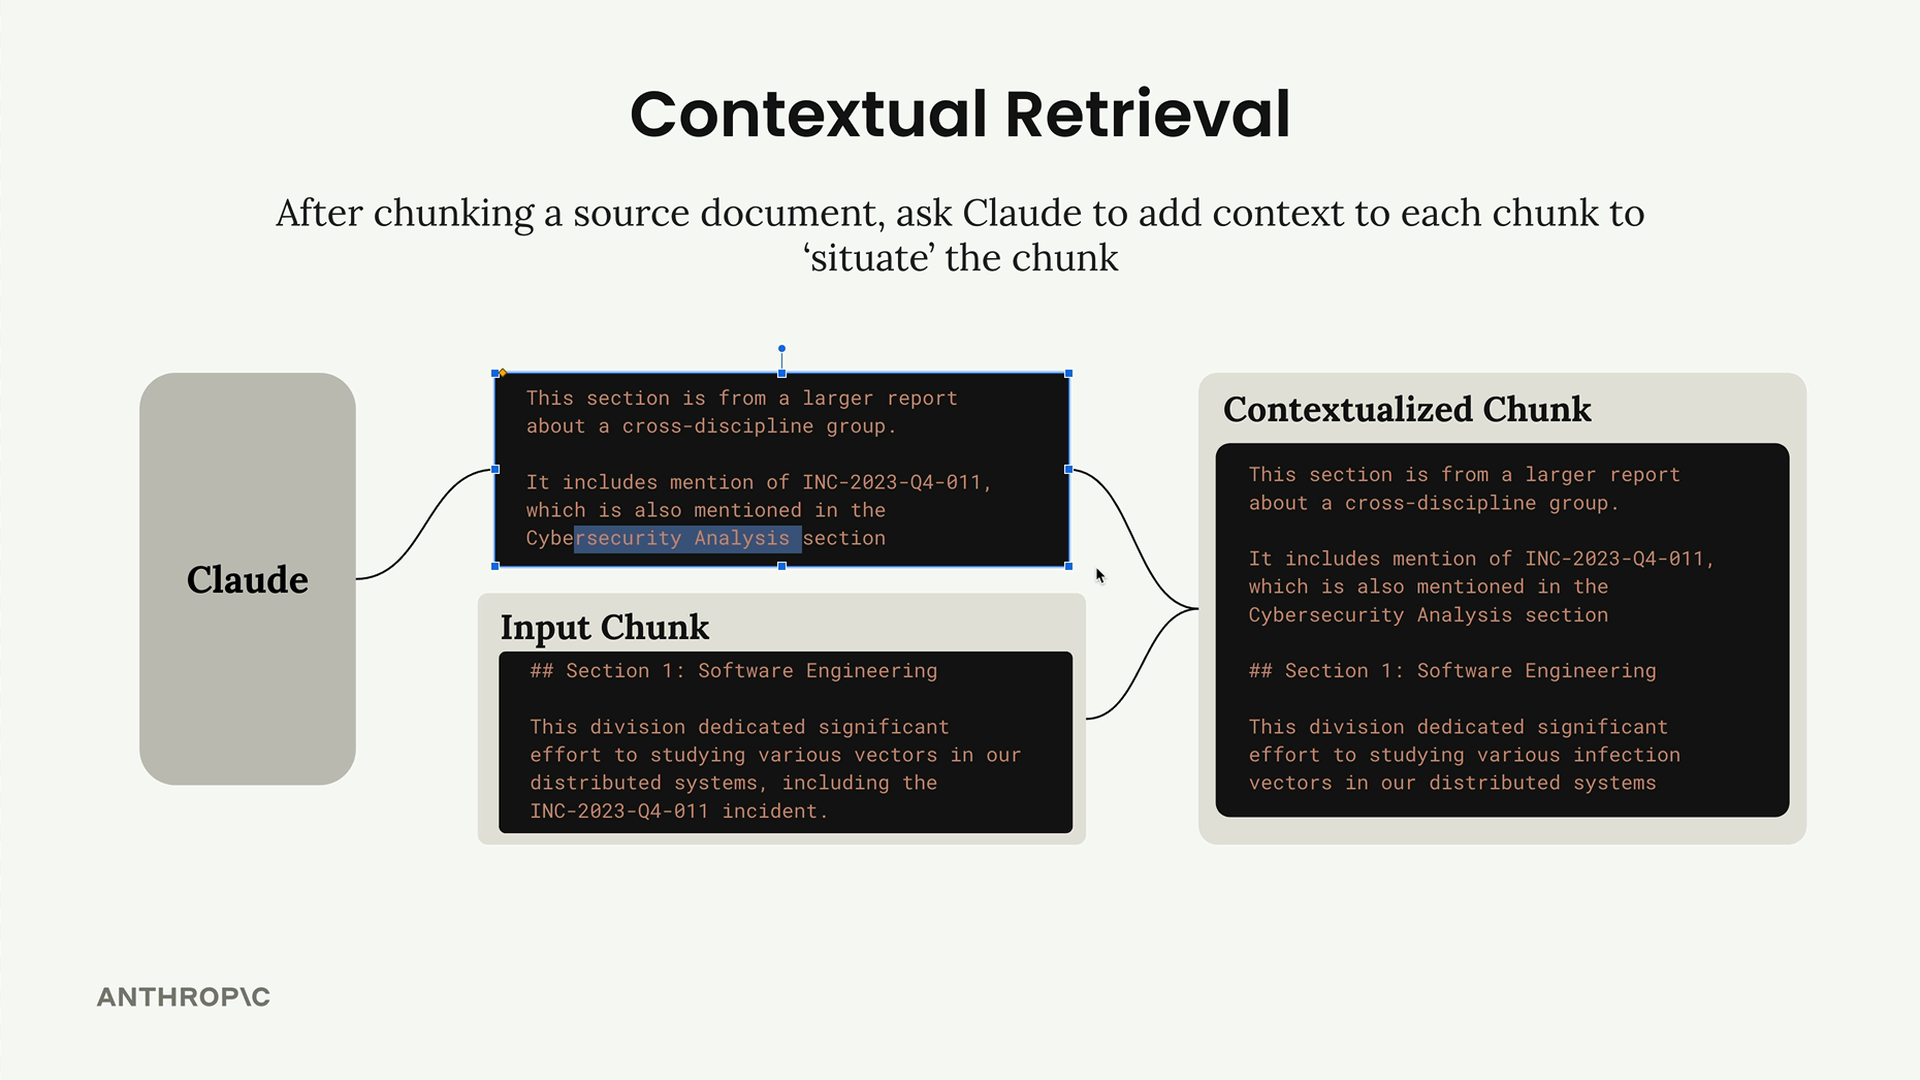
Por ejemplo, si tienes una sección sobre ingeniería de software que menciona un incidente de 2023, Claude podría generar un contexto como: "Esta sección es de un informe más amplio sobre un grupo interdisciplinario. Incluye la mención de INC-2023-04-011, que también se menciona en la sección de Análisis de Ciberseguridad."
Manejo de documentos grandes
Un problema común ocurre cuando tu documento fuente es demasiado grande para caber en la ventana de contexto de Claude. Aun así puedes usar la recuperación contextual proporcionando un conjunto reducido de contexto:
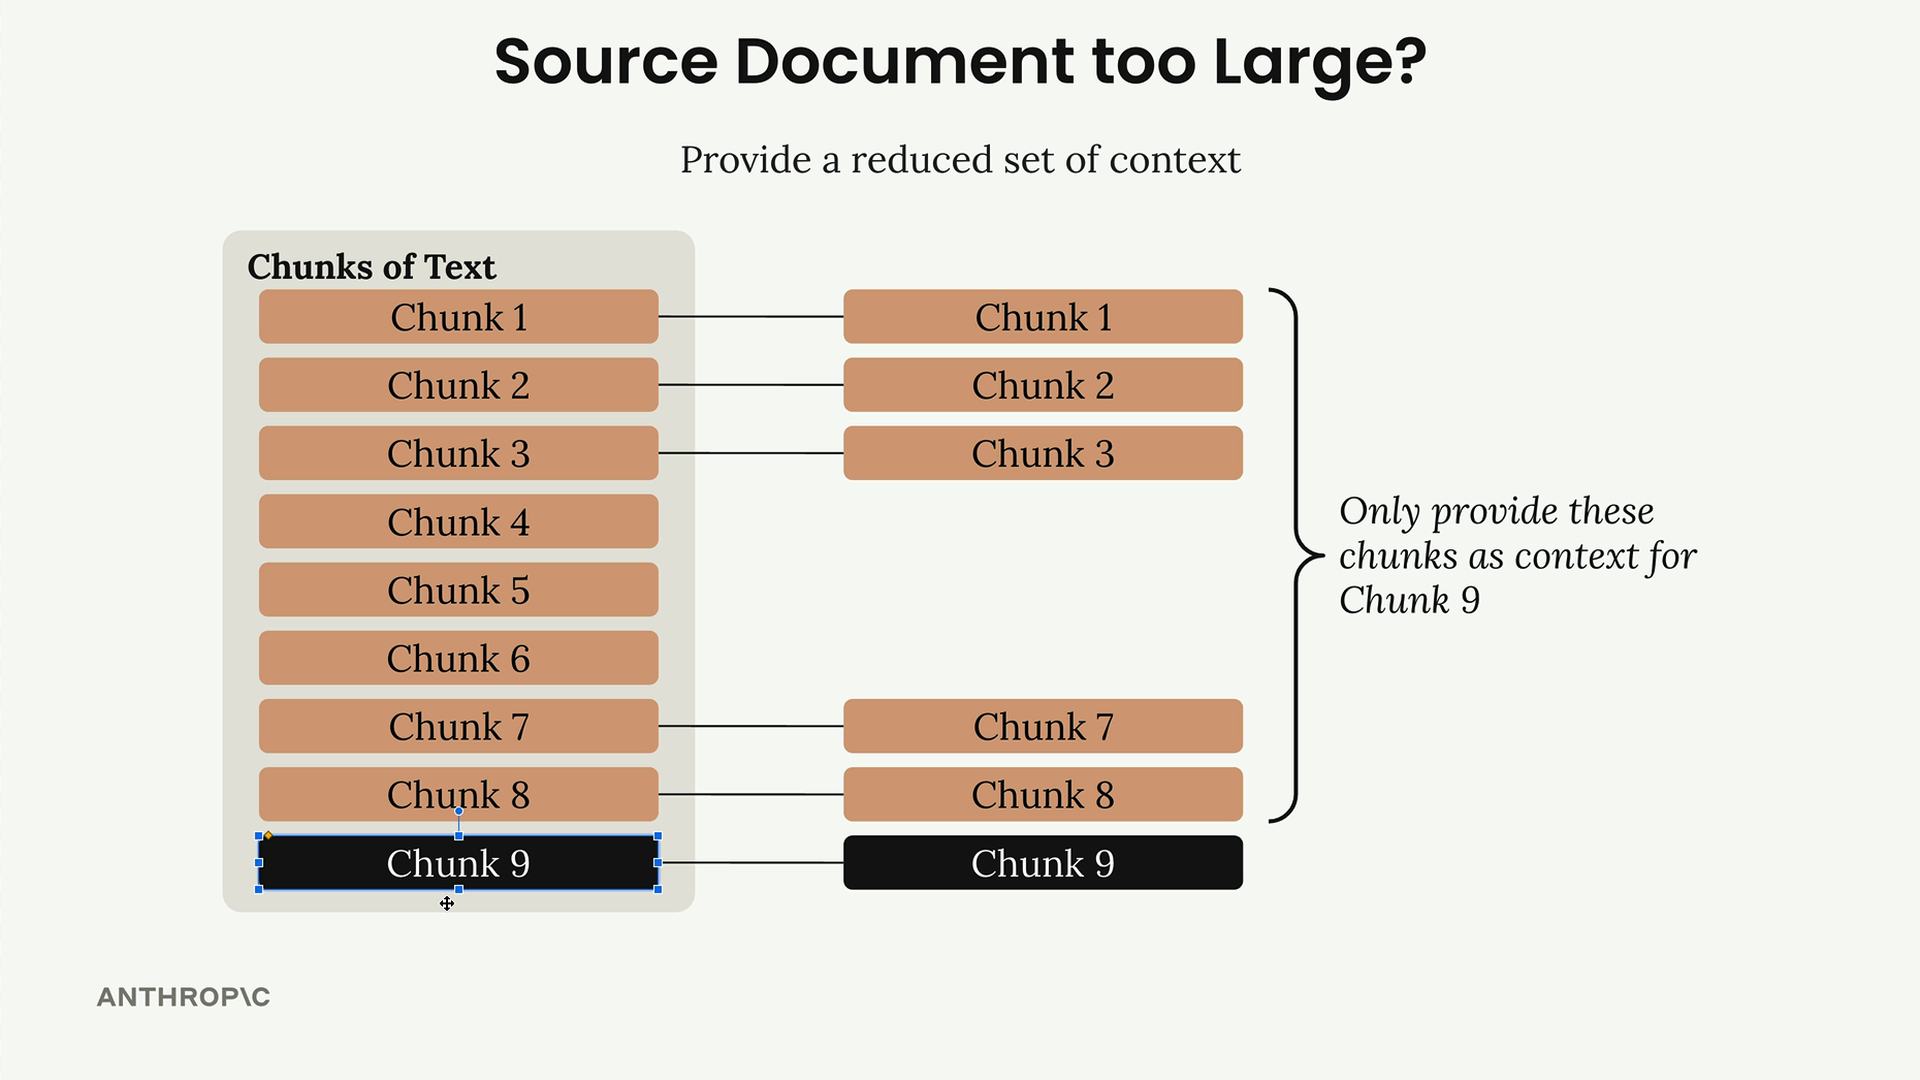
En lugar de incluir el documento completo, proporciona:
- Algunos fragmentos del inicio del documento (que a menudo contienen resúmenes o extractos)
- Fragmentos inmediatamente anteriores al fragmento que estás contextualizando
Este enfoque le da a Claude suficiente información para comprender la estructura del documento y el contexto inmediato sin saturar la indicación.
Ejemplo de implementación
Aquí tienes una función básica para agregar contexto a los fragmentos:
def add_context(text_chunk, source_text):
    prompt = f"""
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.
"""

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return text_from_message(result) + "\n" + text_chunk
Para documentos grandes, puedes implementar una estrategia que seleccione los fragmentos de contexto relevantes:
# Agrega contexto a cada fragmento y luego agrégalo al retriever
num_start_chunks = 2
num_prev_chunks = 2

for i, chunk in enumerate(chunks):
    context_parts = []

    # Conjunto inicial de fragmentos desde el inicio del documento
    context_parts.extend(chunks[: min(num_start_chunks, len(chunks))])

    # Fragmentos adicionales por delante del fragmento actual que estamos contextualizando
    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
Cuándo usar la recuperación contextual
Esta técnica es más valiosa cuando:
- Tus documentos tienen relaciones internas complejas entre secciones
- Los fragmentos hacen referencia a conceptos definidos en otra parte del documento
- Comprender la estructura del documento es importante para una recuperación precisa
- Estás trabajando con documentos técnicos, informes o artículos académicos
Aunque la recuperación contextual agrega tiempo de procesamiento y costo (ya que estás haciendo llamadas adicionales a la API), puede mejorar significativamente la precisión de recuperación para documentos complejos donde el contexto importa.