加载中
在将文档分割成块之后,RAG 流程中的下一步是找出哪些块与用户的问题最相关。这本质上是一个搜索问题——您需要查看所有的文本块,并找出与用户所询问内容相关的那些。
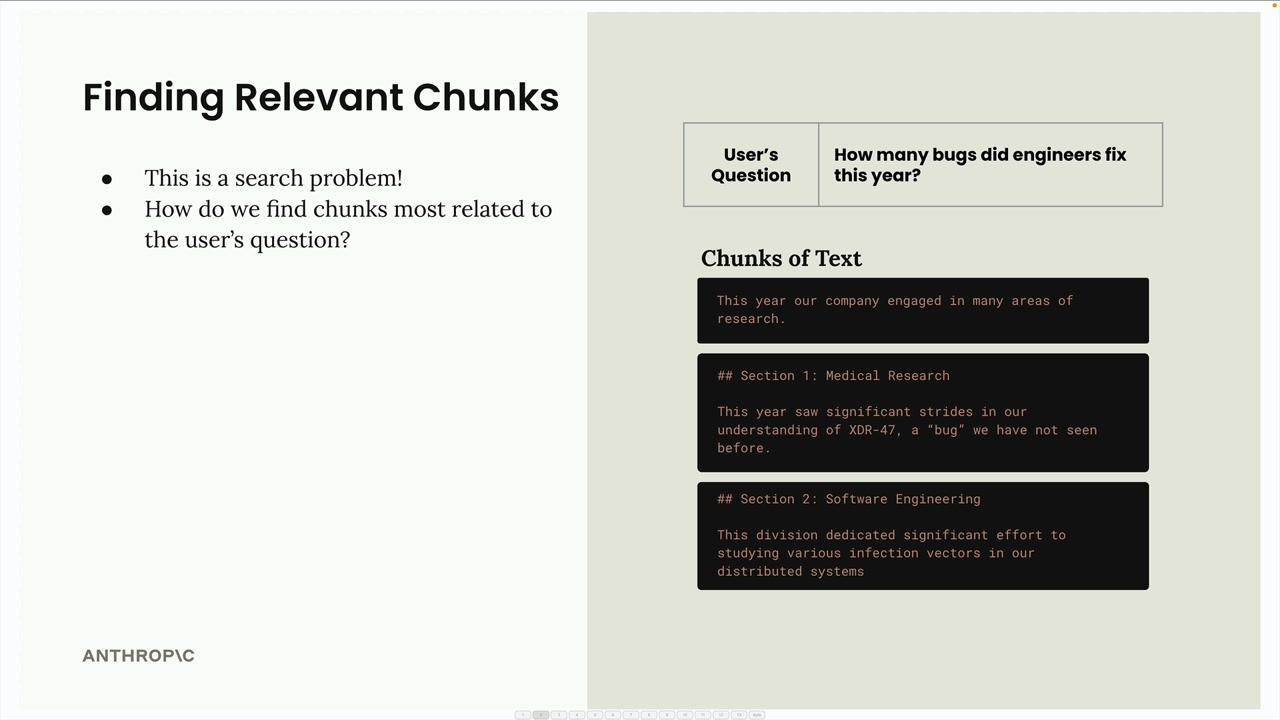
语义搜索
查找相关块最常见的方法是语义搜索。与寻找精确单词匹配的基于关键词的搜索不同,语义搜索使用文本嵌入来理解用户问题和每个文本块的含义和上下文。
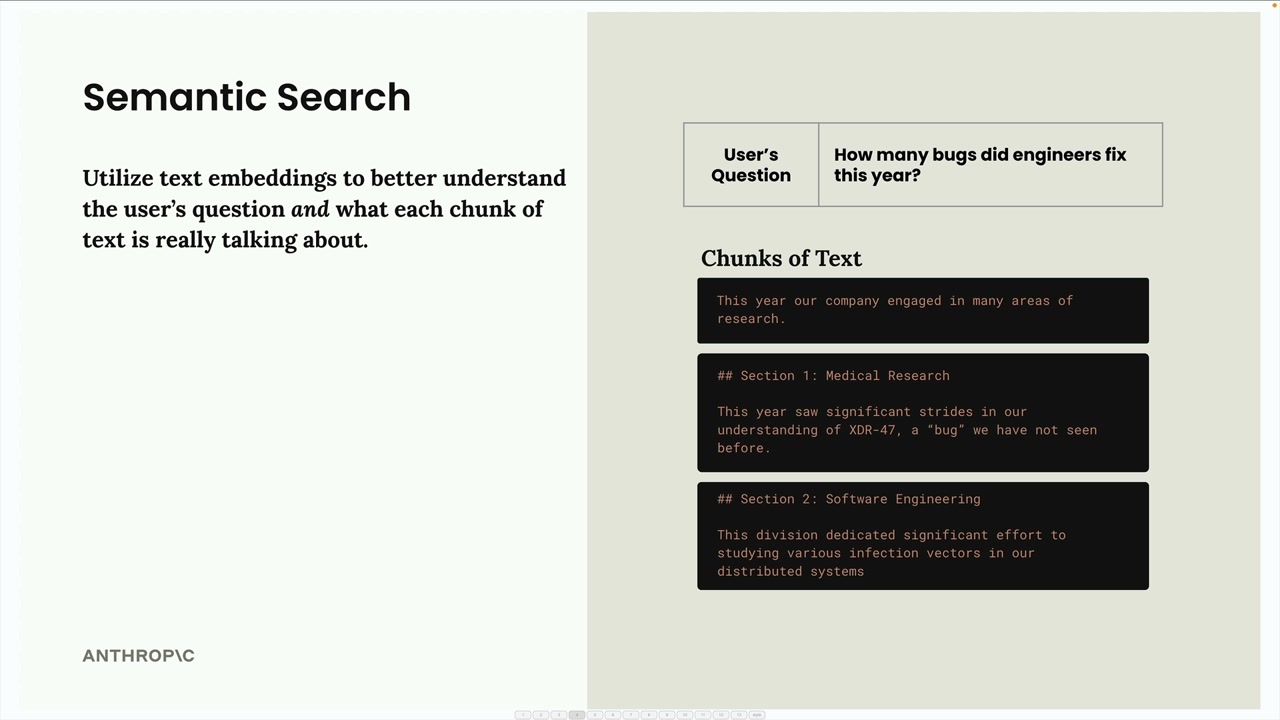
文本嵌入
文本嵌入是某段文本所包含含义的数值表示。可以将其视为把单词和句子转换成计算机可以进行数学处理的格式。
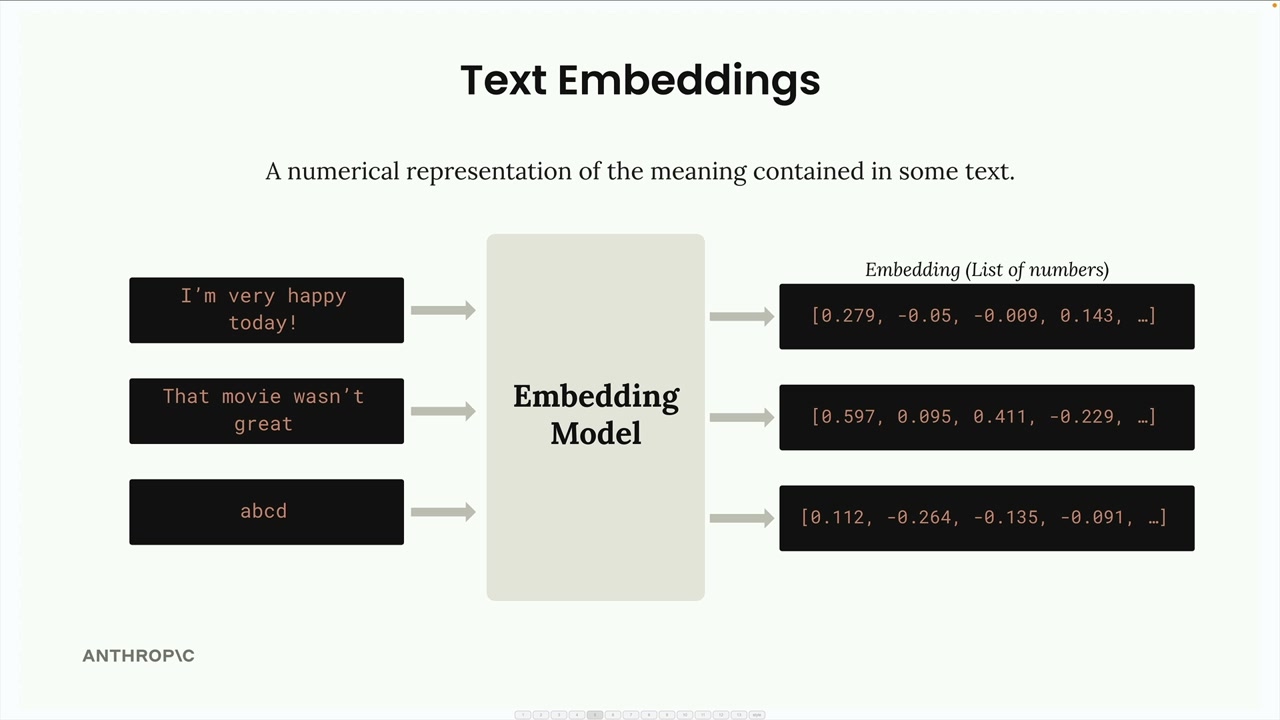
这个过程的工作原理如下:
- 您将文本输入到一个嵌入模型中
- 模型输出一长串数字(即嵌入向量)
- 每个数字的范围在 -1 到 +1 之间
- 这些数字代表输入文本的不同特质或特征
理解这些数字
嵌入向量中的每个数字本质上都是对输入文本某种特质的"打分"。但需要注意的重要一点是:我们并不清楚每个数字具体代表什么。
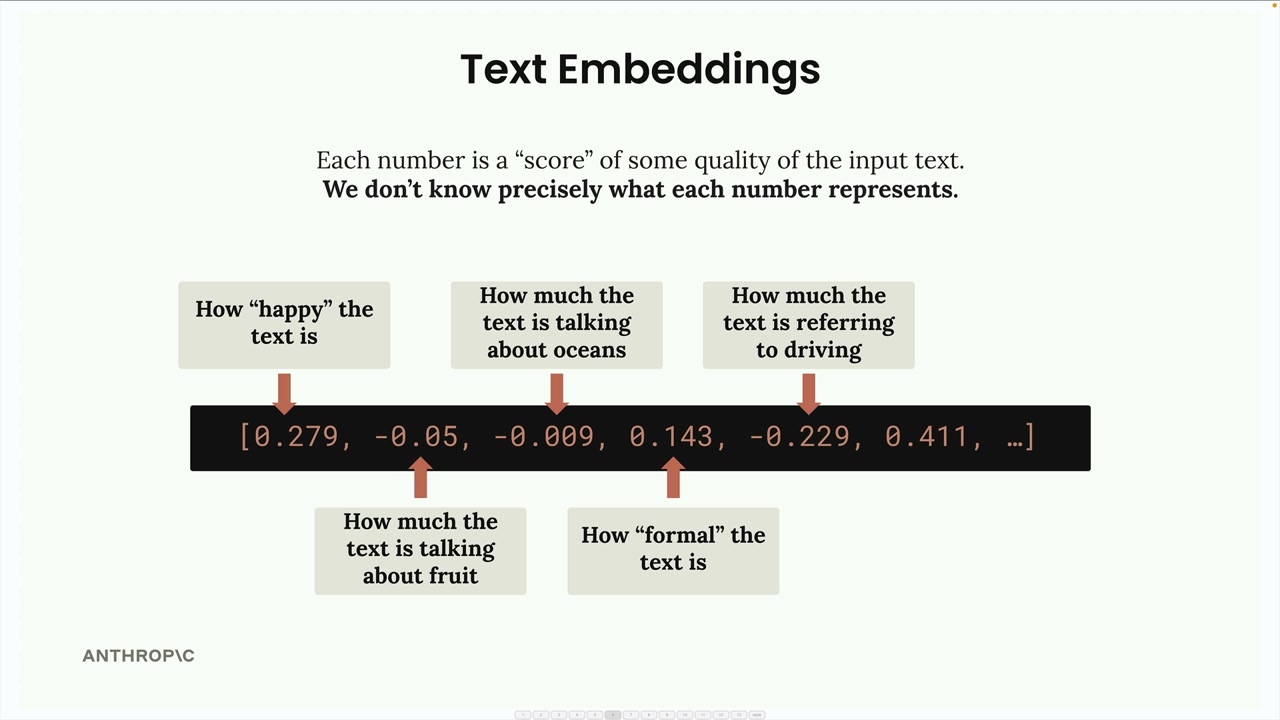
虽然想象某个数字可能代表"文本有多开心"或"文本谈论海洋的程度"会很有帮助,但这些只是概念性的示例。每个维度的实际含义是模型在训练过程中学习到的,人类无法直接解读。
使用 VoyageAI 生成嵌入
由于 Anthropic 目前不提供嵌入生成服务,推荐的提供商是 VoyageAI。您需要:
- 注册一个单独的 VoyageAI 账户
- 获取一个 API 密钥(免费即可开始使用)
- 将该密钥添加到您的环境变量中
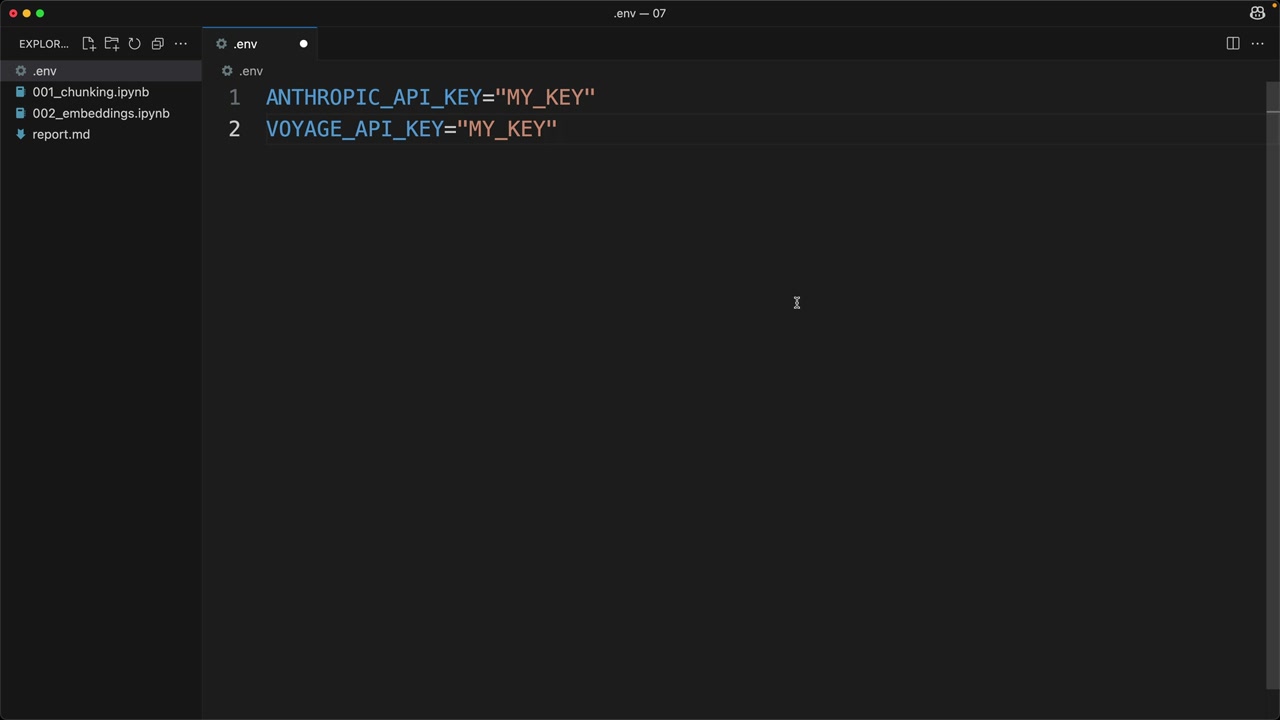
在您的 .env 文件中,添加:
bash
VOYAGE_API_KEY="your_key_here"实现
首先,安装 VoyageAI 库:
bash
%pip install voyageai然后设置客户端并创建一个用于生成嵌入的函数:
python
from dotenv import load_dotenv
import voyageai

load_dotenv()
client = voyageai.Client()

def generate_embedding(text, model="voyage-3-large", input_type="query"):
    result = client.embed([text], model=model, input_type=input_type)
    return result.embeddings[0]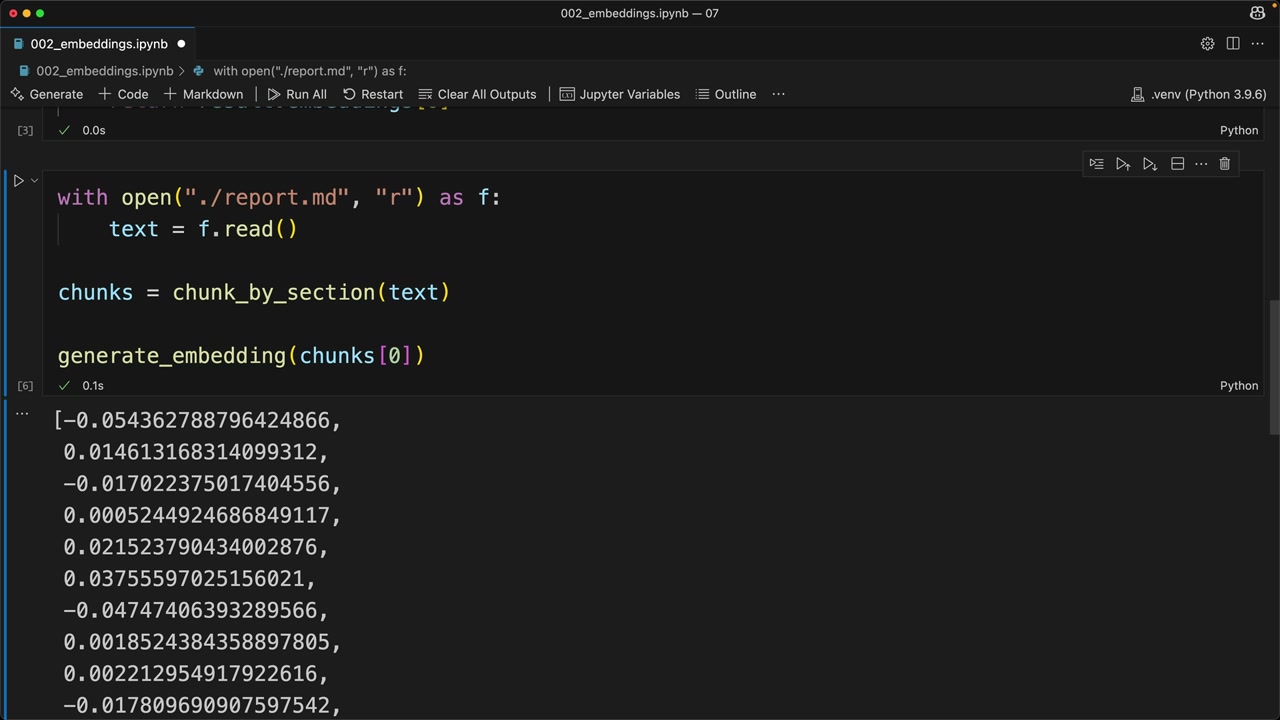
当您在一个文本块上运行此函数时,您会得到一个表示嵌入向量的浮点数列表。这个过程很快且简单直接——真正的挑战在于理解如何在您的 RAG 流程中有效利用这些嵌入向量来找到最相关的内容。
下一步是学习如何比较嵌入向量,以确定哪些块与用户的问题最相似,这构成了语义搜索过程的核心。