既然我们的评估数据集已经准备就绪,是时候构建核心评估流水线了。这包括:将每个测试用例与我们的提示合并,将其输入给Claude,然后对结果进行评分。
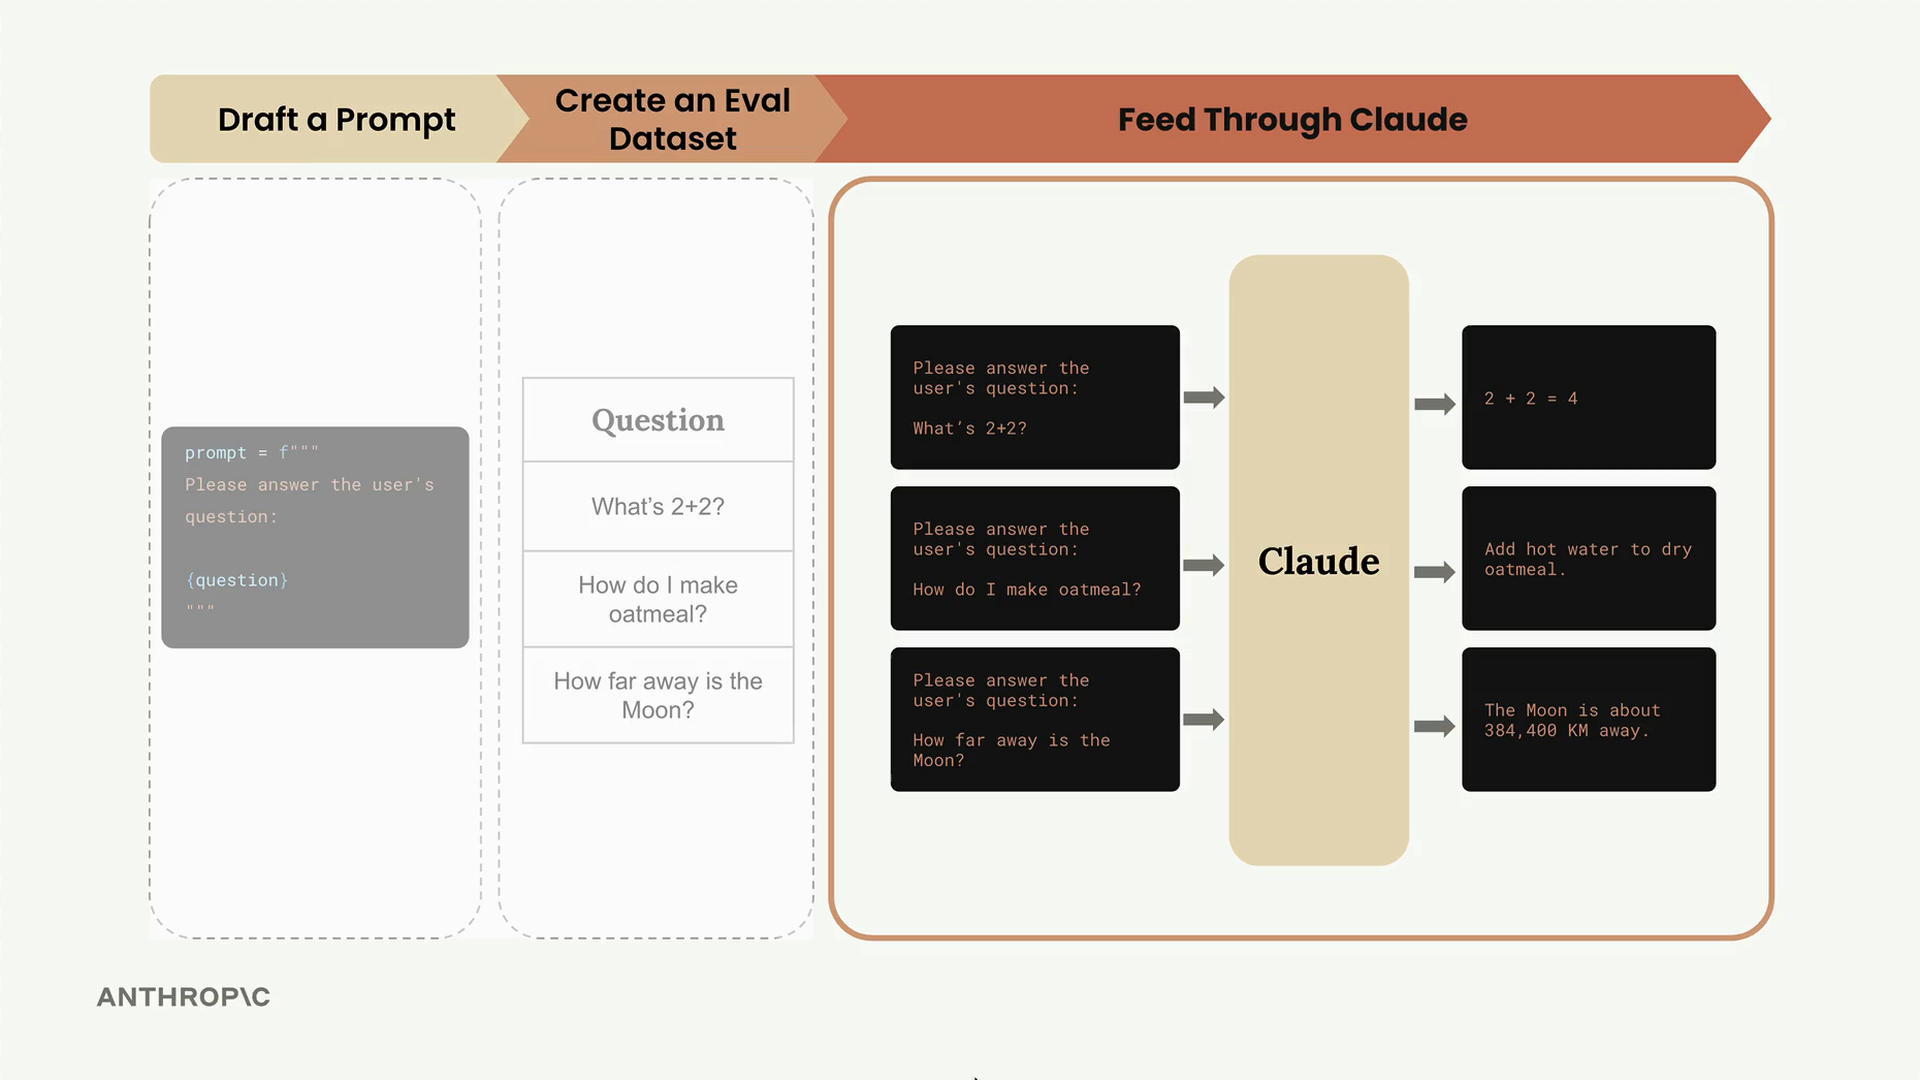
评估流程遵循一个清晰的工作流:我们获取测试用例数据集,将每个用例与我们的提示模板结合,将其发送给Claude进行处理,然后使用评分系统对输出进行评估。
构建核心函数
评估流水线由三个主要函数组成,每个函数都有特定的职责。让我们从最简单的一个开始——处理单个提示的函数。
run_prompt 函数
这个函数接收一个测试用例,并将其与我们的提示模板合并:
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
目前,我们将提示保持得极其简单。我们没有包含任何格式化指令,因此Claude很可能会返回比我们需要的更冗长的输出。随着我们在提示设计上的迭代,我们稍后会对此进行改进。
run_test_case 函数
这个函数负责编排单个测试用例的运行并对结果进行评分:
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - 评分
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
目前,我们使用的是硬编码的评分10分。评分逻辑是我们将在接下来的章节中花费大量时间的地方,但这个占位符让我们能够测试整个流水线。
run_eval 函数
这个函数协调整个评估过程:
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
此函数处理数据集中的每一个测试用例,并将所有结果收集到一个列表中。
运行评估
要执行我们的评估流水线,我们加载数据集并通过我们的函数运行它:
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
第一次运行时,预计会需要一些时间——即使使用Claude Haiku,处理一个完整的数据集也可能需要大约30秒。我们稍后会介绍优化技巧。
检查结果
评估返回一个结构化的JSON数组,其中每个对象代表一个测试用例的结果:
print(json.dumps(results, indent=2))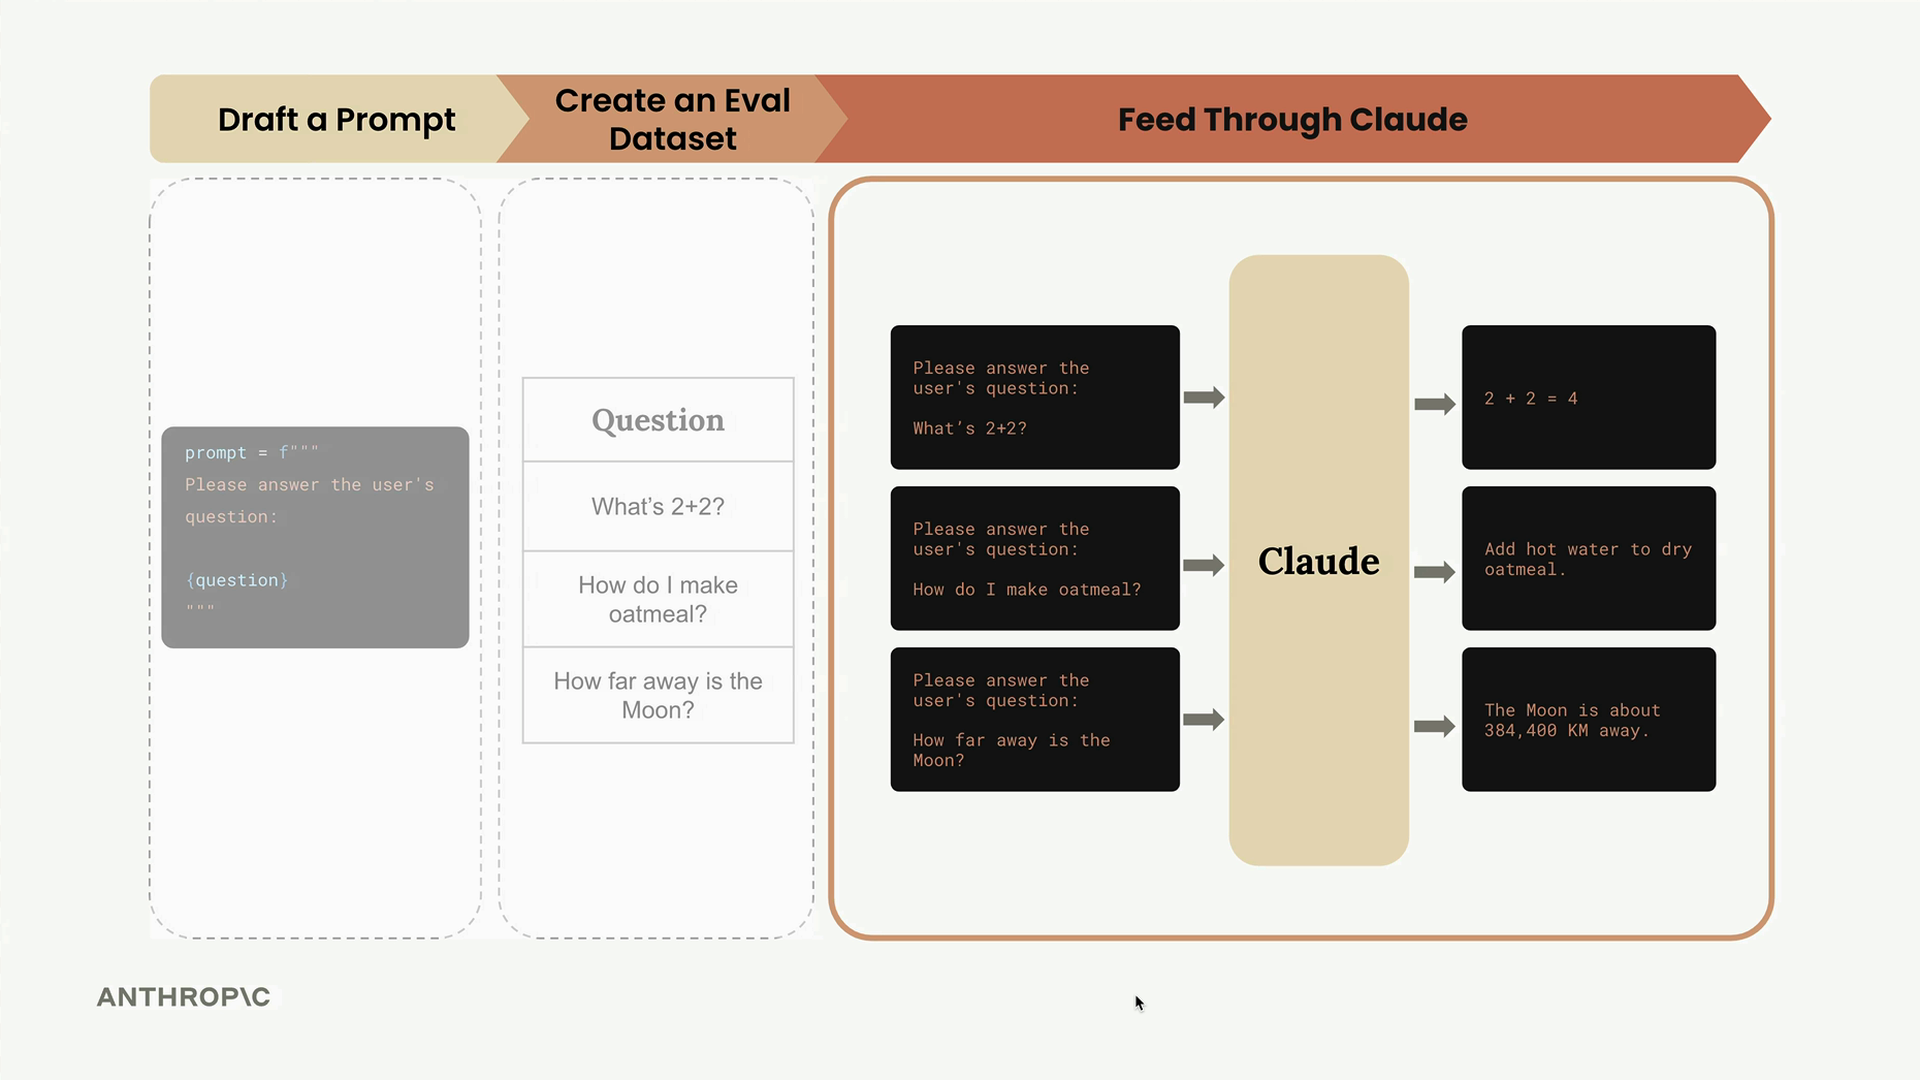
每个结果包含三个关键信息:
- output:来自Claude的完整响应
- test_case:被处理的原始测试用例
- score:评估分数(目前是硬编码的)
正如您在输出中看到的,由于我们还没有提供具体的格式化指令,Claude生成的回复相当冗长。这正是我们在完善提示时需要解决的问题。
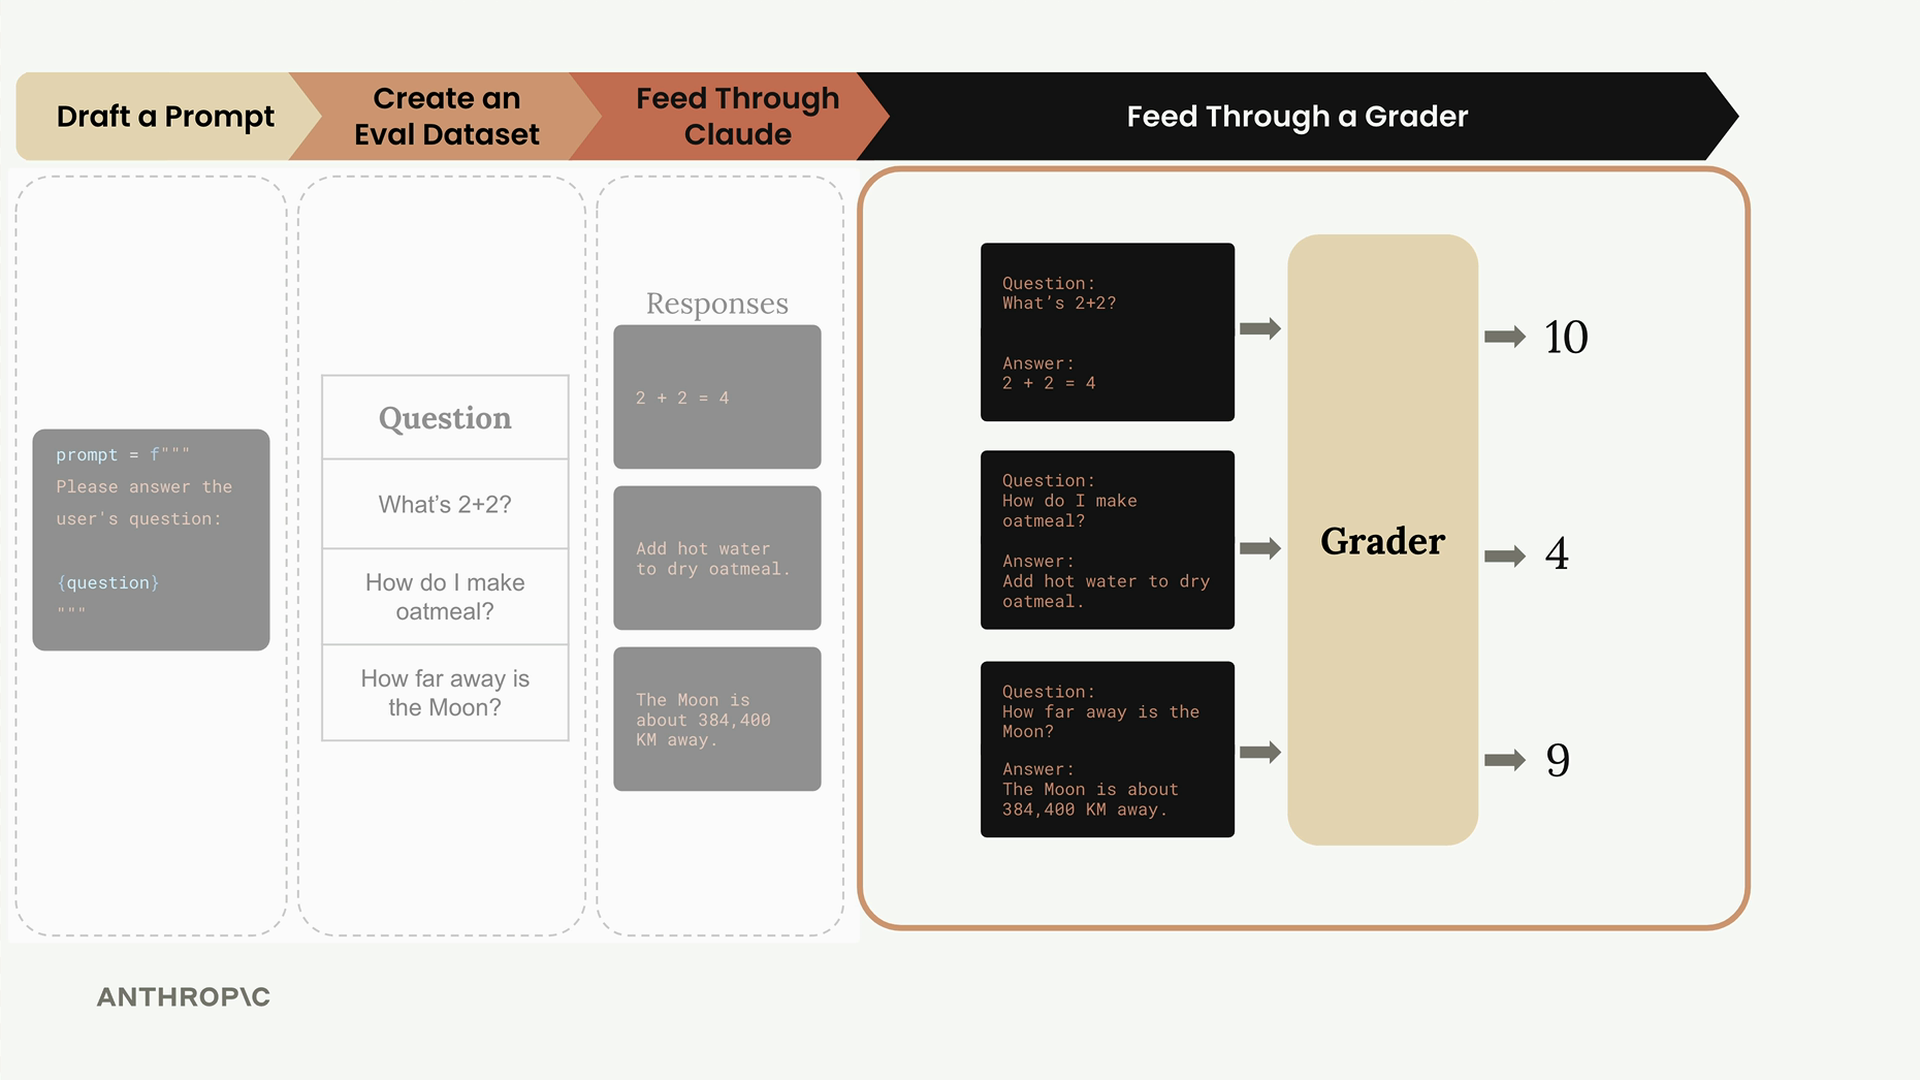
我们已经完成的工作
至此,我们已经成功构建了核心评估流水线。我们可以获取数据集,将其通过Claude处理,并收集结构化的结果。主要缺失的部分是评分系统——那个硬编码的10分需要被实际的评估逻辑所取代。
这个流水线代表了大多数AI评估系统的基础。虽然它看起来很简单,但您刚刚构建出了一个评估流水线实际功能的大部分内容。复杂性体现在细节中——更好的提示、更精细的评分,以及性能优化。
接下来,我们将深入探讨评分器这一关键主题,它将把我们硬编码的分数转变为对Claude表现的有意义的评估。