当您在 Claude 中将工具使用与流式传输结合起来时,您可以在 AI 生成工具参数时获得实时更新。这创造了更具响应性的用户体验,但关于其背后的工作原理,有一些重要细节需要理解。
基本工具流式传输
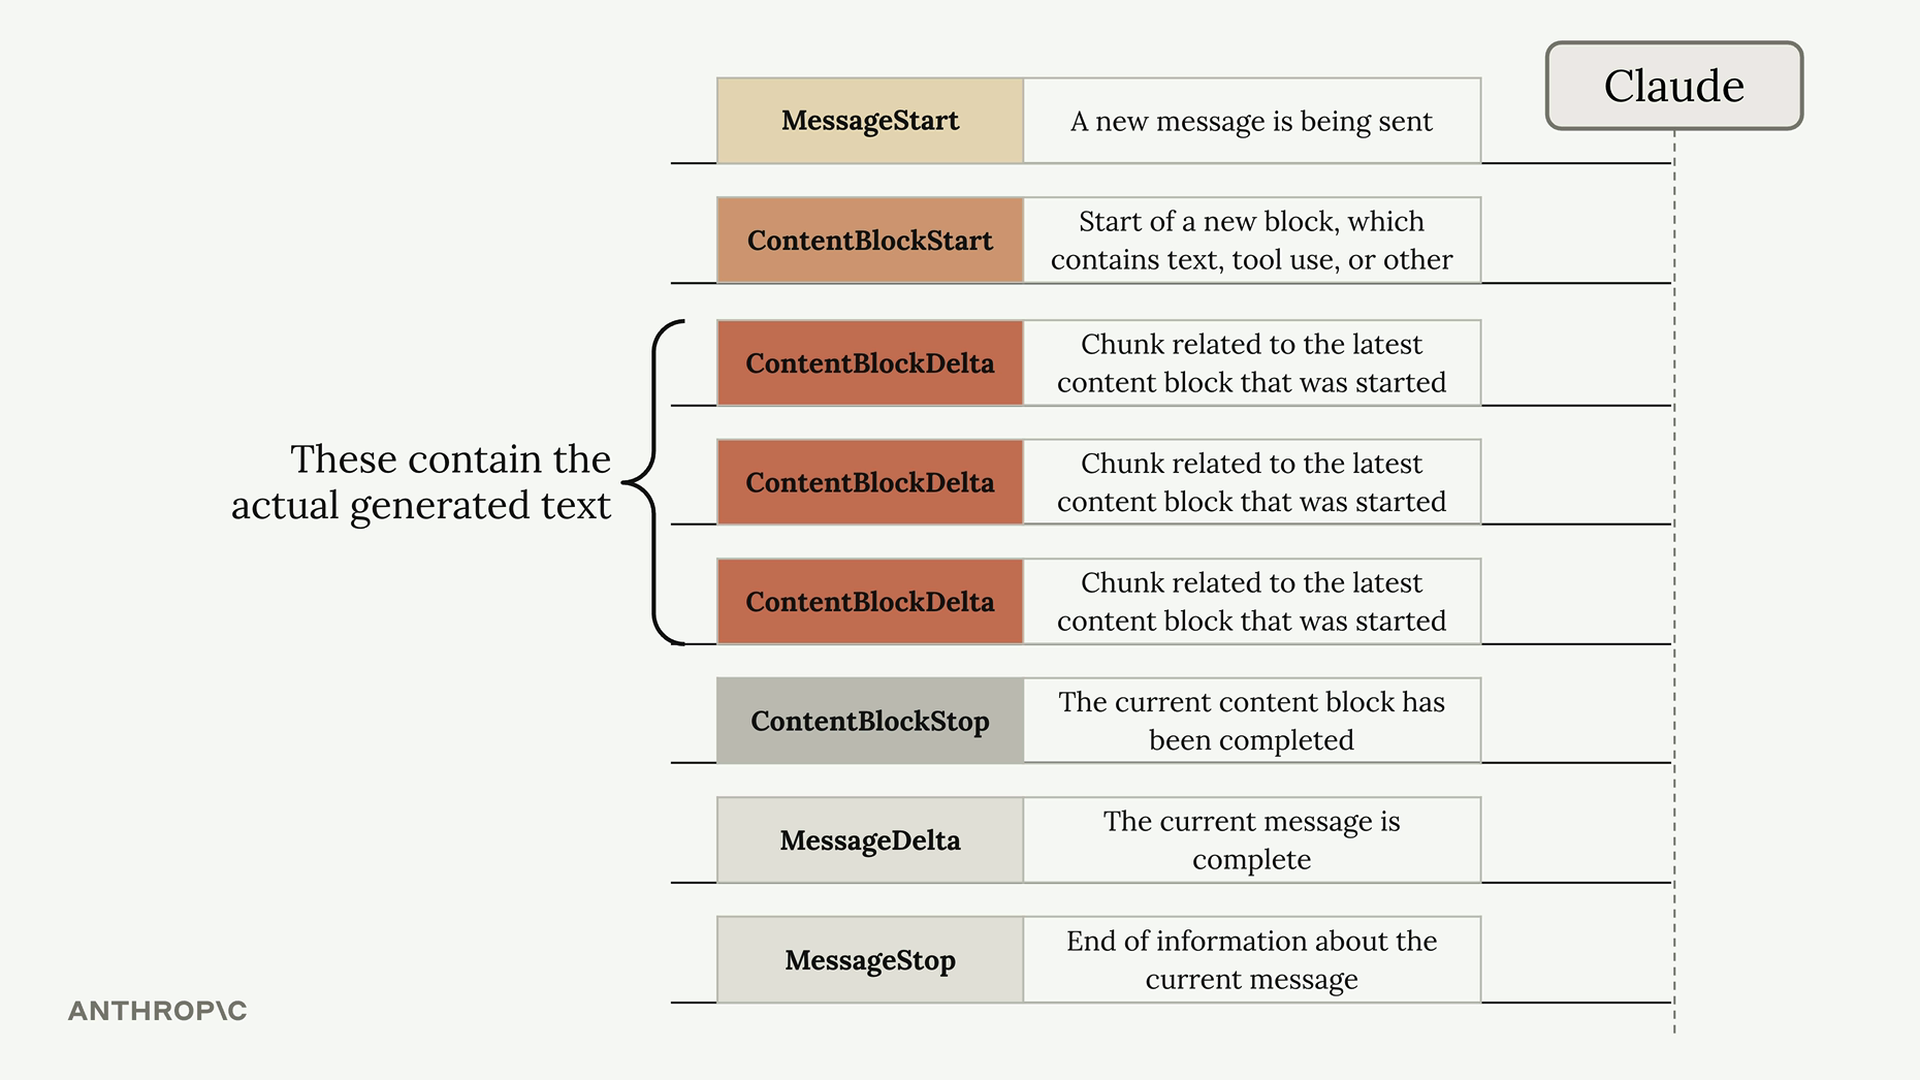
启用流式传输后,Claude 在处理您的请求时会发送不同类型的事件。您已经熟悉了用于常规文本生成的事件,比如 ContentBlockDelta。对于工具使用,您还需要处理一种名为 InputJsonEvent 的新事件类型。
每个 InputJsonEvent 包含两个关键属性:
- partial_json - 表示工具参数一部分的 JSON 块
- snapshot - 从目前为止收到的所有块累积构建的 JSON
以下是您在流式传输管道中处理这些事件的方式:
for chunk in stream:
    if chunk.type == "input_json":
        # 处理部分 JSON 数据块
        print(chunk.partial_json)
        # 或使用目前为止完整的快照
        current_args = chunk.snapshot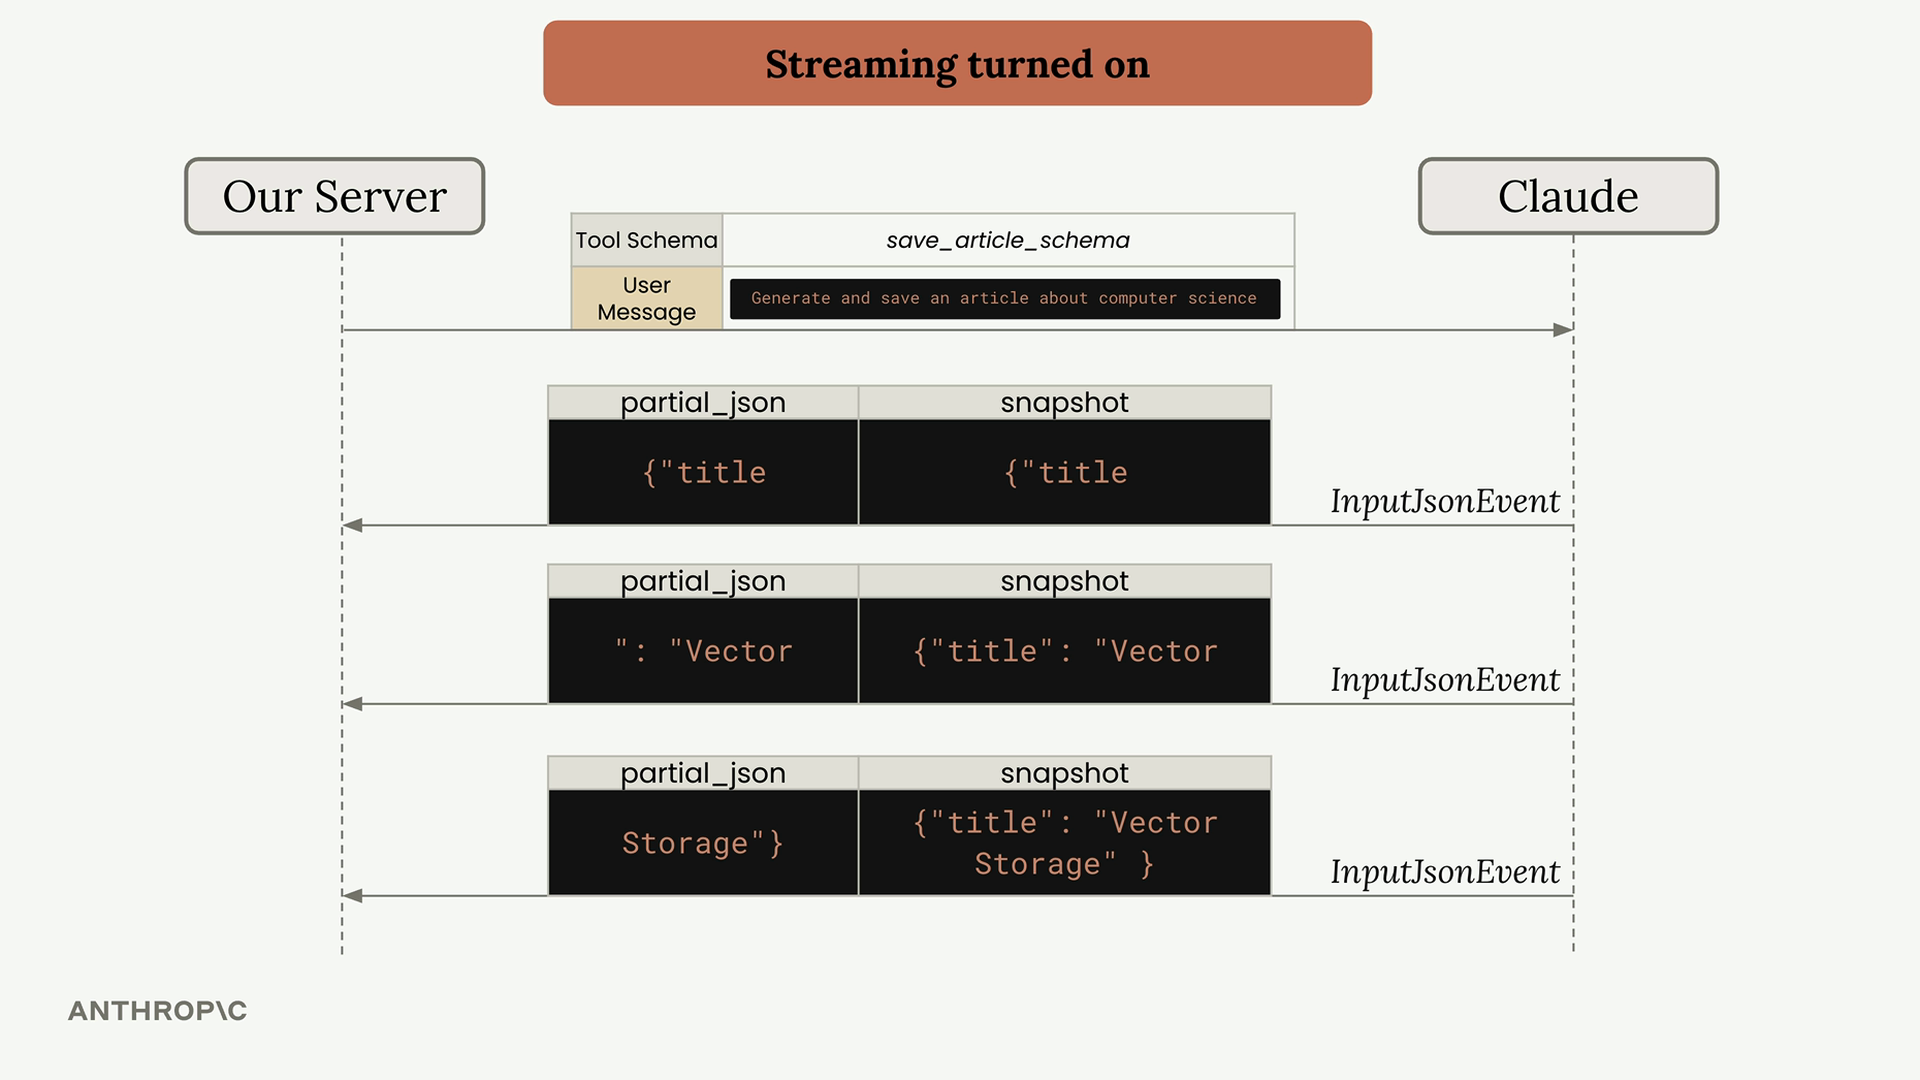
JSON 验证的工作原理
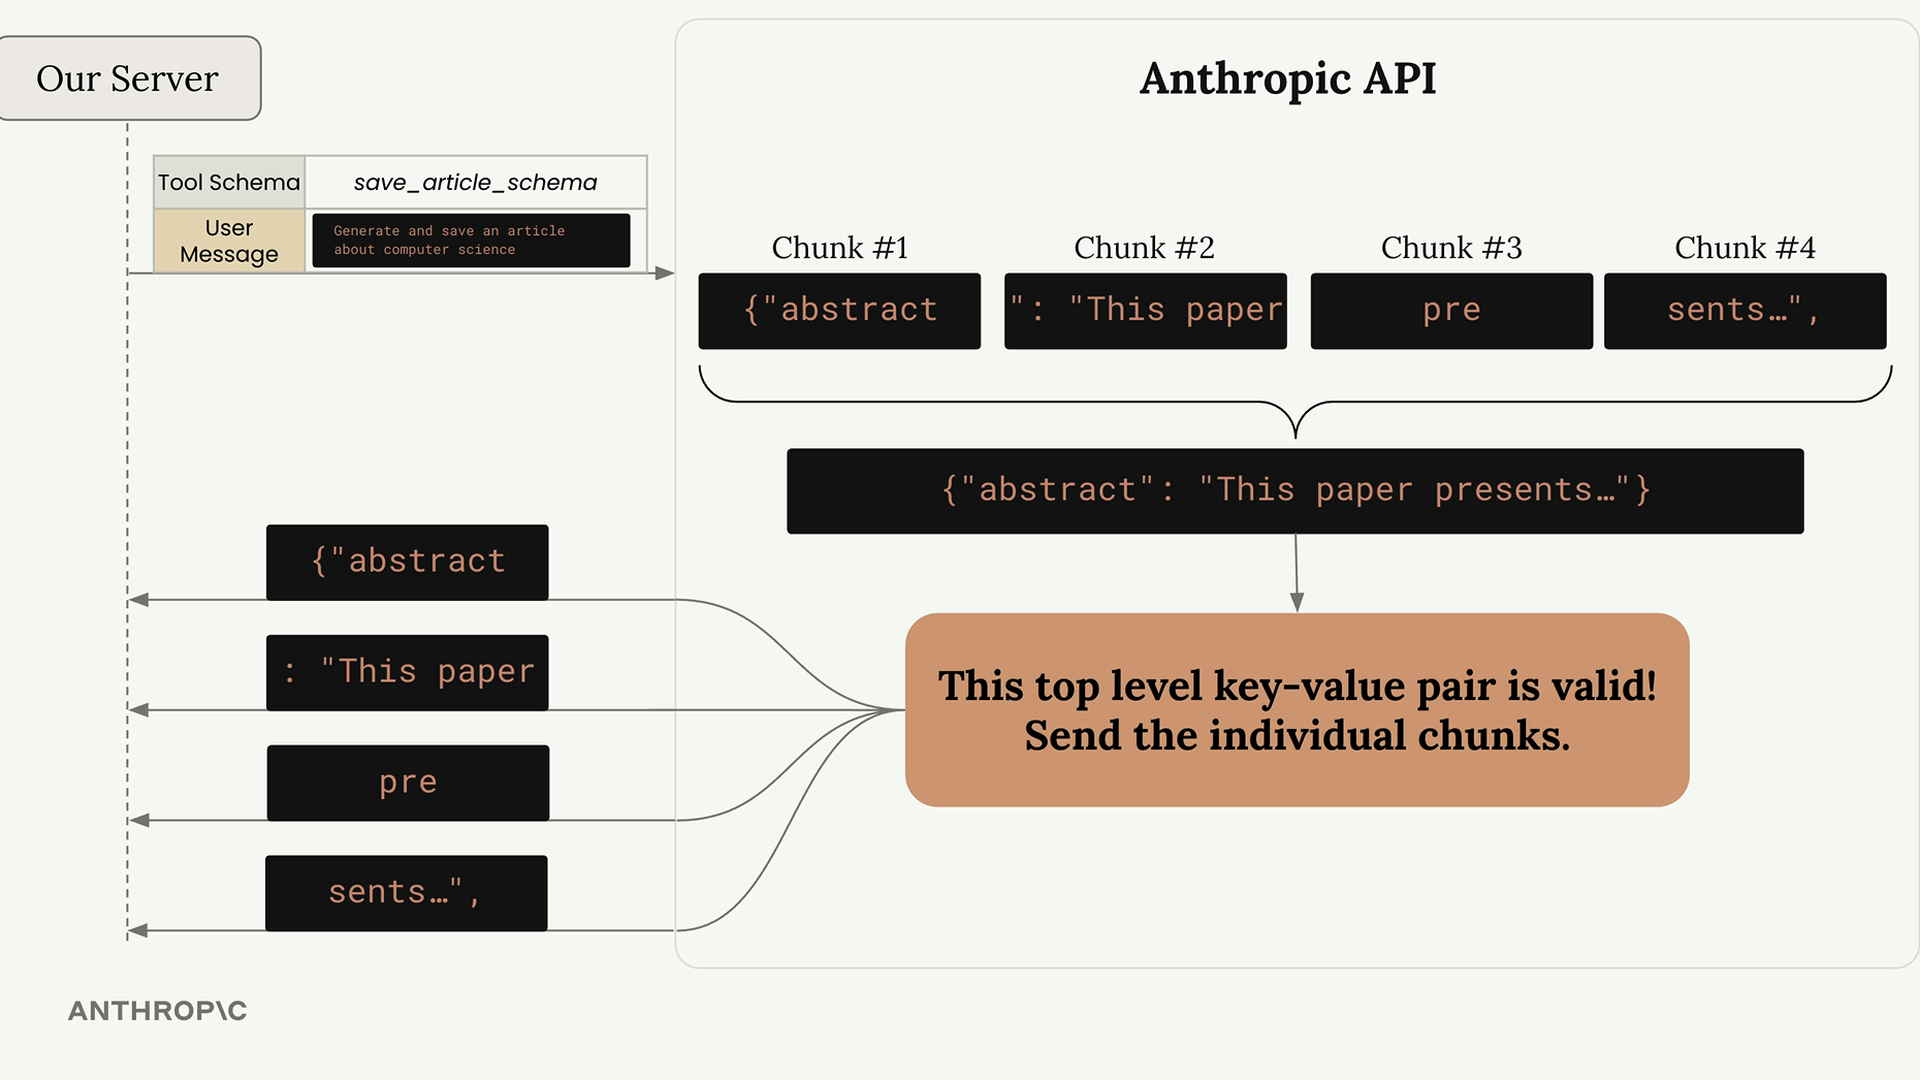
这正是有趣的地方。Anthropic API 不会在 Claude 生成每个块时立即将其发送给您。相反,它会先缓冲这些块并对其进行验证。
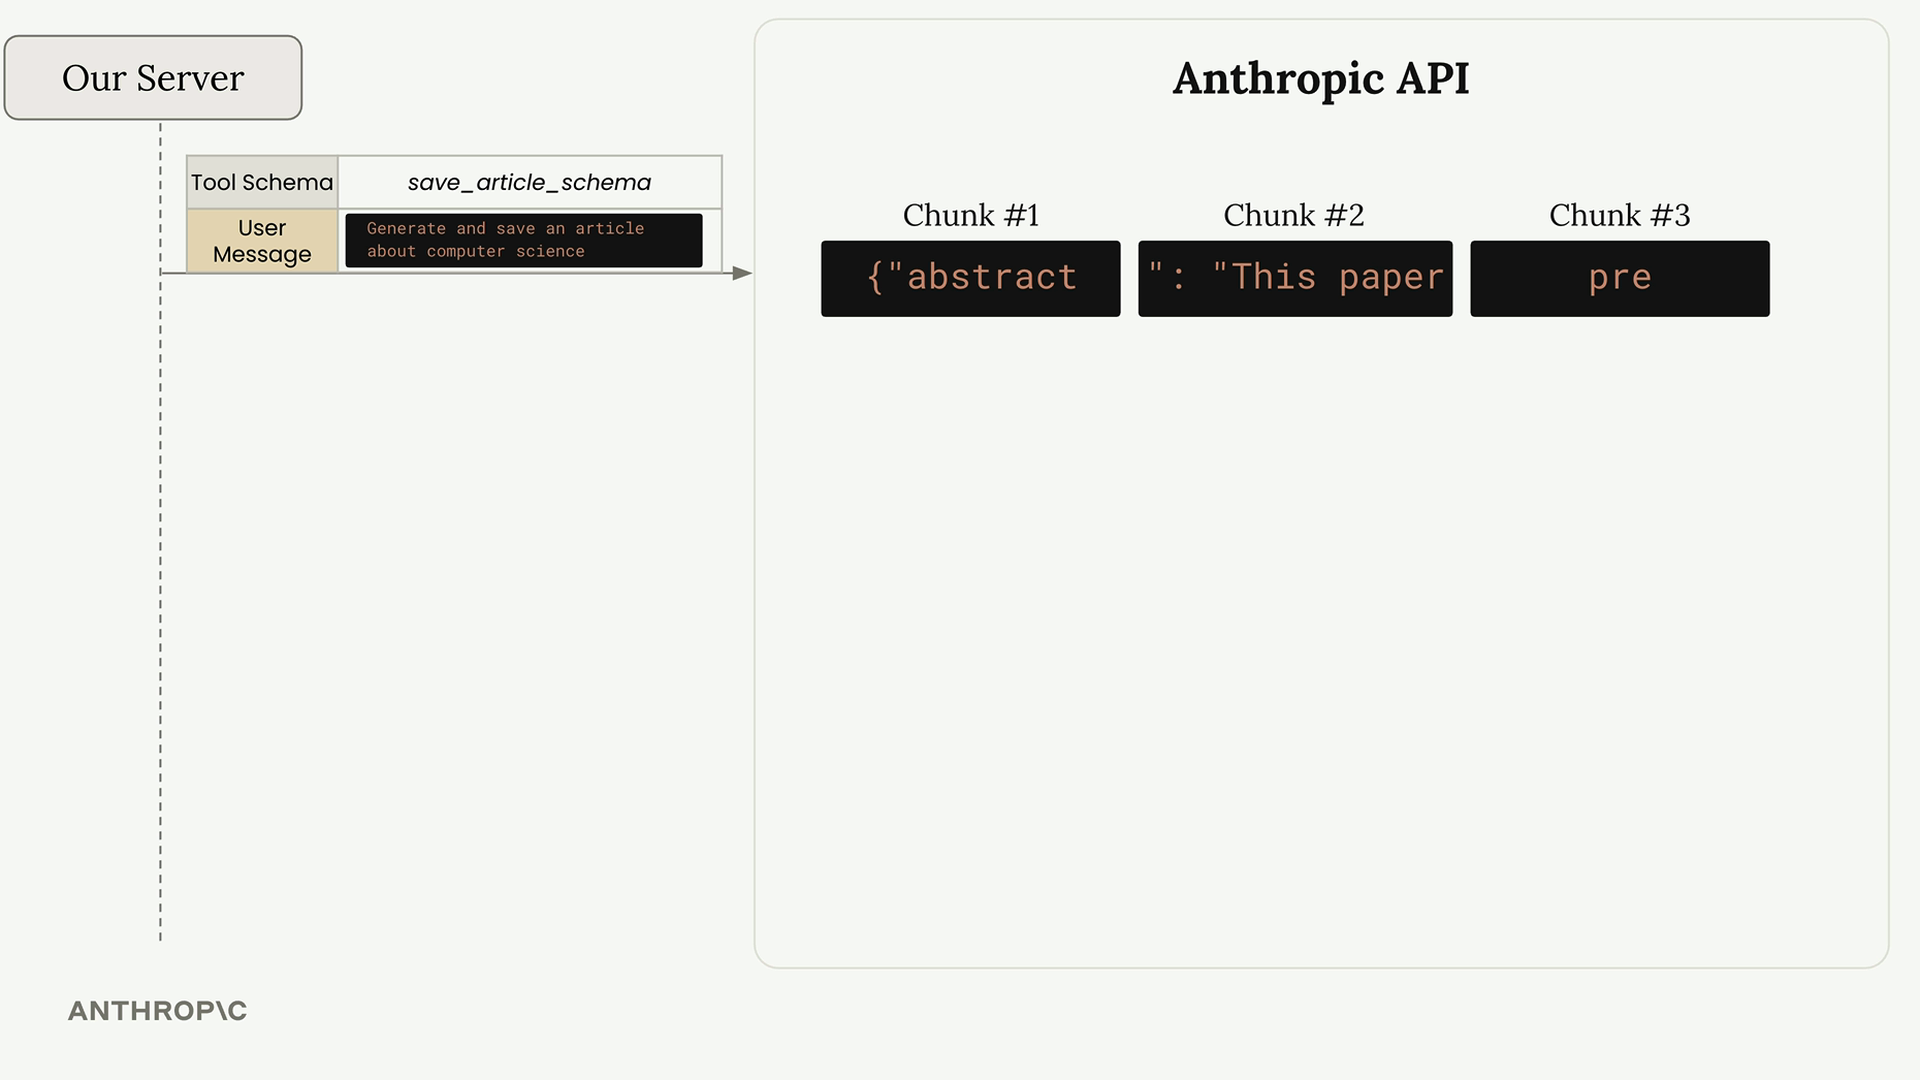
API 会等待完整的顶层键值对后才发送任何内容。例如,如果您的工具期望如下结构:
{
  "abstract": "This paper presents a novel...",
  "meta": {
    "word_count": 847,
    "review": "This paper introduces QuanNet..."
  }
}
API 将会:
- 等待整个
abstract值完成 - 对照您的 schema 验证该键值对
- 一次性发送
abstract的所有缓冲块 - 对
meta对象重复此过程
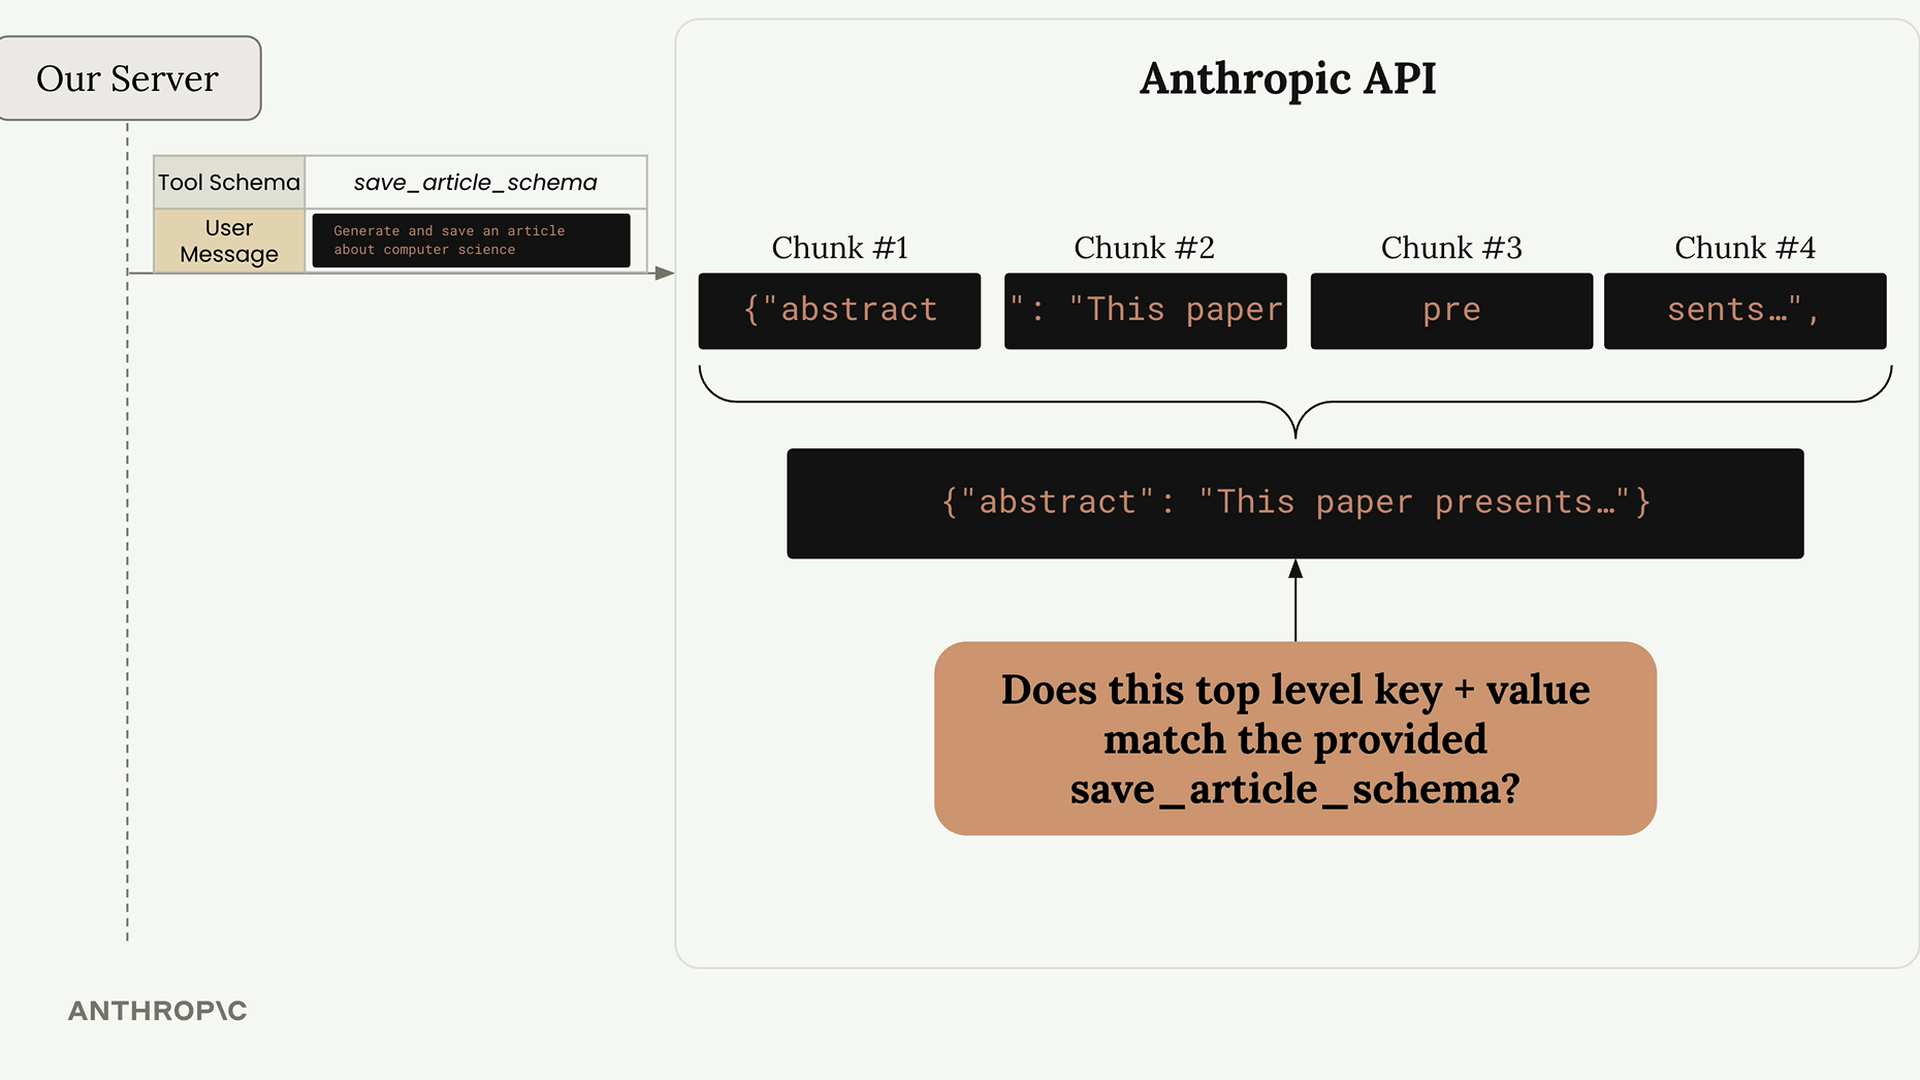
这个验证过程解释了为什么即使启用了流式传输,您看到的仍是延迟之后的一阵文本爆发。这些块会被一直保留,直到一个完整、有效的顶层键值对准备就绪。
细粒度工具调用
如果您需要更快、更细粒度的流式传输——也许是为了向用户展示即时更新或尽快开始处理部分结果——您可以启用细粒度工具调用。
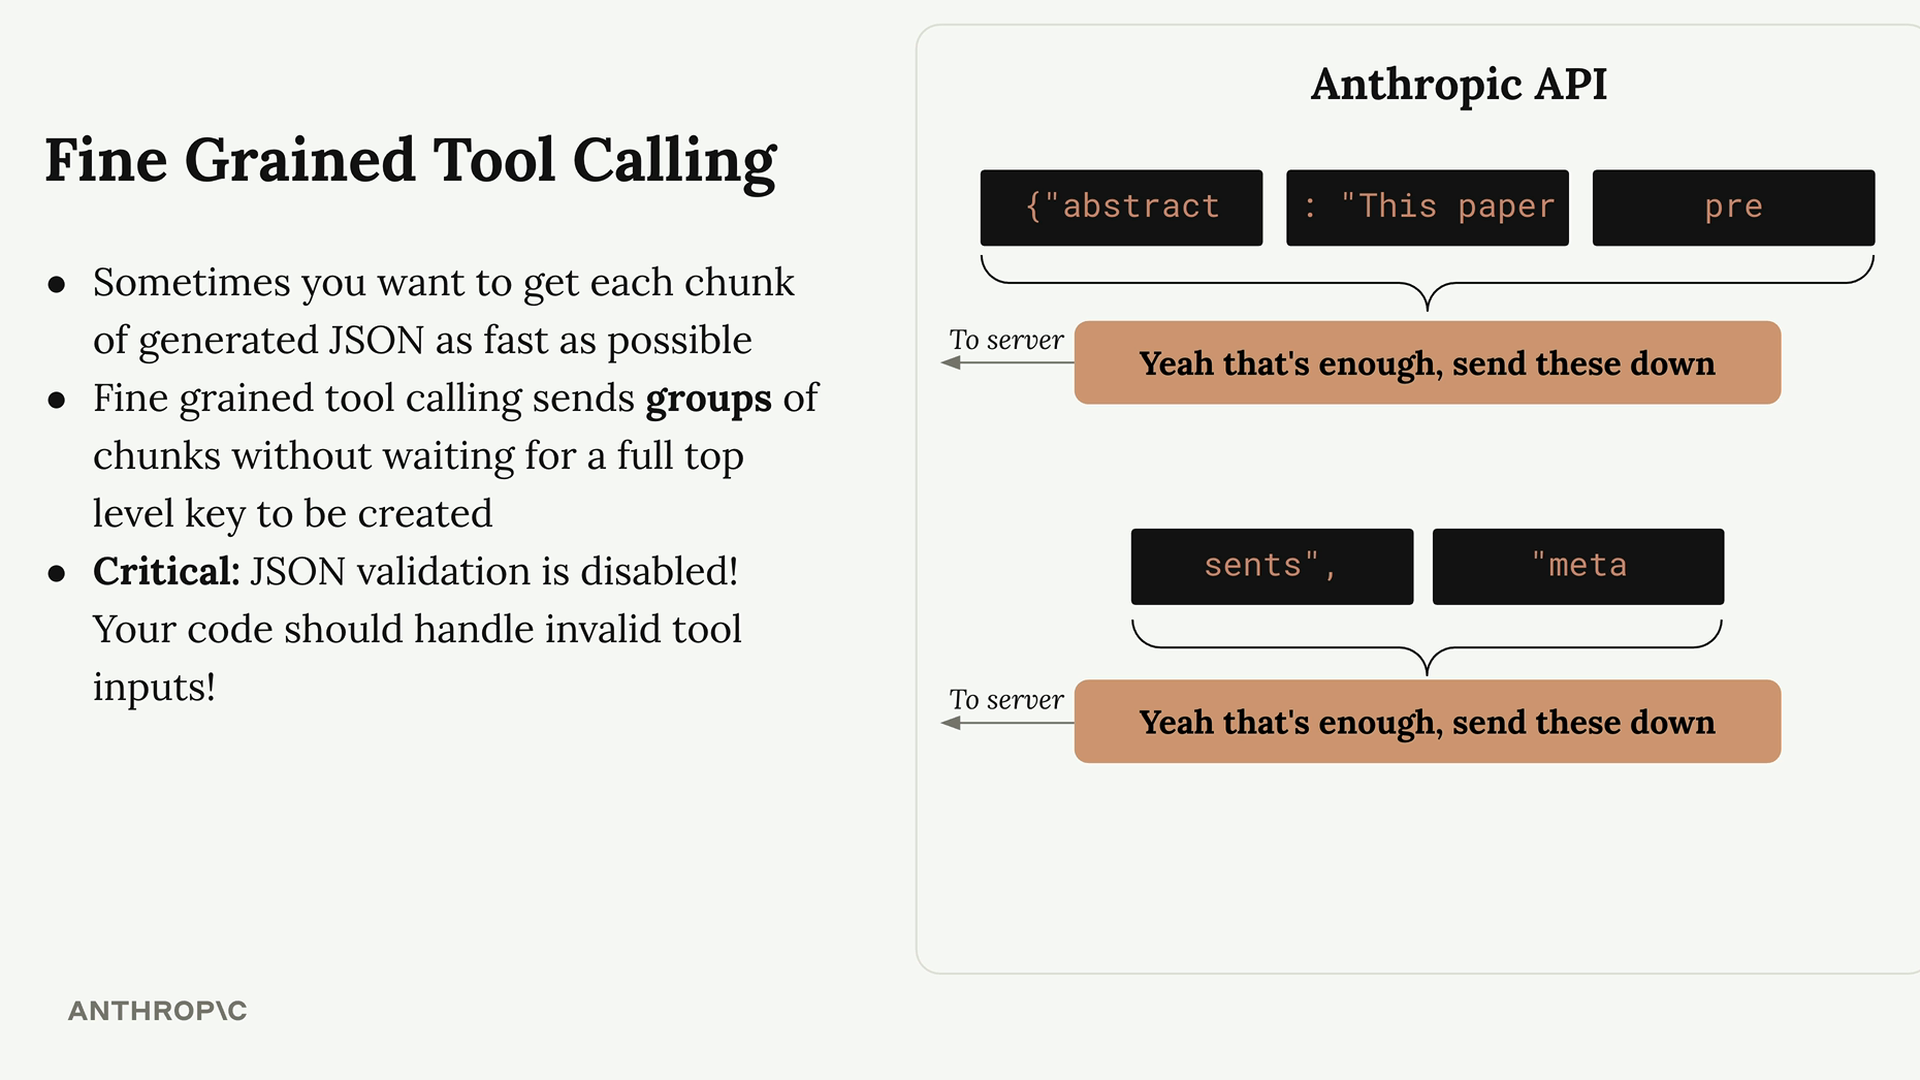
细粒度工具调用主要做一件事:它禁用了 API 端的 JSON 验证。这意味着:
- 您会在 Claude 生成块后立即收到它们
- 顶层键之间没有缓冲延迟
- 更传统的流式传输行为
- 关键点: JSON 验证被禁用——您的代码必须处理无效的 JSON
通过在工具上将 eager_input_streaming 设置为 True 来启用它:
run_conversation(
    messages,
    tools=[{**save_article_schema, "eager_input_streaming": True}]
)
启用细粒度工具调用后,您可能会在流中更早地收到 word_count 值,而无需等待整个 meta 对象完成。
处理无效的 JSON
在使用细粒度工具调用时,Claude 可能会生成无效的 JSON,例如 "word_count": undefined 而不是一个正确的数字。您的应用程序需要优雅地处理这些情况:
try:
    parsed_args = json.loads(chunk.snapshot)
except json.JSONDecodeError:
    # 适当处理无效的 JSON
    print("Received invalid JSON, continuing...")
如果不使用细粒度工具调用,API 的验证会捕获此错误,并可能将有问题的值包装在字符串中,这可能与您预期的 schema 不匹配。
何时使用细粒度工具调用
在以下情况下,请考虑启用细粒度工具调用:
- 您需要向用户展示工具参数生成的实时进度
- 您希望尽快开始处理部分工具结果
- 缓冲延迟对您的用户体验产生了负面影响
- 您愿意实现健壮的 JSON 错误处理
对于大多数应用程序而言,带有验证的默认行为已经完全够用。但当您需要那种额外的响应性时,细粒度工具调用能让您以 Claude 生成内容的最快速度获取数据块的控制权。