加载中
构建自定义提示评估工作流首先要创建一个可靠的提示,然后生成测试数据以查看其表现如何。让我们来看看如何为一个帮助用户编写 AWS 专用代码的提示设置评估系统。
设定目标
我们的提示需要协助用户针对 AWS 使用场景编写三种特定类型的输出:
- Python 代码
- JSON 配置文件
- 正则表达式
关键要求是,当用户请求协助完成某项任务时,我们要以这些格式之一返回干净的输出,不带任何额外的解释、页眉或页脚。
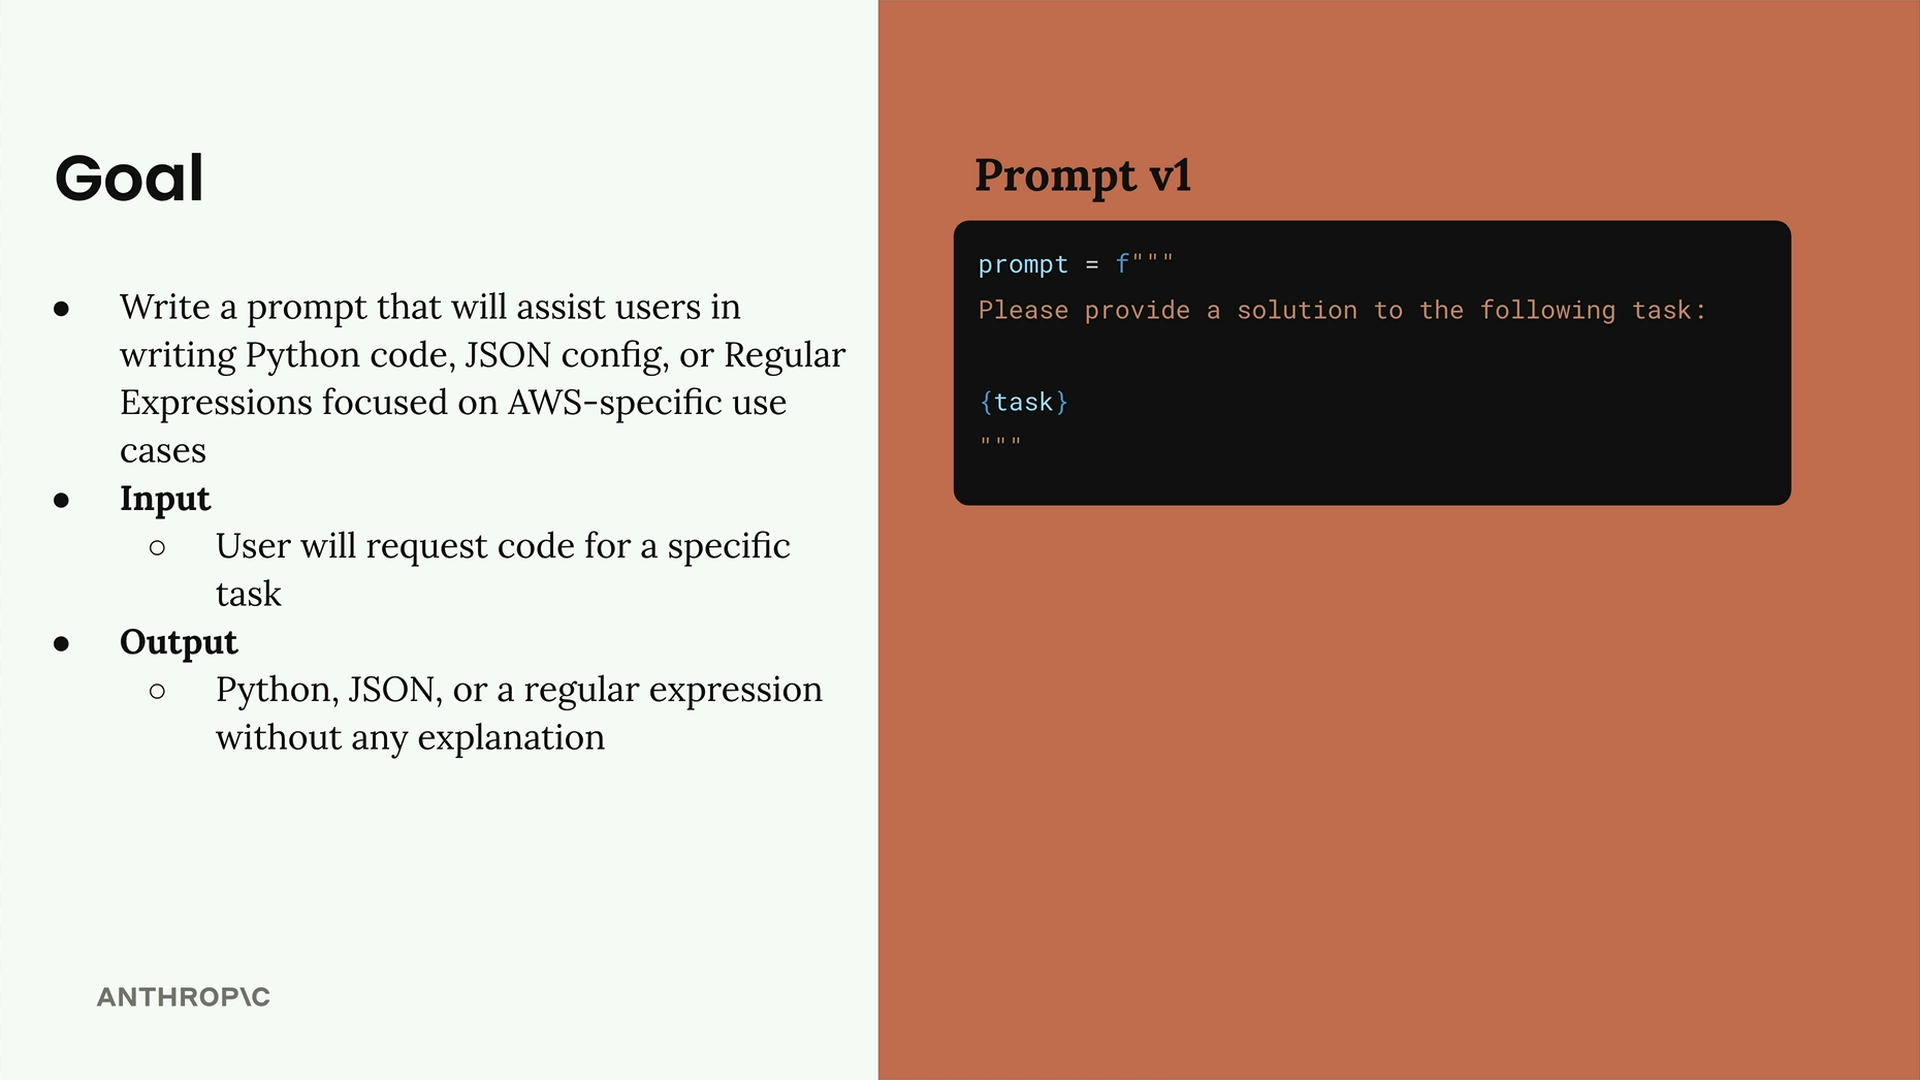
这是我们的初始提示(版本 1):
python
prompt = f"""
Please provide a solution to the following task:
{task}
"""
创建评估数据集
评估数据集包含将要输入到我们提示中的内容。对于每一种提示与输入的组合,我们都会运行该提示并分析结果。
我们的数据集将是一个 JSON 对象数组,其中每个对象都包含一个描述我们希望 Claude 完成的任务的 "task" 属性。我们既可以手动创建此数据集,也可以使用 Claude 自动生成。
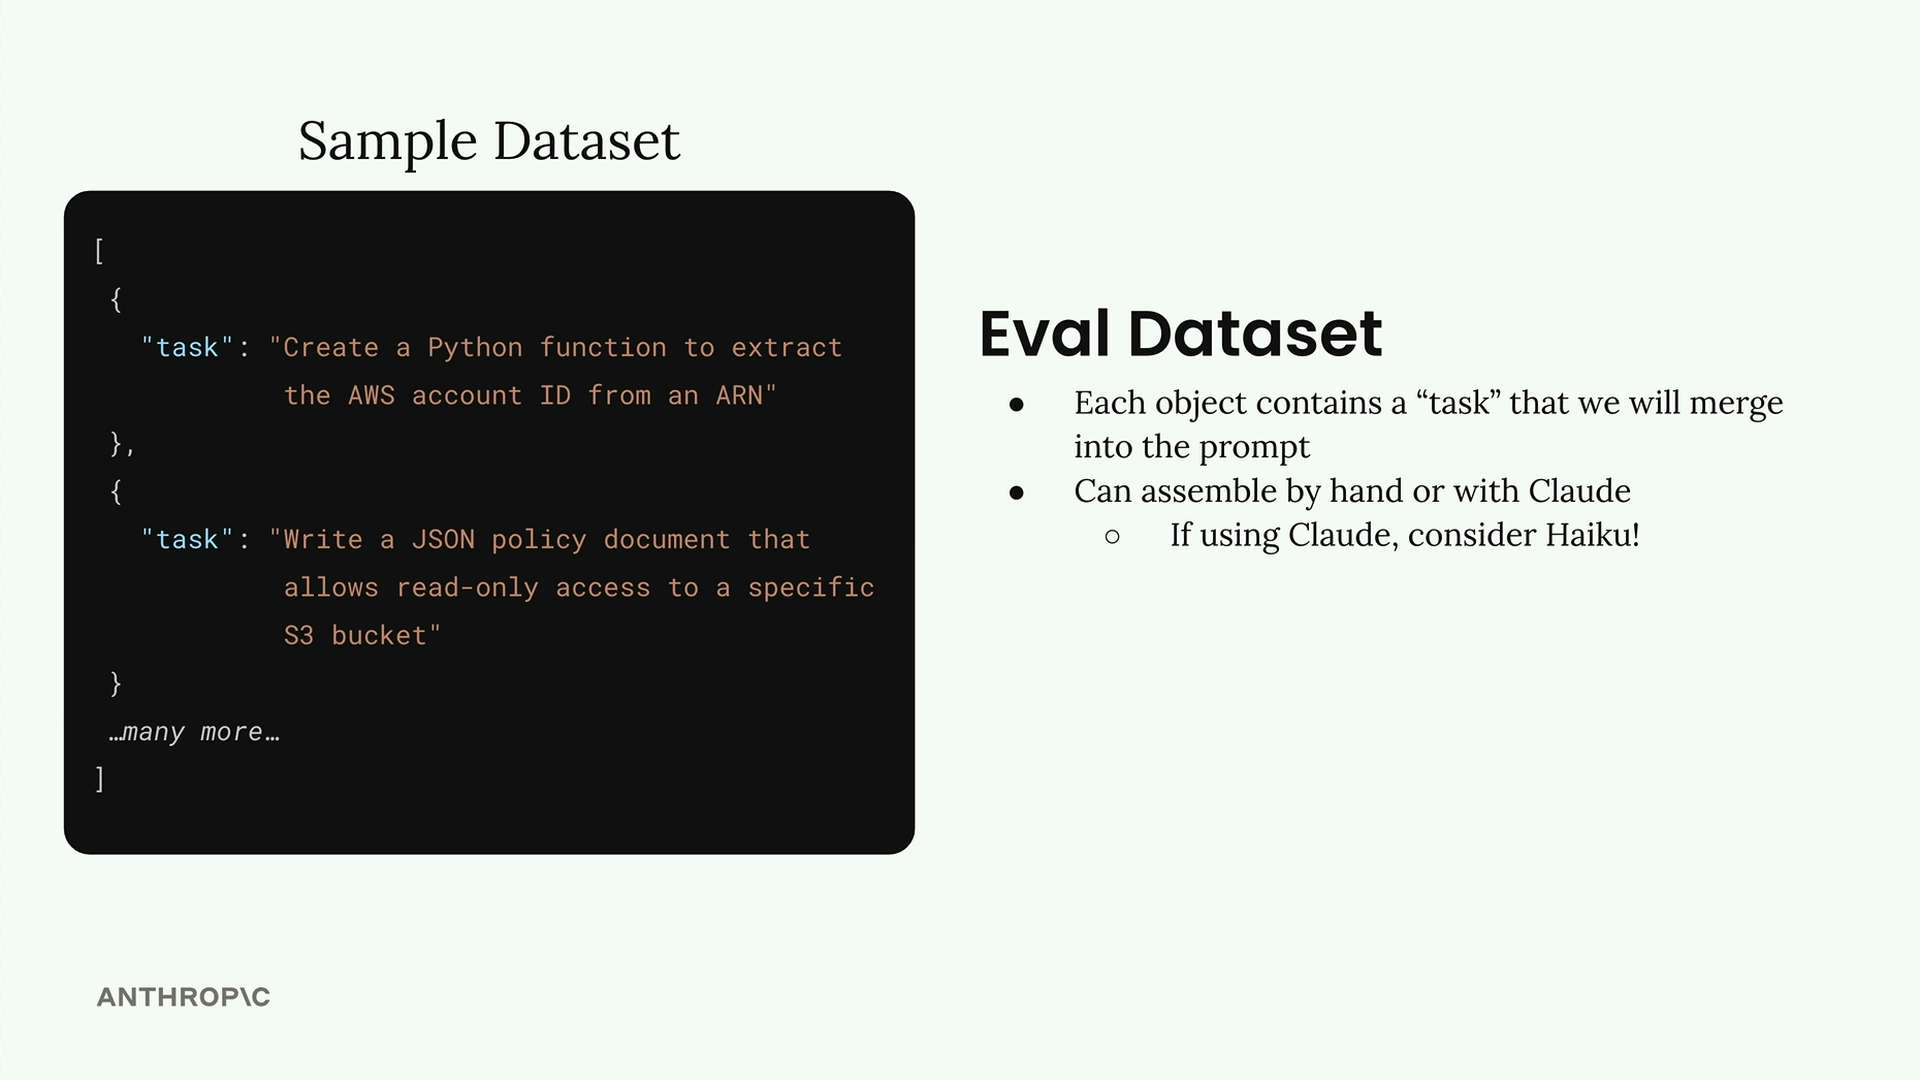
由于我们只是在生成测试数据,这正是使用像 Haiku 这样更快的模型而非完整 Claude 模型的绝佳机会。
使用代码生成测试数据
让我们创建一个能够自动生成测试数据集的函数。首先,我们需要一些用于调用 Claude 的辅助函数:
python
def add_user_message(messages, text):
    user_message = {"role": "user", "content": text}
    messages.append(user_message)

def add_assistant_message(messages, text):
    assistant_message = {"role": "assistant", "content": text}
    messages.append(assistant_message)

def chat(messages, system=None, temperature=1.0, stop_sequences=[]):
    params = {
        "model": model,
        "max_tokens": 1000,
        "messages": messages,
        "temperature": temperature
    }
    if system:
        params["system"] = system
    if stop_sequences:
        params["stop_sequences"] = stop_sequences

    response = client.messages.create(**params)
    return response.content[0].text
现在我们来创建数据集生成函数:
python
def generate_dataset():
    prompt = """
Generate an evaluation dataset for a prompt evaluation. The dataset will be used to evaluate prompts that generate Python, JSON, or Regex specifically for AWS-related tasks. Generate an array of JSON objects, each representing task that requires Python, JSON, or a Regex to complete.

Example output:
```json
[
  {
    "task": "Description of task",
  },
  ...additional
]
```

* Focus on tasks that can be solved by writing a single Python function, a single JSON object, or a single regex
* Focus on tasks that do not require writing much code

Please generate 3 objects.
"""
为了正确解析 JSON 响应,我们将使用预填充(prefilling)和停止序列(stop sequences):
python
    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
测试数据集生成
让我们运行这个函数,看看能得到什么样的测试用例:
python
dataset = generate_dataset()
print(dataset)
这应该会返回三个涵盖我们目标输出的不同测试用例——Python 函数、JSON 配置以及 AWS 专用任务的正则表达式。
保存数据集
一旦有了数据集,我们就将其保存到文件中,以便日后在评估时能够轻松加载:
python
with open('dataset.json', 'w') as f:
    json.dump(dataset, f, indent=2)
这会在与笔记本相同的目录中创建一个 dataset.json 文件,其中包含一份已准备好用于提示评估的任务列表。
有了这个基础,您现在就拥有了一种系统化的方法,可以生成测试数据来评估您的提示在不同类型的 AWS 相关编码任务中的表现如何。