我们已经为语义搜索(使用向量嵌入)和词法搜索(使用 BM25)构建了各自独立的实现。现在是时候将它们组合成一个统一的搜索管道,以充分利用两种方法的优势。
多索引架构
我们的 VectorIndex 和 BM25Index 类共享几乎相同的 API——它们都有 add_document() 和 search() 方法。这种一致性使我们可以很方便地将它们封装在一个名为 Retriever 的新类中。
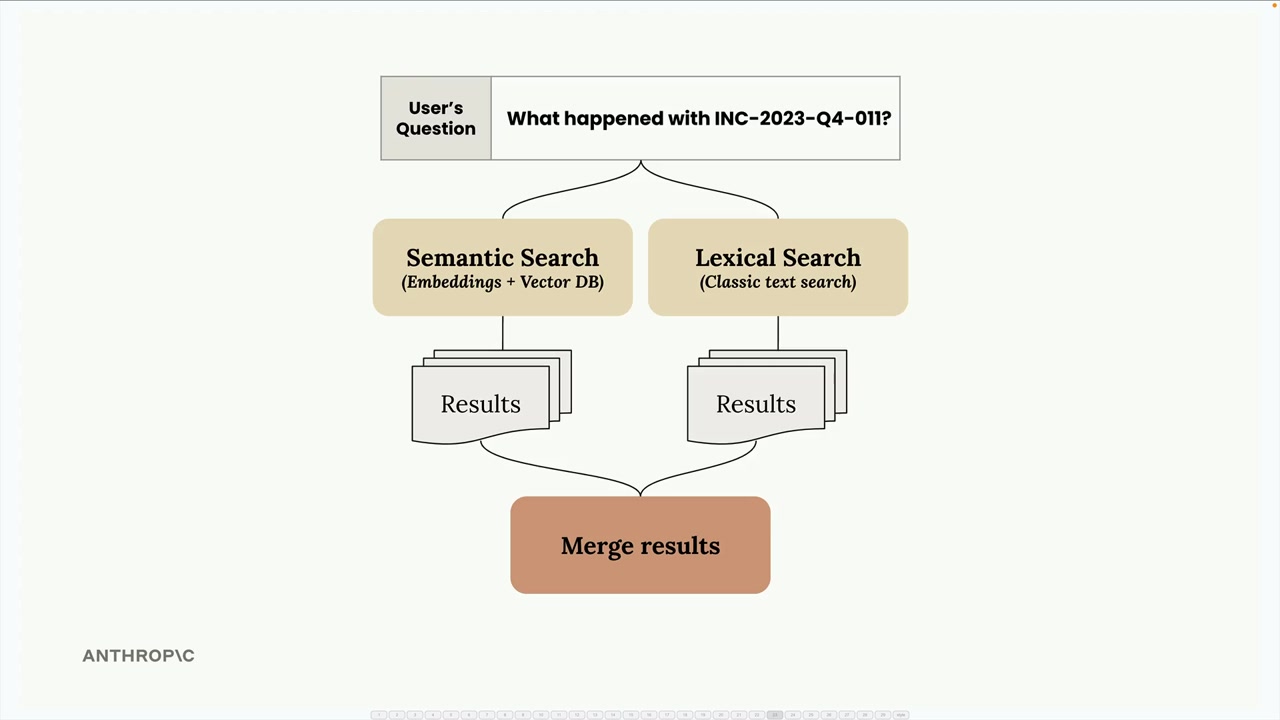
Retriever 充当协调器的角色,它将用户查询转发到两个索引,收集它们的结果,并使用一种称为倒数排名融合(reciprocal rank fusion)的技术将其合并。
理解倒数排名融合
合并来自不同搜索方法的结果并不像简单地将列表拼接在一起那么简单。每种方法使用不同的评分系统,因此我们需要一种方法来公平地归一化并组合它们的排名。
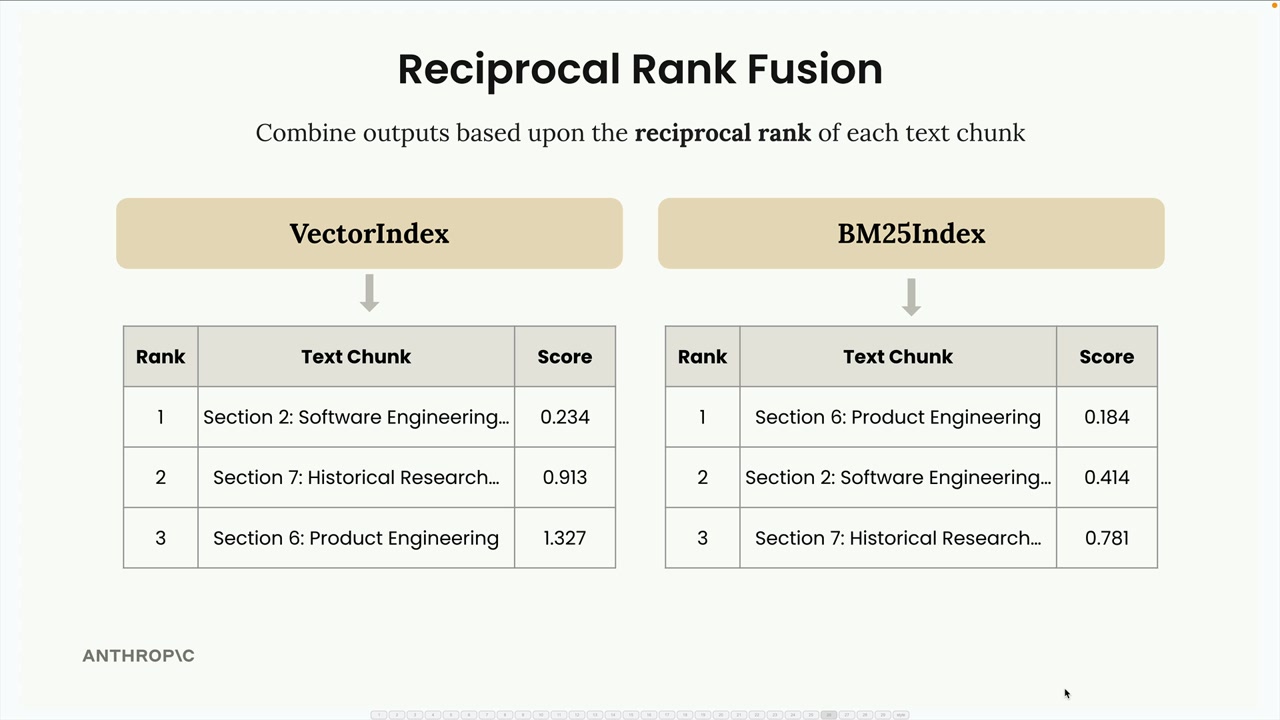
下面通过一个示例来说明倒数排名融合的工作原理。假设我们搜索有关"INC-2023-Q4-011"的信息,得到以下结果:
- VectorIndex 返回:第 2 节(排名 1)、第 7 节(排名 2)、第 6 节(排名 3)
- BM25Index 返回:第 6 节(排名 1)、第 2 节(排名 2)、第 7 节(排名 3)
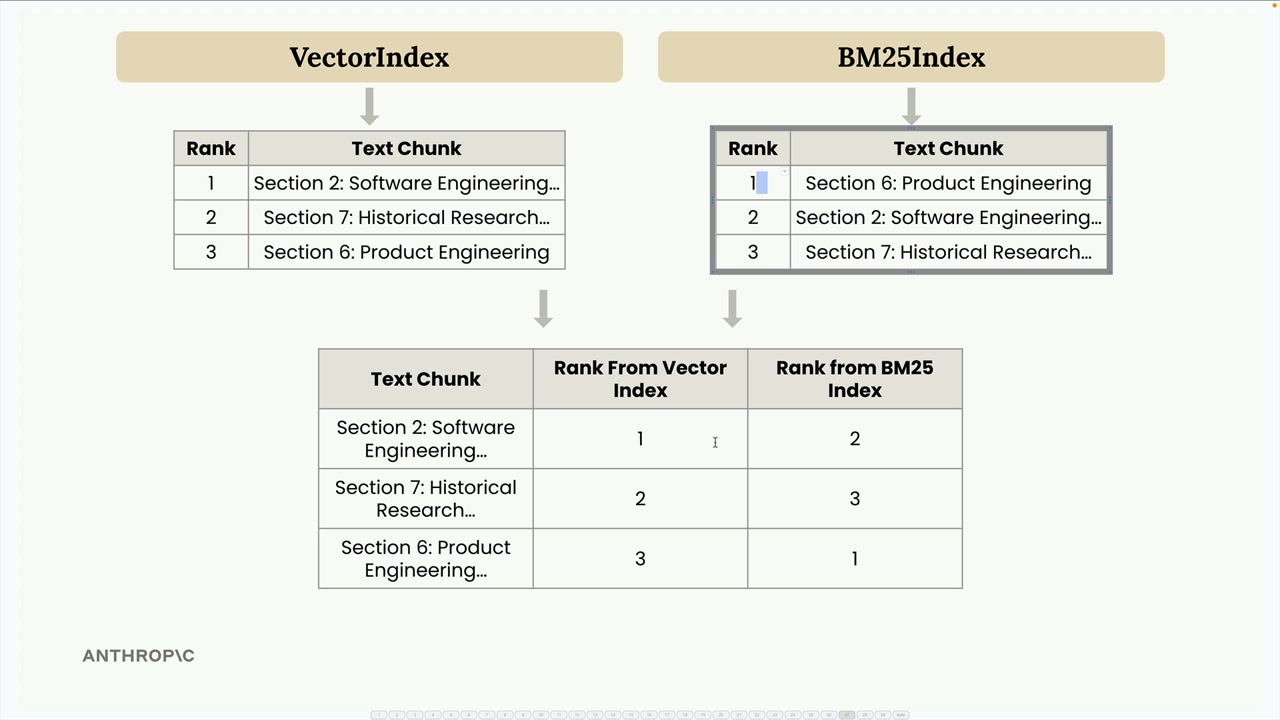
我们将这些结果合并到一张表中,显示每个文本块在两个索引中的排名,然后应用 RRF 公式:
RRF_score(d) = Σ(1 / (k + rank_i(d)))其中 k 是一个常数(通常为 60,但为了结果更清晰,我们将使用 1),rank_i(d) 是文档 d 在第 i 个排名列表中的排名。
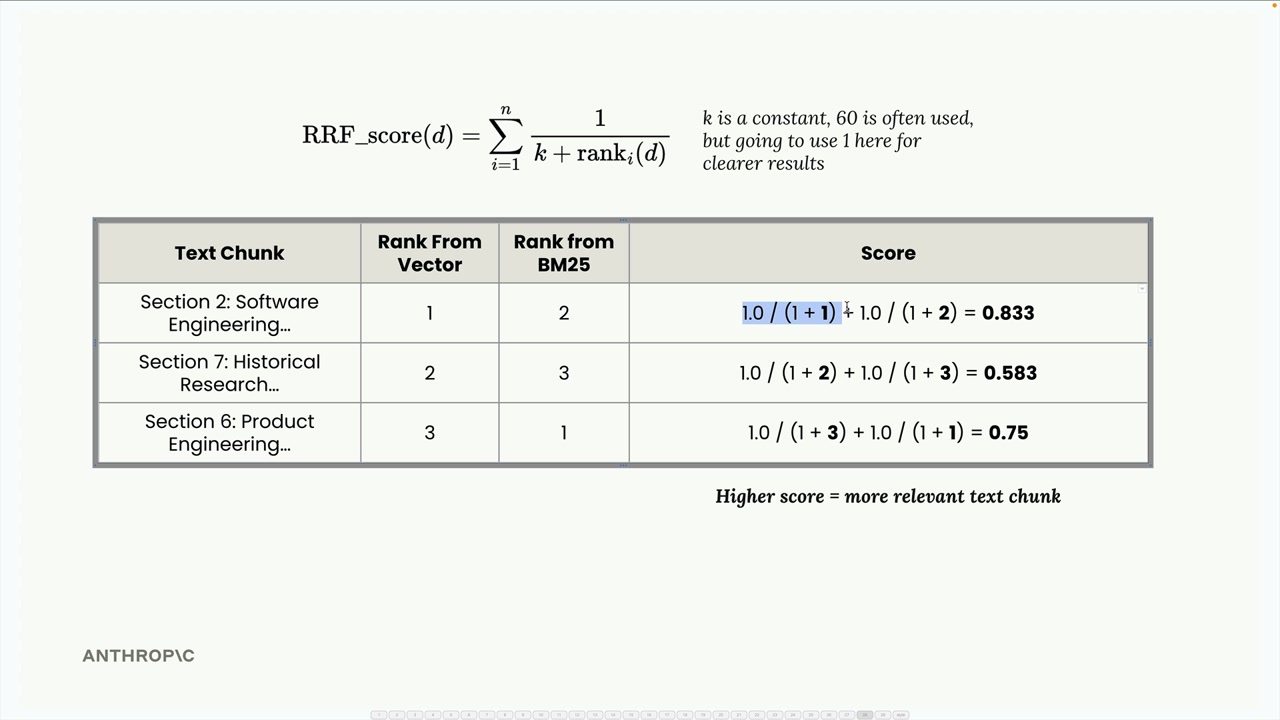
以我们的示例为例:
- 第 2 节:1.0/(1+1) + 1.0/(1+2) = 0.833
- 第 7 节:1.0/(1+2) + 1.0/(1+3) = 0.583
- 第 6 节:1.0/(1+3) + 1.0/(1+1) = 0.75
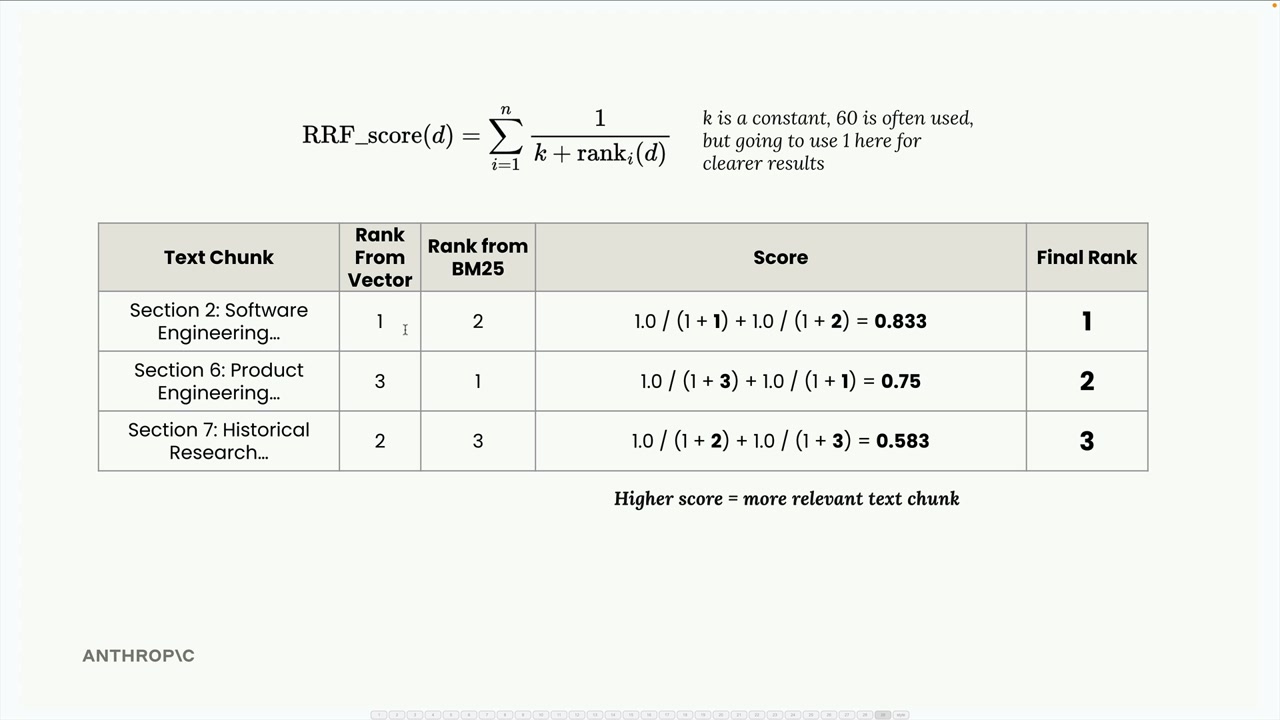
最终排名变为:第 2 节(0.833)、第 6 节(0.75)、第 7 节(0.583)。这在直觉上是合理的——第 2 节在两个索引中都表现良好,因此它排到了最前面。
实现细节
Retriever 类封装了多个搜索索引,并提供了统一的接口:
class Retriever:
    def __init__(self, *indexes: SearchIndex):
        if len(indexes) == 0:
            raise ValueError("At least one index must be provided")
        self._indexes = list(indexes)

    def add_document(self, document: Dict[str, Any]):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text: str, k: int = 1, k_rrf: int = 60):
        # 从所有索引中获取结果
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # 跨索引跟踪文档排名
                # 应用 RRF 评分公式
        # 返回合并并排序后的结果
关键的洞察在于,通过在不同的搜索实现之间维护一致的 API,我们可以轻松地将它们组合在一起,而不会产生紧耦合。
测试混合方法
还记得我们之前遇到的问题吗:当搜索"INC-2023-Q4-011 发生了什么?"时,仅使用向量方法返回了出乎意料的结果?网络安全事件(第 10 节)排在第一位,但财务分析(第 3 节)排在第二位,而不是更相关的软件工程章节。
使用我们的混合检索器,现在我们得到了更好的结果:
- 第 10 节:网络安全分析——事件响应报告(最相关)
- 第 2 节:软件工程——凤凰计划稳定性增强(第二相关)
- 第 5 节:法律动态(第三)
这表明,结合语义搜索和词法搜索可以克服单独使用任一方法的局限性。
可扩展性
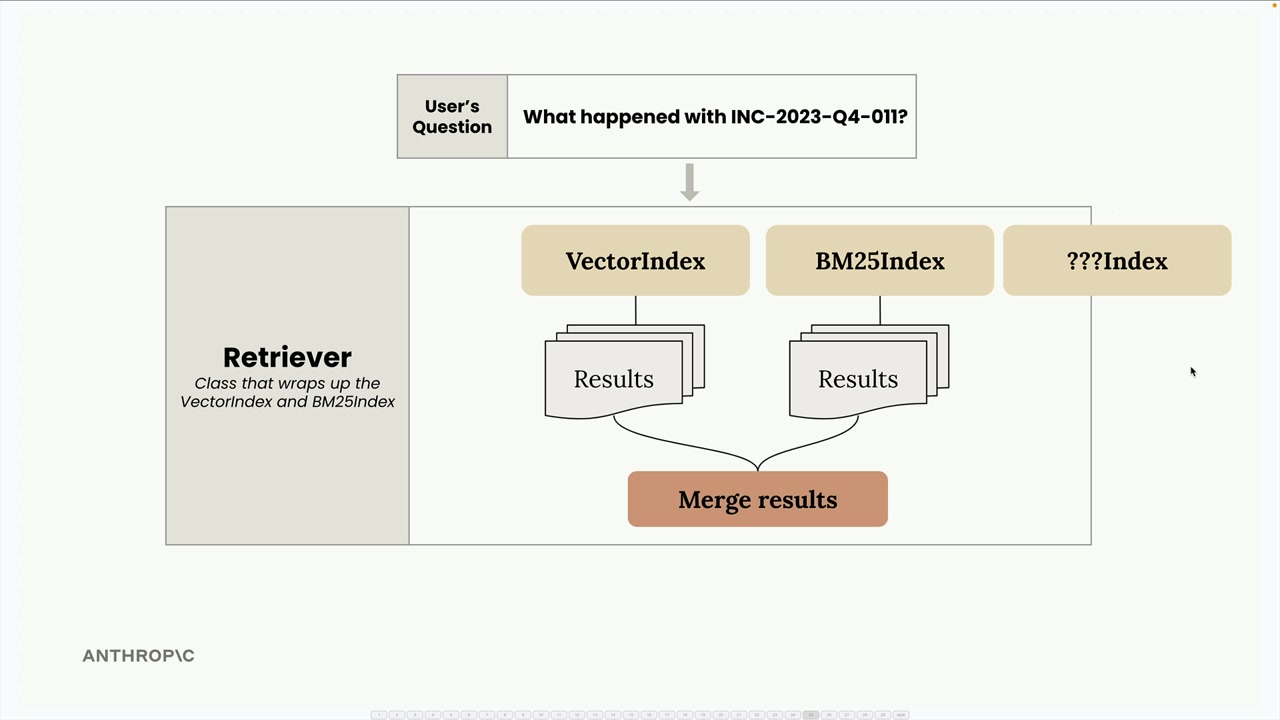
这种架构的妙处在于其可扩展性。由于所有索引都实现了相同的 SearchIndex 协议,具备 add_document() 和 search() 方法,您可以轻松添加新的搜索方法:
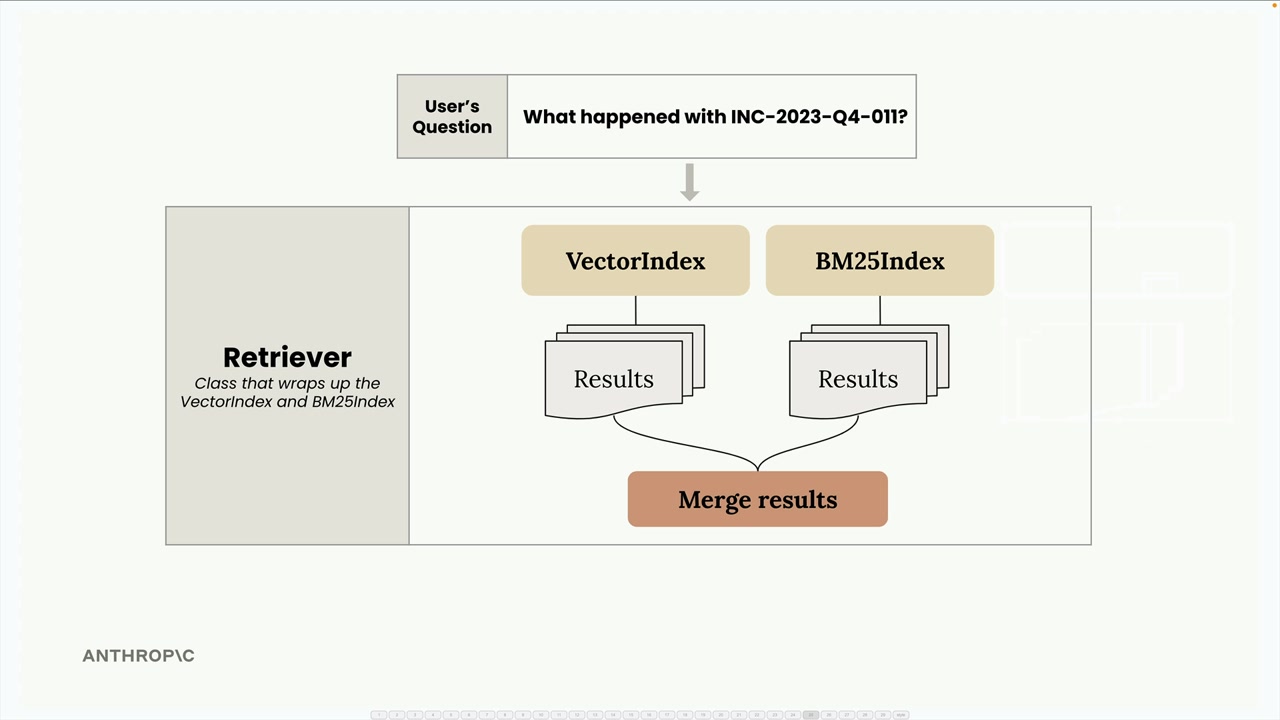
想添加基于关键词的索引?基于图的搜索?专门的领域索引?只需实现相同的接口,Retriever 就会自动将其纳入融合过程。
这种模块化方法使每个搜索实现都保持专注且易于测试,同时提供了一种干净的方式,在最终系统中组合它们各自的优势。