이제 RAG, 텍스트 청크화, 임베딩의 기본 개념을 다뤘으니, 전체 RAG 파이프라인을 단계별로 살펴보겠습니다. 이 예제를 통해 이러한 요소들이 어떻게 함께 작동하여 관련 정보를 검색하고 응답을 생성하는지 정확히 확인할 수 있습니다.
1단계: 원본 텍스트 청크화하기
먼저, 원본 문서를 가져와 관리하기 쉬운 청크로 나눕니다. 이 예제에서는 두 개의 간단한 텍스트 섹션을 사용하겠습니다:
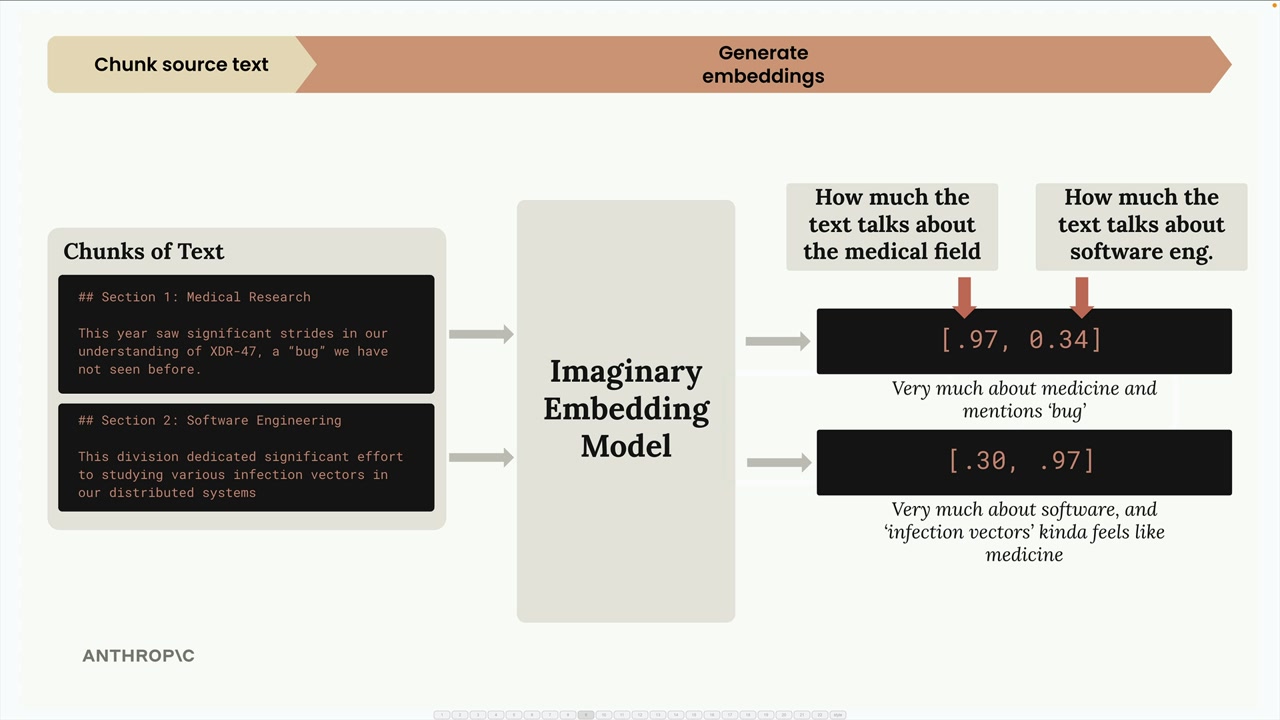
- 섹션 1: 의학 연구 - "올해는 우리가 이전에 본 적 없는 '버그'인 XDR-47에 대한 이해에서 중요한 진전이 있었습니다."
- 섹션 2: 소프트웨어 엔지니어링 - "이 부서는 분산 시스템에서 다양한 감염 경로(infection vectors)를 연구하는 데 상당한 노력을 기울였습니다"
2단계: 임베딩 생성하기
다음으로, 임베딩 모델을 사용하여 각 텍스트 청크를 숫자 임베딩으로 변환합니다. 이를 쉽게 이해할 수 있도록, 항상 정확히 두 개의 숫자를 반환하는 완벽한 임베딩 모델이 있다고 가정하고, 각 숫자가 무엇을 의미하는지 알고 있다고 가정해 보겠습니다.
이 가상의 모델에서:
- 첫 번째 숫자는 텍스트가 의학 분야에 대해 얼마나 이야기하는지를 나타냅니다
- 두 번째 숫자는 텍스트가 소프트웨어 엔지니어링에 대해 얼마나 이야기하는지를 나타냅니다
의학 연구 섹션의 경우 [0.97, 0.34]를 얻을 수 있습니다 - 매우 의학 중심이지만 "버그"라는 단어로 인해 소프트웨어적 요소도 일부 포함됩니다. 소프트웨어 엔지니어링 섹션의 경우 [0.30, 0.97]을 얻습니다 - 소프트웨어 중심이 강하지만 "감염 경로"로 인해 의학적 뉘앙스가 있습니다.
정규화(Normalization)
임베딩 API는 일반적으로 각 벡터의 크기를 1.0으로 조정하는 정규화 단계를 수행합니다. 여기서 수학적 계산에 대해 걱정할 필요는 없습니다 - 자동으로 처리됩니다. 이를 통해 [0.944, 0.331]과 [0.295, 0.955] 같은 정규화된 벡터를 얻습니다.
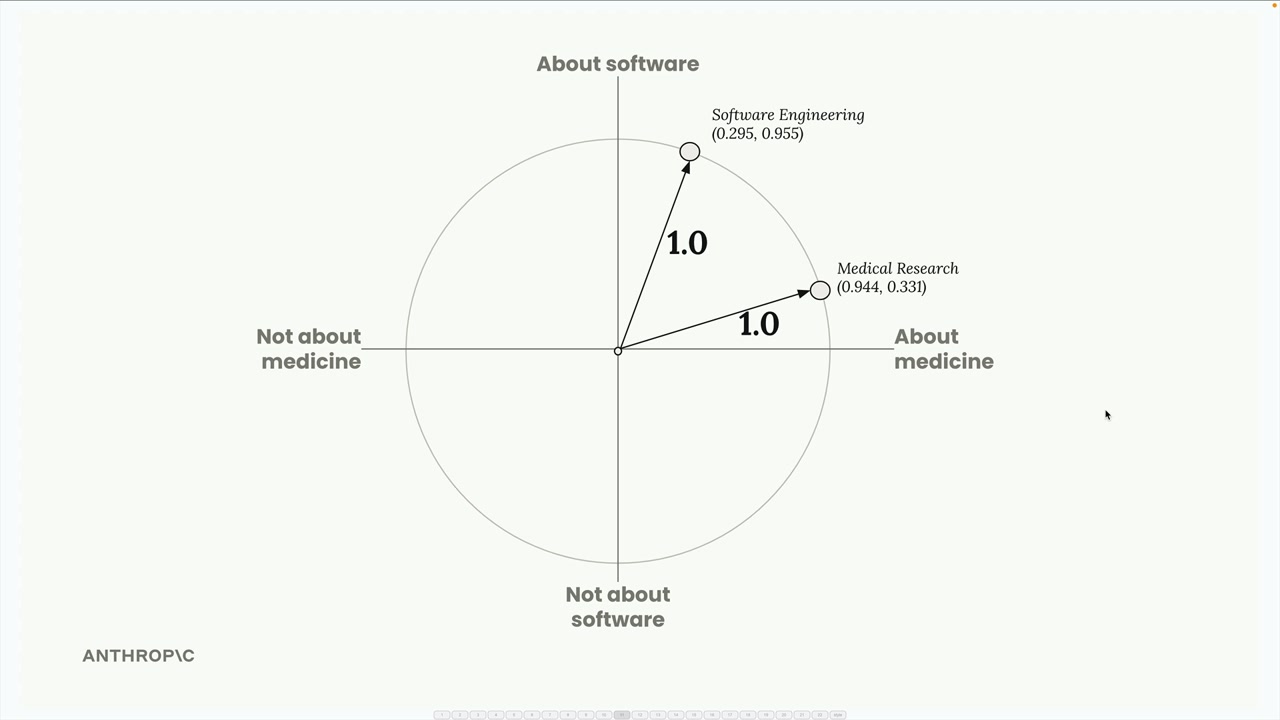
이러한 임베딩을 단위 원에서 시각화할 수 있으며, 각 점은 우리의 텍스트 청크 중 하나를 나타냅니다.
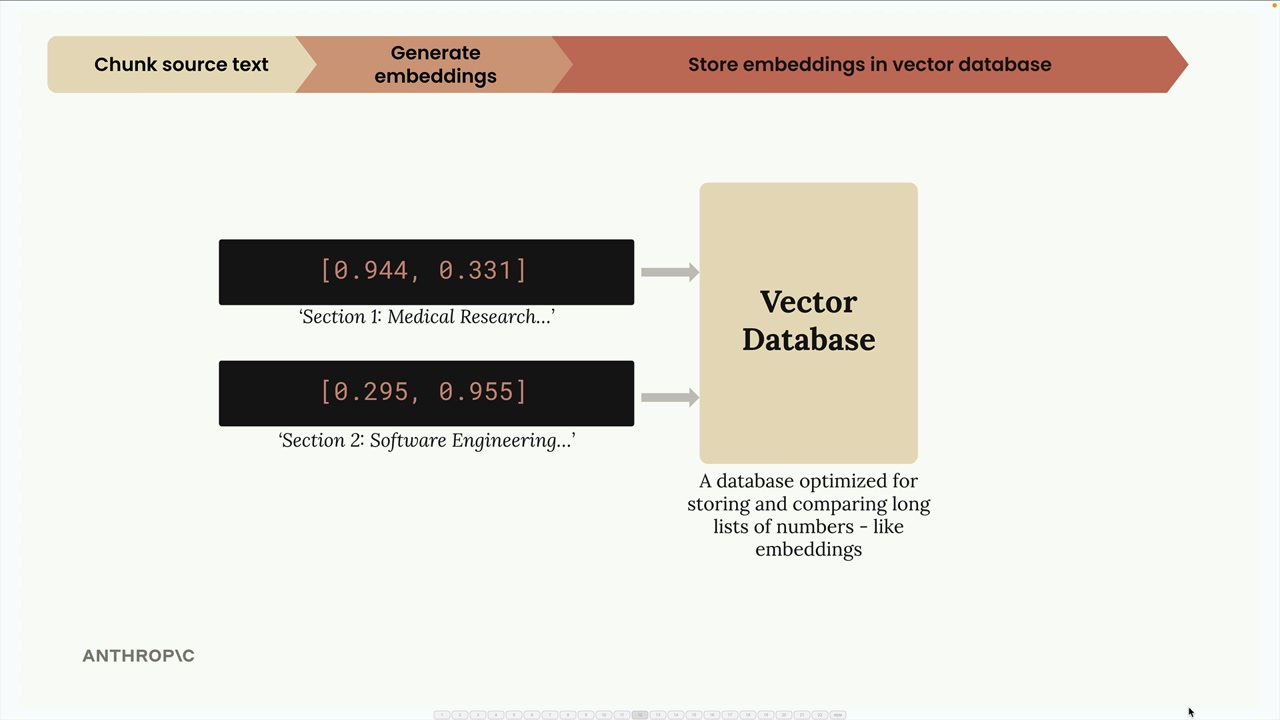
3단계: 벡터 데이터베이스에 저장하기
이러한 임베딩을 벡터 데이터베이스에 저장합니다 - 이는 우리의 임베딩과 같이 긴 숫자 목록을 저장, 비교, 검색하는 데 최적화된 특수한 데이터베이스입니다.
이 시점에서 잠시 멈춥니다. 지금까지의 모든 작업은 미리 이루어지는 전처리 과정이었습니다. 이제 사용자가 질의를 제출하기를 기다립니다.
4단계: 사용자 질의 처리하기
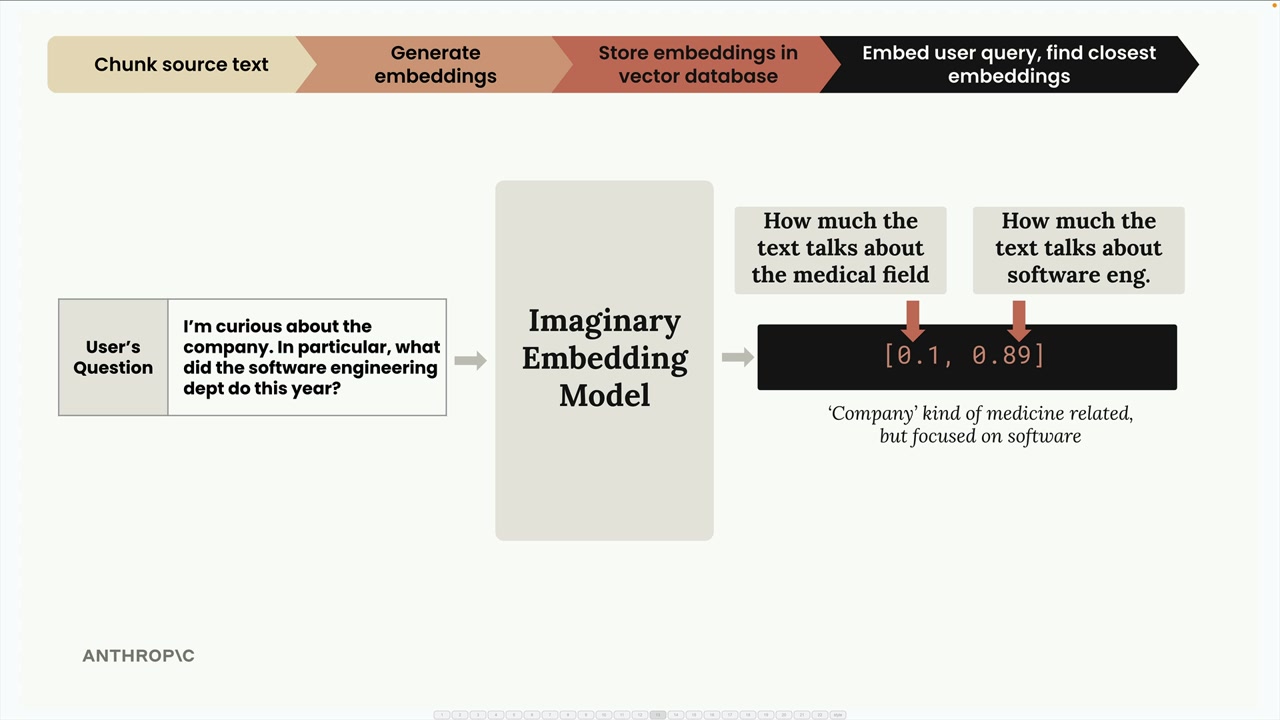
사용자가 "회사에 대해 궁금합니다. 특히 소프트웨어 엔지니어링 부서는 올해 무엇을 했나요?"와 같은 질문을 하면, 동일한 임베딩 모델을 통해 해당 질의를 처리합니다.
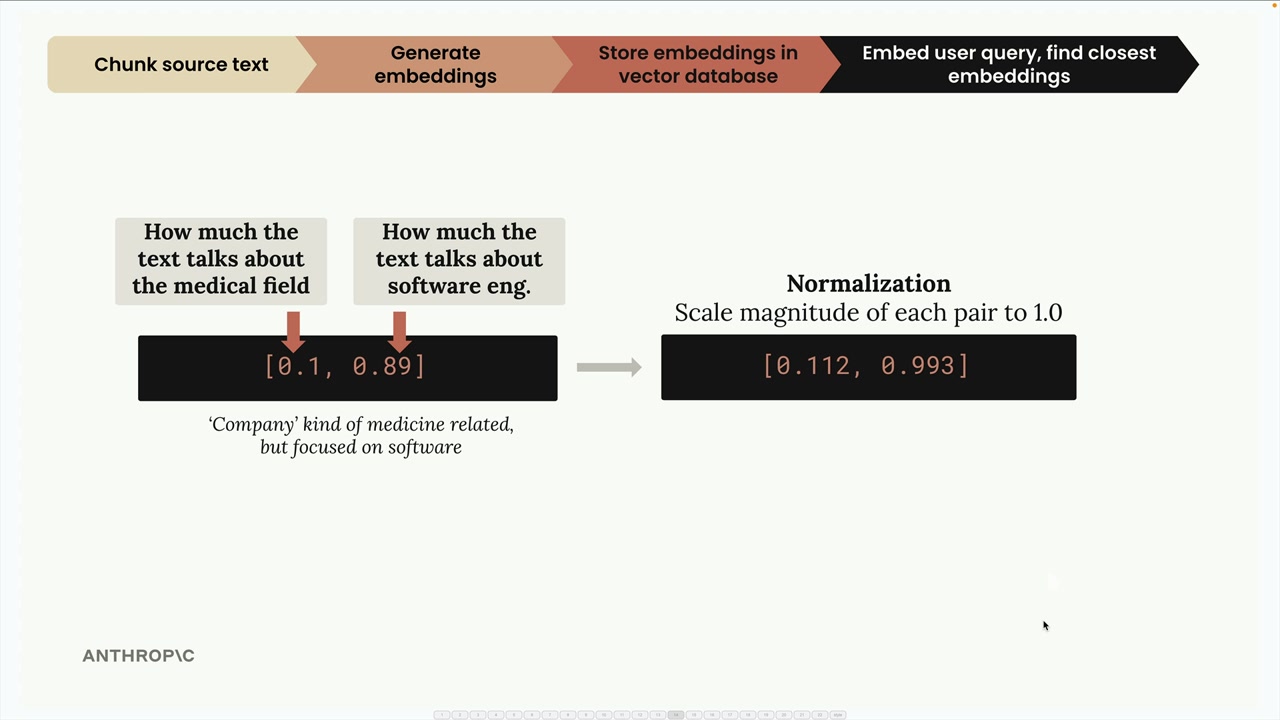
이 질의는 [0.1, 0.89]와 같이 임베딩됩니다 - 낮은 의학 점수, 높은 소프트웨어 엔지니어링 점수입니다. 정규화 후에는 [0.112, 0.993]을 얻습니다.
5단계: 유사한 임베딩 찾기
사용자의 질의 임베딩을 벡터 데이터베이스로 전송하여 가장 유사한 저장된 임베딩을 찾도록 요청합니다.
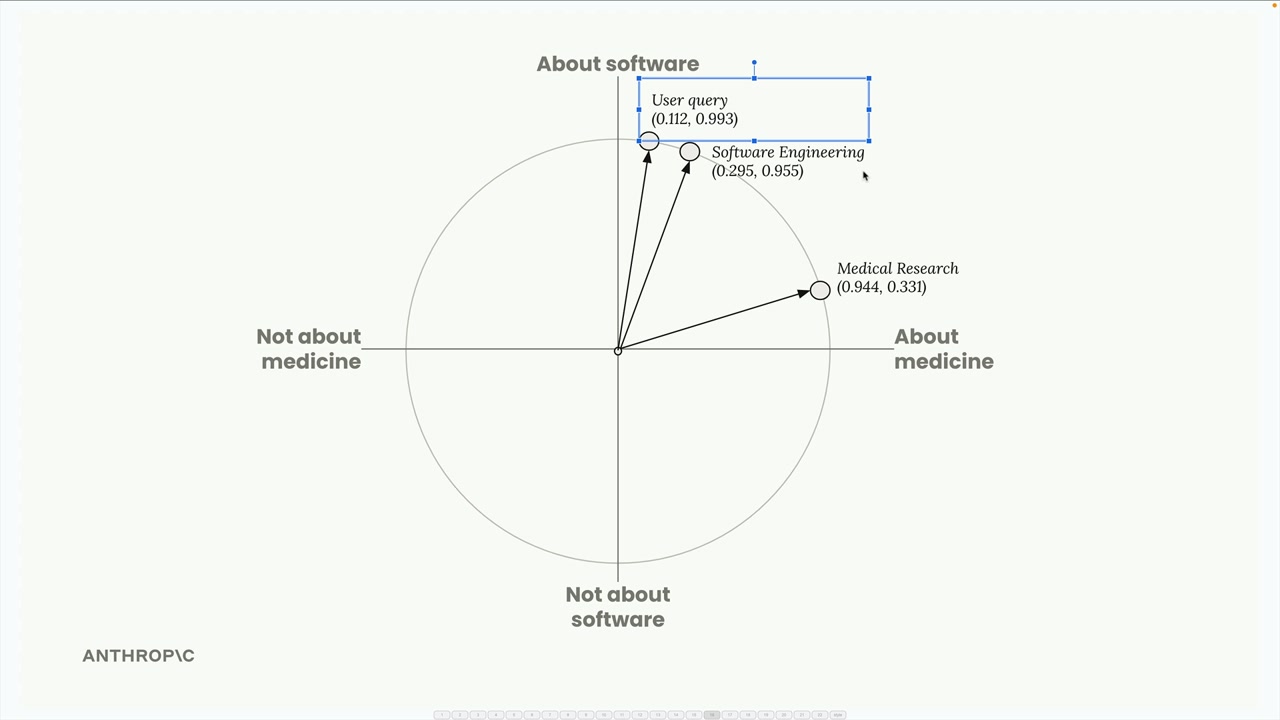
데이터베이스는 사용자가 질문한 내용과 가장 일치하기 때문에 소프트웨어 엔지니어링 섹션을 반환합니다.
유사도 계산 방식: 코사인 유사도
벡터 데이터베이스는 어떤 임베딩이 가장 유사한지 판단하기 위해 코사인 유사도를 사용합니다. 이는 두 벡터 사이의 각도의 코사인 값을 측정합니다.
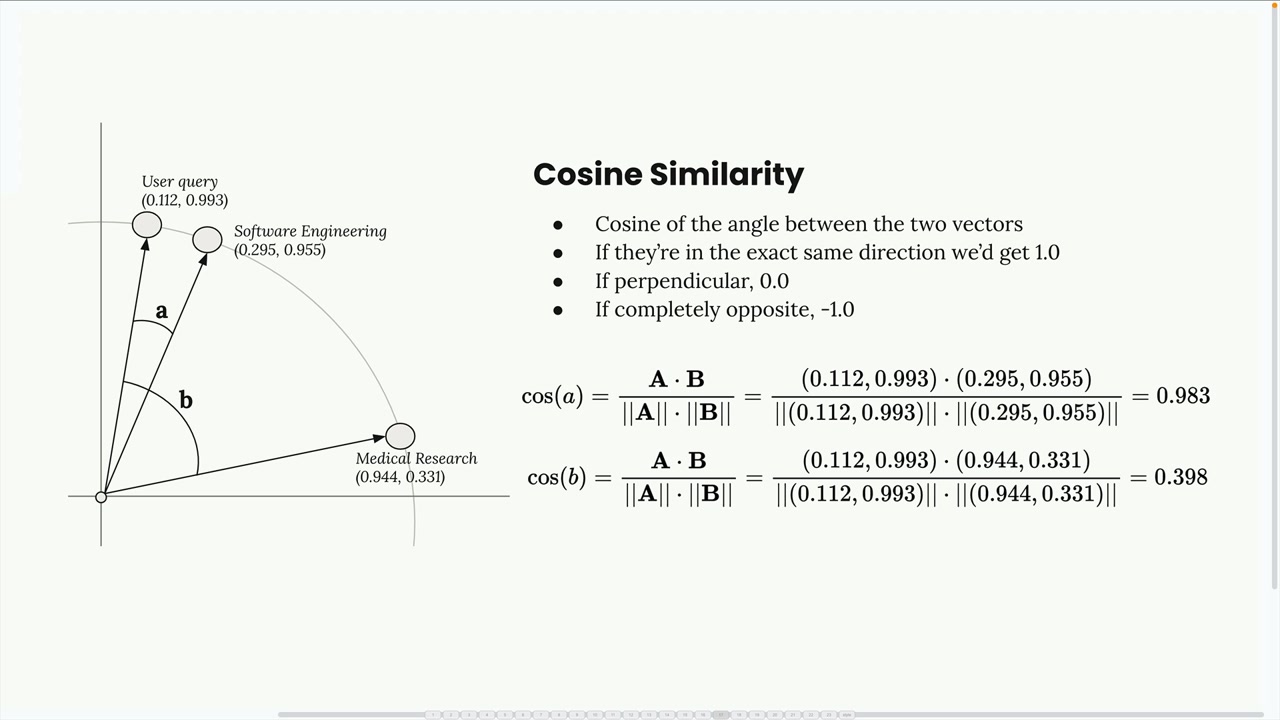
코사인 유사도에 관한 핵심 사항:
- 결과값은 -1에서 1 사이의 범위를 가집니다
- 1에 가까운 값은 높은 유사도를 의미합니다
- -1에 가까운 값은 매우 다름을 의미합니다
- 0은 수직(관계 없음)을 의미합니다
이 예제에서 사용자 질의와 소프트웨어 엔지니어링 청크 사이의 코사인 유사도는 0.983으로, 매우 높은 유사도입니다. 의학 연구 청크와의 유사도는 0.398에 불과하며, 훨씬 낮습니다.
코사인 거리(Cosine Distance)
벡터 데이터베이스 문서에서 "코사인 거리"라는 용어를 자주 보게 될 것입니다. 이는 단순히 (1 - 코사인 유사도)로 계산됩니다. 코사인 거리에서는:
- 0에 가까운 값은 높은 유사도를 의미합니다
- 값이 클수록 유사도가 낮음을 의미합니다
이러한 조정은 많은 상황에서 숫자를 더 쉽게 해석할 수 있게 해줍니다.
6단계: 최종 프롬프트 작성하기
마지막으로, 사용자의 질문과 우리가 찾은 가장 관련성 높은 텍스트 청크를 가져와 프롬프트로 결합한 후 Claude에게 전송하여 응답을 받습니다.
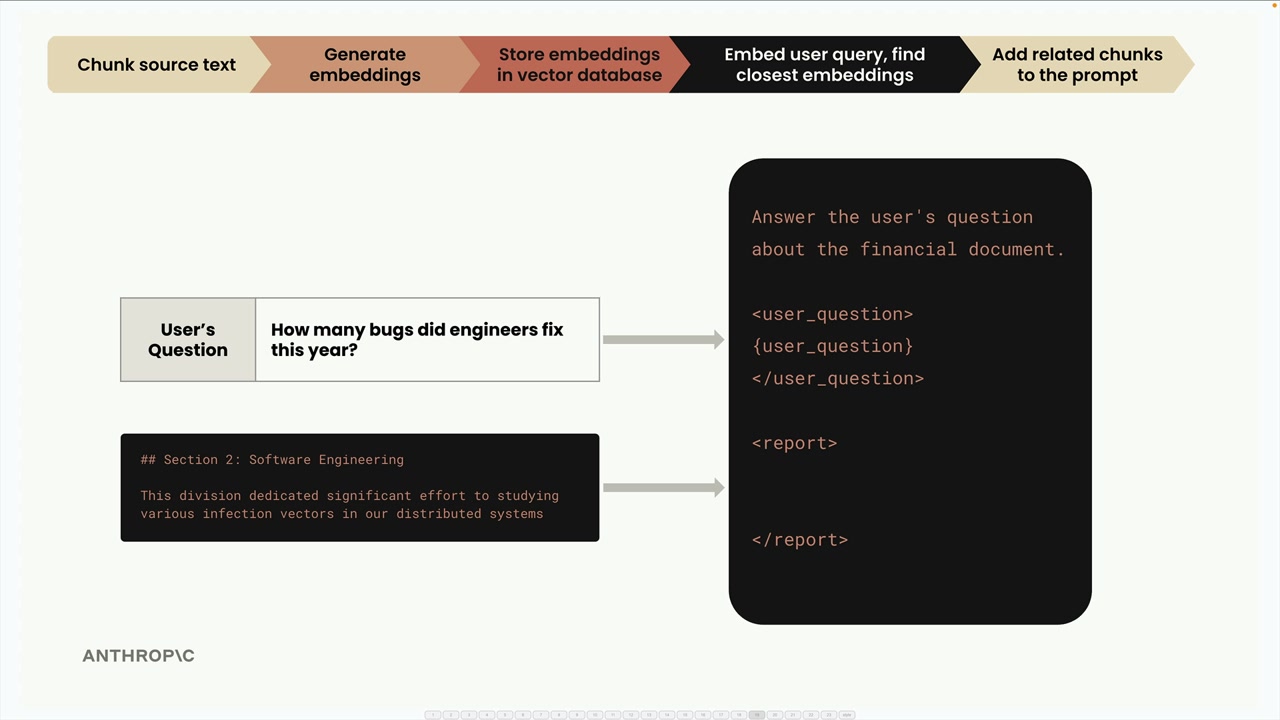
프롬프트는 다음과 같은 형태일 수 있습니다:
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>이것이 바로 전체 RAG 파이프라인입니다! 이 시스템은 의미적 유사성을 기반으로 가장 관련성 높은 정보를 성공적으로 검색했으며, 이를 정확한 응답 생성을 위한 컨텍스트로 제공했습니다.