로드 중
Claude는 PDF 파일을 직접 읽고 분석할 수 있어, 문서 처리를 위한 강력한 도구가 됩니다. 이 기능은 이미지 처리와 유사하게 작동하지만, 코드를 구성하는 방식에 몇 가지 주요 차이점이 있습니다.
PDF 처리 설정하기
Claude로 PDF 파일을 처리하려면, 이미지에 사용하는 것과 거의 동일한 코드를 사용하게 됩니다. 주요 차이점은 파일 유형 지정과 명확성을 위한 변수 이름에 있습니다.
기존 이미지 처리 코드를 PDF용으로 수정하는 방법은 다음과 같습니다:
python
with open("earth.pdf", "rb") as f:
    file_bytes = base64.standard_b64encode(f.read()).decode("utf-8")

messages = []

add_user_message(
    messages,
    [
        {
            "type": "document",
            "source": {
                "type": "base64",
                "media_type": "application/pdf",
                "data": file_bytes,
            },
        },
        {"type": "text", "text": "Summarize the document in one sentence"},
    ],
)

chat(messages)
이미지 처리와의 주요 변경 사항
이미지 처리 코드를 PDF용으로 조정할 때, 다음과 같은 여러 요소를 업데이트해야 합니다:
- 파일 확장자를
.png에서.pdf로 변경합니다 - 명확성을 위해 변수 이름을
image_bytes에서file_bytes로 업데이트합니다 - 유형을
"image"대신"document"로 설정합니다 - 미디어 유형을
"image/png"대신"application/pdf"로 변경합니다
Claude가 PDF에서 추출할 수 있는 것
Claude의 PDF 처리 기능은 단순한 텍스트 추출을 넘어섭니다. Claude는 다음을 분석하고 이해할 수 있습니다:
- 문서 전체에 걸친 텍스트 콘텐츠
- PDF에 포함된 이미지 및 차트
- 표와 그 데이터 관계
- 문서 구조 및 서식
이를 통해 Claude는 요약이 필요하든, 데이터 분석이 필요하든, 특정 콘텐츠 추출이 필요하든, PDF 문서에서 모든 유형의 정보를 추출하는 원스톱 솔루션이 됩니다.
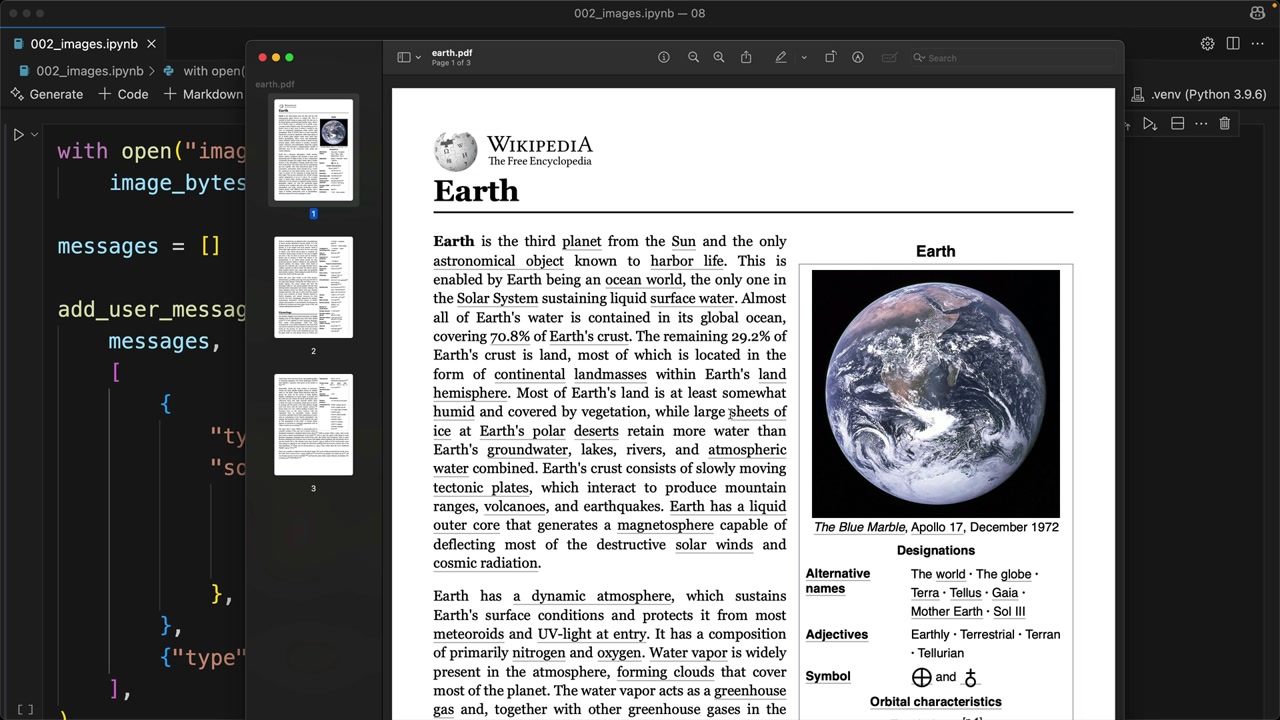
위의 예시는 Claude가 PDF로 저장된 Earth에 관한 Wikipedia 문서를 성공적으로 처리하는 모습을 보여주며, 복잡한 문서 콘텐츠를 한 문장으로 이해하고 요약하는 방법을 설명합니다.