지금까지 시맨틱 검색(벡터 임베딩 사용)과 어휘 검색(BM25 사용)에 대해 각각 별도의 구현을 만들었습니다. 이제 이 두 가지 접근 방식의 장점을 모두 활용하는 통합 검색 파이프라인으로 결합할 차례입니다.
멀티 인덱스 아키텍처
VectorIndex와 BM25Index 클래스는 거의 동일한 API를 공유합니다 - 둘 다 add_document()와 search() 메서드를 가지고 있습니다. 이러한 일관성 덕분에 이 둘을 Retriever라는 새로운 클래스로 감싸는 것이 간단해집니다.
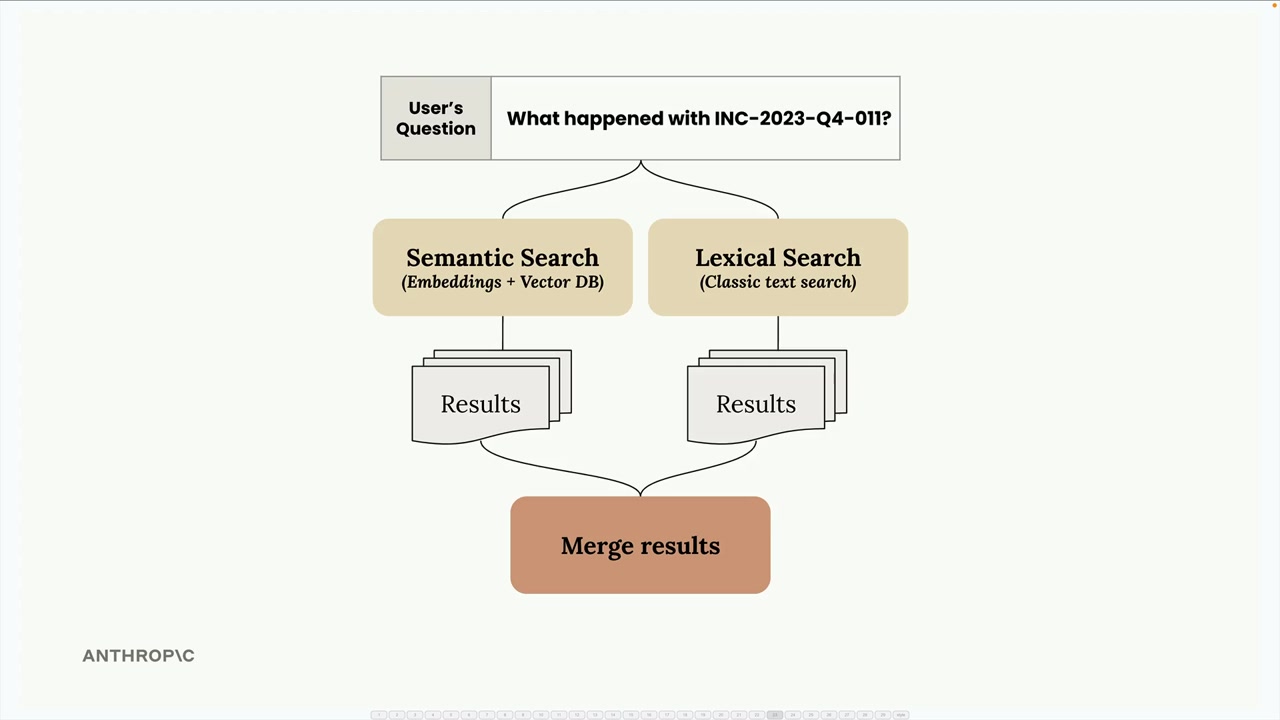
Retriever는 사용자 쿼리를 두 인덱스 모두에 전달하고, 그 결과를 수집한 다음, reciprocal rank fusion이라는 기법을 사용하여 병합하는 코디네이터 역할을 합니다.
Reciprocal Rank Fusion 이해하기
서로 다른 검색 방법의 결과를 병합하는 것은 단순히 목록을 이어 붙이는 것처럼 간단하지 않습니다. 각 방법은 서로 다른 점수 체계를 사용하므로, 각 순위를 공정하게 정규화하고 결합할 방법이 필요합니다.
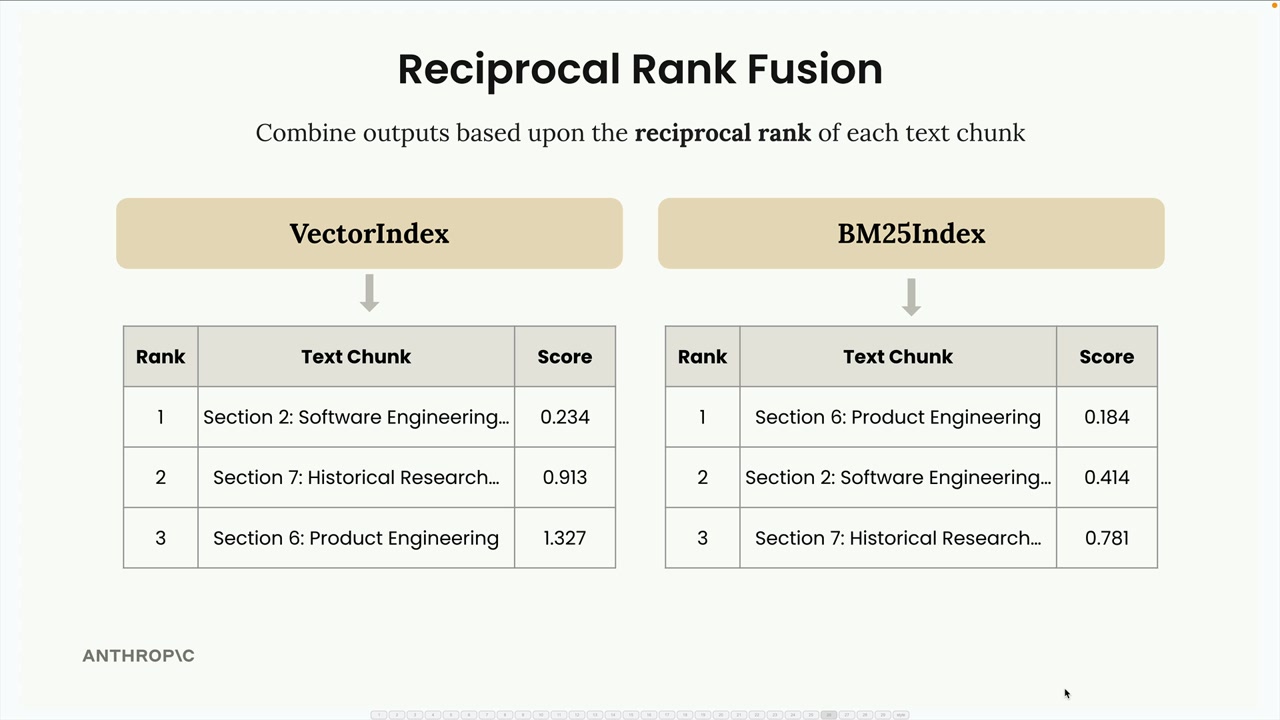
예시를 통해 reciprocal rank fusion이 어떻게 작동하는지 살펴보겠습니다. "INC-2023-Q4-011"에 대한 정보를 검색해서 다음과 같은 결과를 얻었다고 가정해 보겠습니다:
- VectorIndex 반환 결과: 섹션 2 (1위), 섹션 7 (2위), 섹션 6 (3위)
- BM25Index 반환 결과: 섹션 6 (1위), 섹션 2 (2위), 섹션 7 (3위)
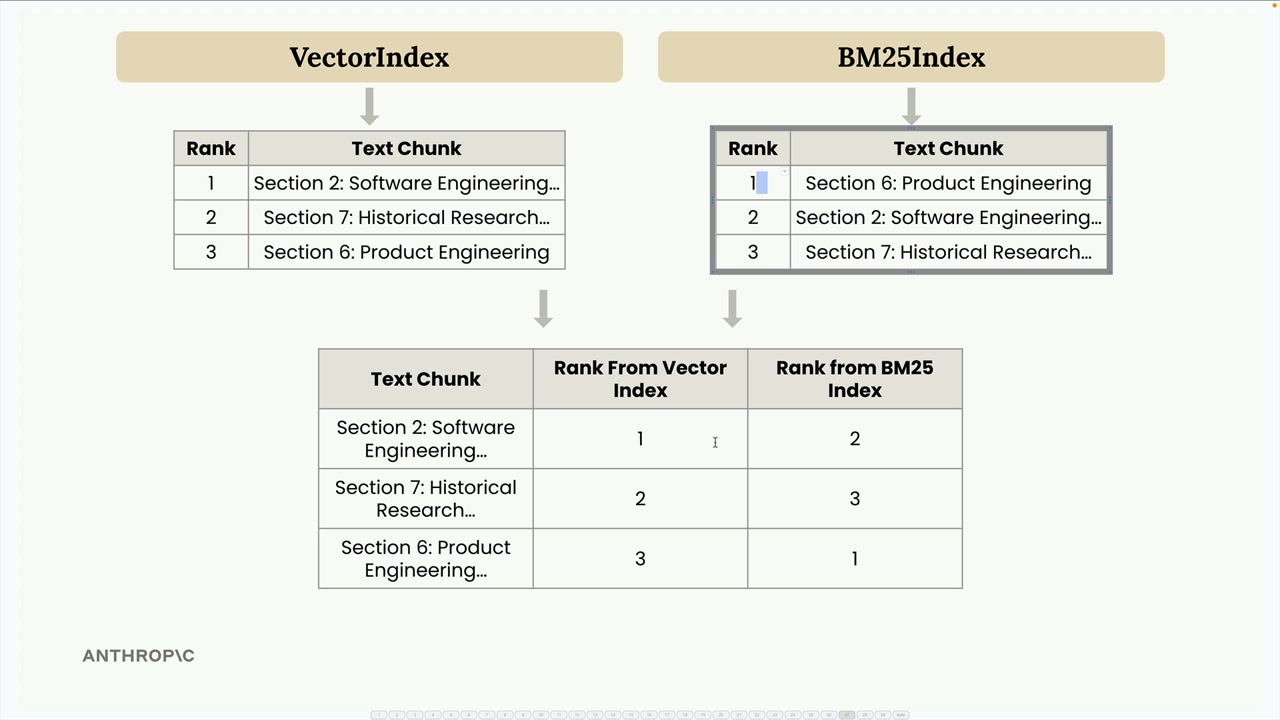
이를 각 텍스트 청크가 두 인덱스에서 얻은 순위를 보여주는 하나의 표로 결합한 다음, RRF 공식을 적용합니다:
RRF_score(d) = Σ(1 / (k + rank_i(d)))여기서 k는 상수(보통 60이지만, 결과를 더 명확히 보기 위해 1을 사용하겠습니다)이고 rank_i(d)는 i번째 순위에서 문서 d의 순위입니다.
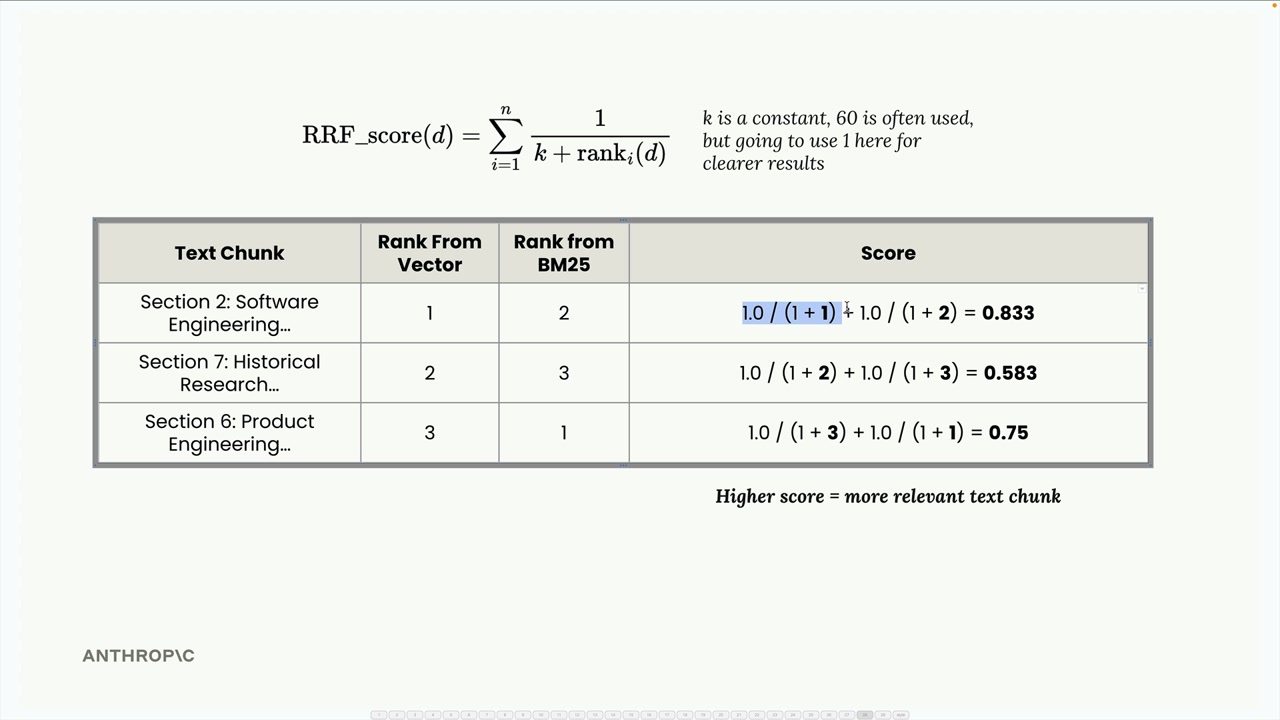
예시를 계산해보면 다음과 같습니다:
- 섹션 2: 1.0/(1+1) + 1.0/(1+2) = 0.833
- 섹션 7: 1.0/(1+2) + 1.0/(1+3) = 0.583
- 섹션 6: 1.0/(1+3) + 1.0/(1+1) = 0.75
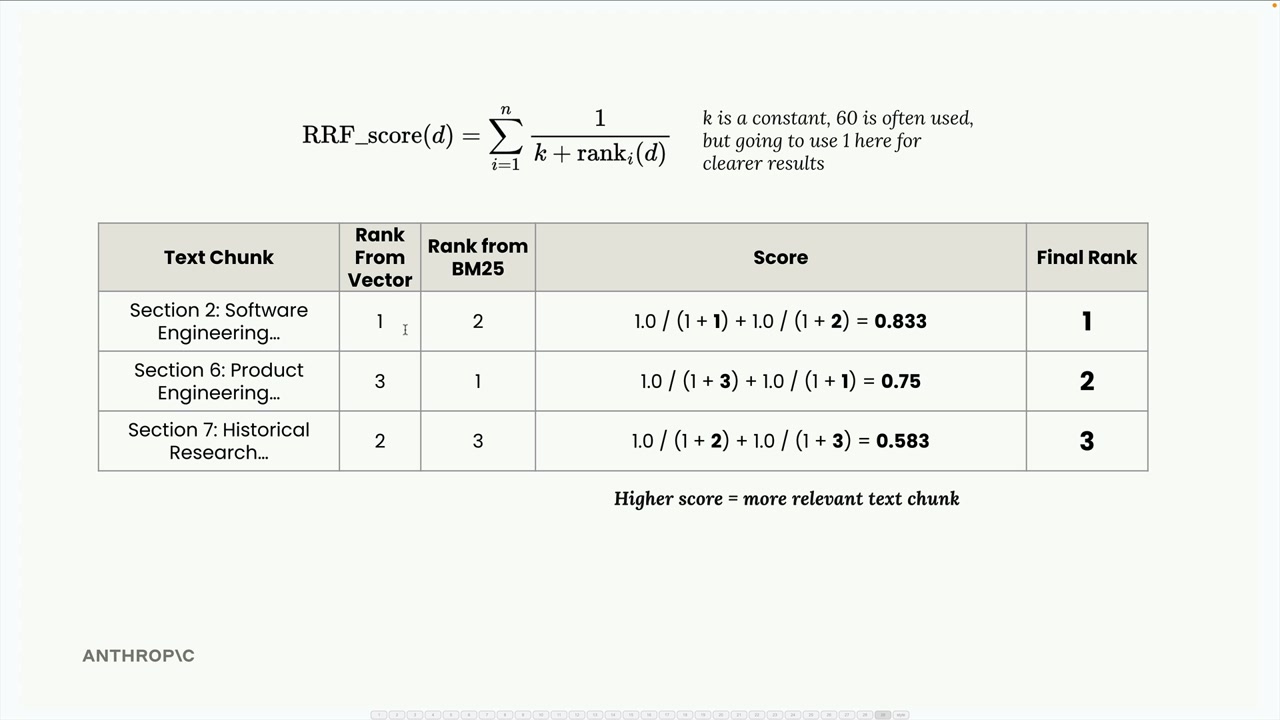
최종 순위는 다음과 같습니다: 섹션 2 (0.833), 섹션 6 (0.75), 섹션 7 (0.583). 이는 직관적으로도 타당합니다 - 섹션 2는 두 인덱스 모두에서 좋은 성과를 보였기 때문에 최상위로 올라갑니다.
구현 세부 사항
Retriever 클래스는 여러 검색 인덱스를 감싸고 통합된 인터페이스를 제공합니다:
class Retriever:
    def __init__(self, *indexes: SearchIndex):
        if len(indexes) == 0:
            raise ValueError("At least one index must be provided")
        self._indexes = list(indexes)

    def add_document(self, document: Dict[str, Any]):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text: str, k: int = 1, k_rrf: int = 60):
        # 모든 인덱스에서 결과 가져오기
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # 인덱스 전반의 문서 순위 추적
                # RRF 점수 계산 공식 적용
        # 병합 및 정렬된 결과 반환
핵심은 서로 다른 검색 구현 전반에 걸쳐 일관된 API를 유지함으로써, 긴밀한 결합 없이도 이들을 쉽게 결합할 수 있다는 것입니다.
하이브리드 접근 방식 테스트하기
"INC-2023-Q4-011에 무슨 일이 있었나요?"를 검색했을 때 벡터 전용 접근 방식에서 예상치 못한 결과가 반환됐던 이전 문제를 기억하시나요? 사이버보안 사건(섹션 10)이 첫 번째로 나왔지만, 더 관련성 높은 소프트웨어 엔지니어링 섹션 대신 재무 분석(섹션 3)이 두 번째로 나왔었습니다.
하이브리드 Retriever를 사용하면 훨씬 더 나은 결과를 얻을 수 있습니다:
- 섹션 10: 사이버보안 분석 - 사고 대응 보고서 (가장 관련성 높음)
- 섹션 2: 소프트웨어 엔지니어링 - 프로젝트 피닉스 안정성 개선 (두 번째로 관련성 높음)
- 섹션 5: 법률 동향 (세 번째)
이는 시맨틱 검색과 어휘 검색을 결합하면 각 접근 방식을 단독으로 사용했을 때의 한계를 어떻게 극복할 수 있는지 보여줍니다.
확장성
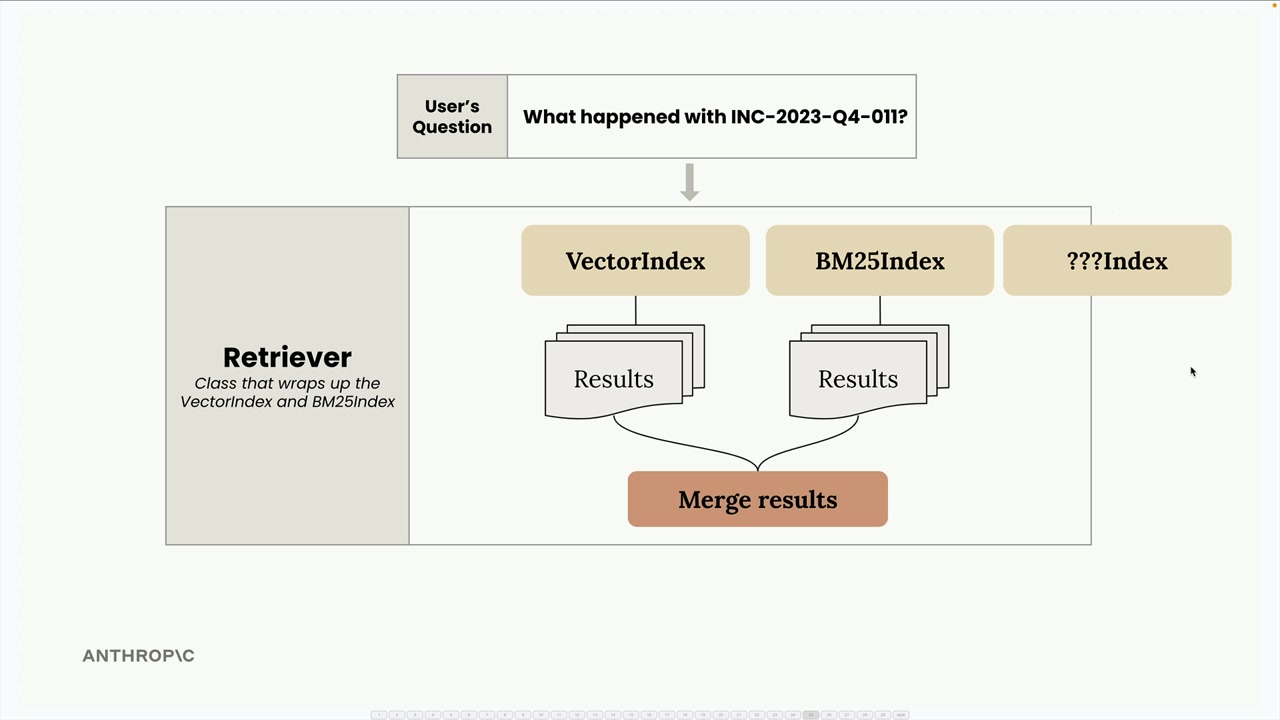
이 아키텍처의 장점은 확장성에 있습니다. 모든 인덱스가 add_document()와 search() 메서드를 가진 동일한 SearchIndex 프로토콜을 구현하므로, 새로운 검색 방법론을 쉽게 추가할 수 있습니다:
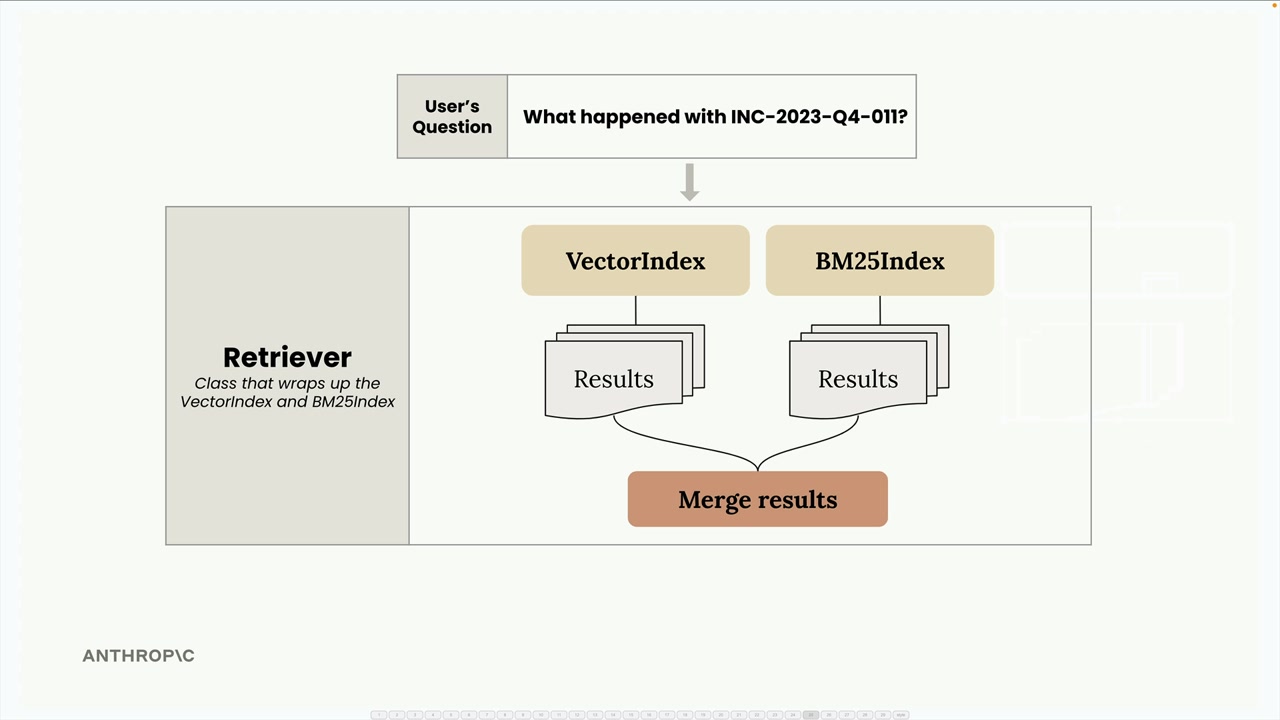
키워드 기반 인덱스를 추가하고 싶으신가요? 그래프 기반 검색은 어떨까요? 특화된 도메인 인덱스는요? 동일한 인터페이스만 구현하면 Retriever가 자동으로 이를 퓨전 과정에 포함시킵니다.
이러한 모듈식 접근 방식은 각 검색 구현을 집중적이고 테스트 가능하게 유지하면서, 최종 시스템에서 각각의 강점을 결합할 수 있는 깔끔한 방법을 제공합니다.