Claude로 채팅 애플리케이션을 구축할 때는 중요한 사용자 경험 문제가 있습니다. 응답을 생성하는 데 10~30초가 걸릴 수 있어서 사용자가 로딩 스피너만 바라보게 된다는 점입니다. 이에 대한 해결책이 바로 응답 스트리밍입니다. 스트리밍을 사용하면 Claude가 텍스트를 생성하는 동안 사용자가 청크 단위로 텍스트가 나타나는 것을 볼 수 있어, 훨씬 더 반응성이 좋은 느낌을 줍니다.
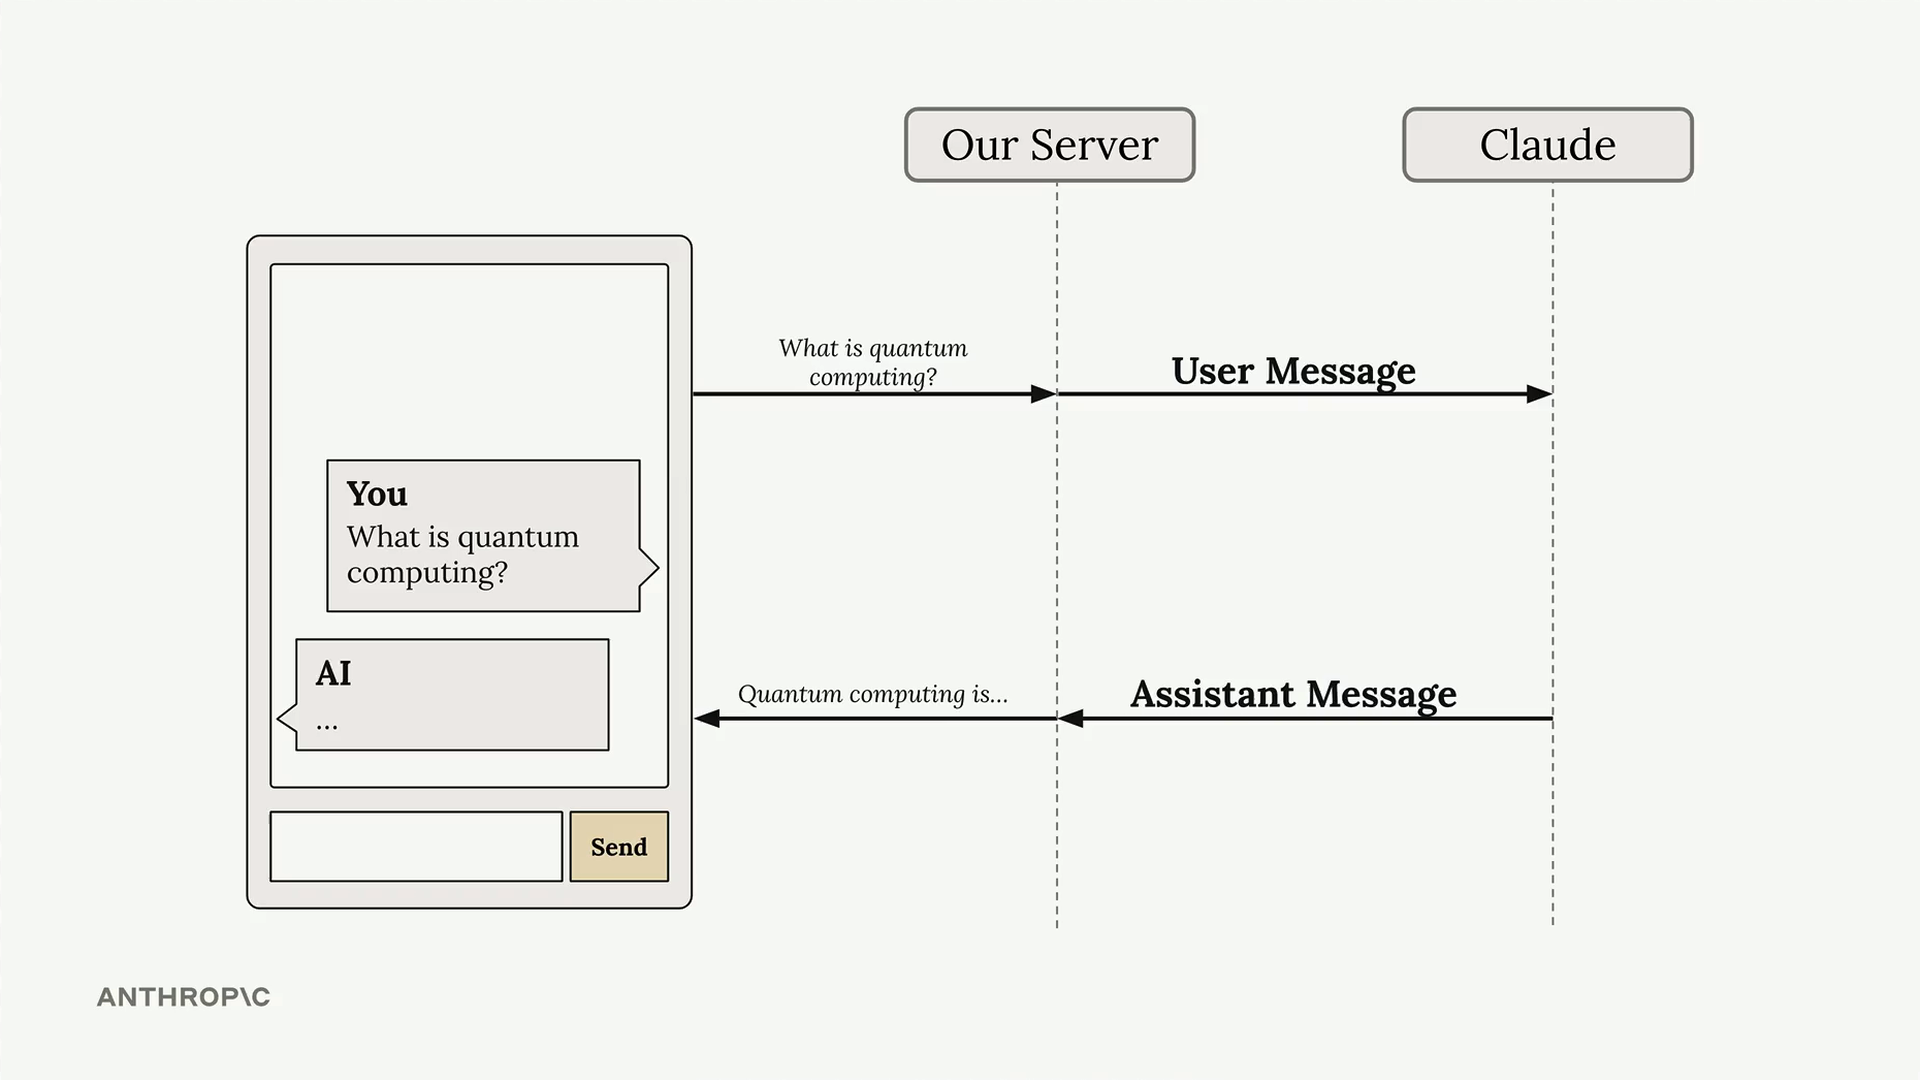
표준 응답의 문제점
일반적인 채팅 구성에서는 서버가 사용자 메시지를 Claude에 보낸 후 완전한 응답을 받을 때까지 기다렸다가 클라이언트에 무언가를 다시 보냅니다. 이로 인해 사용자는 무언가 진행되고 있다는 피드백을 전혀 받지 못한 채 어색한 지연을 경험하게 됩니다.
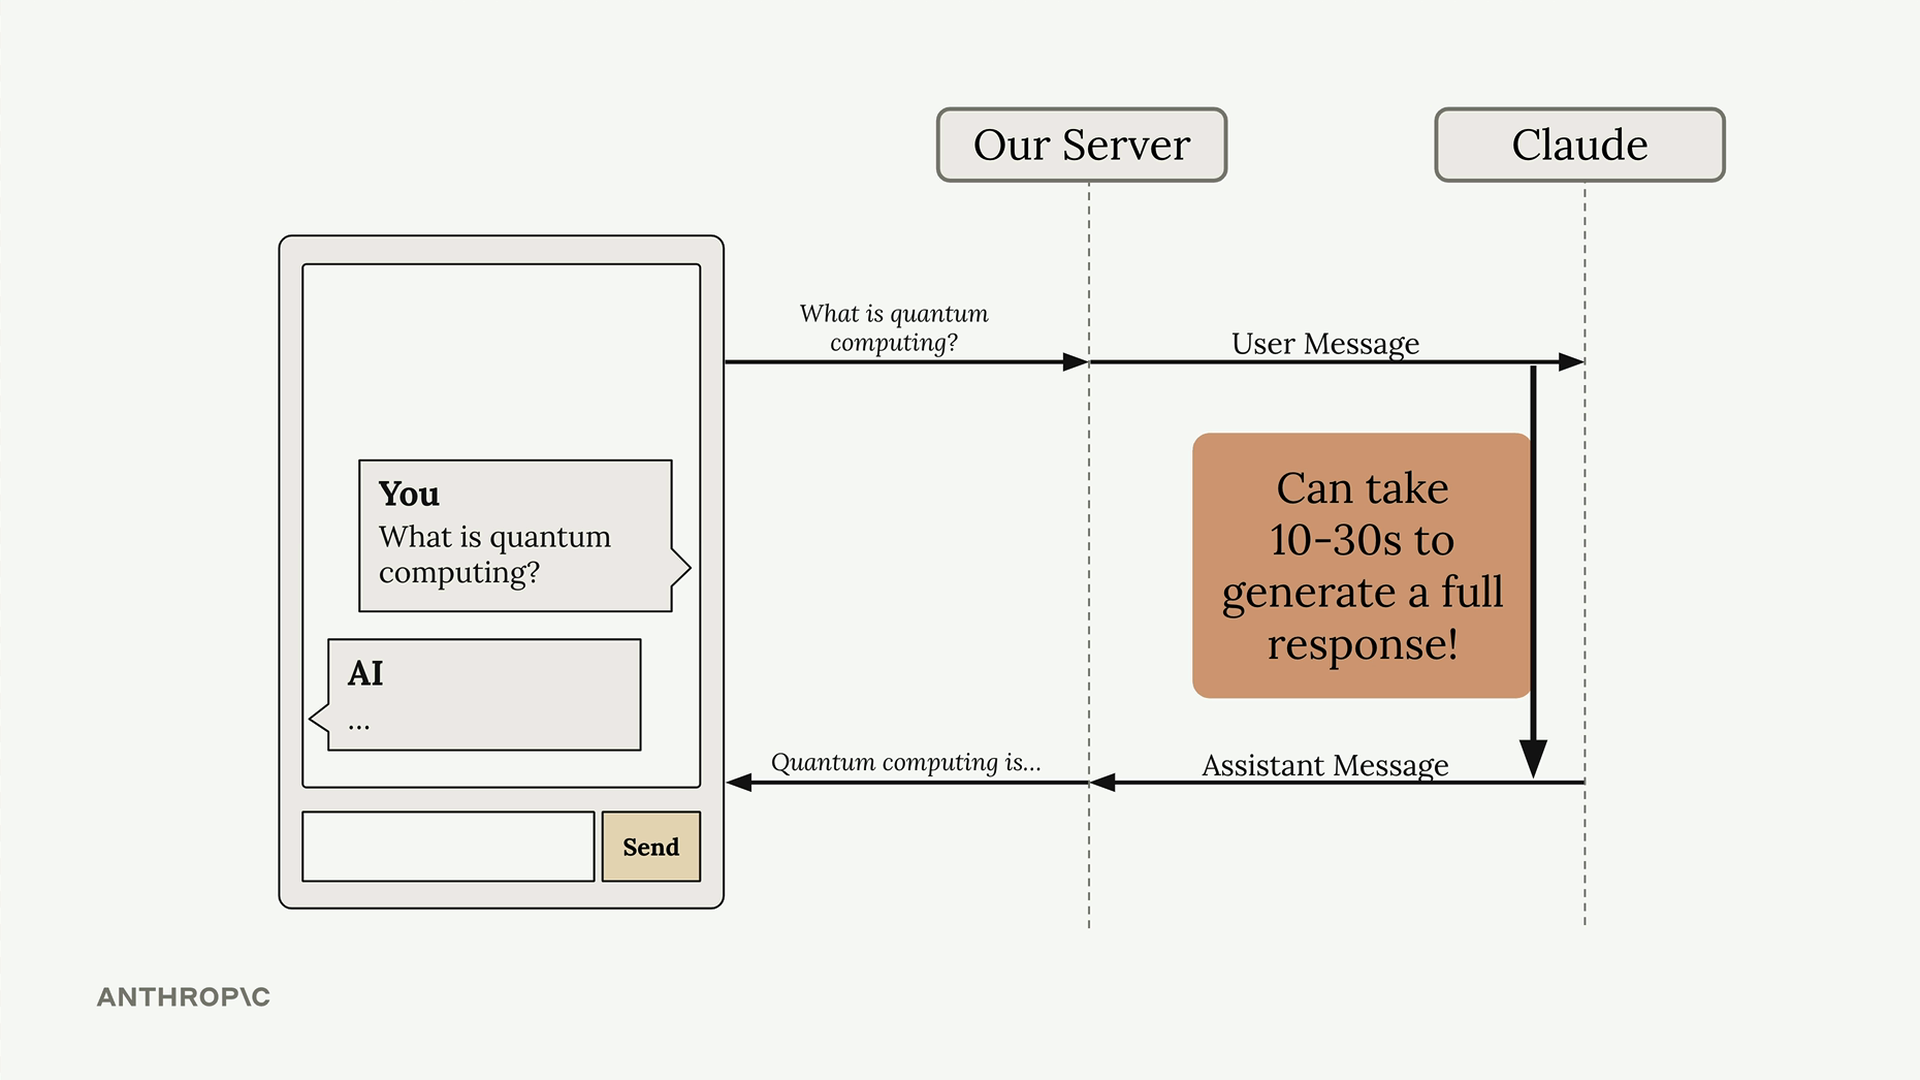
스트리밍의 작동 방식
스트리밍이 활성화되면 Claude는 요청을 수신했으며 텍스트 생성을 시작한다는 것을 나타내는 초기 응답을 즉시 다시 보냅니다. 그런 다음 전체 응답의 작은 조각을 각각 담고 있는 일련의 이벤트를 받게 됩니다.
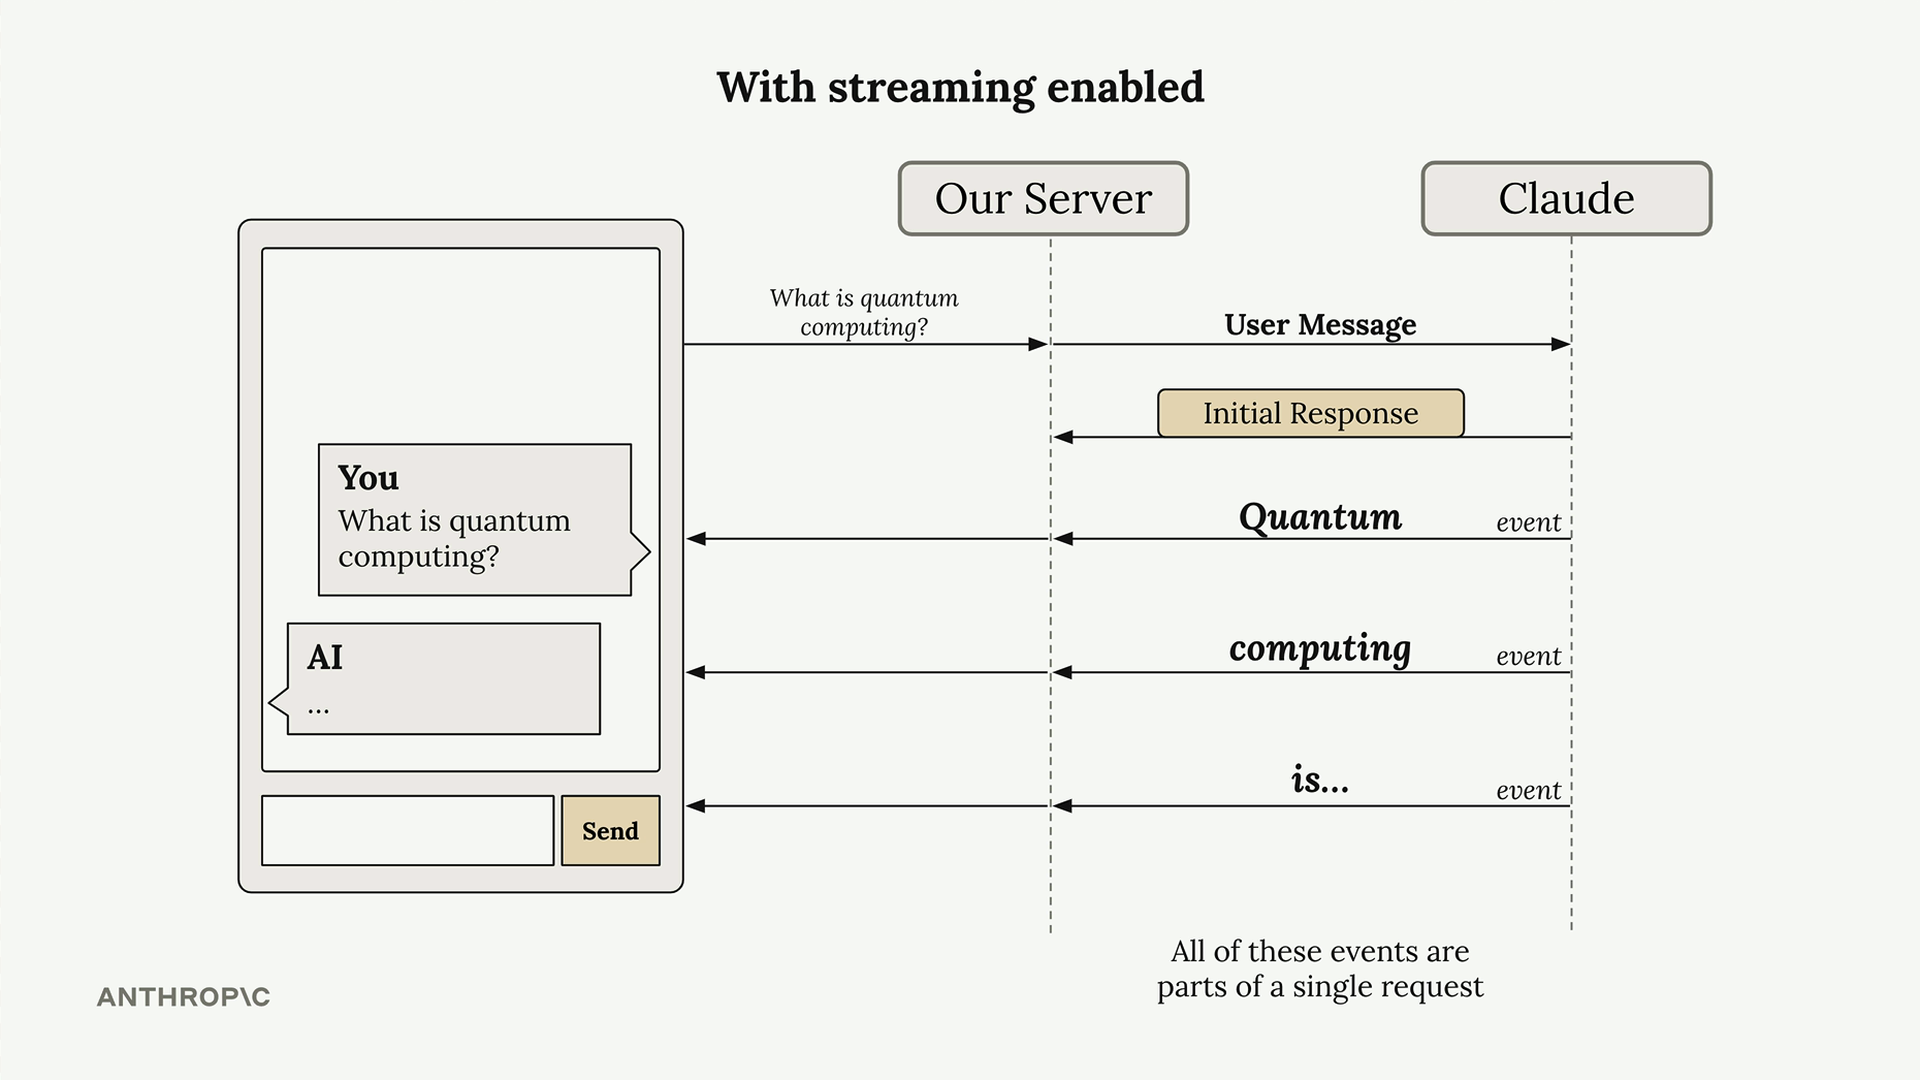
서버는 이러한 텍스트 청크가 도착하는 대로 클라이언트 애플리케이션으로 전달할 수 있으므로, 사용자는 응답이 단어 단위로 만들어지는 것을 볼 수 있습니다. 이러한 이벤트는 모두 Claude에 대한 단일 요청의 일부입니다.
스트림 이벤트 이해하기
스트리밍을 활성화하면 Claude는 여러 유형의 이벤트를 다시 보냅니다:
- MessageStart - 새 메시지를 보내는 중입니다
- ContentBlockStart - 텍스트, 도구 사용 또는 기타 콘텐츠를 포함하는 새 블록의 시작
- ContentBlockDelta - 실제로 생성된 텍스트의 청크
- ContentBlockStop - 현재 콘텐츠 블록이 완료되었습니다
- MessageDelta - 현재 메시지가 완료되었습니다
- MessageStop - 현재 메시지에 대한 정보의 끝
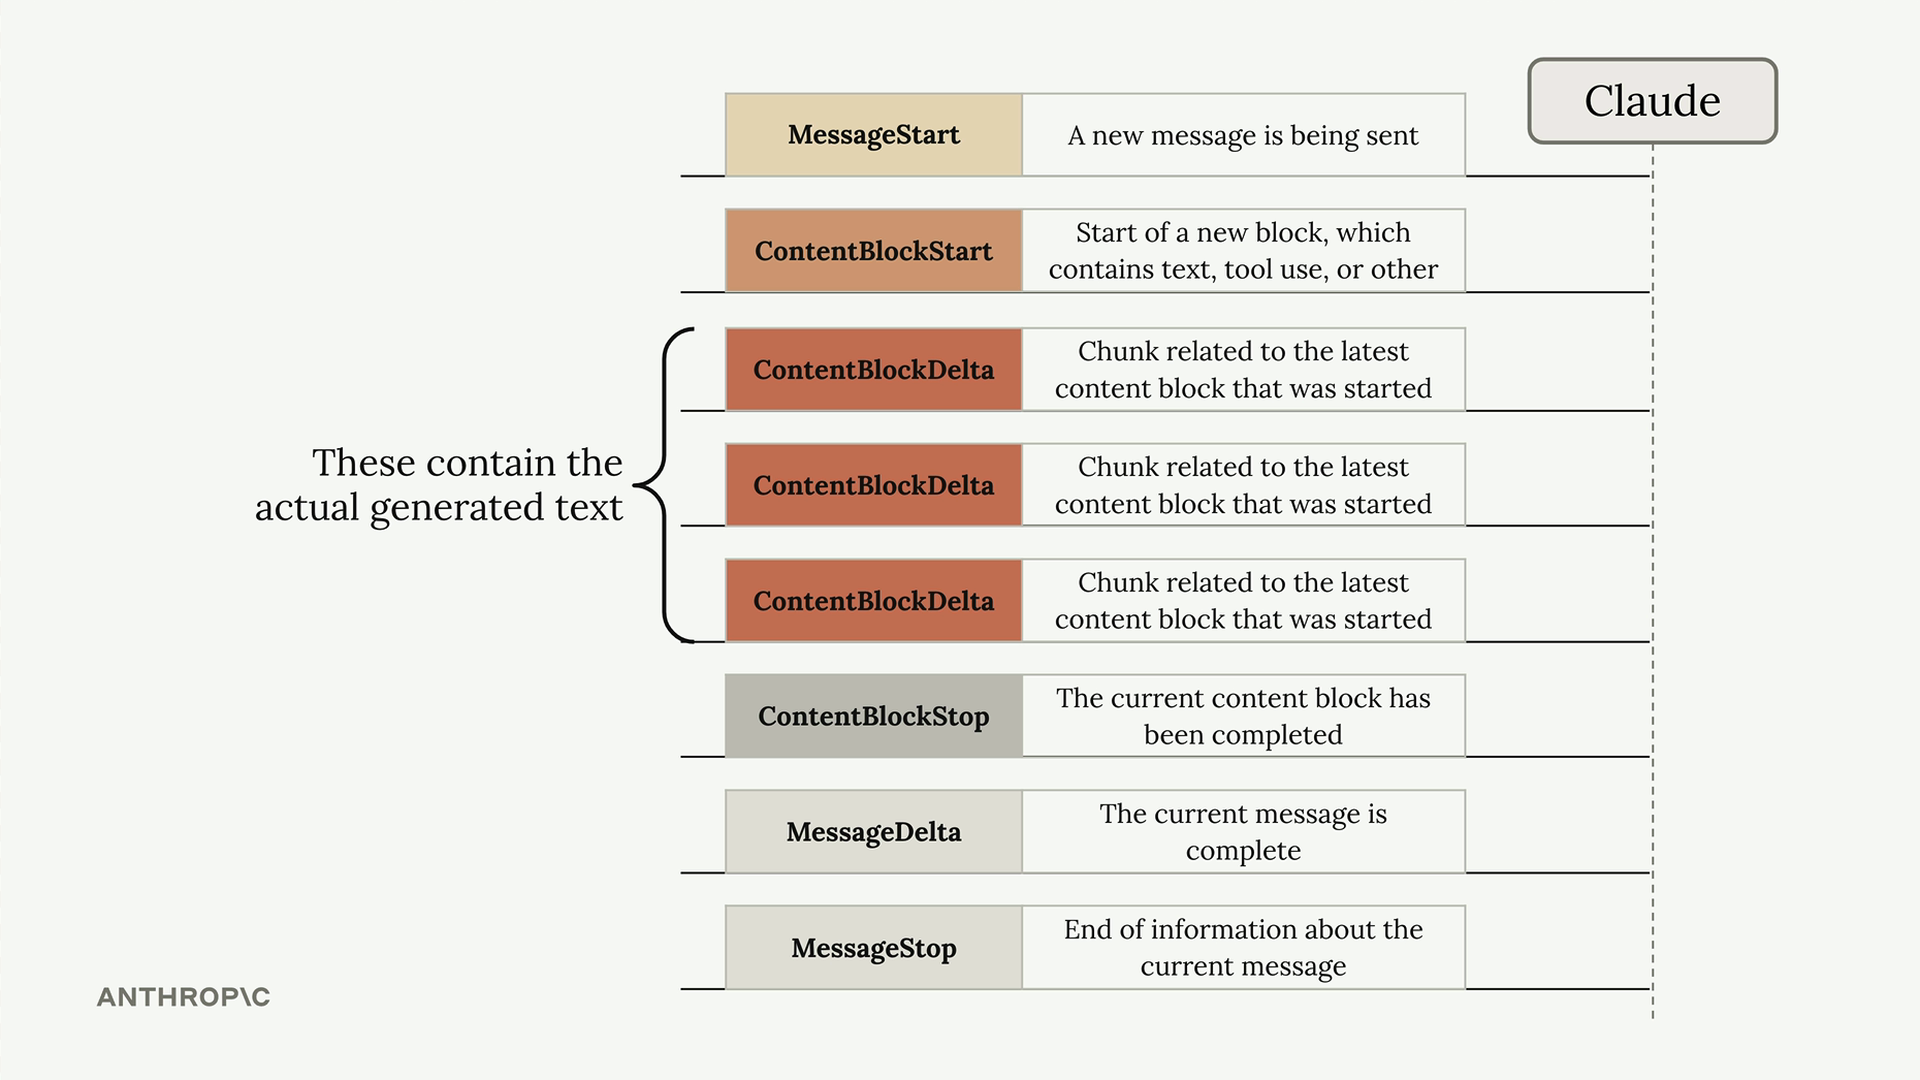
ContentBlockDelta 이벤트에는 사용자에게 표시하고자 하는 실제 생성된 텍스트가 포함되어 있습니다.
기본 스트리밍 구현
스트리밍을 활성화하려면 messages.create 호출에 stream=True를 추가하세요.
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)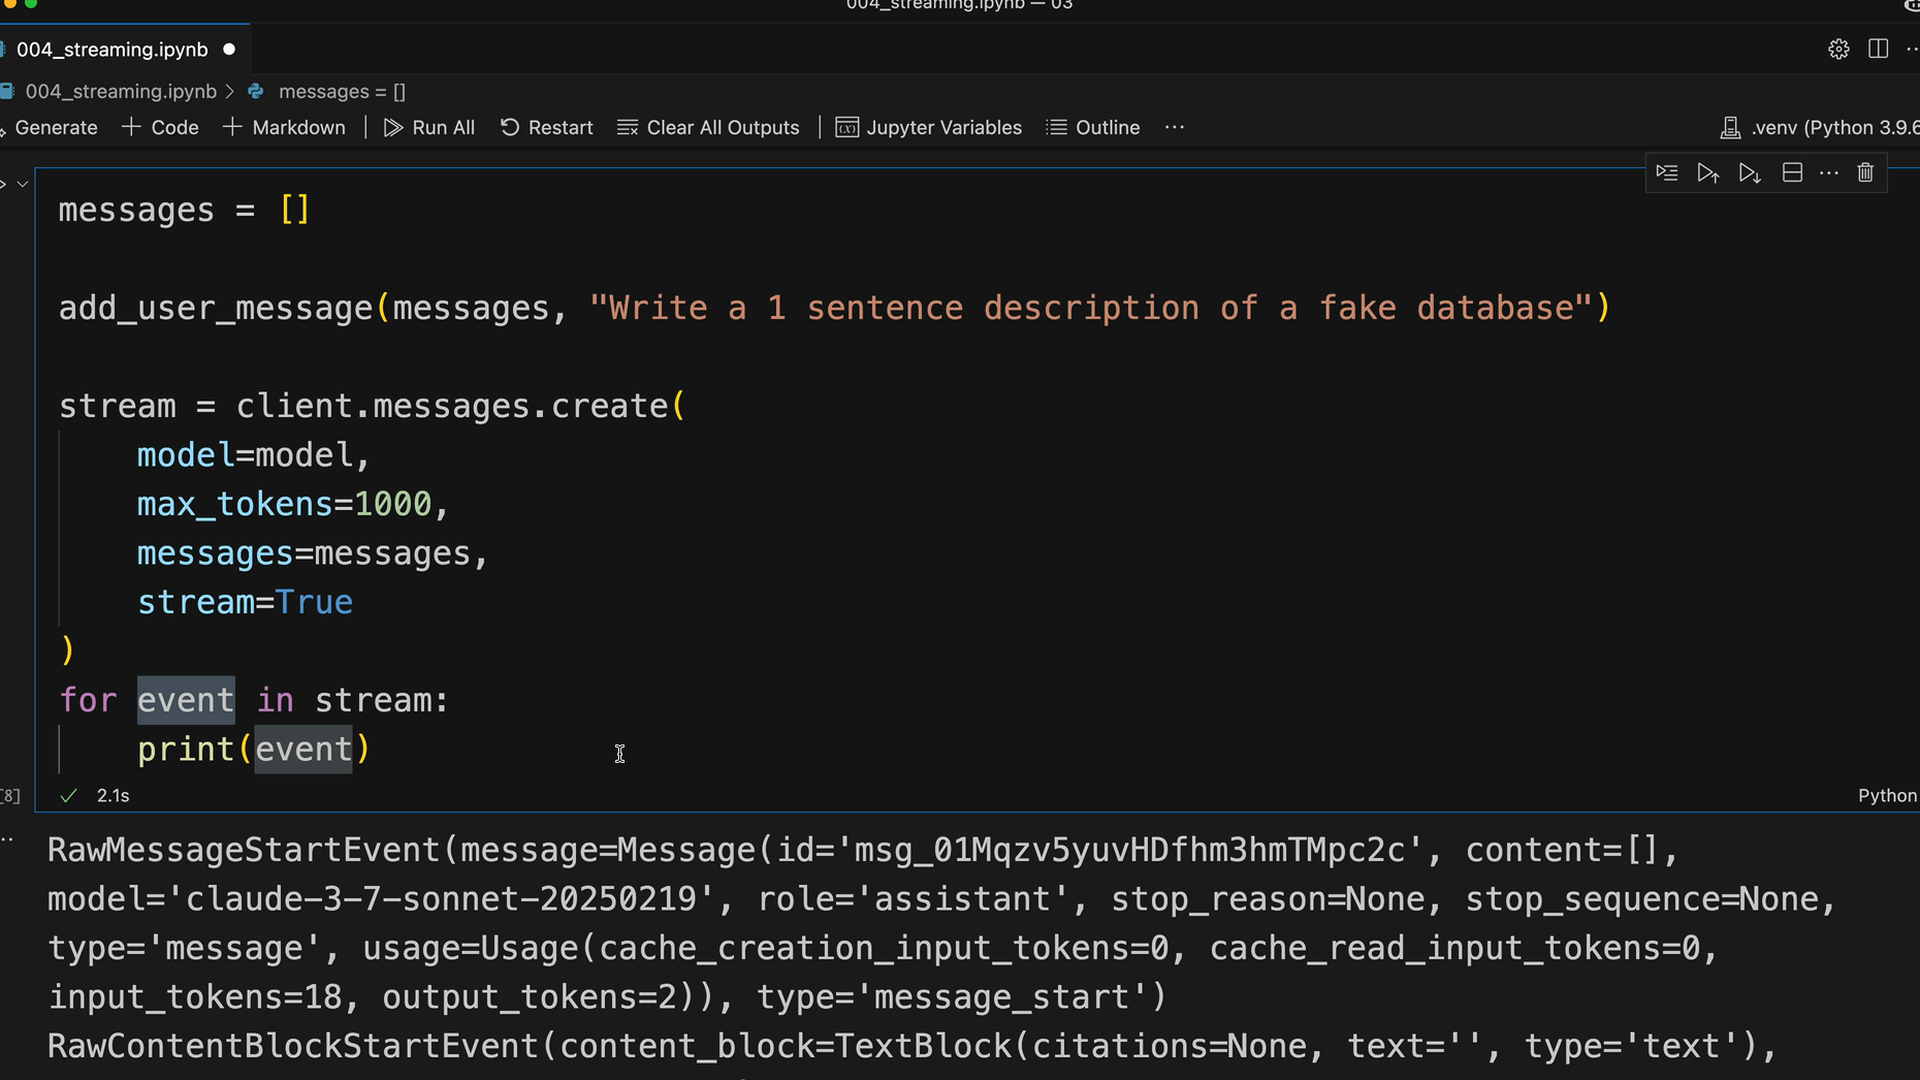
단순화된 텍스트 스트리밍
이벤트를 수동으로 파싱하는 대신, 실제 텍스트 콘텐츠만 추출하는 SDK의 단순화된 스트리밍 인터페이스를 사용할 수 있습니다:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
이 방식은 실제 텍스트 콘텐츠를 제외한 나머지를 모두 자동으로 걸러내며, 이는 보통 사용자에게 응답을 표시할 때 필요한 것입니다.
완전한 메시지 가져오기
개별 청크를 스트리밍하는 것은 사용자 경험에는 좋지만, 저장이나 추가 처리를 위해서는 완전한 메시지가 필요한 경우가 많습니다. 스트리밍이 완료된 후 조립된 최종 메시지를 가져올 수 있습니다:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        # 각 청크를 클라이언트로 전송
        pass

    # 데이터베이스 저장을 위해 전체 메시지 가져오기
    final_message = stream.get_final_message()
이를 통해 사용자를 위한 실시간 스트리밍과 애플리케이션 로직을 위한 완전한 메시지 객체라는 두 가지 장점을 모두 얻을 수 있습니다.