이제 RAG 흐름을 개념적으로 이해했으니, 단계별로 구현해 보겠습니다. 텍스트를 청크로 나누고, 임베딩을 생성하고, 이를 벡터 데이터베이스에 저장하고, 유사도 검색을 수행하는 방법을 보여주는 전체 예제를 함께 살펴보겠습니다.
5단계 RAG 구현
우리의 구현은 이전에 논의했던 것과 동일한 다섯 단계를 따릅니다:
- 텍스트를 섹션별로 청크로 나눕니다
- 각 청크에 대한 임베딩을 생성합니다
- 벡터 저장소를 생성하고 각 임베딩을 추가합니다
- 사용자 질문에 대한 임베딩을 생성합니다
- 저장소를 검색하여 가장 관련성 높은 청크를 찾습니다
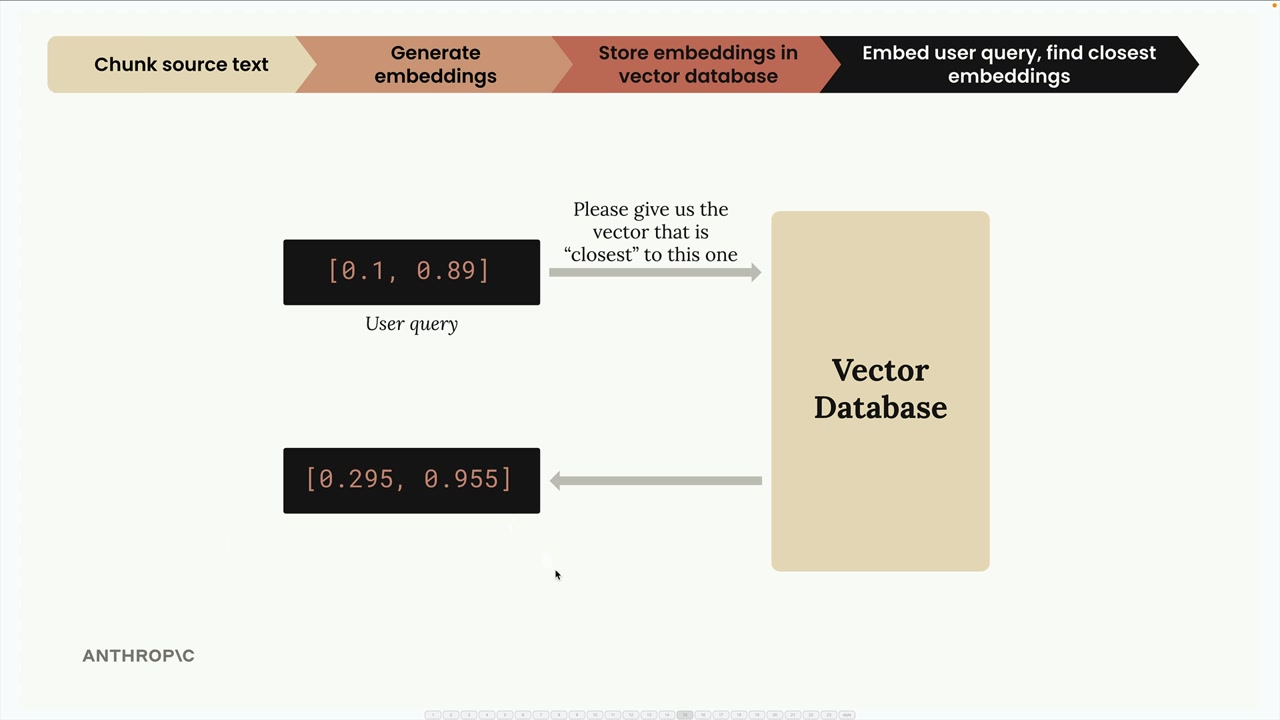
이 다이어그램은 사용자 쿼리를 임베딩으로 변환하고 벡터 데이터베이스를 검색하여 가장 관련성 높은 콘텐츠를 찾는 방법을 보여줍니다.
1단계: 텍스트 청크로 나누기
먼저, 문서를 불러와서 관리 가능한 섹션으로 분할합니다:
with open("./report.md", "r") as f:
    text = f.read()

chunks = chunk_by_section(text)
chunks[2]  # Test to see the table of contents
앞서 사용했던 것과 동일한 chunk_by_section 함수를 사용하여 문서를 논리적 섹션으로 분할합니다.
2단계: 임베딩 생성
다음으로, 모든 청크에 대한 임베딩을 한 번에 생성합니다:
embeddings = generate_embedding(chunks)임베딩 함수는 단일 문자열과 문자열 목록을 모두 처리할 수 있도록 업데이트되어 배치 처리를 더 효율적으로 수행할 수 있습니다.
3단계: 벡터 데이터베이스에 저장
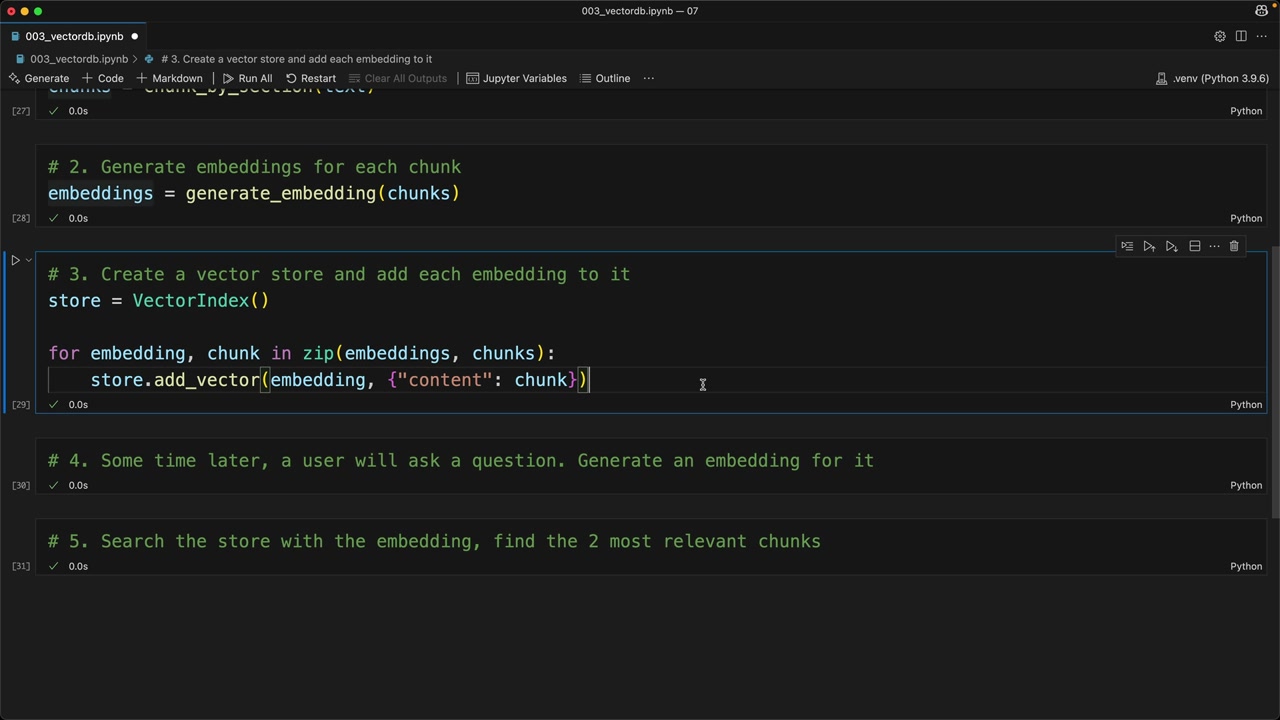
이제 벡터 저장소를 생성하고 임베딩 및 관련 텍스트로 채워 넣습니다:
store = VectorIndex()

for embedding, chunk in zip(embeddings, chunks):
    store.add_vector(embedding, {"content": chunk})
임베딩과 원본 텍스트 콘텐츠를 모두 저장한다는 점에 주목하세요. 이는 나중에 검색할 때 숫자로 된 임베딩 값이 아니라 실제 텍스트를 반환해야 하기 때문에 매우 중요합니다.
원본 텍스트를 저장하는 이유는 무엇인가요?
벡터 데이터베이스를 쿼리할 때 단순히 임베딩 숫자만 돌려받는 것은 유용하지 않습니다. 해당 임베딩을 생성하는 데 사용된 실제 텍스트가 필요합니다. 그렇기 때문에 데이터베이스에 각 임베딩과 함께 원본 청크 텍스트(또는 적어도 그에 대한 참조)를 포함하는 것입니다.
4단계: 사용자 쿼리 처리
사용자가 질문을 하면, 해당 쿼리에 대한 임베딩을 생성합니다:
user_embedding = generate_embedding("What did the software engineering dept do last year?")5단계: 관련 콘텐츠 찾기
마지막으로, 벡터 저장소를 검색하여 가장 유사한 청크를 찾습니다:
results = store.search(user_embedding, 2)

for doc, distance in results:
    print(distance, "\n", doc["content"][0:200], "\n")
이 검색은 유사도 점수(코사인 거리)와 함께 가장 관련성 높은 두 개의 청크를 반환합니다.
검색 결과는 사용자의 질문과 가장 관련성이 높은 문서 섹션을 유사도 점수와 함께 보여줍니다.
결과 이해하기
소프트웨어 엔지니어링 부서에 대한 예제 쿼리를 실행하면 다음과 같은 결과를 얻습니다:
- 2번 섹션: 소프트웨어 엔지니어링 — 거리 0.71 (가장 가까운 일치)
- 방법론 섹션 — 거리 0.72 (두 번째로 가까운 일치)
거리 값이 낮을수록 유사도가 높다는 것을 의미하므로, 2번 섹션이 우리의 쿼리와 가장 관련성이 높습니다.
다음 단계는 무엇인가요?
이 구현은 기본적인 경우에는 잘 작동하지만, 예상대로 수행되지 않는 시나리오도 있습니다. 다음 섹션에서는 RAG 시스템을 더 견고하고 정확하게 만들기 위한 개선 사항을 살펴보겠습니다.
핵심 요점은 RAG가 근본적으로 텍스트를 숫자(임베딩)로 변환하고, 그 숫자를 효율적으로 저장한 다음, 사용자가 질문할 때 수학적 유사도를 사용하여 관련 콘텐츠를 찾는 것이라는 점입니다.