코드를 생성하는 AI 모델을 평가할 때는 응답이 말이 되는지 확인하는 것만으로는 충분하지 않습니다. 생성된 코드가 실제로 유효한 문법을 가지고 있고 올바른 형식을 따르는지도 검증해야 합니다. 바로 이 지점에서 코드 기반 채점이 필요합니다.
코드 채점의 작동 방식
코드 채점은 AI가 생성한 응답의 두 가지 핵심 측면을 검증합니다:
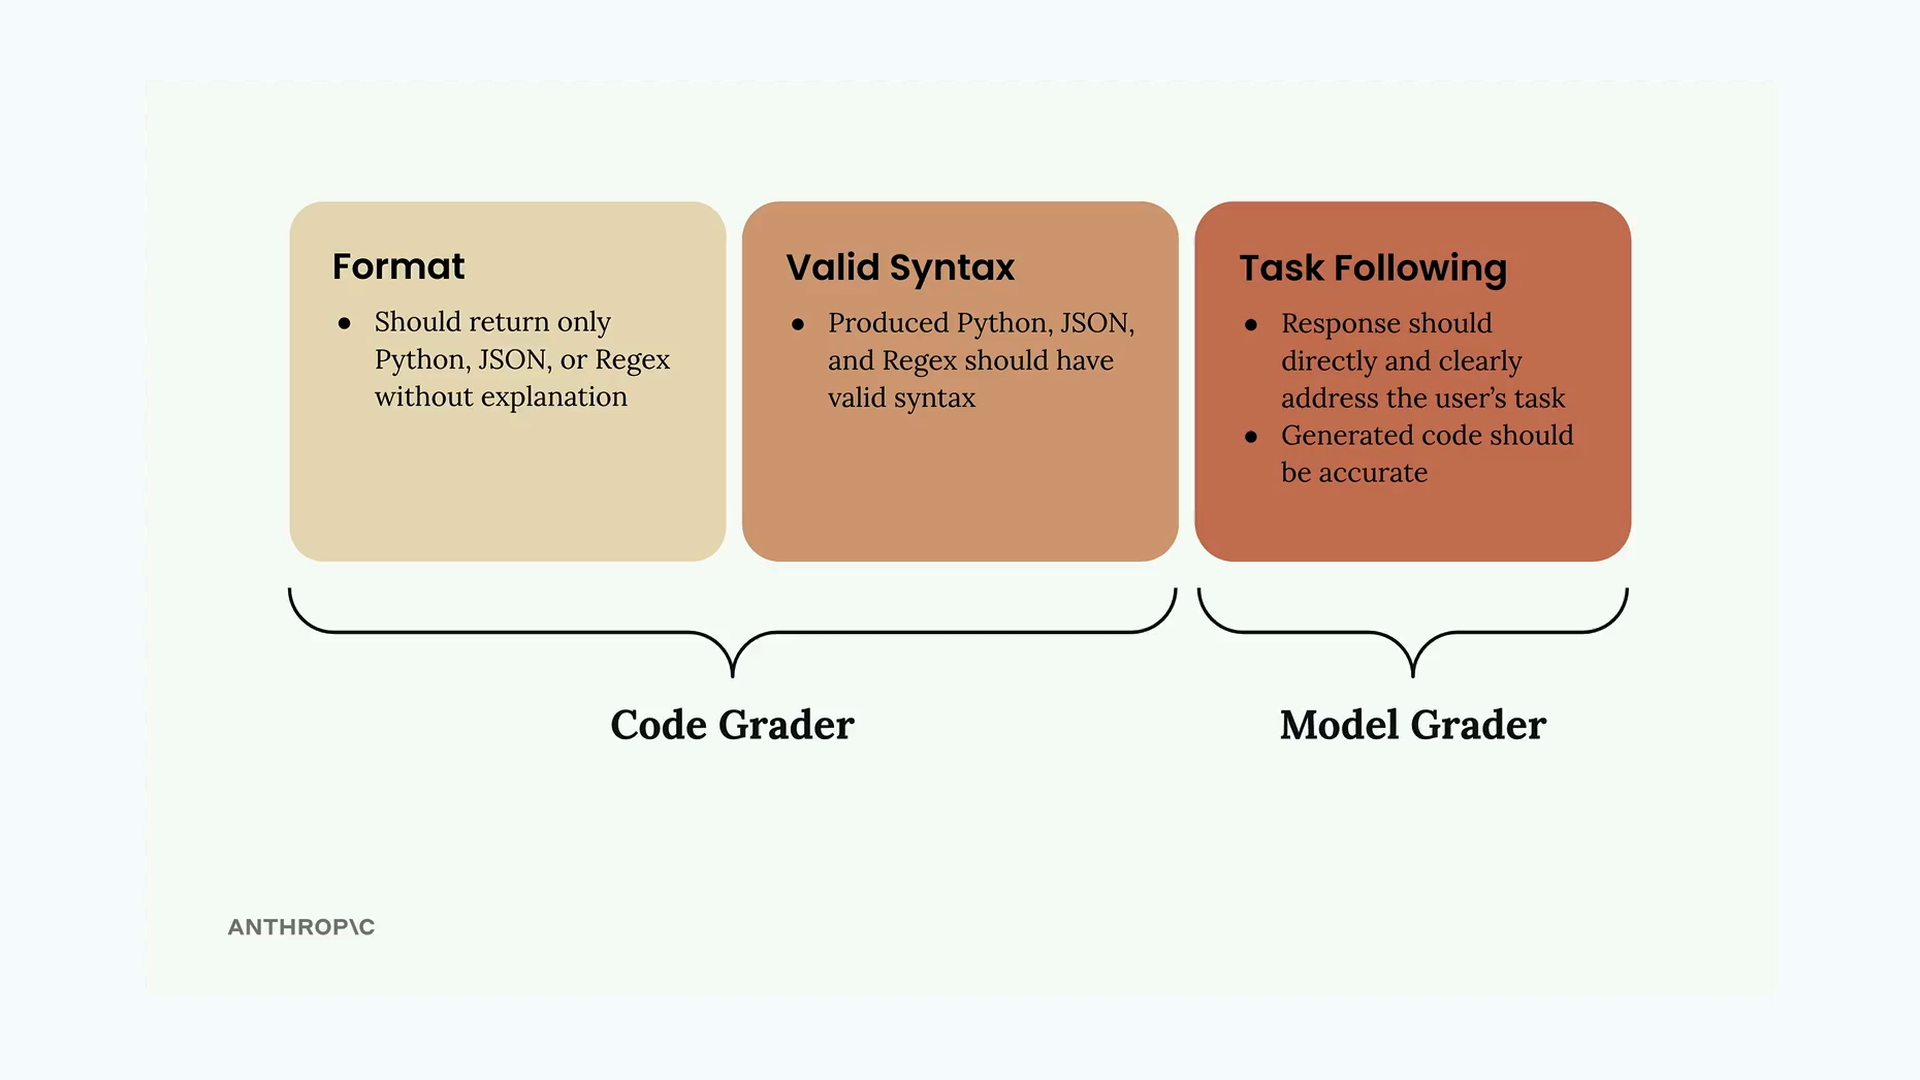
- 형식 - 응답은 설명 없이 요청된 코드 유형(Python, JSON 또는 Regex)만 반환해야 합니다
- 유효한 문법 - 생성된 코드는 의도한 언어로 실제로 올바르게 파싱되어야 합니다
- 작업 수행 - 응답은 질문한 내용을 직접적으로 다루어야 하며 정확해야 합니다
앞의 두 기준은 코드 채점자가 처리하며, 작업 수행은 모델 채점자가 평가합니다. 이 둘이 함께 작동하여 종합적인 평가를 제공합니다.
문법 검증 함수
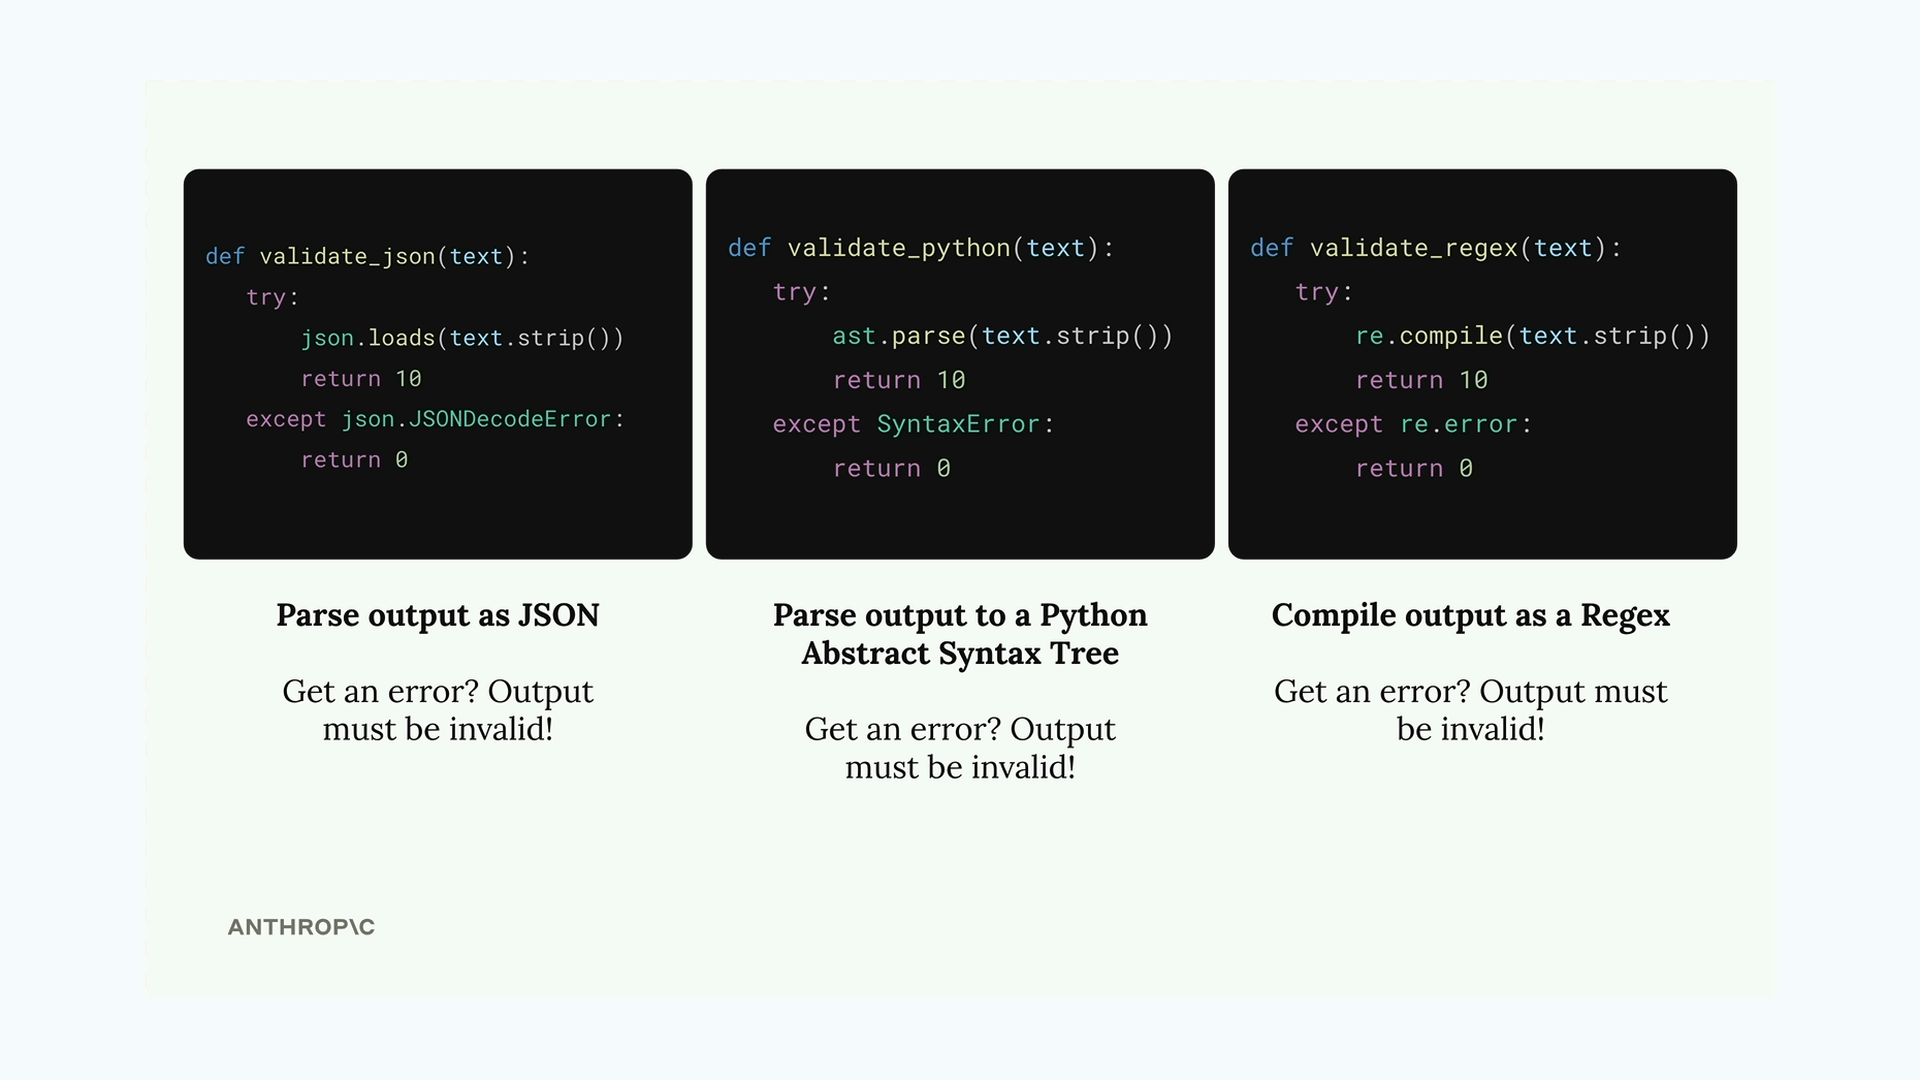
생성된 코드의 문법이 유효한지 확인하려면, 출력을 파싱하려고 시도하는 세 가지 헬퍼 함수를 만들 수 있습니다:
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
각 함수는 텍스트를 각자의 형식으로 파싱하려고 시도합니다. 파싱에 성공하면 완벽한 점수인 10점을 반환합니다. 오류와 함께 실패하면 문법이 유효하지 않은 것이며 0점을 반환합니다.
데이터셋 형식 요구사항
코드 채점자가 어떤 검증기를 사용해야 할지 알 수 있도록, 테스트 케이스에 예상 출력 형식을 명시해야 합니다:
{
    "task": "Create a Python function to validate an AWS IAM username",
    "format": "python"
}
예시 출력 구조에 이 형식 필드를 추가함으로써 데이터셋 생성 프롬프트를 업데이트하여 이를 자동으로 포함시킬 수 있습니다.
프롬프트 명확성 개선하기
AI 모델에서 더 나은 결과를 얻으려면, 프롬프트 지시사항을 예상 출력 형식에 대해 더 구체적으로 작성하세요:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanation또한 코드 블록이 포함된 미리 채워진 어시스턴트 메시지를 사용하여 모델이 원시 코드만 반환하도록 유도할 수 있습니다:
add_assistant_message(messages, "```code")
output = chat(messages, stop_sequences=["```"])
이렇게 하면 Claude가 사전에 Python인지, JSON인지, Regex인지 명시할 필요 없이 코드 내용을 생성하기 시작하도록 지시할 수 있습니다.
점수 결합하기
먼저, 각 테스트 케이스에 맞는 검증기를 선택합니다:
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
    return validate_regex(output)
마지막 단계는 모델 채점자 점수와 코드 채점자 점수를 병합하는 것입니다. 간단한 방법은 run_test_case 내부에서 평균을 구하는 것입니다:
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
이렇게 하면 콘텐츠 품질과 기술적 정확성 모두에 동등한 가중치를 부여합니다. 특정 사용 사례에서 무엇이 더 중요한지에 따라 이러한 가중치를 조정할 수 있습니다.
구현 테스트하기
코드 채점을 구현했다면, 평가를 실행하여 기준 점수를 얻으세요. 점수 자체가 본질적으로 좋거나 나쁜 것은 아니며, 중요한 것은 프롬프트를 개선함으로써 점수를 향상시킬 수 있는지입니다. 이는 주관적인 평가에 의존하는 대신 프롬프트 엔지니어링 진행 상황을 정량적으로 측정할 수 있는 방법을 제공합니다.