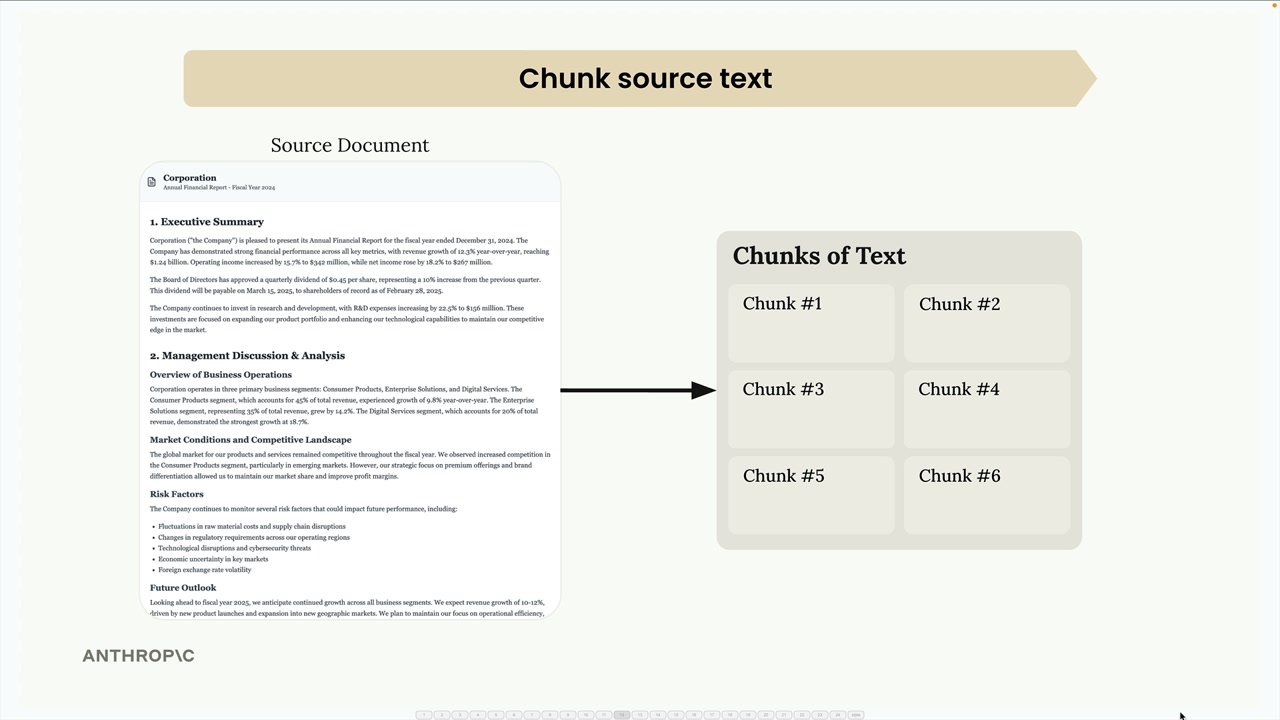
텍스트 청킹은 RAG(Retrieval Augmented Generation) 파이프라인을 구축할 때 가장 중요한 단계 중 하나입니다. 문서를 어떻게 나누는지가 전체 시스템의 품질에 직접적인 영향을 미칩니다. 잘못된 청킹 전략은 관련 없는 컨텍스트가 프롬프트에 삽입되게 하여 AI가 완전히 잘못된 답변을 내놓게 만들 수 있습니다.
다음 예시를 생각해 보세요: 의료 연구와 소프트웨어 엔지니어링에 관한 섹션이 있는 문서가 있다고 가정합니다. 청킹이 제대로 이루어지지 않으면, "올해 엔지니어들이 수정한 버그는 몇 개인가요?"라고 묻는 사용자가 소프트웨어 엔지니어링이 아니라 의료 연구에 관한 정보를 받을 수 있습니다. 단순히 의료 섹션에 다른 맥락에서 "bug"라는 단어가 포함되어 있었기 때문입니다.
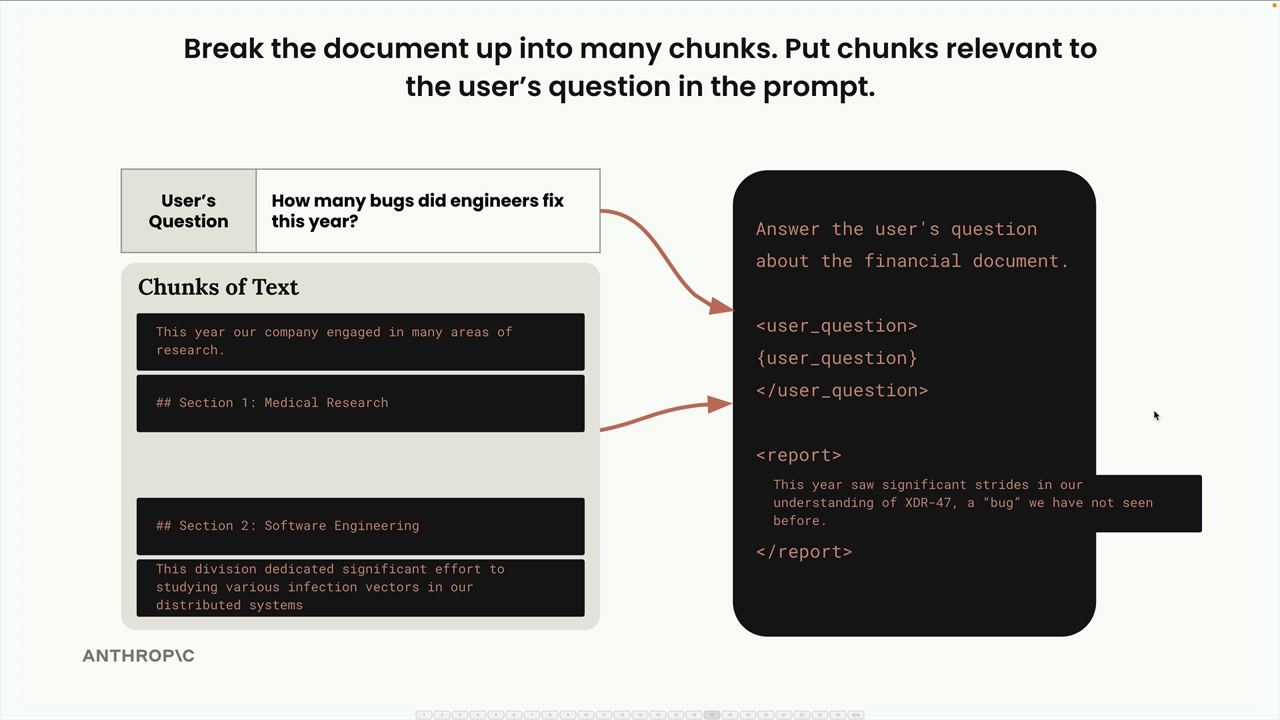
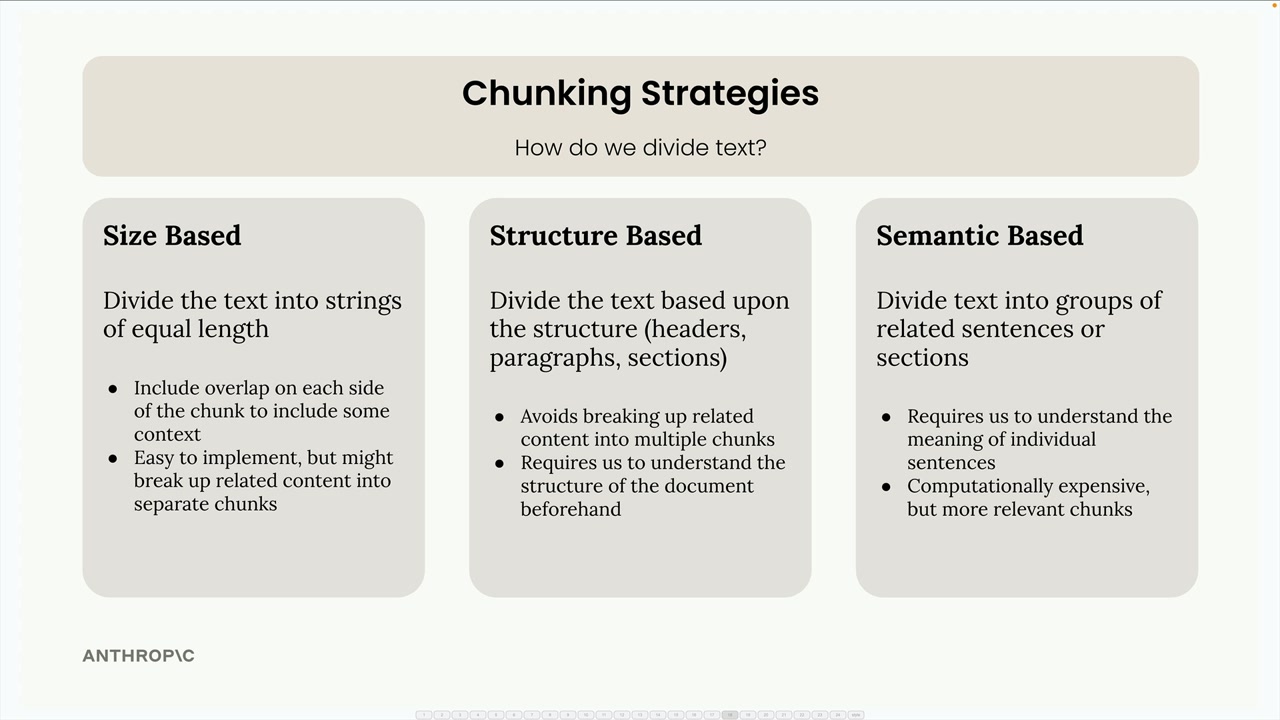
바로 이런 이유로 올바른 청킹 전략을 선택하는 것이 매우 중요합니다. 세 가지 주요 접근 방식을 살펴보겠습니다.
크기 기반 청킹
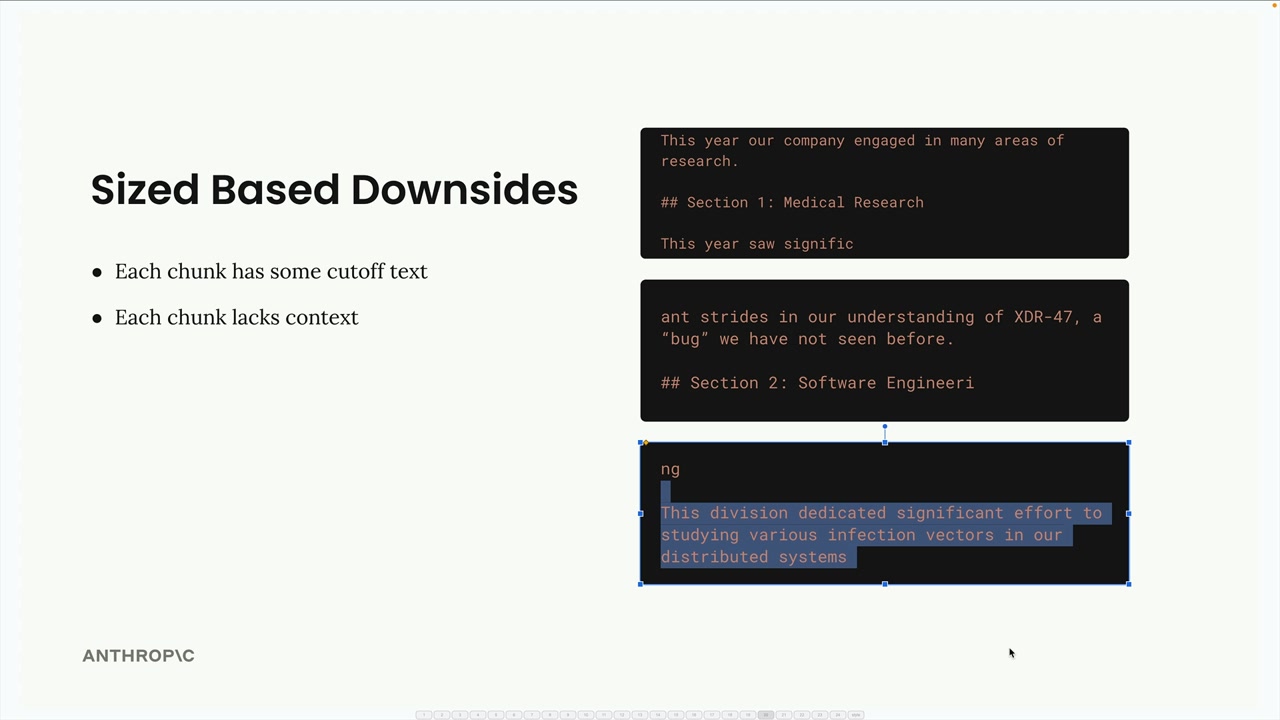
크기 기반 청킹은 가장 단순한 접근 방식으로, 텍스트를 동일한 길이의 문자열로 나눕니다. 325자 길이의 문서가 있다면, 이를 각각 약 108자씩 세 개의 청크로 나눌 수 있습니다.
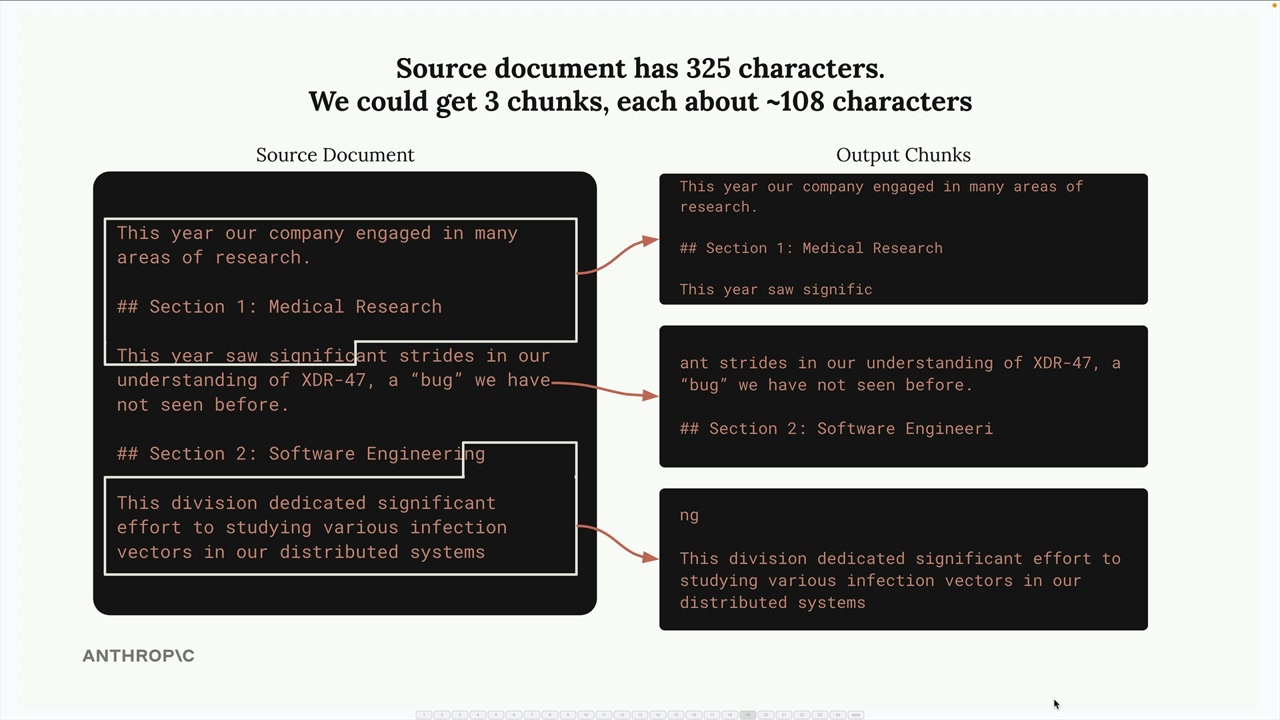
이 방법은 구현이 쉽고 어떤 종류의 문서에도 적용할 수 있지만, 다음과 같은 명확한 단점이 있습니다:
- 단어가 문장 중간에서 잘림
- 청크가 주변 텍스트로부터 얻는 중요한 맥락을 잃음
- 섹션 헤더가 본문 내용과 분리될 수 있음
이런 문제를 해결하기 위해 청크 사이에 중첩(overlap)을 추가할 수 있습니다. 이는 각 청크가 이웃한 청크의 일부 문자를 포함하게 함으로써, 더 나은 맥락을 제공하고 완전한 단어와 문장을 보장합니다.
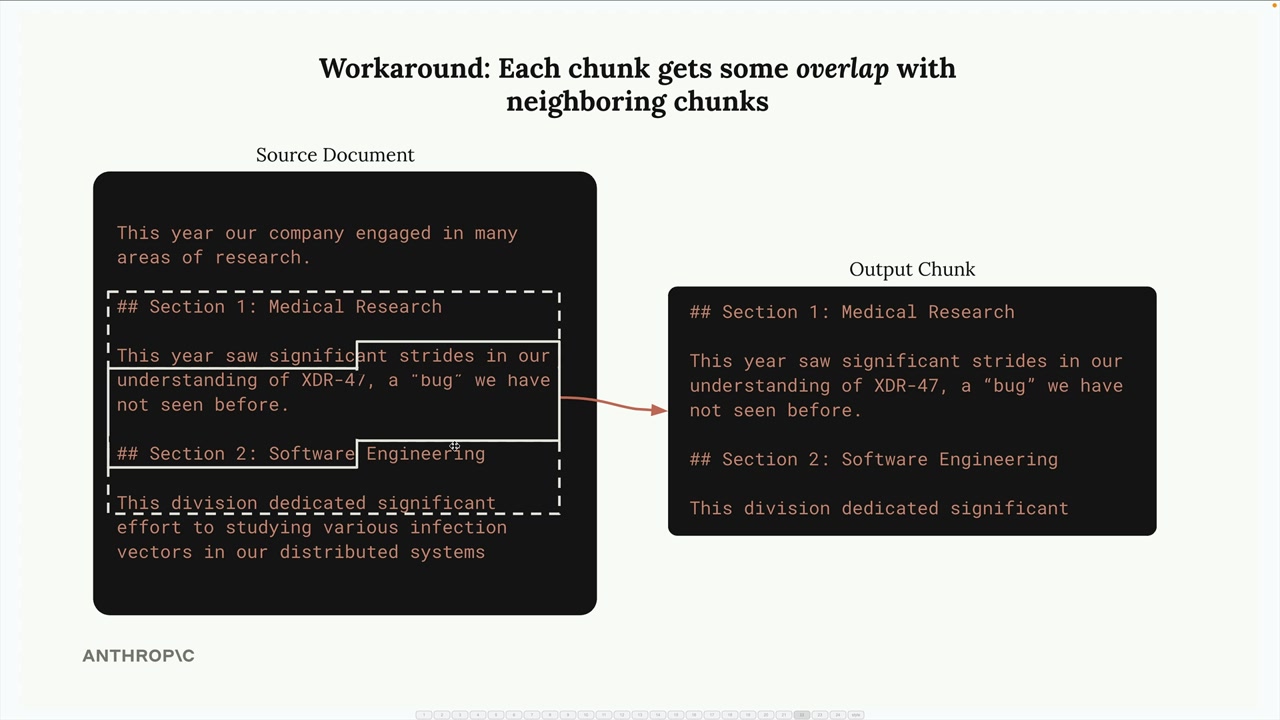
기본적인 구현 방법은 다음과 같습니다:
def chunk_by_char(text, chunk_size=150, chunk_overlap=20):
    chunks = []
    start_idx = 0

    while start_idx < len(text):
        end_idx = min(start_idx + chunk_size, len(text))
        chunk_text = text[start_idx:end_idx]
        chunks.append(chunk_text)

        start_idx = (
            end_idx - chunk_overlap if end_idx < len(text) else len(text)
        )

    return chunks
구조 기반 청킹
구조 기반 청킹은 문서의 자연스러운 구조, 즉 헤더, 단락, 섹션을 기준으로 텍스트를 나눕니다. 이 방법은 Markdown 파일처럼 형식이 잘 갖춰진 문서에서 특히 효과적입니다.
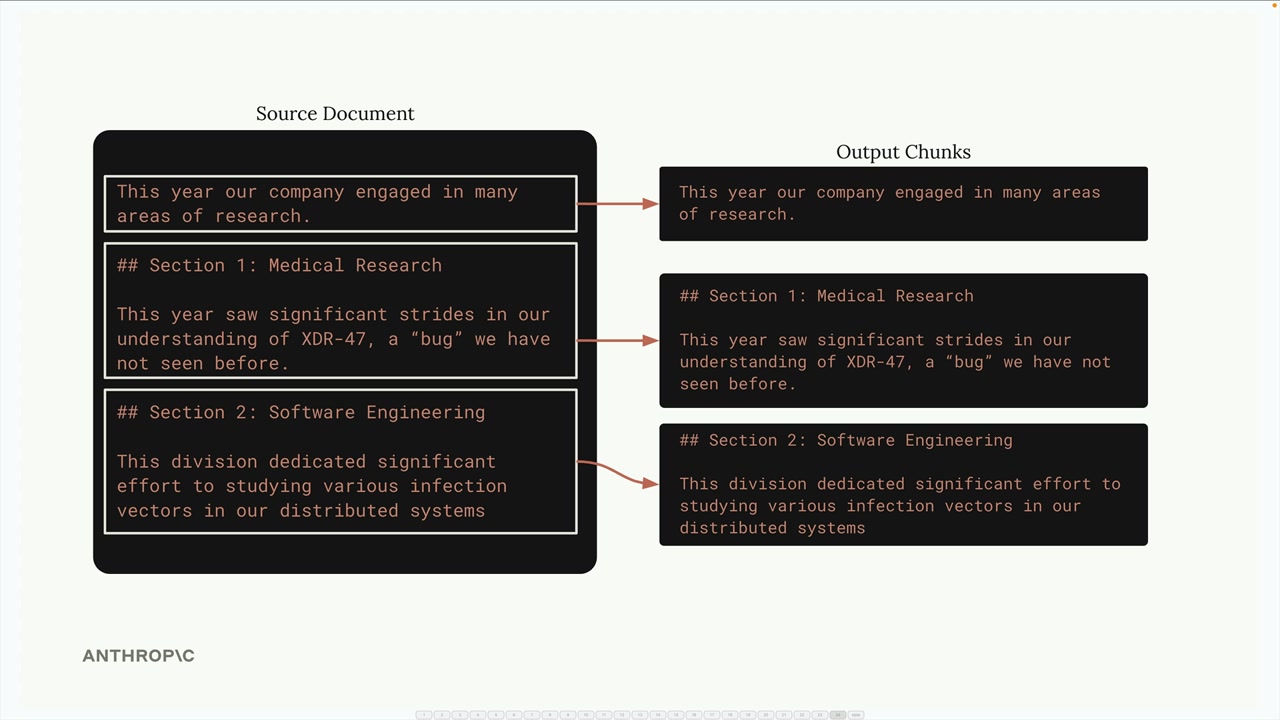
Markdown 문서의 경우, 헤더 마커를 기준으로 분할할 수 있습니다:
import re

def chunk_by_section(document_text):
    pattern = r"\n## "
    return re.split(pattern, document_text)
이 접근 방식은 각 청크가 하나의 완전한 섹션을 나타내기 때문에 가장 깔끔하고 의미 있는 청크를 만들어냅니다. 하지만 이는 문서 구조가 보장될 때만 효과가 있습니다. 실제로 많은 문서들은 명확한 구조적 마커가 없는 일반 텍스트나 PDF 형태입니다.
의미 기반 청킹
의미 기반 청킹은 가장 정교한 접근 방식입니다. 텍스트를 문장 단위로 나눈 다음, 자연어 처리를 사용해 연속된 문장들이 얼마나 관련이 있는지 파악합니다. 관련성이 높은 문장 그룹으로 청크를 구성합니다.
이 방법은 계산 비용이 많이 들지만 가장 관련성 높은 청크를 만들어냅니다. 개별 문장의 의미를 이해해야 하며, 다른 전략들보다 구현이 더 복잡합니다.
문장 기반 청킹
실용적인 중간 지점은 문장 단위로 청킹하는 것입니다. 정규 표현식을 사용해 텍스트를 개별 문장으로 나눈 다음, 선택적인 중첩을 두어 청크로 묶습니다:
def chunk_by_sentence(text, max_sentences_per_chunk=5, overlap_sentences=1):
    sentences = re.split(r"(?<=[.!?])\s+", text)

    chunks = []
    start_idx = 0

    while start_idx < len(sentences):
        end_idx = min(start_idx + max_sentences_per_chunk, len(sentences))
        current_chunk = sentences[start_idx:end_idx]
        chunks.append(" ".join(current_chunk))

        start_idx += max_sentences_per_chunk - overlap_sentences

        if start_idx < 0:
            start_idx = 0

    return chunks
전략 선택하기
선택은 전적으로 사용 사례와 문서의 보장 조건에 따라 달라집니다:
- 구조 기반: 문서 형식을 직접 통제할 수 있는 경우(예: 사내 보고서)에 가장 좋은 결과를 얻습니다
- 문장 기반: 대부분의 텍스트 문서에 적합한 중간 지점입니다
- 크기 기반: 코드를 포함한 모든 콘텐츠 유형에서 작동하는 가장 안정적인 대안입니다
중첩을 적용한 크기 기반 청킹은 단순하고 신뢰할 수 있으며 어떤 문서 유형에도 적용할 수 있기 때문에 실무에서 흔히 기본 선택지로 사용됩니다. 완벽한 결과를 보장하지는 않지만, 파이프라인을 망가뜨리지 않을 만큼 합리적인 청크를 꾸준히 만들어냅니다.
기억하세요: 단 하나의 "최선의" 청킹 전략은 존재하지 않습니다. 올바른 접근 방식은 특정 문서, 사용 사례, 그리고 구현 복잡성과 청크 품질 사이에서 기꺼이 받아들일 수 있는 트레이드오프에 따라 달라집니다.