Retrieval Augmented Generation(RAG)은 하나의 프롬프트에 담기에는 너무 큰 대규모 문서를 다룰 수 있도록 도와주는 기법입니다. 모든 내용을 하나의 거대한 프롬프트에 욱여넣는 대신, RAG는 문서를 여러 청크(chunk)로 나누고 질문에 답할 때 가장 관련성 높은 부분만 포함시킵니다.
대규모 문서의 문제점
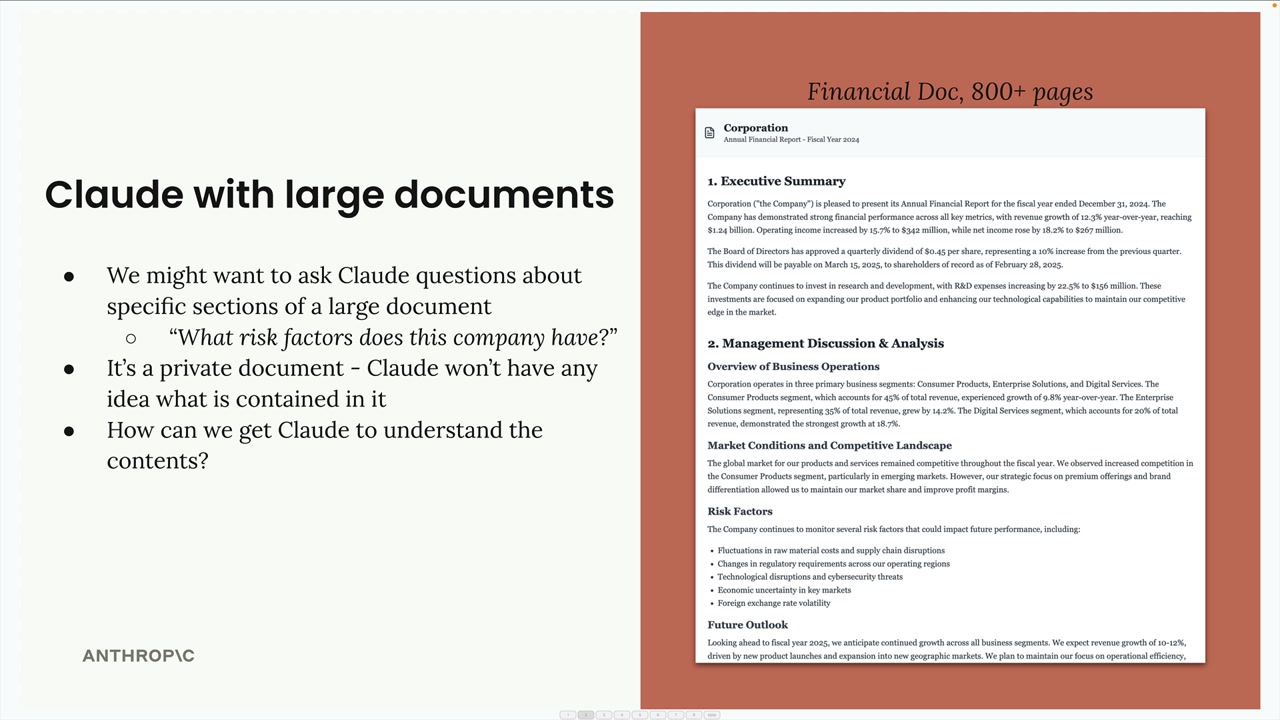
800페이지 분량의 재무 문서가 있고 "이 회사의 리스크 요인은 무엇인가요?"와 같이 구체적인 질문을 Claude에게 하고 싶다고 상상해 보세요. 문서에서 관련 정보를 어떻게든 Claude에게 전달해야 하지만, 프롬프트에 포함할 수 있는 텍스트 양에는 한계가 있습니다.
옵션 1: 모든 내용을 프롬프트에 포함하기
첫 번째 방법은 단순합니다 - 문서에서 모든 텍스트를 추출해 사용자의 질문과 함께 프롬프트에 채워 넣는 것입니다. 프롬프트는 다음과 같은 모습일 것입니다:
Answer the user's question about the financial document.

<user_question>
{user_question}
</user_question>

<financial_document>
{financial_document}
</financial_document>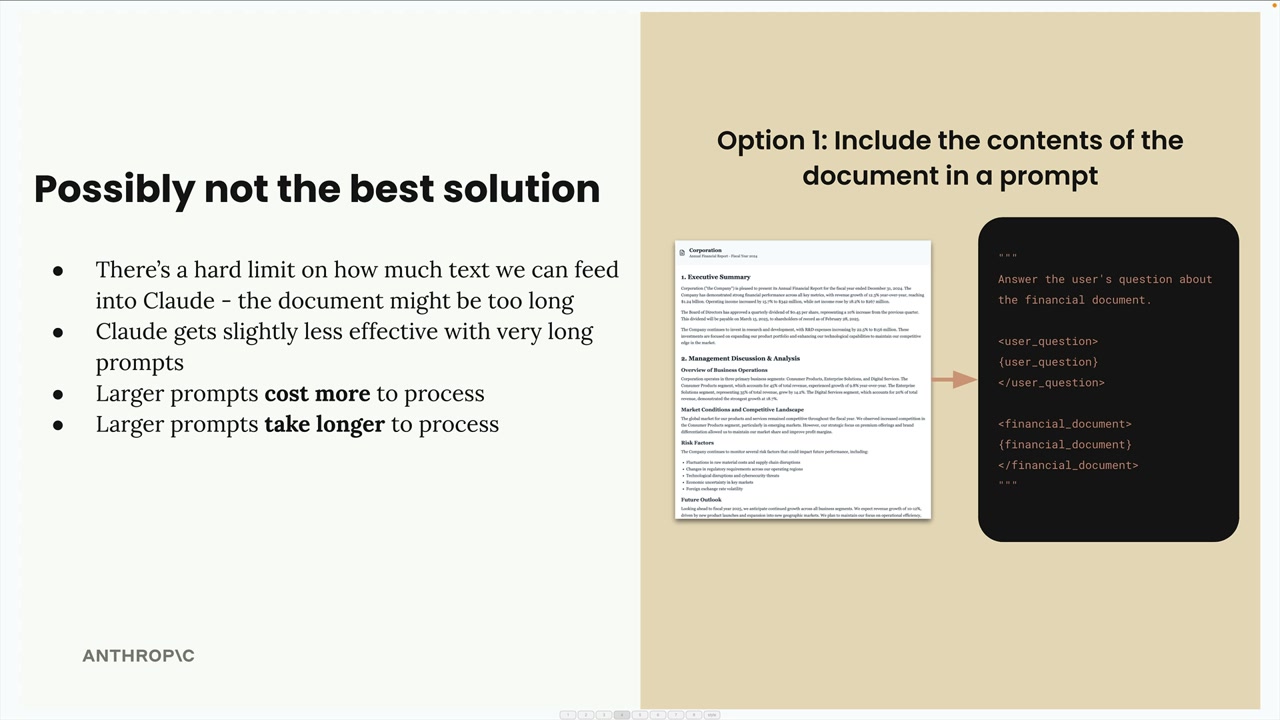
이 방법에는 심각한 한계가 있습니다:
- 프롬프트 길이에는 엄격한 제한이 있으며 - 문서가 너무 길 수 있습니다
- 매우 긴 프롬프트에서는 Claude의 효과가 떨어집니다
- 프롬프트가 길수록 처리 비용이 더 많이 듭니다
- 프롬프트가 길수록 처리 시간이 더 오래 걸립니다
옵션 2: 문서를 청크로 나누기
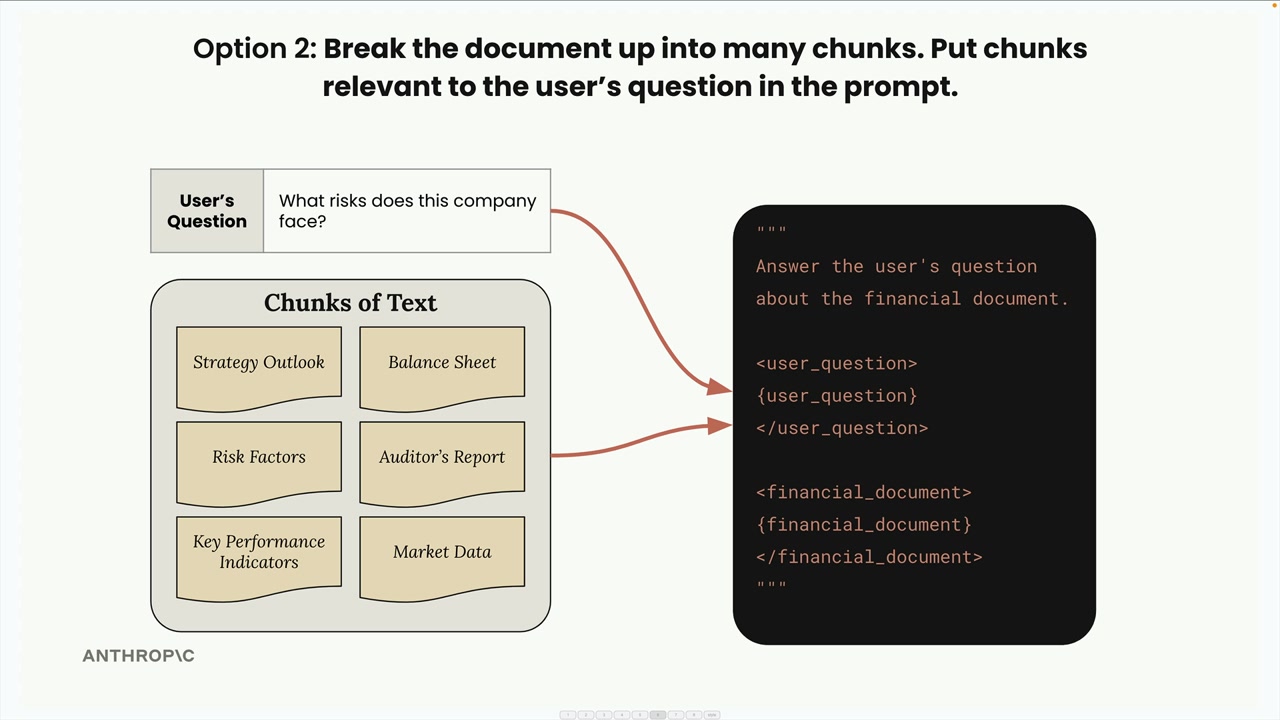
RAG는 더 똑똑한 방식을 취합니다. 먼저, 전처리 단계에서 문서를 더 작은 청크로 나눕니다. 그런 다음 사용자가 질문을 하면, 해당 질문과 가장 관련성 높은 청크를 찾아 그것만 프롬프트에 포함시킵니다.
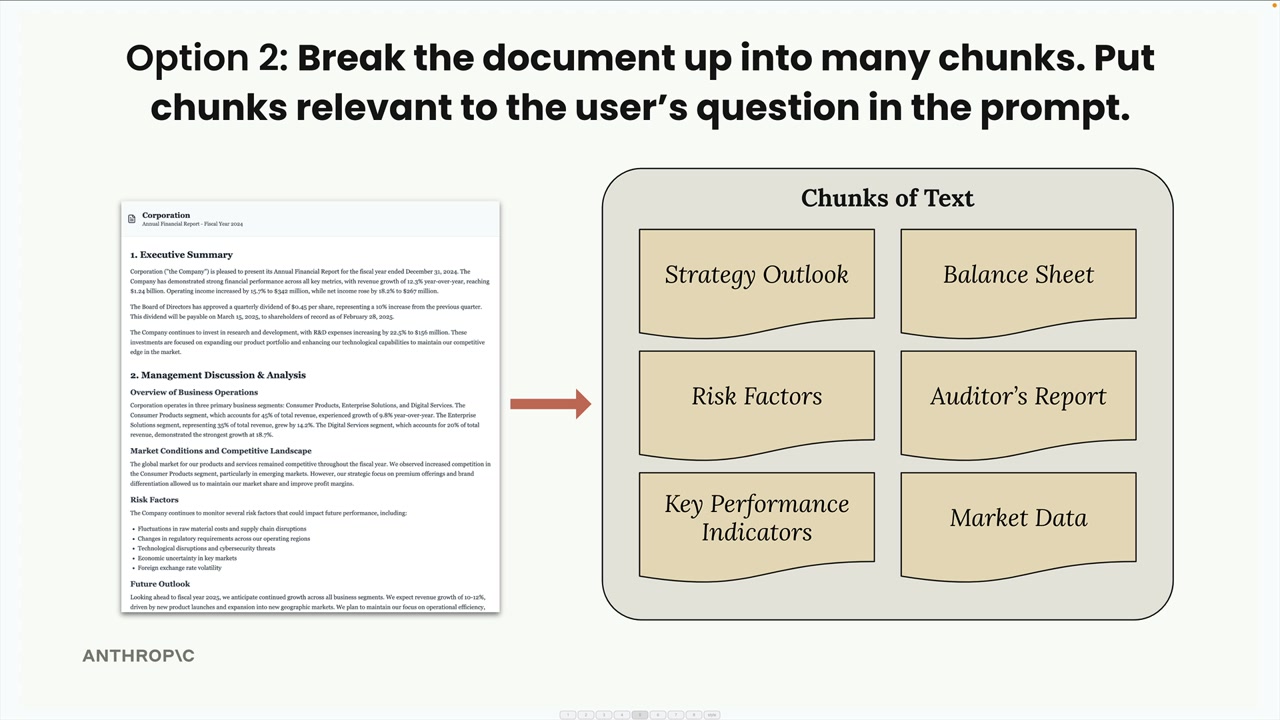
작동 방식은 이렇습니다: 누군가 "이 회사가 직면한 리스크는 무엇인가요?"라고 물으면, 청크들을 검색해 "Risk Factors" 섹션을 찾은 뒤 그 관련 청크만 프롬프트에 포함시킵니다.
RAG의 이점
- Claude가 가장 관련성 높은 내용에만 집중할 수 있습니다
- 매우 큰 문서까지 확장 가능합니다
- 여러 문서를 동시에 다룰 수 있습니다
- 프롬프트가 작을수록 비용이 적게 들고 더 빠르게 실행됩니다
RAG의 과제
- 문서를 청크로 나누는 전처리 단계가 필요합니다
- "관련성 있는" 청크를 찾기 위한 검색 메커니즘이 필요합니다
- 포함된 청크에 Claude가 필요로 하는 모든 맥락이 담겨 있지 않을 수 있습니다
- 텍스트를 청크로 나누는 방법은 다양한데 - 어떤 방식이 가장 좋을까요?
예를 들어, 문서를 동일한 크기의 부분으로 나눌 수도 있고, 머리글이나 섹션 같은 문서 구조를 기준으로 청크를 만들 수도 있습니다. 각 방식에는 여러분의 특정 사용 사례에 맞춰 평가해야 할 장단점이 있습니다.
RAG를 사용해야 하는 경우
RAG는 많은 기술적 결정을 수반하며, 모든 내용을 단순히 프롬프트에 포함시키는 것보다 더 많은 작업이 필요합니다. 특정 애플리케이션에서 이러한 이점이 복잡성을 상쇄할 만한지 분석해야 합니다. 특히 매우 큰 문서나 여러 문서를 다루는 경우, 또는 비용과 성능을 최적화해야 하는 경우에 특히 유용합니다.
핵심은 RAG가 단순성을 확장성과 효율성과 맞바꾼다는 점입니다. 제대로 구현하려면 더 많은 사전 작업이 필요하지만, 단순히 프롬프트에 모든 내용을 채워 넣는 방식으로는 다루기 불가능했을 문서 모음을 다룰 수 있게 해줍니다.