프롬프트 평가 워크플로우를 구축할 때, 채점 시스템은 출력 품질에 대한 객관적인 신호를 제공합니다. 그레이더(grader)는 모델 출력을 받아 일종의 측정 가능한 피드백을 반환하며, 일반적으로 1부터 10 사이의 숫자로 표현되고 10은 높은 품질을, 1은 낮은 품질을 나타냅니다.
그레이더의 유형
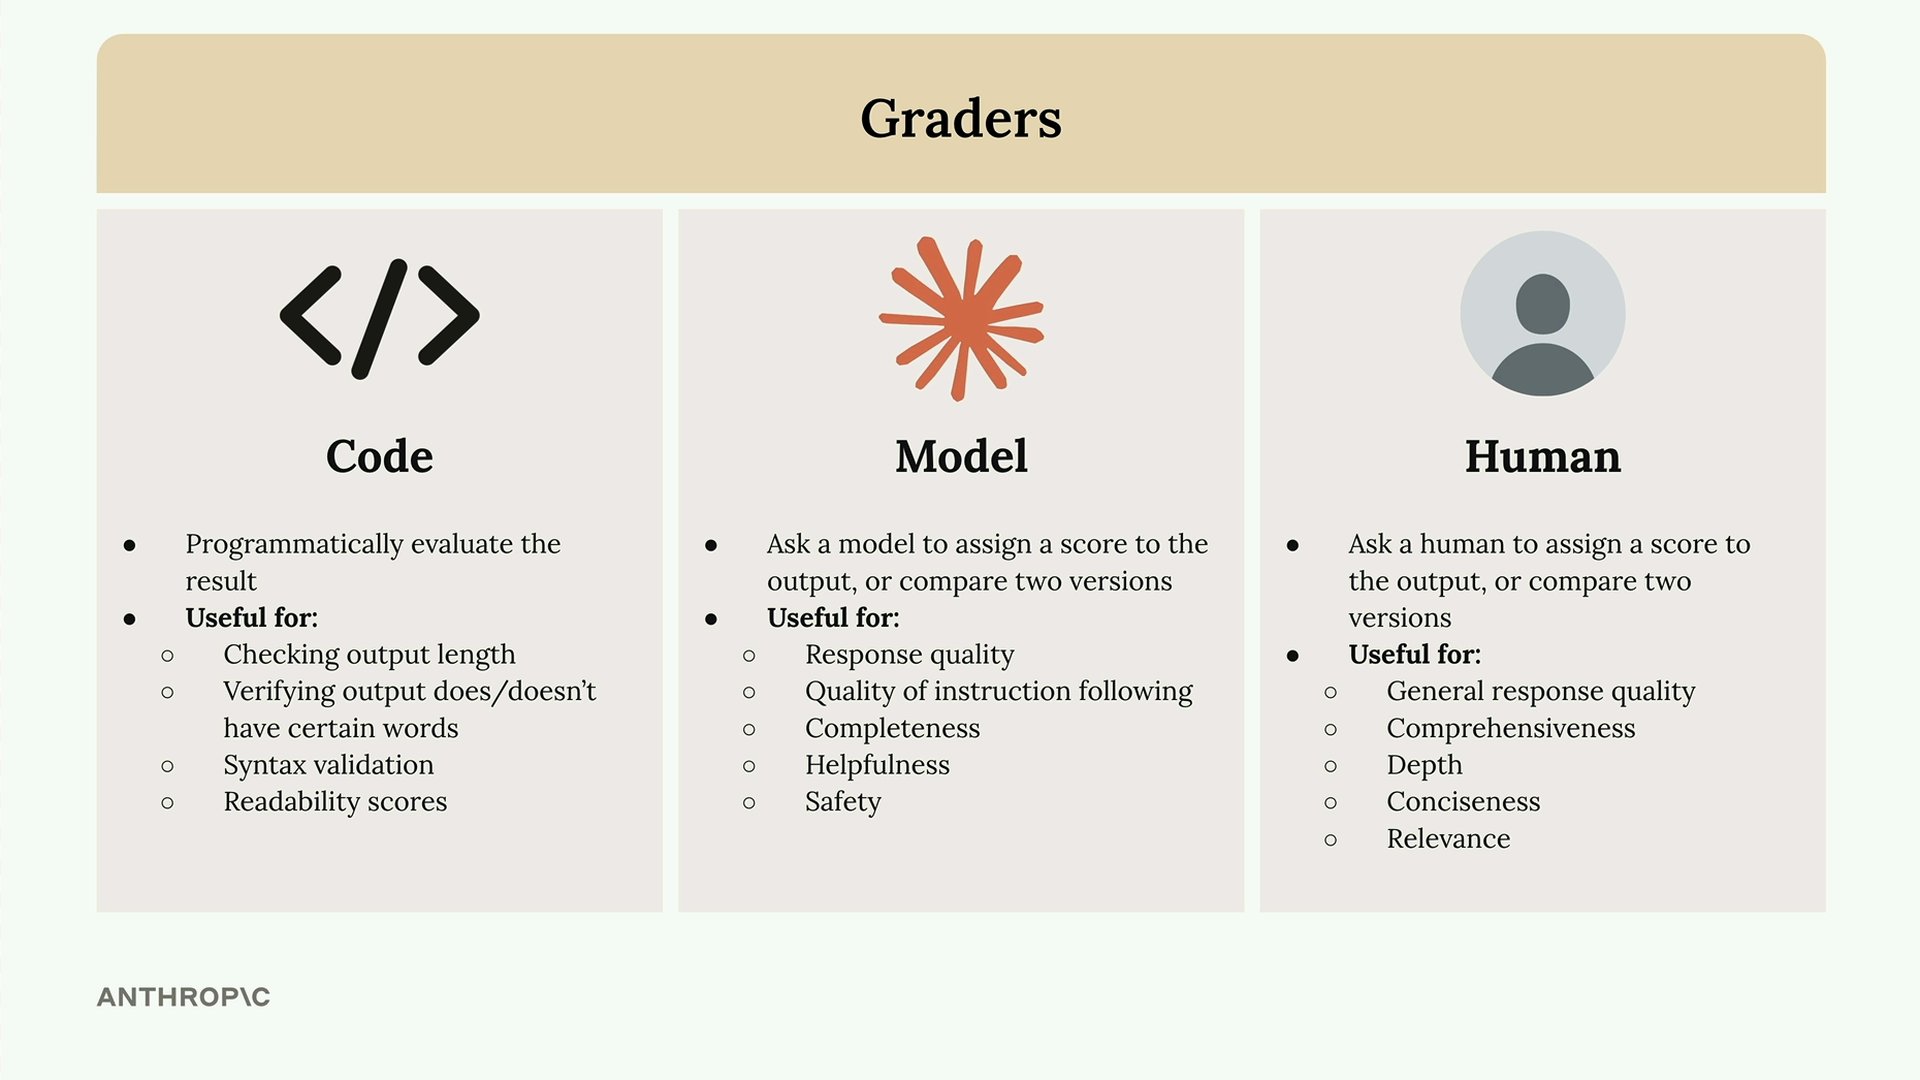
모델 출력을 채점하는 데에는 세 가지 주요 접근 방식이 있습니다:
- 코드 그레이더 - 커스텀 로직을 사용하여 프로그래밍 방식으로 출력을 평가합니다
- 모델 그레이더 - 다른 AI 모델을 사용하여 품질을 평가합니다
- 휴먼 그레이더 - 사람이 수동으로 출력을 검토하고 점수를 매깁니다
코드 그레이더
코드 그레이더를 사용하면 상상할 수 있는 모든 프로그래밍 방식의 검사를 구현할 수 있습니다. 일반적인 사용 사례는 다음과 같습니다:
- 출력 길이 확인
- 특정 단어의 포함 여부 확인
- JSON, Python, 또는 정규식에 대한 구문 검증
- 가독성 점수
유일한 요구사항은 코드가 사용 가능한 신호를 반환해야 한다는 것이며, 보통 1부터 10 사이의 숫자입니다.
모델 그레이더
모델 그레이더는 원래 출력을 또 다른 API 호출에 입력하여 평가합니다. 이 접근 방식은 다음을 평가하는 데 엄청난 유연성을 제공합니다:
- 응답 품질
- 지시 사항 준수 품질
- 완전성
- 유용성
- 안전성
휴먼 그레이더
휴먼 그레이더는 가장 큰 유연성을 제공하지만 시간이 많이 걸리고 번거롭습니다. 다음을 평가하는 데 유용합니다:
- 전반적인 응답 품질
- 포괄성
- 깊이
- 간결성
- 관련성
평가 기준 정의하기
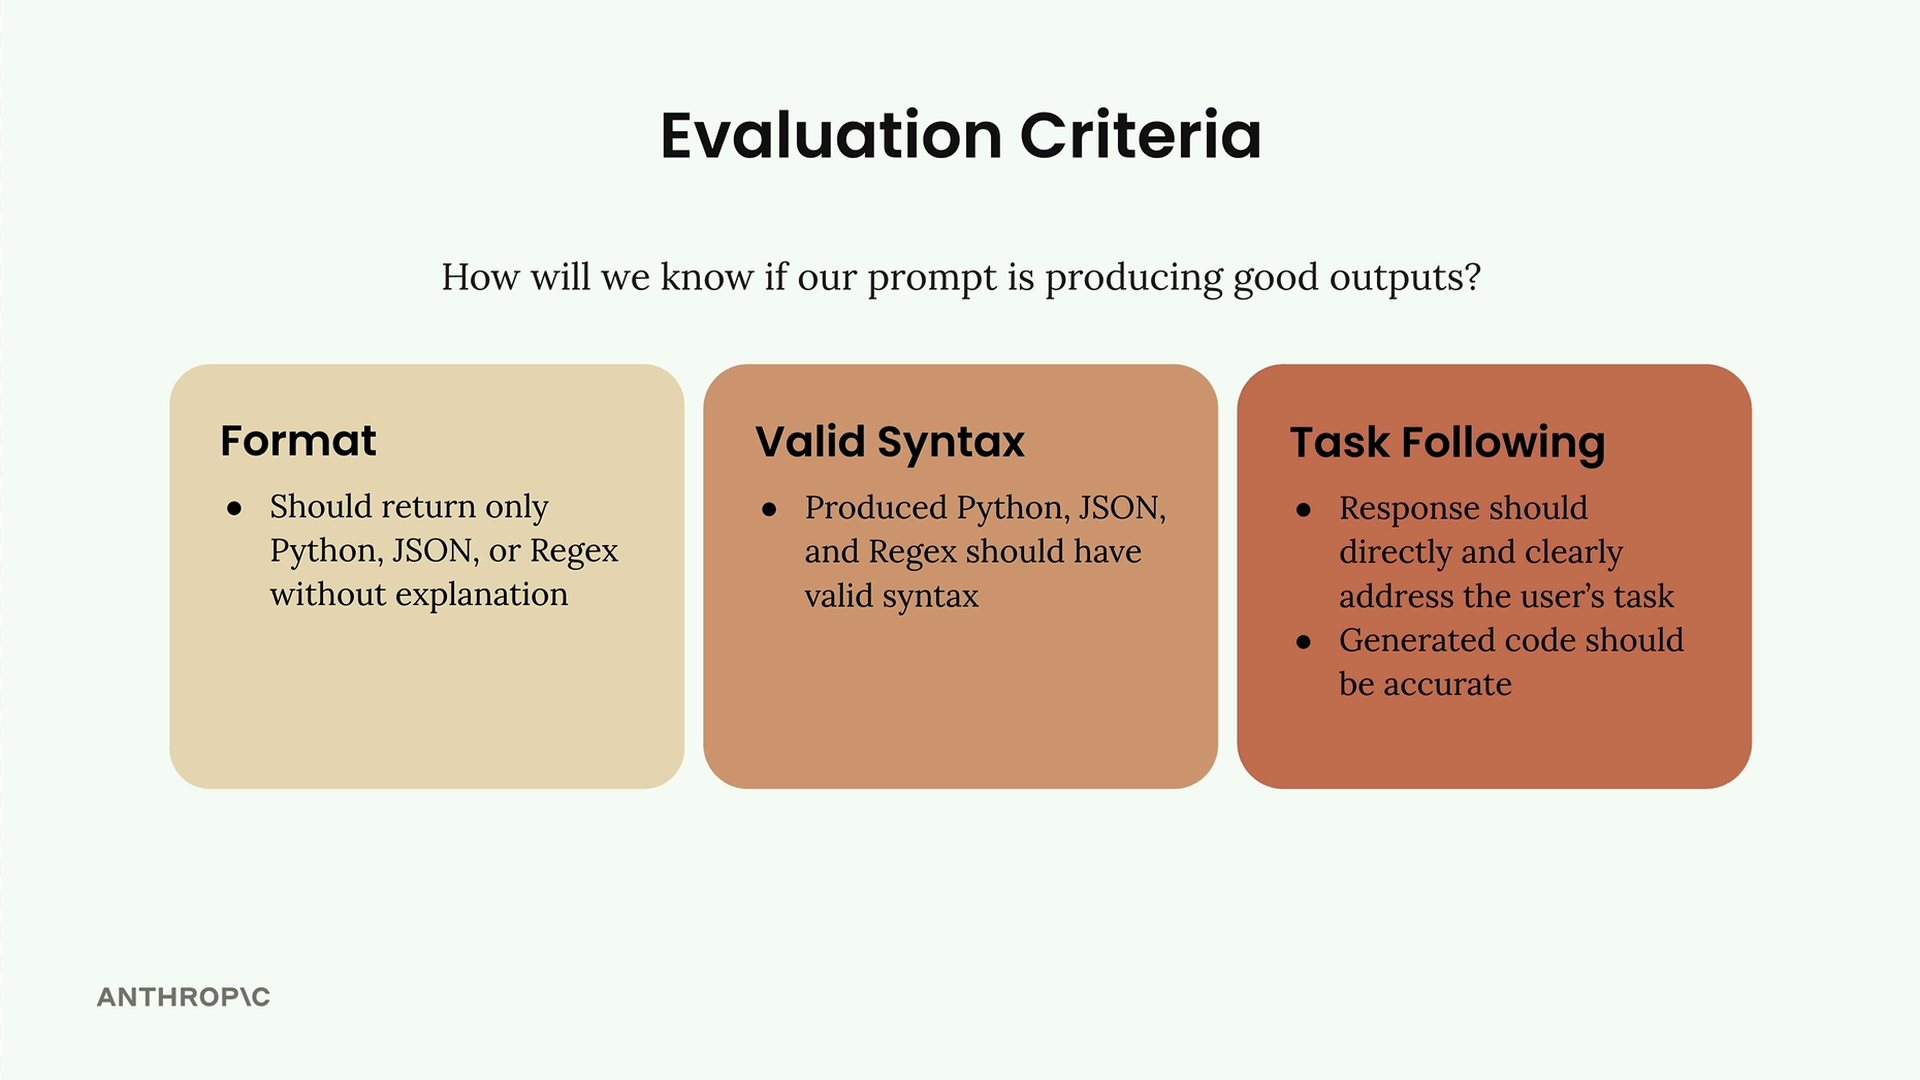
그레이더를 구현하기 전에 명확한 평가 기준이 필요합니다. 코드 생성 프롬프트의 경우, 다음에 초점을 맞출 수 있습니다:
- 형식 - 설명 없이 Python, JSON, 또는 정규식만 반환해야 합니다
- 유효한 구문 - 생성된 코드는 유효한 구문을 가져야 합니다
- 작업 준수 - 응답은 정확한 코드로 사용자의 작업을 직접적으로 다루어야 합니다
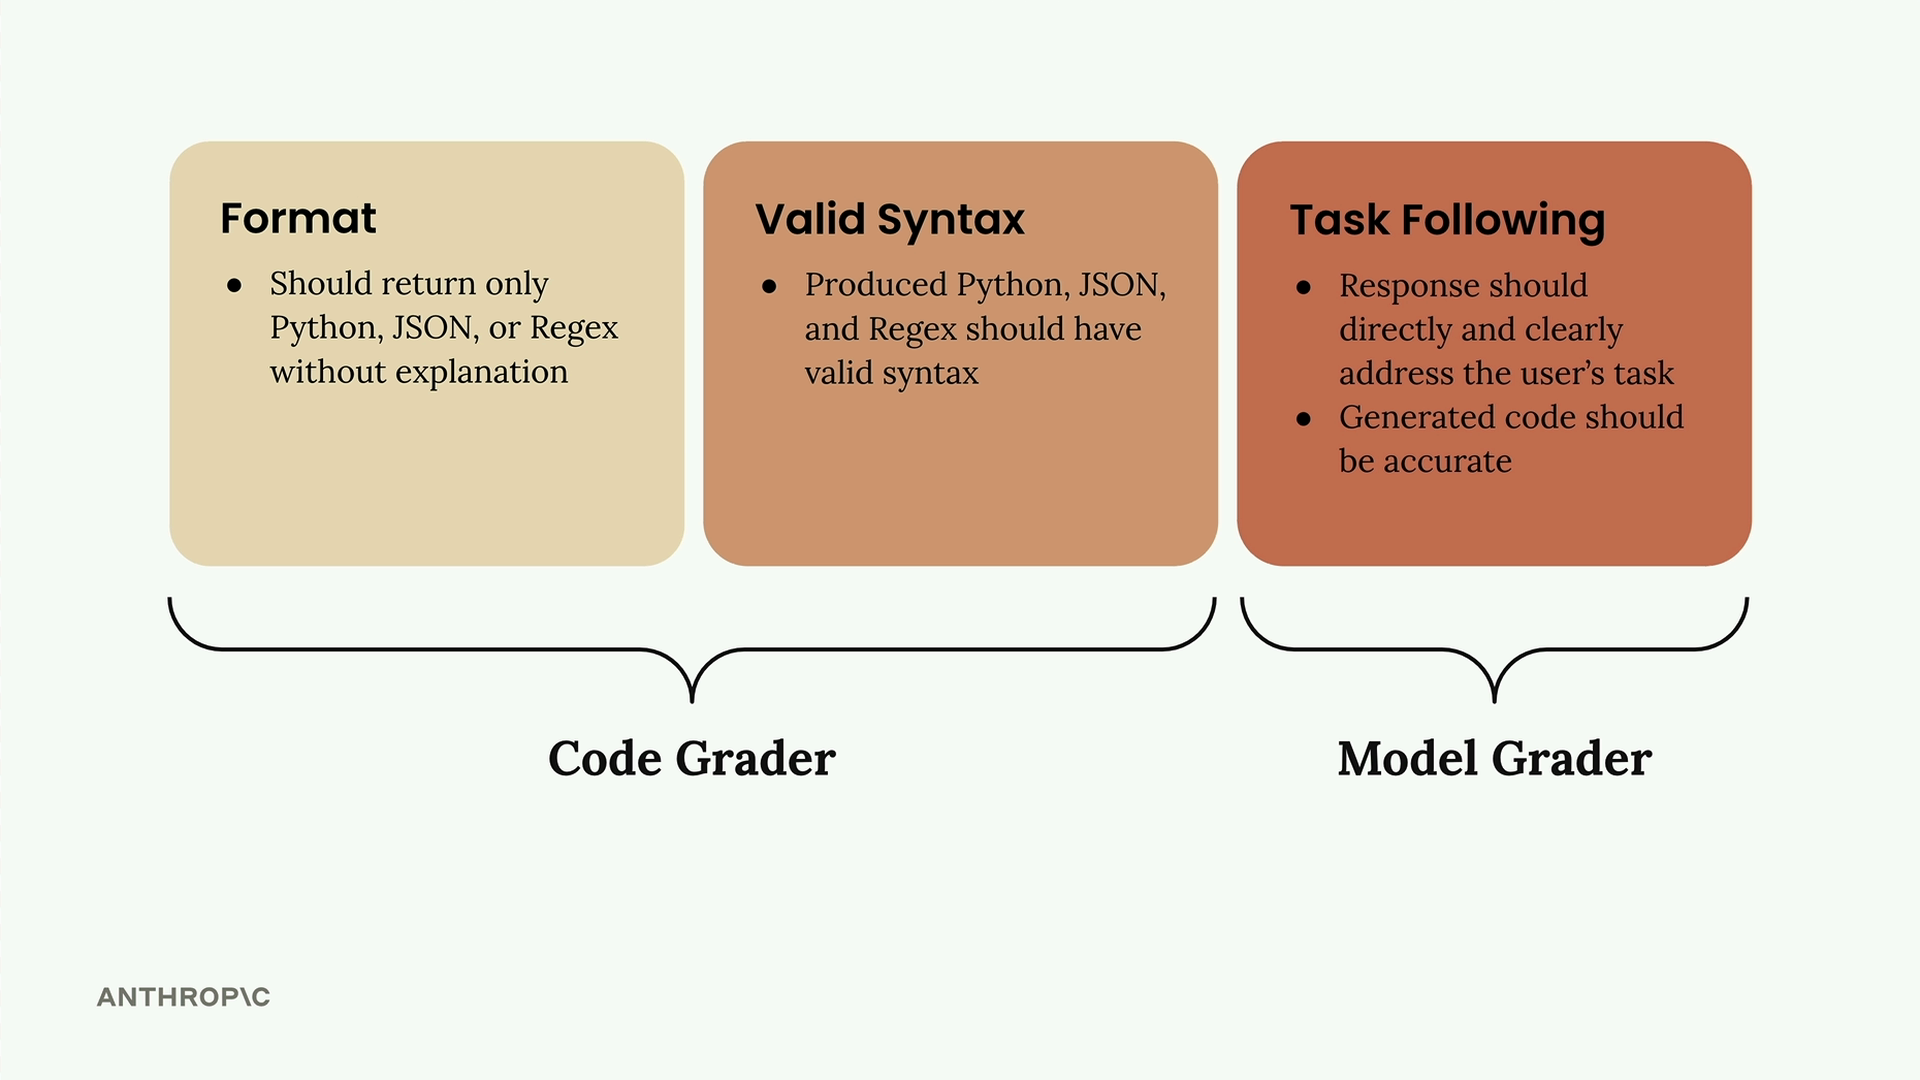
처음 두 기준은 코드 그레이더와 잘 맞지만, 작업 준수는 그 유연성 때문에 모델 그레이더에 더 적합합니다.
모델 그레이더 구현하기
모델 그레이더 함수를 구축하는 방법은 다음과 같습니다:
def grade_by_model(test_case, output):
    # 평가 프롬프트 생성
    eval_prompt = f"""
    You are an expert code reviewer. Evaluate this AI-generated solution.

    Task: {test_case["task"]}
    Solution: {output}

    Provide your evaluation as a structured JSON object with:
    - "strengths": An array of 1-3 key strengths
    - "weaknesses": An array of 1-3 key areas for improvement
    - "reasoning": A concise explanation of your assessment
    - "score": A number between 1-10
    """

    messages = []
    add_user_message(messages, eval_prompt)
    add_assistant_message(messages, "```json")

    eval_text = chat(messages, stop_sequences=["```"])
    return json.loads(eval_text)
핵심은 점수와 함께 강점, 약점, 그리고 그 근거를 요청하는 것입니다. 이러한 맥락이 없으면 모델은 보통 6점 전후의 중간 점수로 기본값을 설정하는 경향이 있습니다.
워크플로우에 채점 통합하기
테스트 케이스 러너를 업데이트하여 그레이더를 호출하도록 합니다:
def run_test_case(test_case):
    output = run_prompt(test_case)

    # 출력 채점
    model_grade = grade_by_model(test_case, output)
    score = model_grade["score"]
    reasoning = model_grade["reasoning"]

    return {
        "output": output,
        "test_case": test_case,
        "score": score,
        "reasoning": reasoning
    }
마지막으로, 모든 테스트 케이스에 걸친 평균 점수를 계산합니다:
from statistics import mean

def run_eval(dataset):
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    average_score = mean([result["score"] for result in results])
    print(f"Average score: {average_score}")

    return results
이를 통해 프롬프트를 반복 개선하면서 추적할 수 있는 객관적인 지표를 얻을 수 있습니다. 모델 그레이더는 다소 변덕스러울 수 있지만, 개선 사항을 측정하기 위한 일관된 기준선을 제공합니다.