El enfoque de recuperación híbrida que hemos creado funciona bien, pero todavía hay algunos detalles que pulir. Cuando buscas términos específicos o usas abreviaturas, los resultados podrían no estar perfectamente ordenados. Por ejemplo, preguntar "¿Qué hizo el equipo de ingeniería con INC-2023-Q4-011?" podría devolver primero la sección de ciberseguridad, aunque la sección de ingeniería de software sea más relevante para esa consulta específica.
Reclasificación basada en LLM
La reclasificación agrega otro paso de post-procesamiento después de fusionar los resultados de tu índice vectorial y tu índice BM25. El concepto es sencillo: toma tus resultados de búsqueda y pide a Claude que los reordene según su relevancia para la pregunta del usuario.
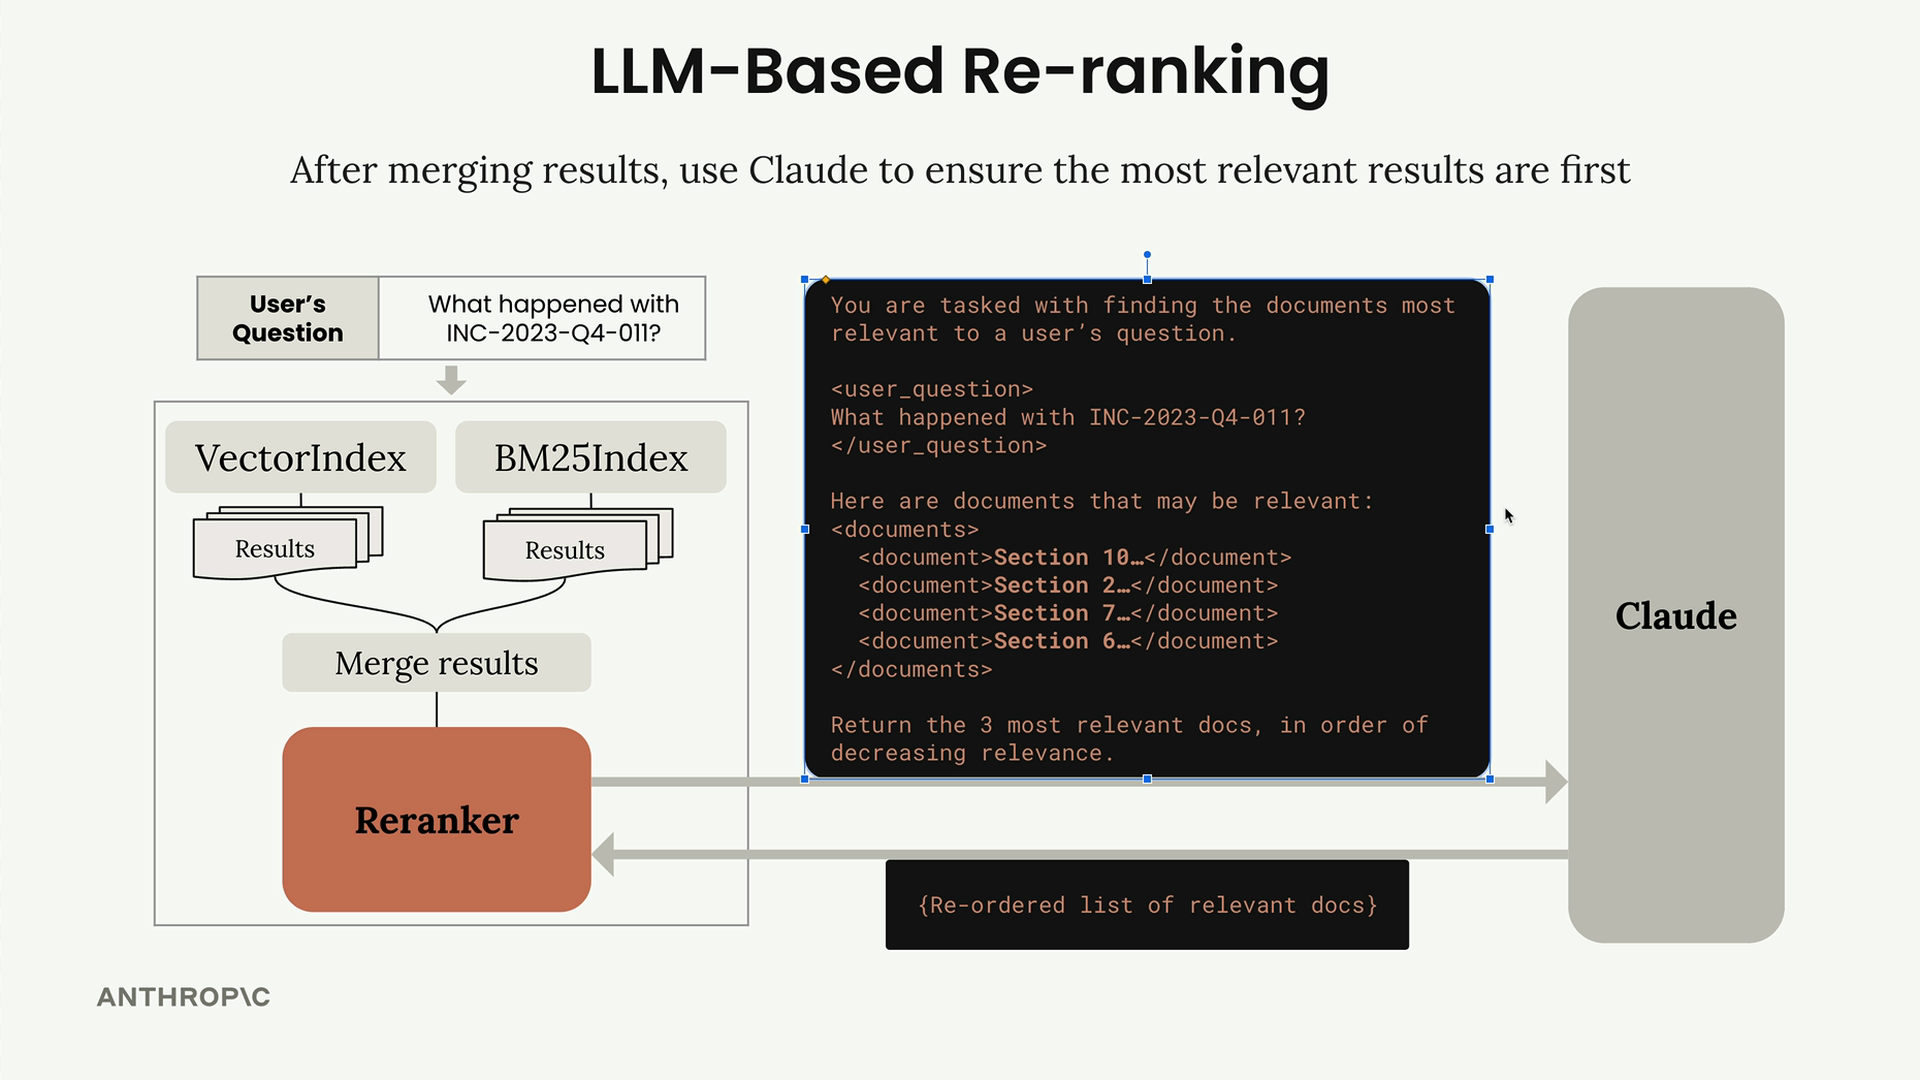
Así es como funciona el proceso:
- Ejecuta tu búsqueda híbrida (vectorial + BM25) como de costumbre
- Fusiona los resultados como antes
- Pasa los resultados fusionados a una función de reclasificación
- El reclasificador envía todo a Claude con un prompt específico
- Claude devuelve una lista reordenada de los documentos más relevantes
Indicaciones del sistema
El prompt de reclasificación está diseñado para ser claro y específico. Le proporcionas a Claude la pregunta del usuario y todos los documentos que parecen relevantes, y luego le pides una tarea sencilla: devolver los documentos más relevantes en orden decreciente de relevancia.
Una estructura típica de prompt se ve así:
You are tasked with finding the documents most relevant to a user's question.

<user_question>
What happened with INC-2023-Q4-011?
</user_question>

Here are documents that may be relevant:
<documents>
<document>Section 10...</document>
<document>Section 2...</document>
<document>Section 7...</document>
<document>Section 6...</document>
</documents>

Return the 3 most relevant docs, in order of decreasing relevance.Consideraciones de eficiencia
Pedirle a Claude que devuelva fragmentos de texto completos sería ineficiente: estarías esperando a que Claude copie grandes cantidades de texto. En su lugar, asigna a cada fragmento de texto un ID único de antemano. Luego pide a Claude que devuelva solo esos IDs en el orden correcto.
Este enfoque es mucho más rápido porque Claude solo necesita devolver una lista simple como ["1p5g", "51n3", "ab83"] en lugar de copiar secciones completas de documentos.
Implementación
La función de reclasificación es llamada automáticamente por tu recuperador después de la búsqueda híbrida inicial. Aquí está la estructura básica:
def reranker_fn(docs, query_text, k):
    # Formatear documentos con IDs
    joined_docs = "\n".join([
        f"<document><document_id>{doc['id']}</document_id>"
        f"<document_content>{doc['content']}</document_content></document>"
        for doc in docs
    ])

    # Crear prompt con la pregunta del usuario y los documentos
    prompt = f"""You are about to be given a set of documents...
    {query_text}
    {joined_docs}
    """

    # Obtener la respuesta de Claude y analizar los IDs de documentos
    result = chat(messages, stop_sequences=["```"])
    return json.loads(result["text"])["document_ids"]
Resultados
Cuando pruebas el reclasificador con consultas como "¿Qué hizo el equipo de ingeniería con INC-2023-Q4-011?", deberías ver resultados más relevantes en la parte superior. Claude comprende el contexto y puede identificar que una consulta sobre el equipo de ingeniería debería priorizar la sección de ingeniería de software sobre otras secciones que simplemente mencionan el incidente.
La compensación es clara: la reclasificación aumenta la latencia porque necesitas esperar la respuesta de Claude, pero mejora significativamente la precisión de búsqueda al aprovechar la comprensión de Claude sobre el contexto y la relevancia.