La recuperación contextual es una técnica que mejora la precisión de los pipelines RAG al resolver un problema fundamental: cuando divides un documento en fragmentos, cada fragmento pierde su conexión con el contexto más amplio del documento.
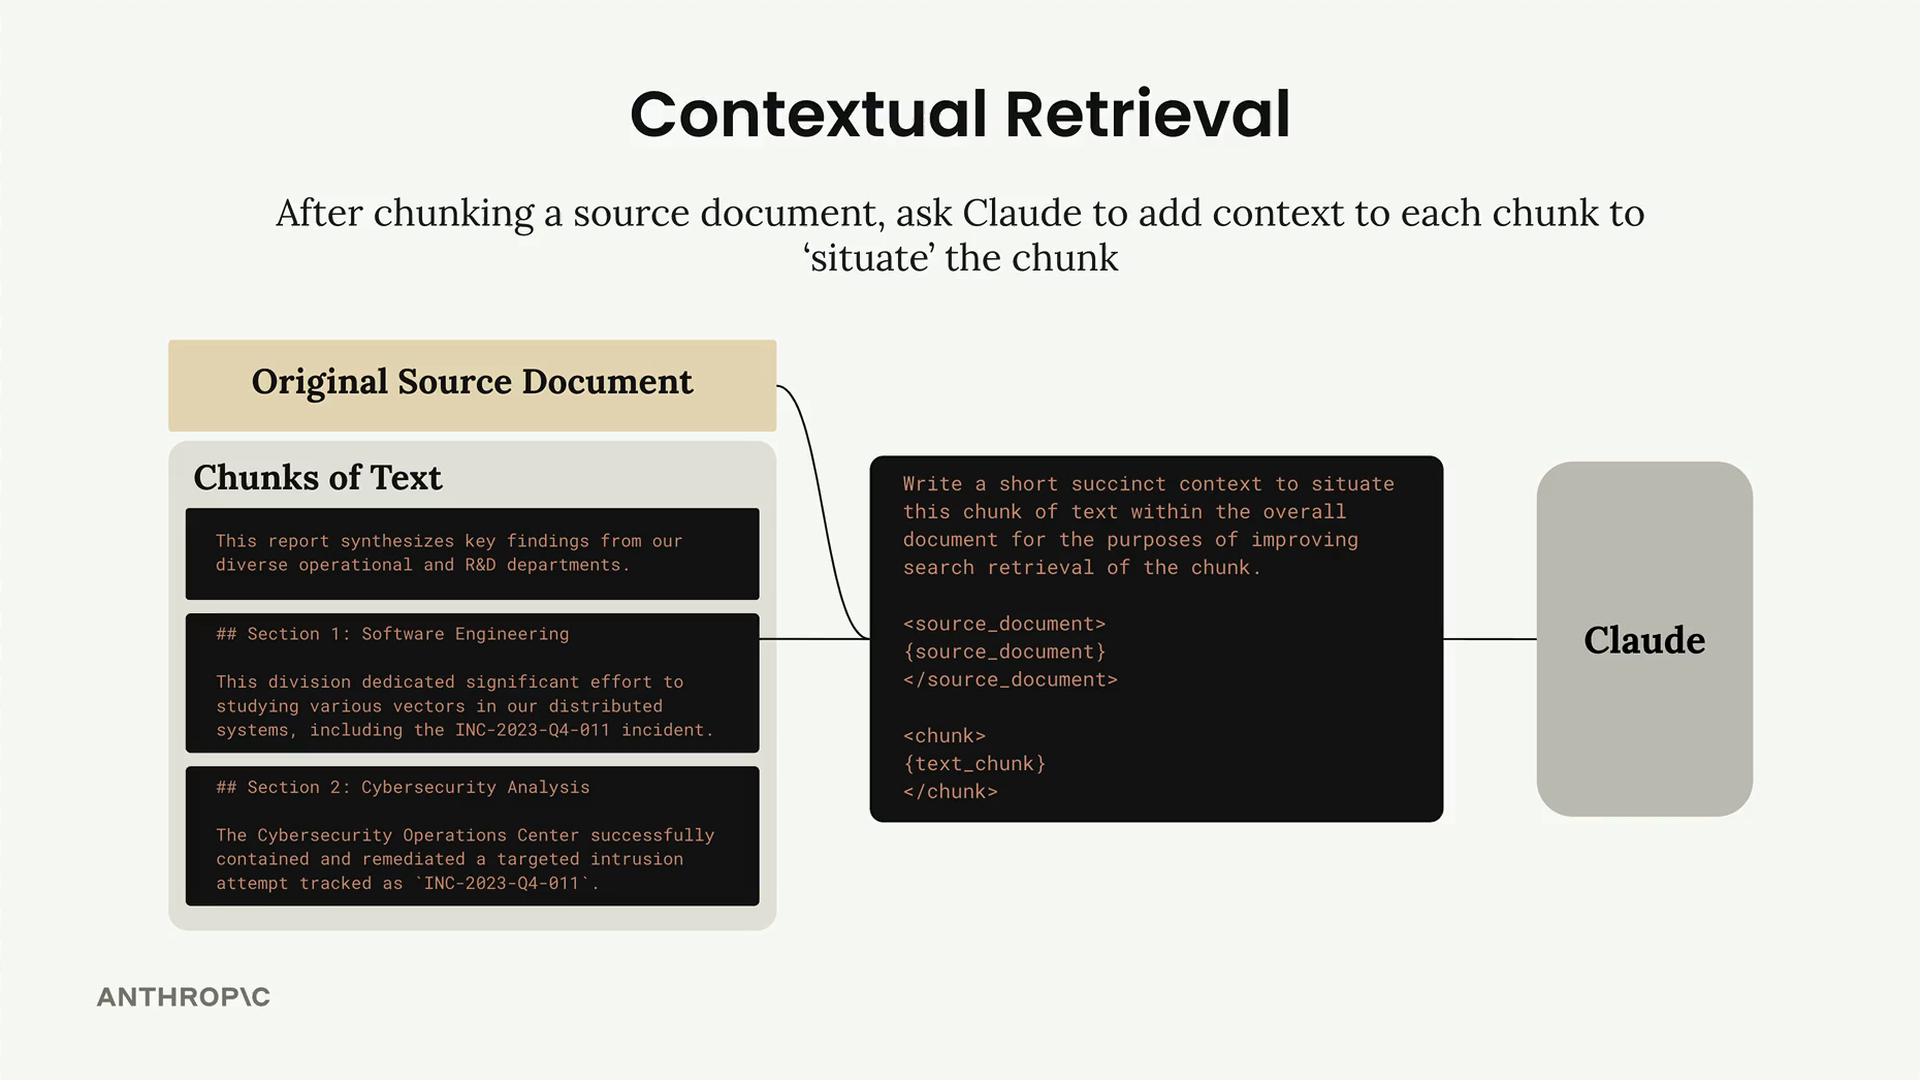
La idea básica es simple. Después de fragmentar tu documento fuente, le pides a Claude que agregue contexto a cada fragmento antes de almacenarlo en tu base de datos de recuperación. Este paso de preprocesamiento ayuda a "situar" cada fragmento dentro del documento más amplio.
Cómo funciona
Para cada fragmento de texto, envías tanto el fragmento como el documento fuente original a Claude con un prompt como este:
Write a short and succinct snippet of text to situate this chunk within the
overall source document for the purposes of improving search retrieval of the chunk.

Here is the original source document:
<document>
{source_text}
</document>

Here is the chunk we want to situate within the whole document:
<chunk>
{text_chunk}
</chunk>

Answer only with the succinct context and nothing else.Claude podría generar un contexto como: "Esta sección proviene de un informe más amplio sobre un grupo interdisciplinario. Incluye mención del INC-2023-04-011, que también se menciona en la sección de Análisis de Ciberseguridad".
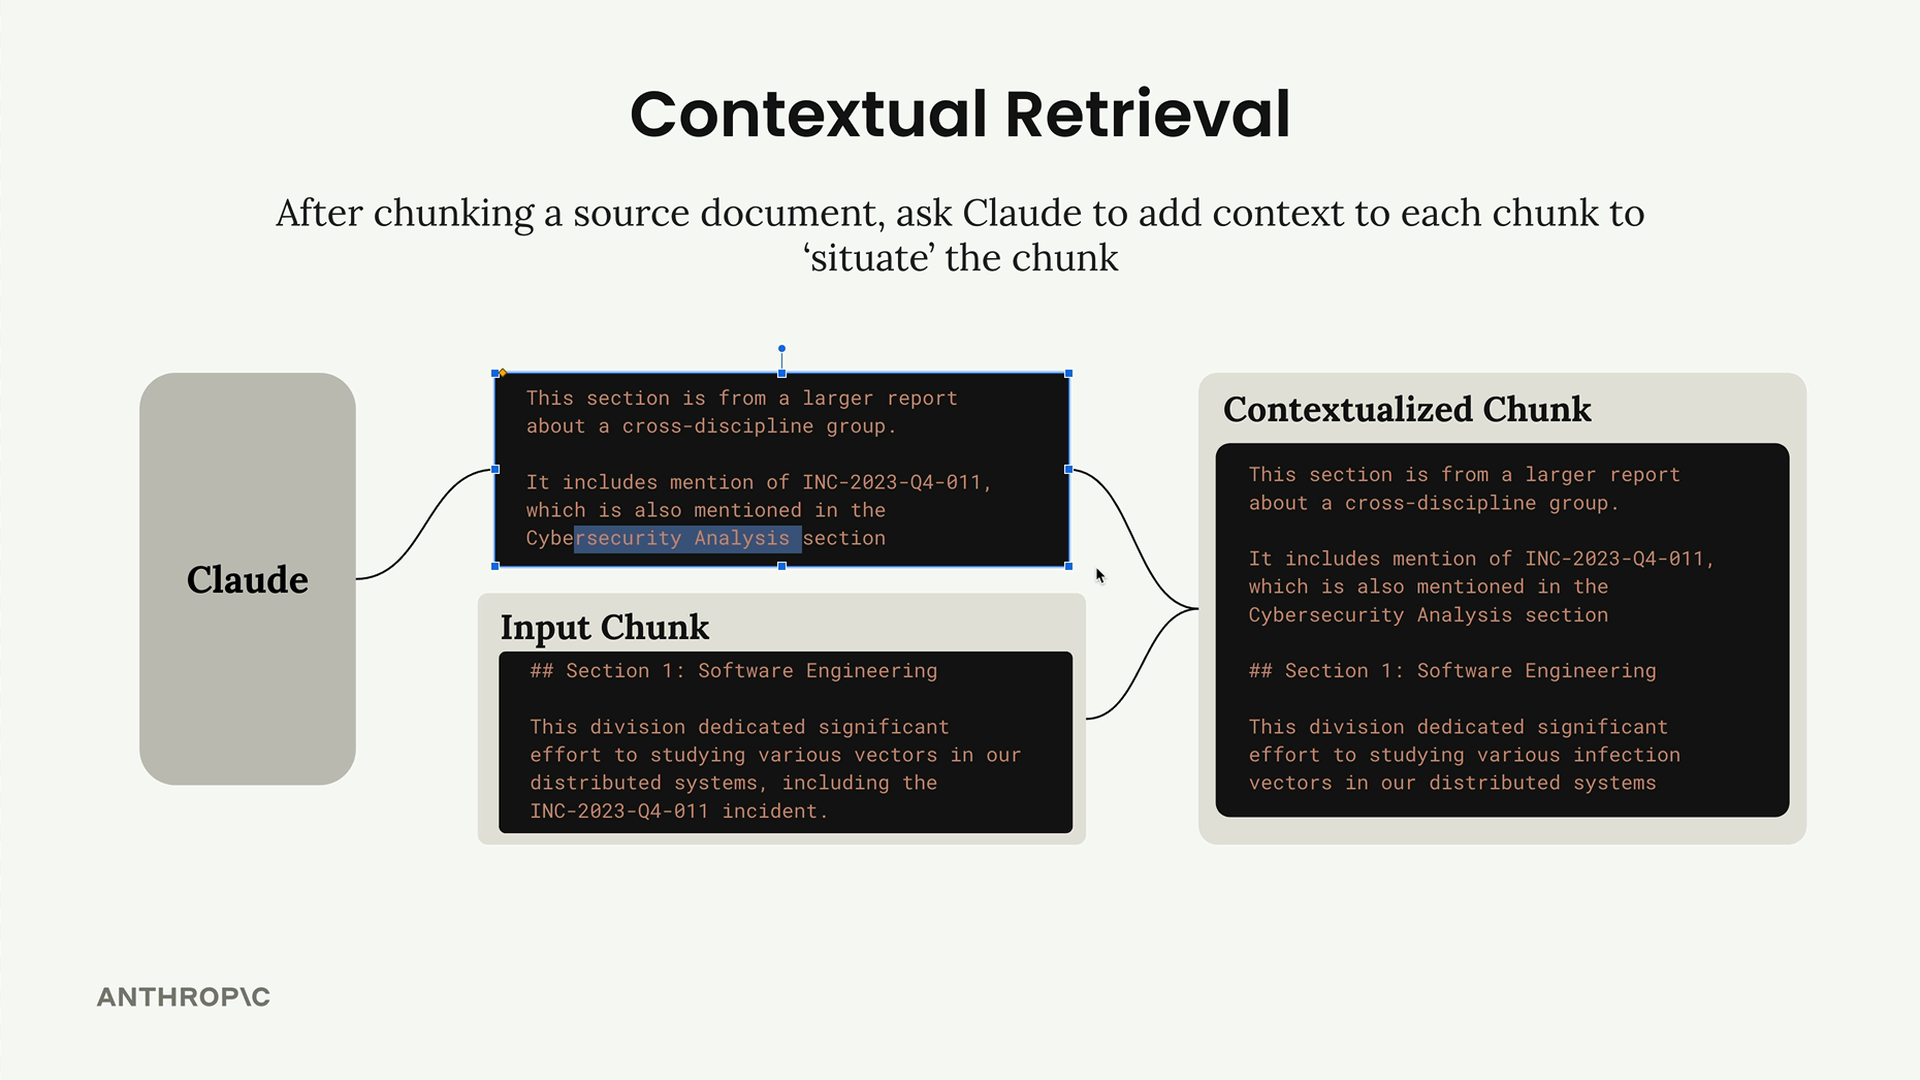
Luego combinas este contexto generado con el texto del fragmento original para crear un "fragmento contextualizado" que se almacena en tus índices vectorial y BM25.
Manejo de documentos grandes
Si tu documento fuente es demasiado grande para caber en un solo prompt, puedes proporcionar un conjunto reducido de contexto en lugar del documento completo.
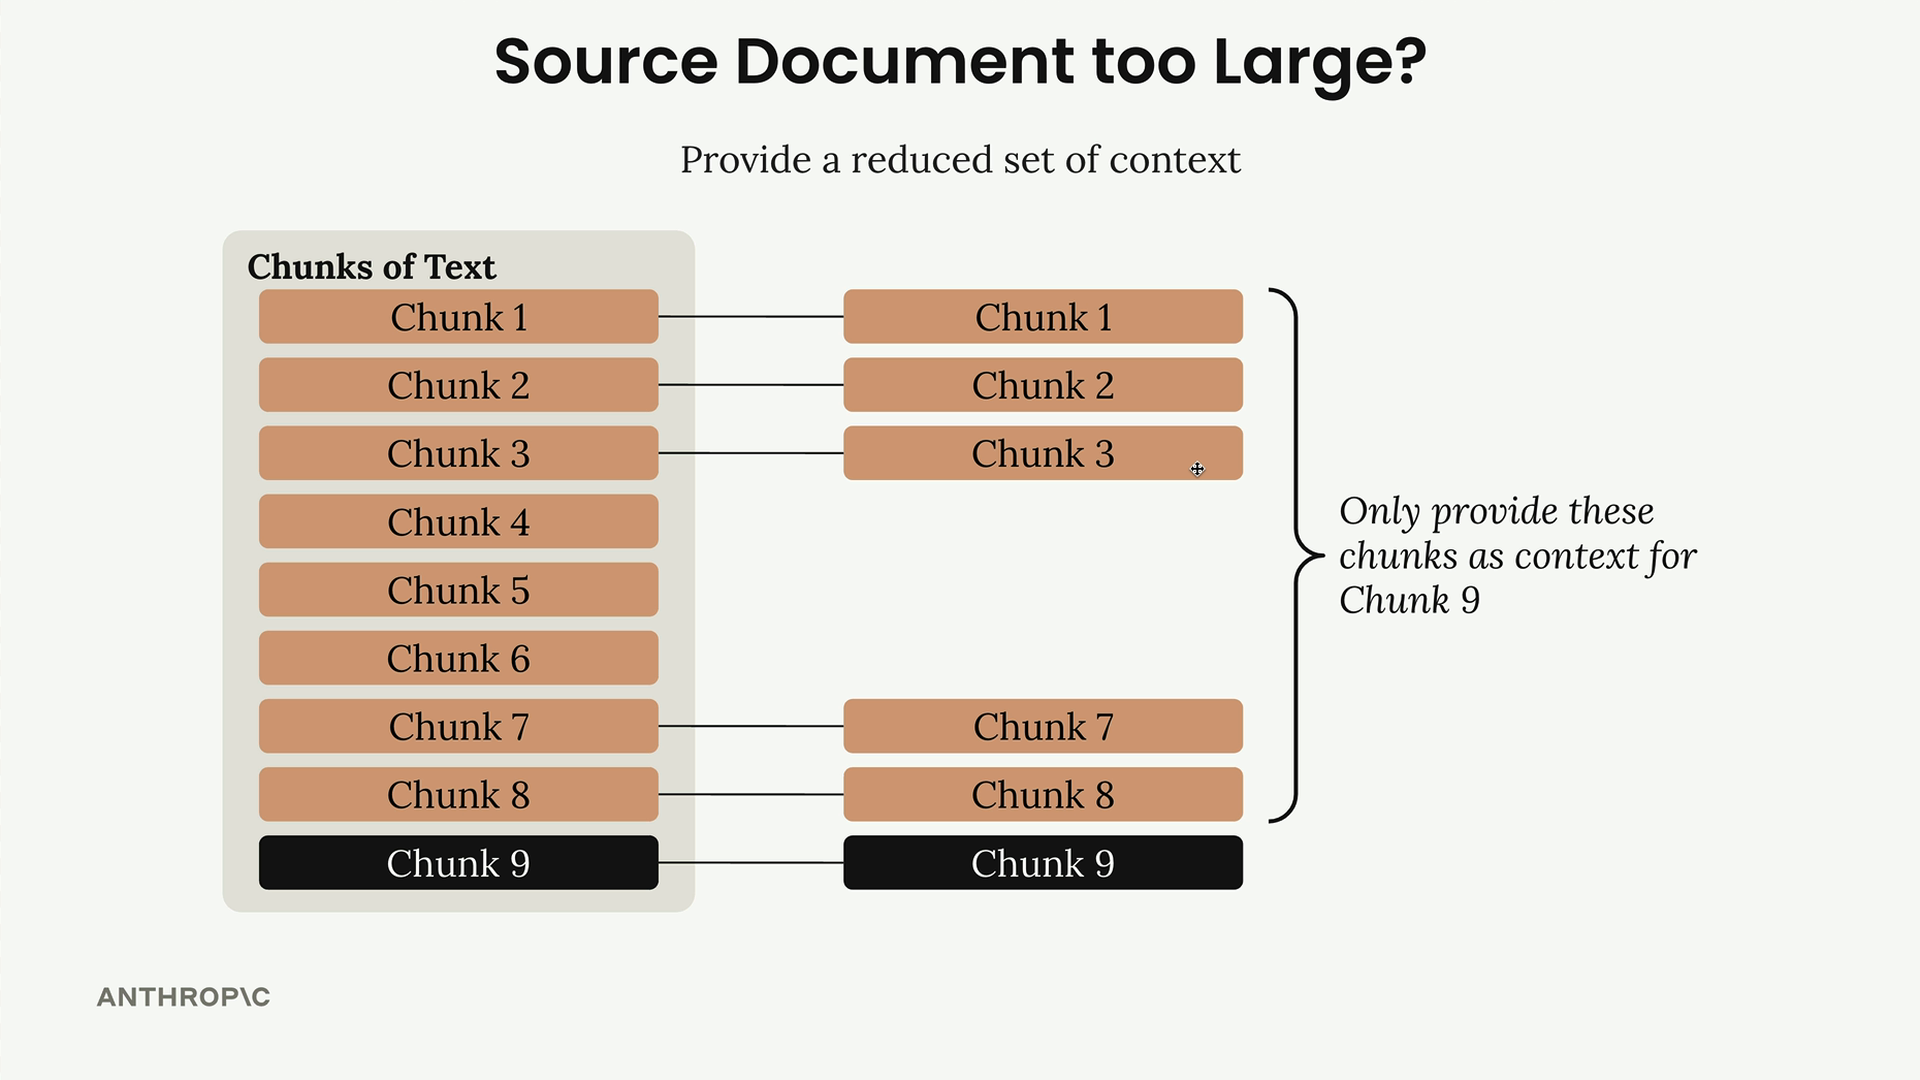
Para cualquier fragmento que estés contextualizando, incluye:
- Algunos fragmentos del inicio del documento (que a menudo contienen resúmenes o abstractos)
- Fragmentos inmediatamente anteriores al fragmento objetivo (que proporcionan contexto local)
Este enfoque le da a Claude suficiente información para generar contexto significativo sin saturar el prompt con el documento completo.
Ejemplo de implementación
Aquí tienes una implementación básica de la función de recuperación contextual:
def add_context(text_chunk, source_text):
    prompt = f"""
    Write a short and succinct snippet of text to situate this chunk within the
    overall source document for the purposes of improving search retrieval of the chunk.

    Here is the original source document:
    <document>
    {source_text}
    </document>

    Here is the chunk we want to situate within the whole document:
    <chunk>
    {text_chunk}
    </chunk>

    Answer only with the succinct context and nothing else.
    """

    messages = []
    add_user_message(messages, prompt)
    result = chat(messages)

    return result["text"] + "\n" + text_chunk
Al procesar los fragmentos de tu documento, recorrerías cada uno y generarías versiones contextualizadas:
# Agrega contexto a cada fragmento y luego agrégalo al retriever
for i, chunk in enumerate(chunks):
    # Crea el contexto a partir de los fragmentos iniciales y los fragmentos anteriores
    context_parts = []
    context_parts.extend(chunks[:min(num_start_chunks, len(chunks))])

    start_idx = max(0, i - num_prev_chunks)
    context_parts.extend(chunks[start_idx:i])

    context = "\n".join(context_parts)

    contextualized_chunk = add_context(chunk, context)
    retriever.add_document({"content": contextualized_chunk})
Resultados esperados
El contexto generado proporciona información valiosa sobre la estructura y las relaciones del documento. Por ejemplo, Claude podría describir un fragmento como "Sección 2 de una Revisión de Investigación Interdisciplinaria Anual, que detalla los esfuerzos de ingeniería de software para resolver problemas de estabilidad en el Proyecto Phoenix. Sigue a la sección de Metodología y precede al Análisis Financiero, formando parte de un informe integral que cubre diez dominios de investigación en toda la organización".
Este contexto adicional ayuda al sistema de recuperación a comprender mejor no solo qué contiene cada fragmento, sino cómo encaja en la estructura más amplia del documento y se relaciona con otras secciones. Si bien es posible que no veas mejoras drásticas con documentos simples, la recuperación contextual se vuelve cada vez más valiosa a medida que tus documentos se vuelven más complejos, con referencias cruzadas y dependencias intrincadas entre secciones.