Hacer tu primera solicitud a la API de AWS Bedrock requiere tres componentes esenciales: un Bedrock Runtime Client para conectarte al servicio, un Model ID para especificar qué modelo quieres ejecutar, y un User Message que contenga el texto que quieres introducir en el modelo.
Configurando el cliente de Bedrock
El cliente firma cada solicitud con tus credenciales de AWS, así que configúralas antes de empezar. Instala la AWS CLI y luego configura tus credenciales con aws configure u otra opción de la guía de AWS sobre credenciales de CLI(se abre en una pestaña nueva). Sin credenciales, tu primera solicitud se detendrá con NoCredentialsError.
Instala boto3 con pip install boto3. Luego crea un cliente para conectarte al servicio de Bedrock runtime:
import boto3

client = boto3.client("bedrock-runtime", region_name="us-west-2")
Entendiendo los Model IDs y la disponibilidad regional
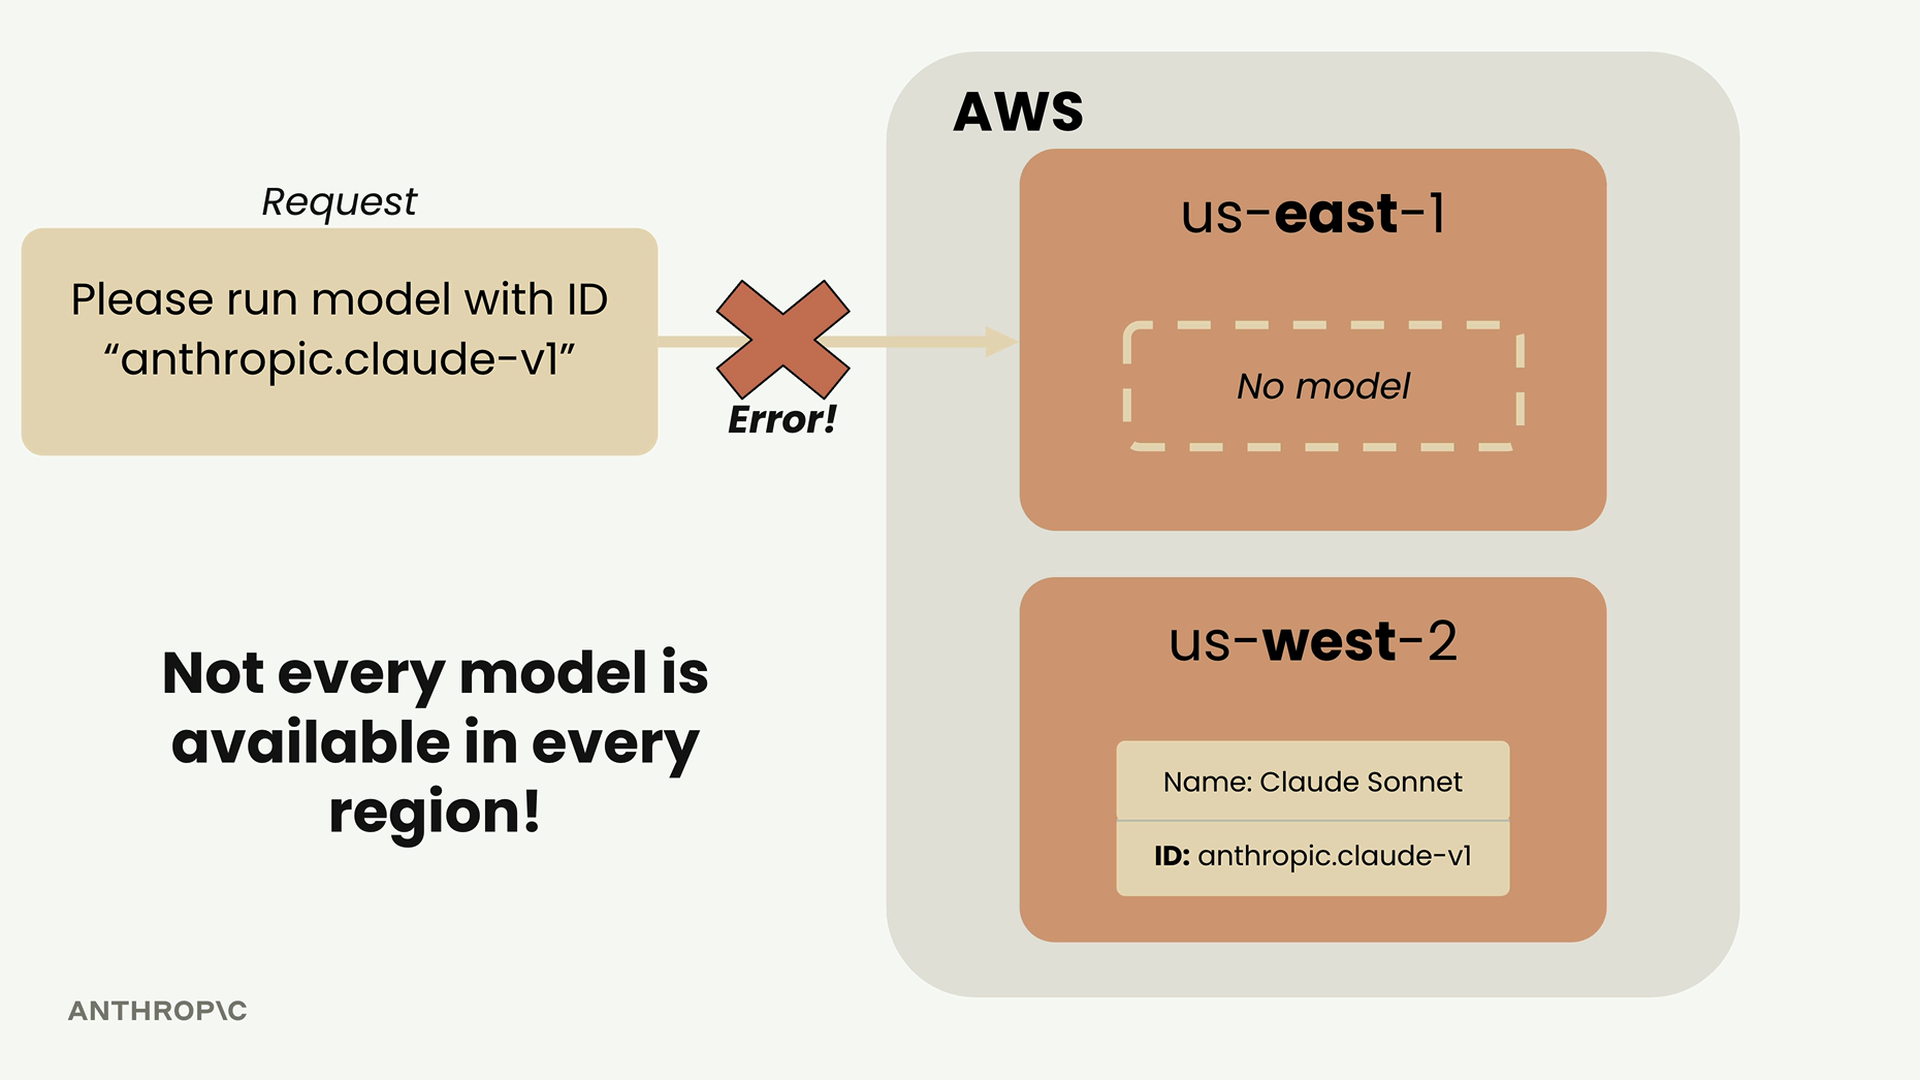
Aquí es donde las cosas se complican. No todos los modelos están disponibles en todas las regiones de AWS. Si intentas ejecutar un modelo que no existe en la región que elegiste, obtendrás un mensaje de error críptico diciendo que el modelo no existe.
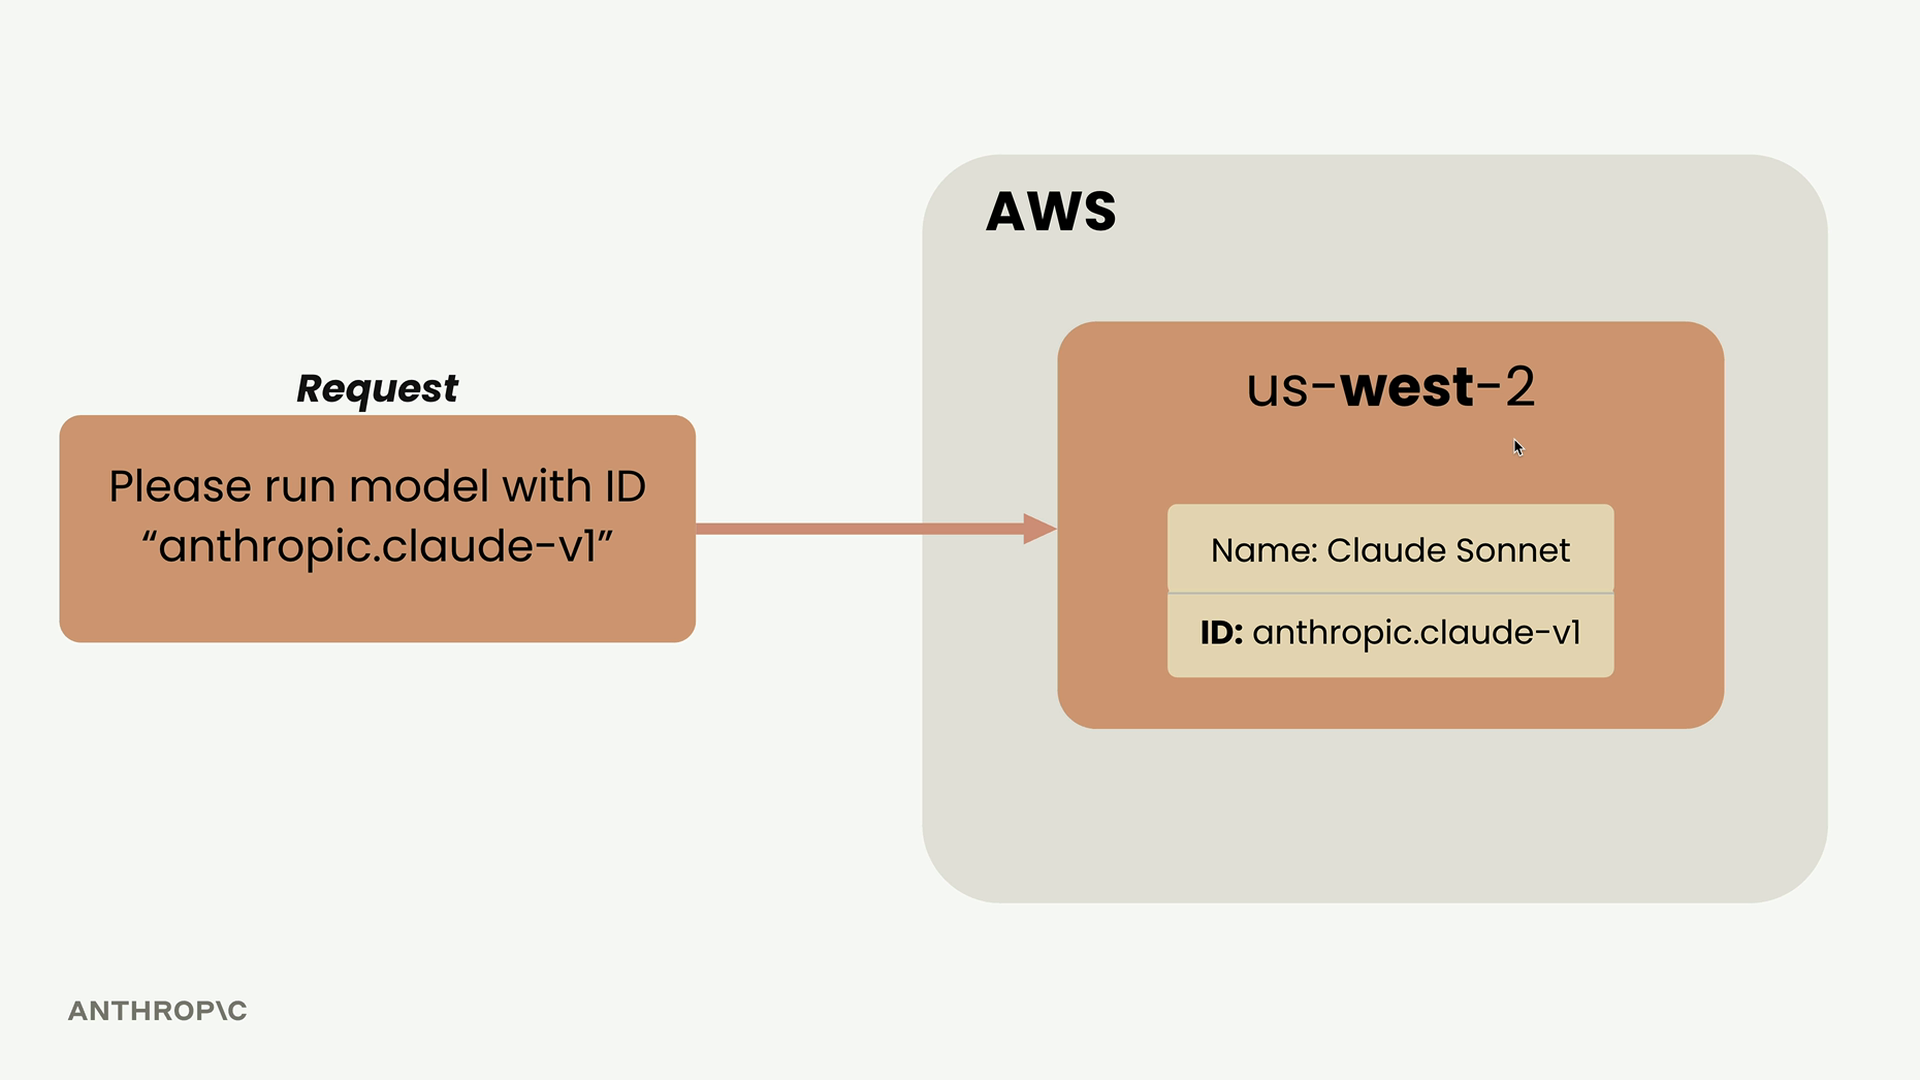
Por ejemplo, si Claude Sonnet está disponible en us-west-2 pero estás haciendo solicitudes desde us-east-1, tu solicitud fallará.
Usando perfiles de inferencia
Los perfiles de inferencia resuelven el problema de la disponibilidad regional enrutando automáticamente tus solicitudes a una región donde realmente esté alojado el modelo que elegiste.
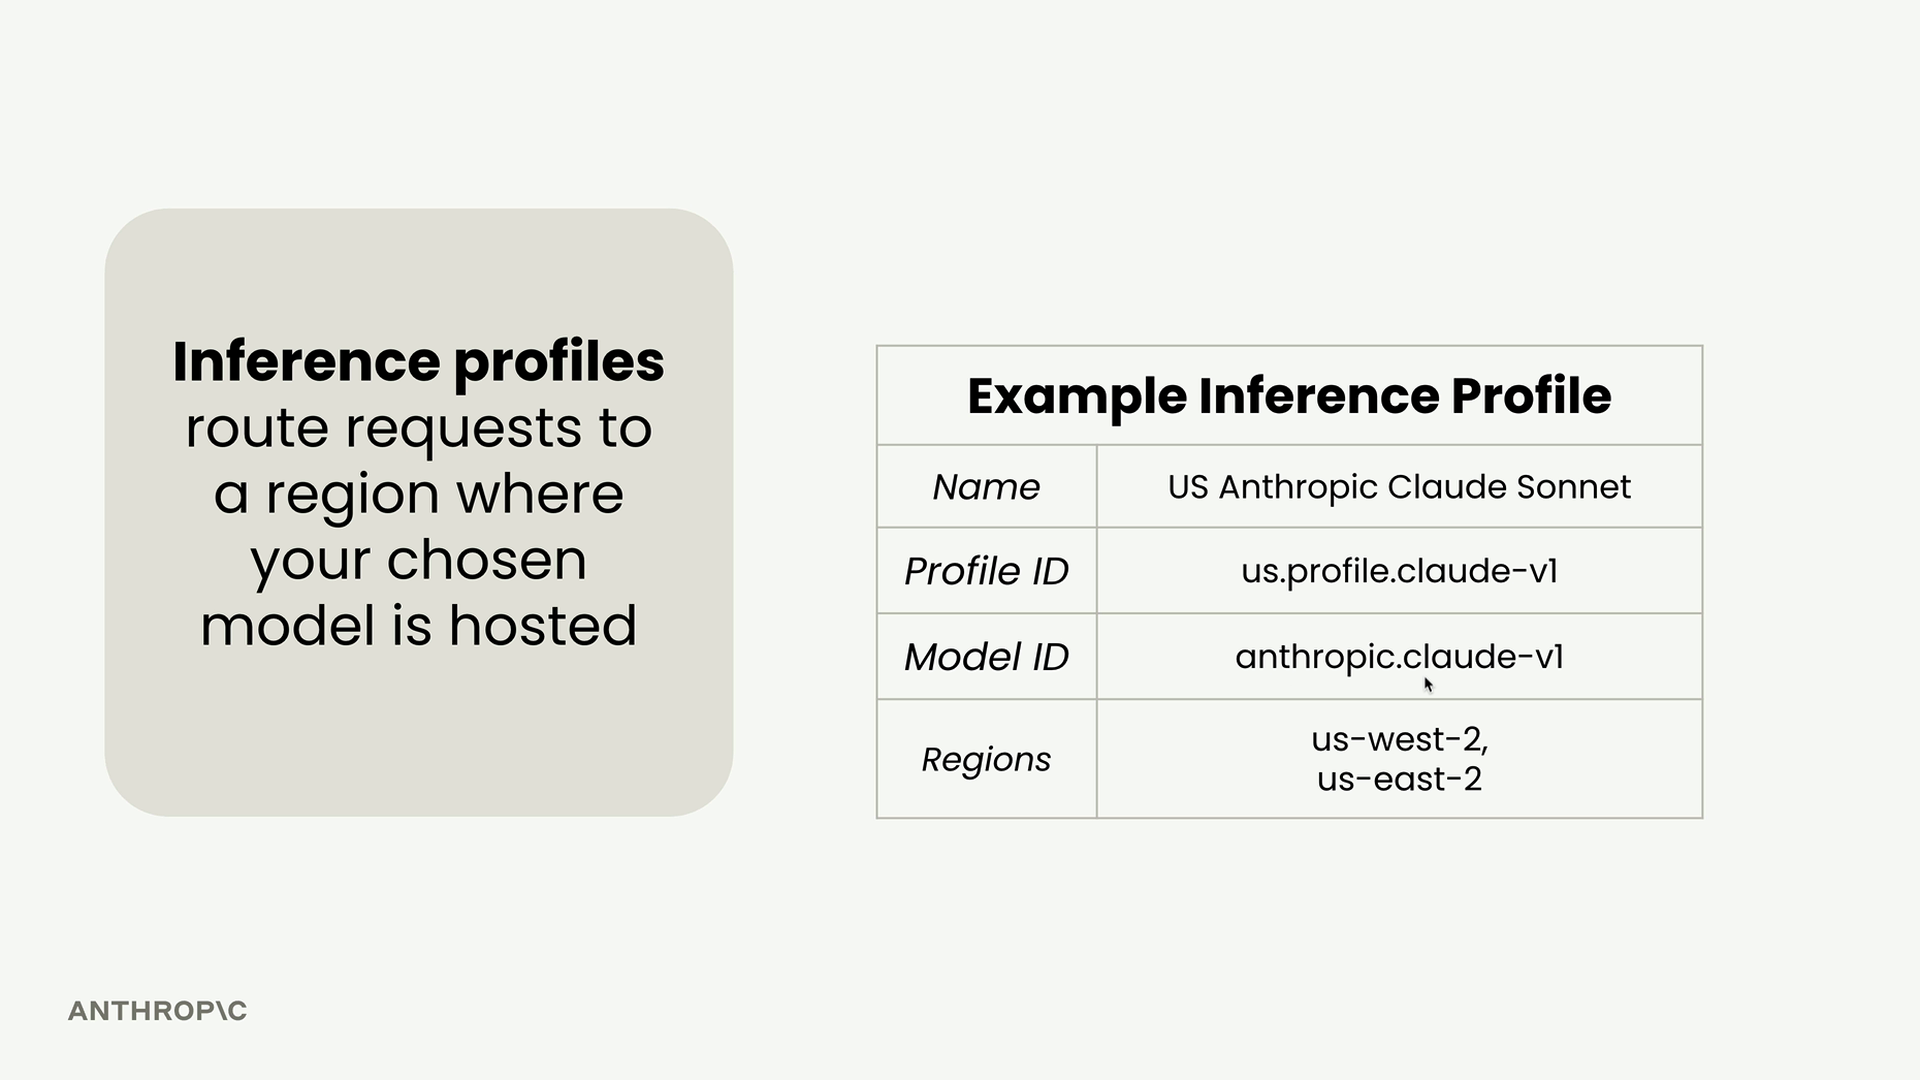
En lugar de hacer seguimiento de qué modelos están en qué regiones, puedes usar un perfil de inferencia que sepa que el modelo está disponible en varias regiones como us-west-2 y us-east-2.
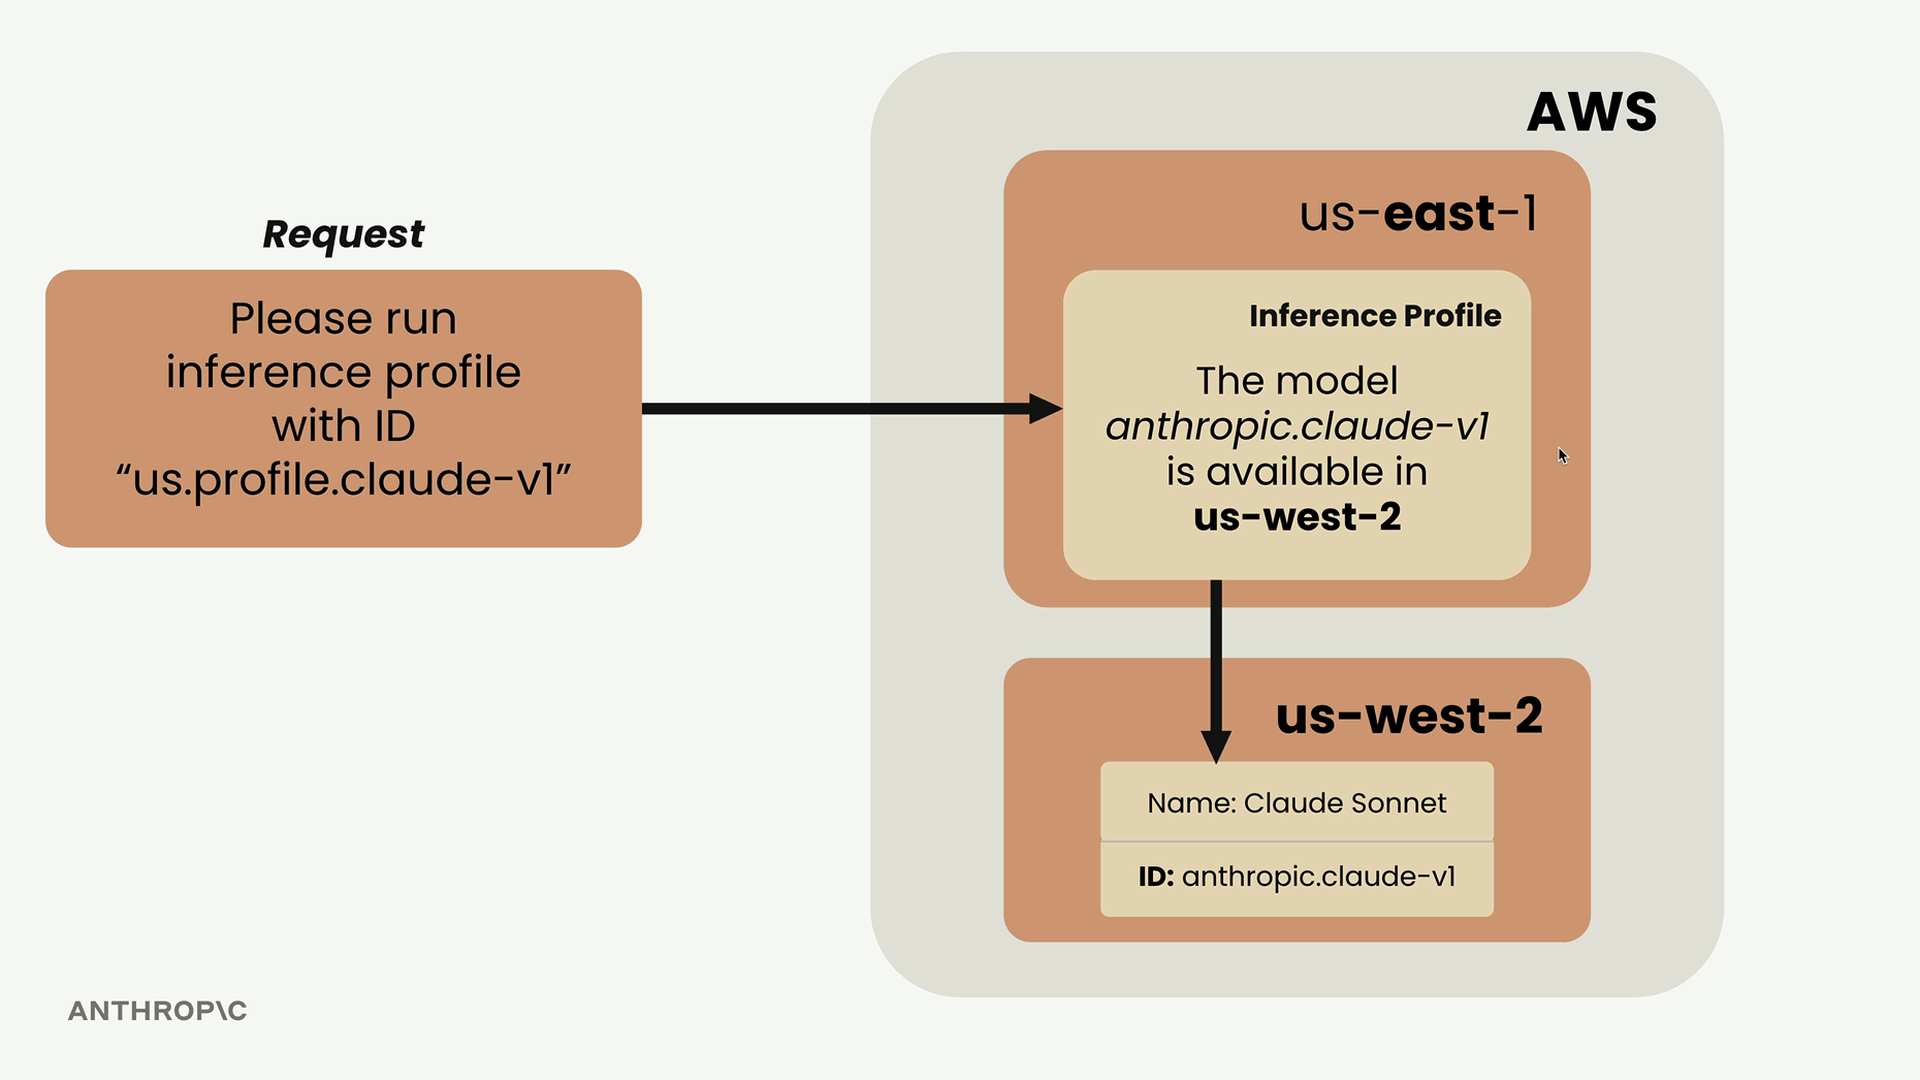
Cuando haces una solicitud usando un perfil de inferencia, AWS la enruta automáticamente a la región correcta donde existe tu modelo, incluso si te estás conectando desde una región diferente.
Para encontrar los IDs de los perfiles de inferencia, ve a la consola de AWS Bedrock y búscalos en "Cross-region inference" en lugar de usar el model ID de la página principal del catálogo de modelos.
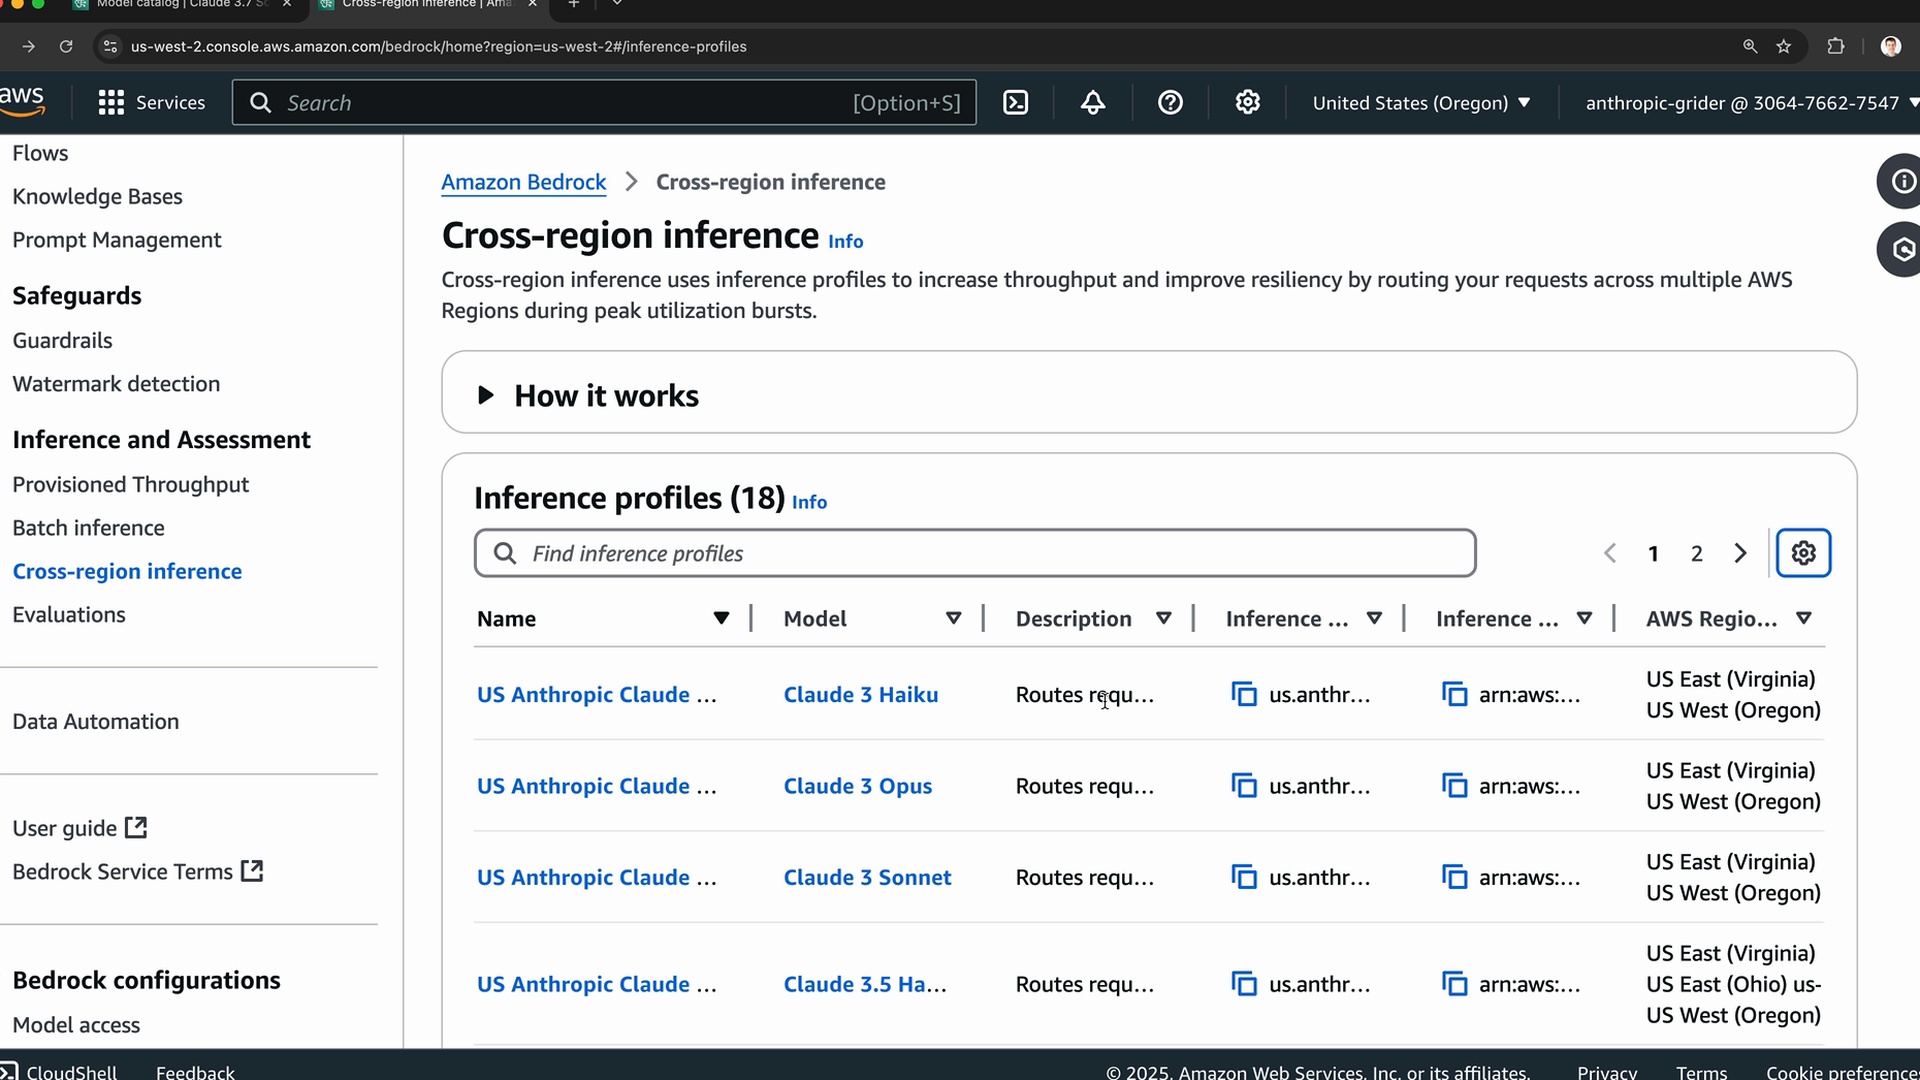
Copia el ID del perfil de inferencia para el modelo que elegiste. Los ejemplos en este curso usan Claude Haiku 4.5, cuyo ID de perfil de inferencia es us.anthropic.claude-haiku-4-5-20251001-v1:0:
model_id = "us.anthropic.claude-haiku-4-5-20251001-v1:0"Creando User Messages
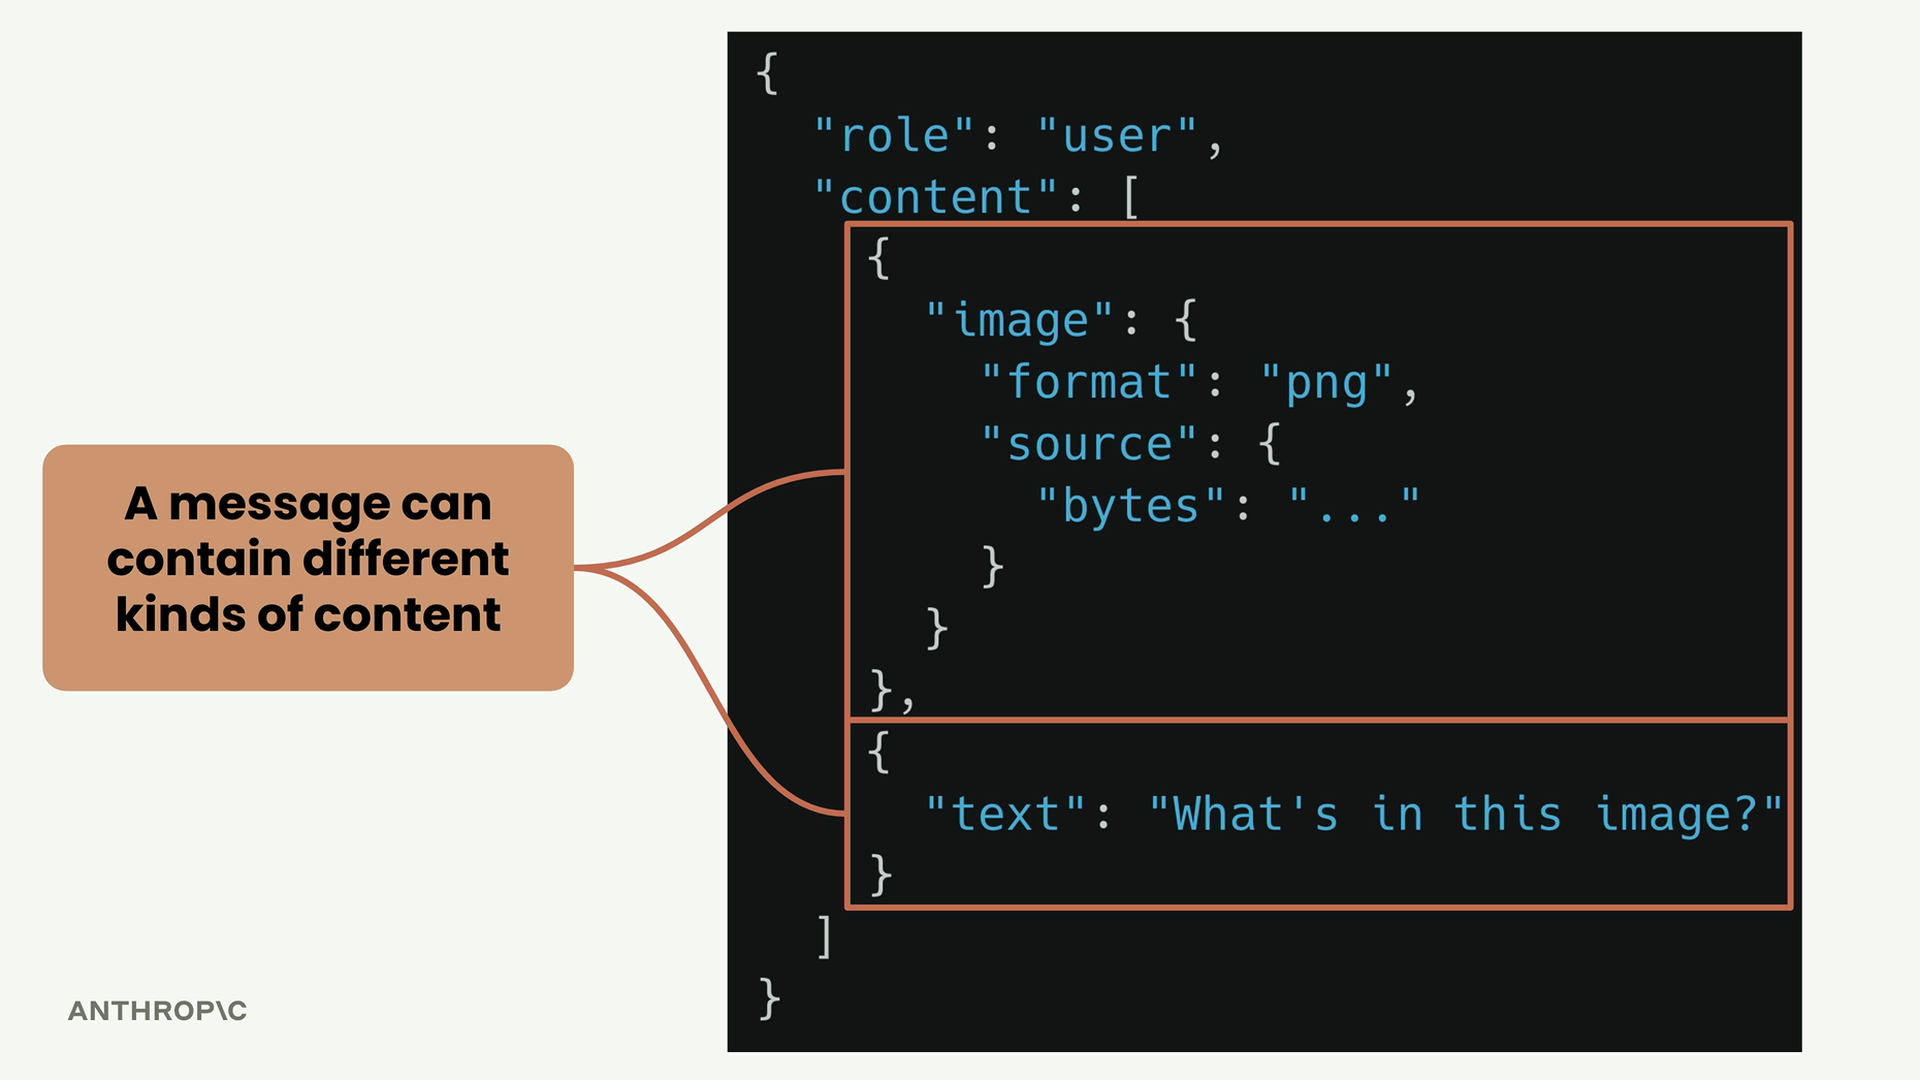
Los user messages tienen una estructura específica que al principio puede parecer excesivamente compleja, pero hay una buena razón para ello:
user_message = {
    "role": "user",
    "content": [
        {"text": "What's 1+1?"}
    ]
}
El contenido es una lista porque un solo mensaje puede contener diferentes tipos de contenido: texto, imágenes u otros tipos de medios. Esta estructura te permite enviar solicitudes multimodales.
Haciendo la solicitud
Ahora puedes hacer tu llamada a la API usando el método converse:
response = client.converse(
    modelId=model_id,
    messages=[user_message]
)
La respuesta contiene mucha metadata, pero para obtener solo el texto generado, necesitas navegar por la estructura de la respuesta:
response["output"]["message"]["content"][0]["text"]Entendiendo los tipos de mensaje
Hay dos tipos de mensaje principales con los que trabajarás:
- User messages - Contenido que quieres introducir en el modelo (role: "user")
- Assistant messages - Contenido que el modelo ha producido (role: "assistant")
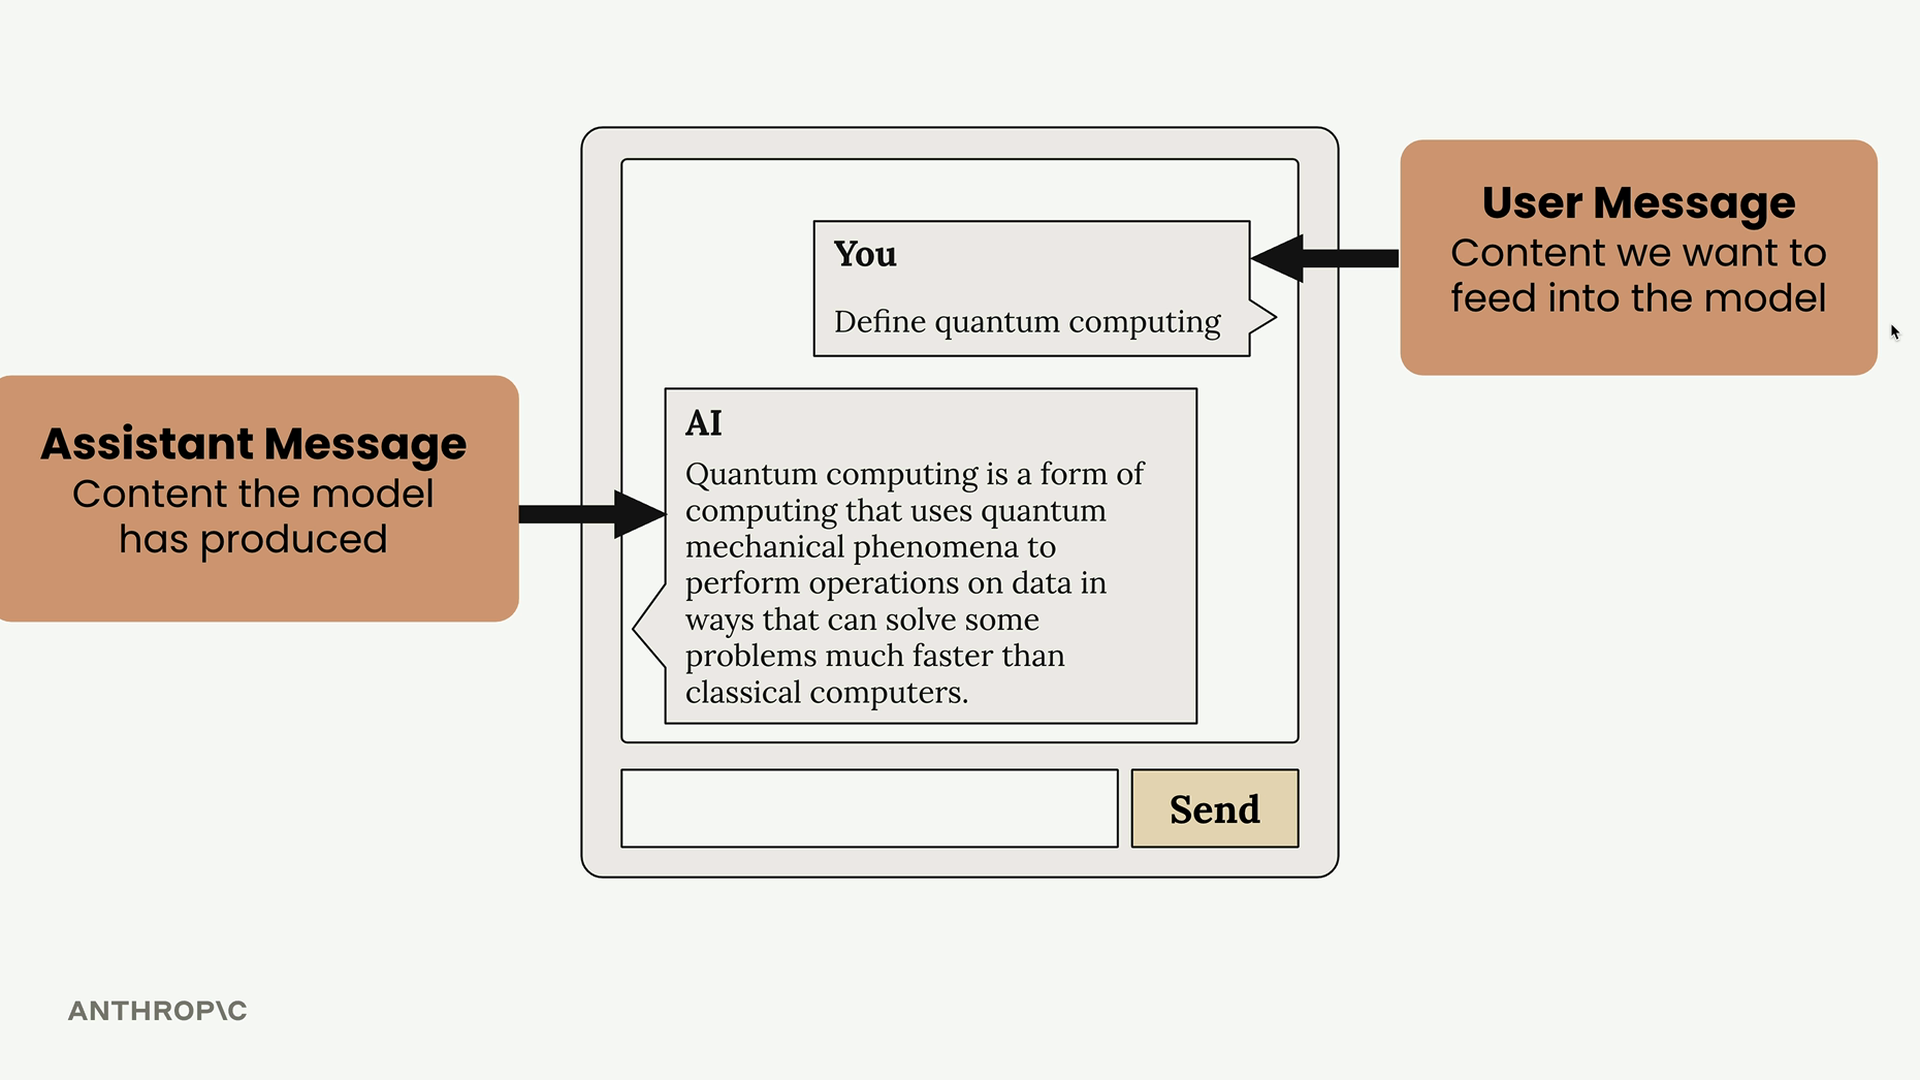
Ambos tipos de mensaje siguen la misma estructura con un role y una lista de content. Esta consistencia facilita la construcción de conversaciones alternando entre user messages y assistant messages.
El assistant message que recibes de vuelta de Bedrock sigue exactamente el mismo formato que tu user message, solo que con un role diferente. Esta estructura estandarizada hace que sea sencillo encadenar múltiples solicitudes para conversaciones más largas.