Cargando
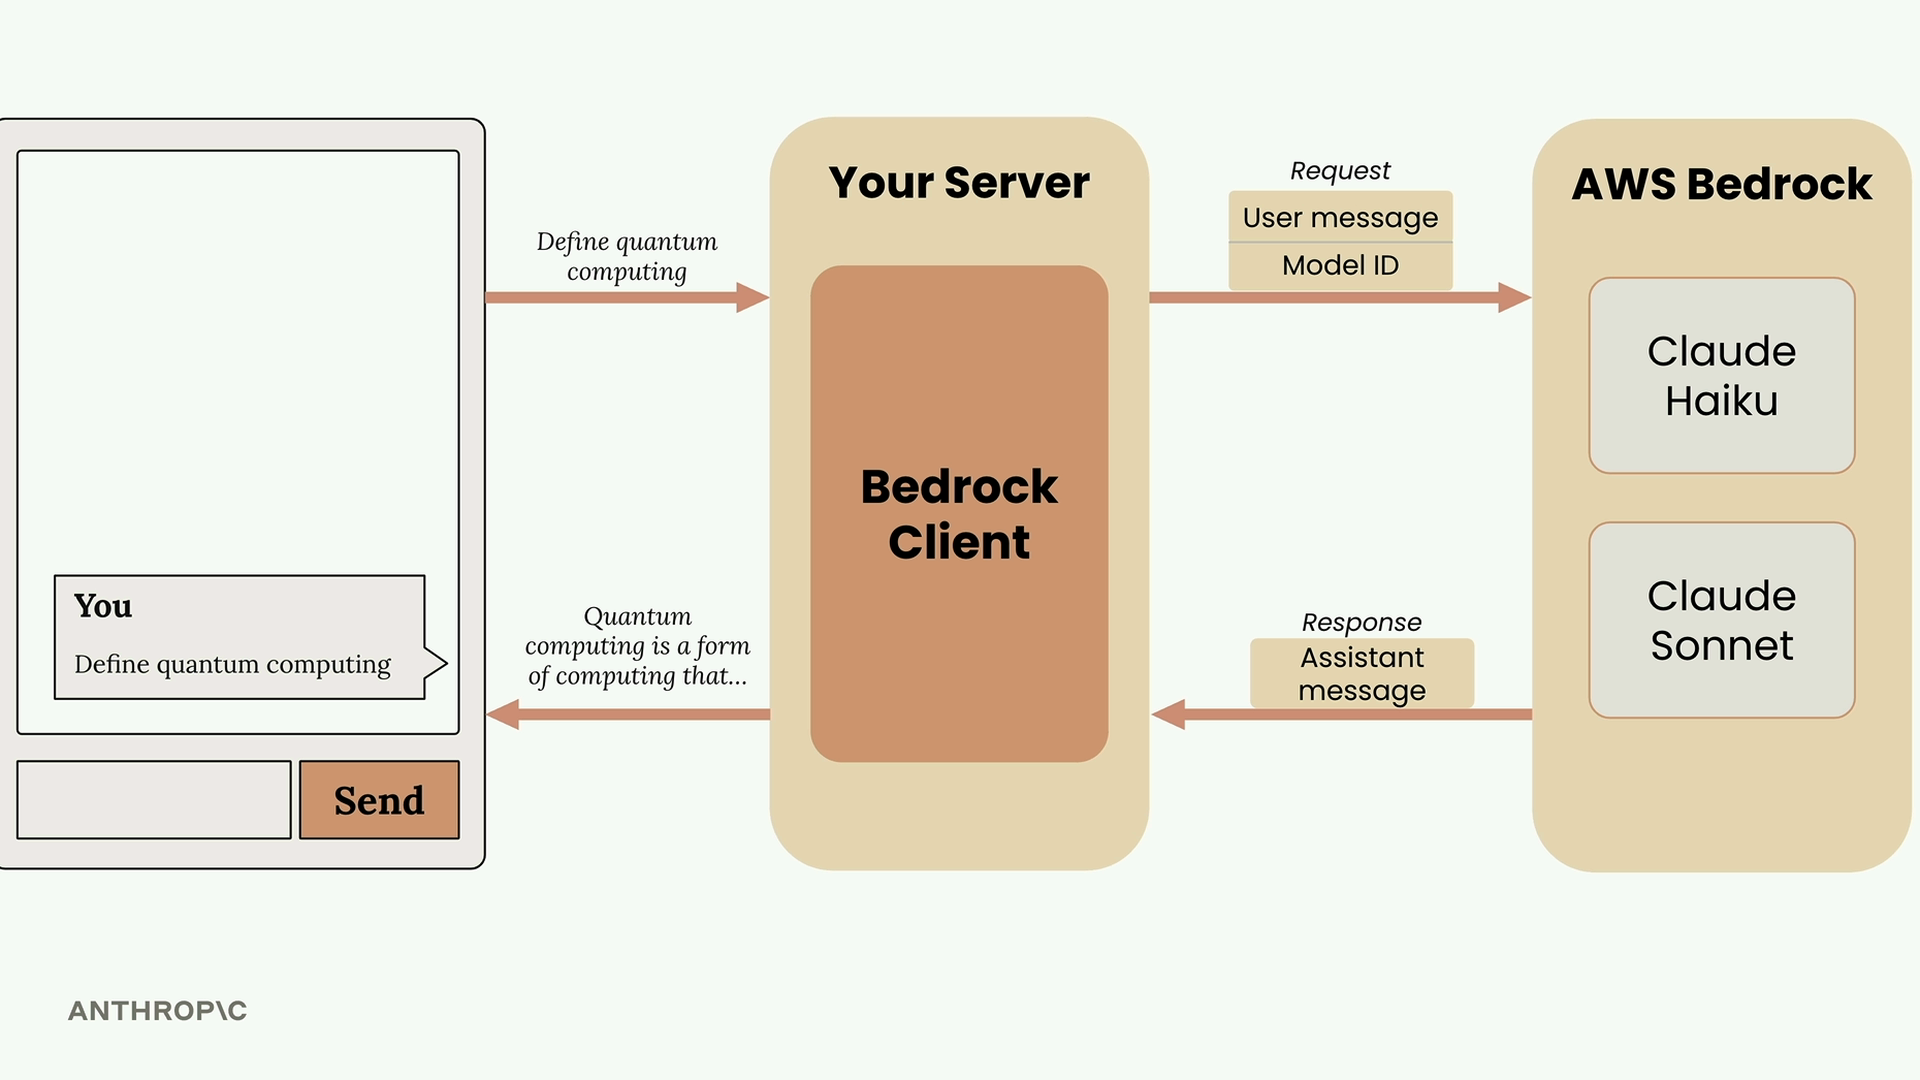
Al crear aplicaciones con modelos de IA, necesitas entender el flujo de datos desde la entrada del usuario hasta la respuesta generada por la IA. Repasemos cómo funciona esto con AWS Bedrock y veamos qué sucede detrás de escena en una aplicación de chat típica.
Cómo funcionan las aplicaciones de chat
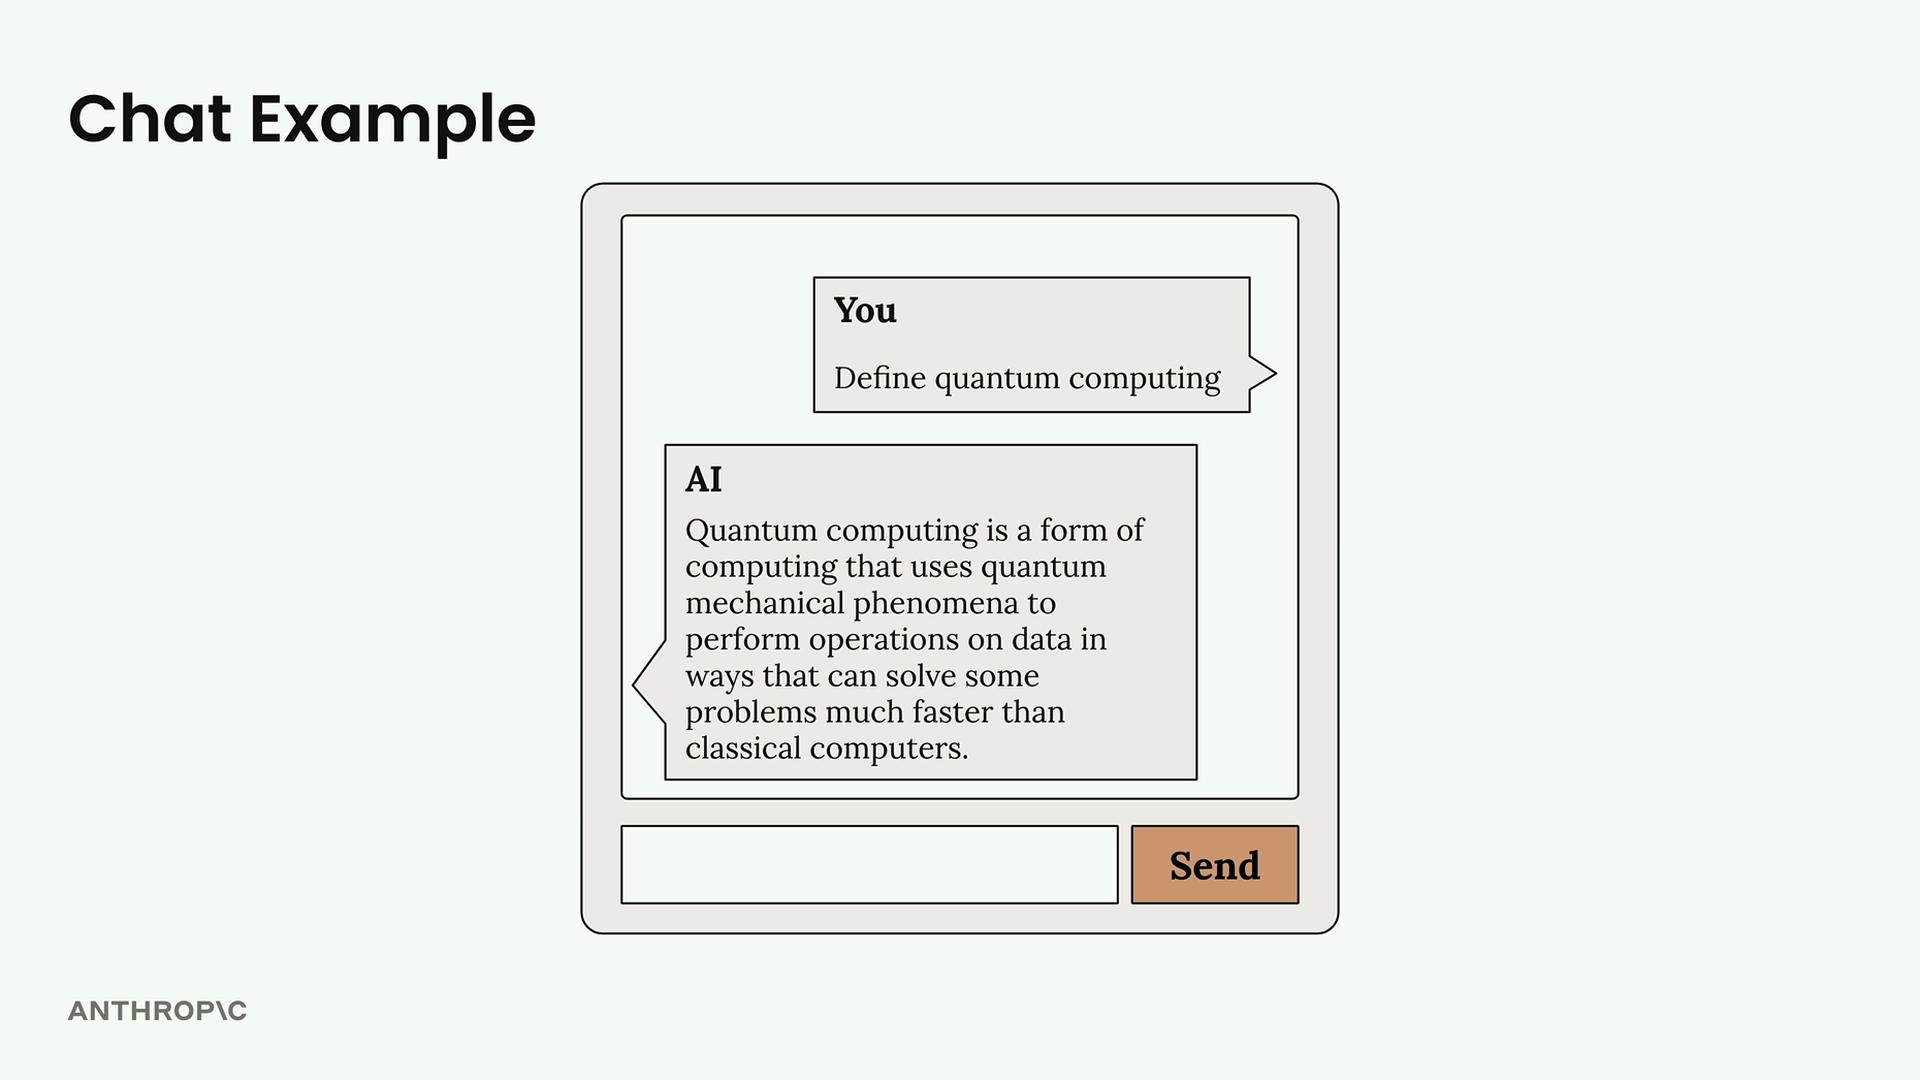
Imagina que estás creando una aplicación web con una interfaz de chat sencilla. Un usuario escribe "Define la computación cuántica" y hace clic en enviar. Esto es lo que realmente ocurre:
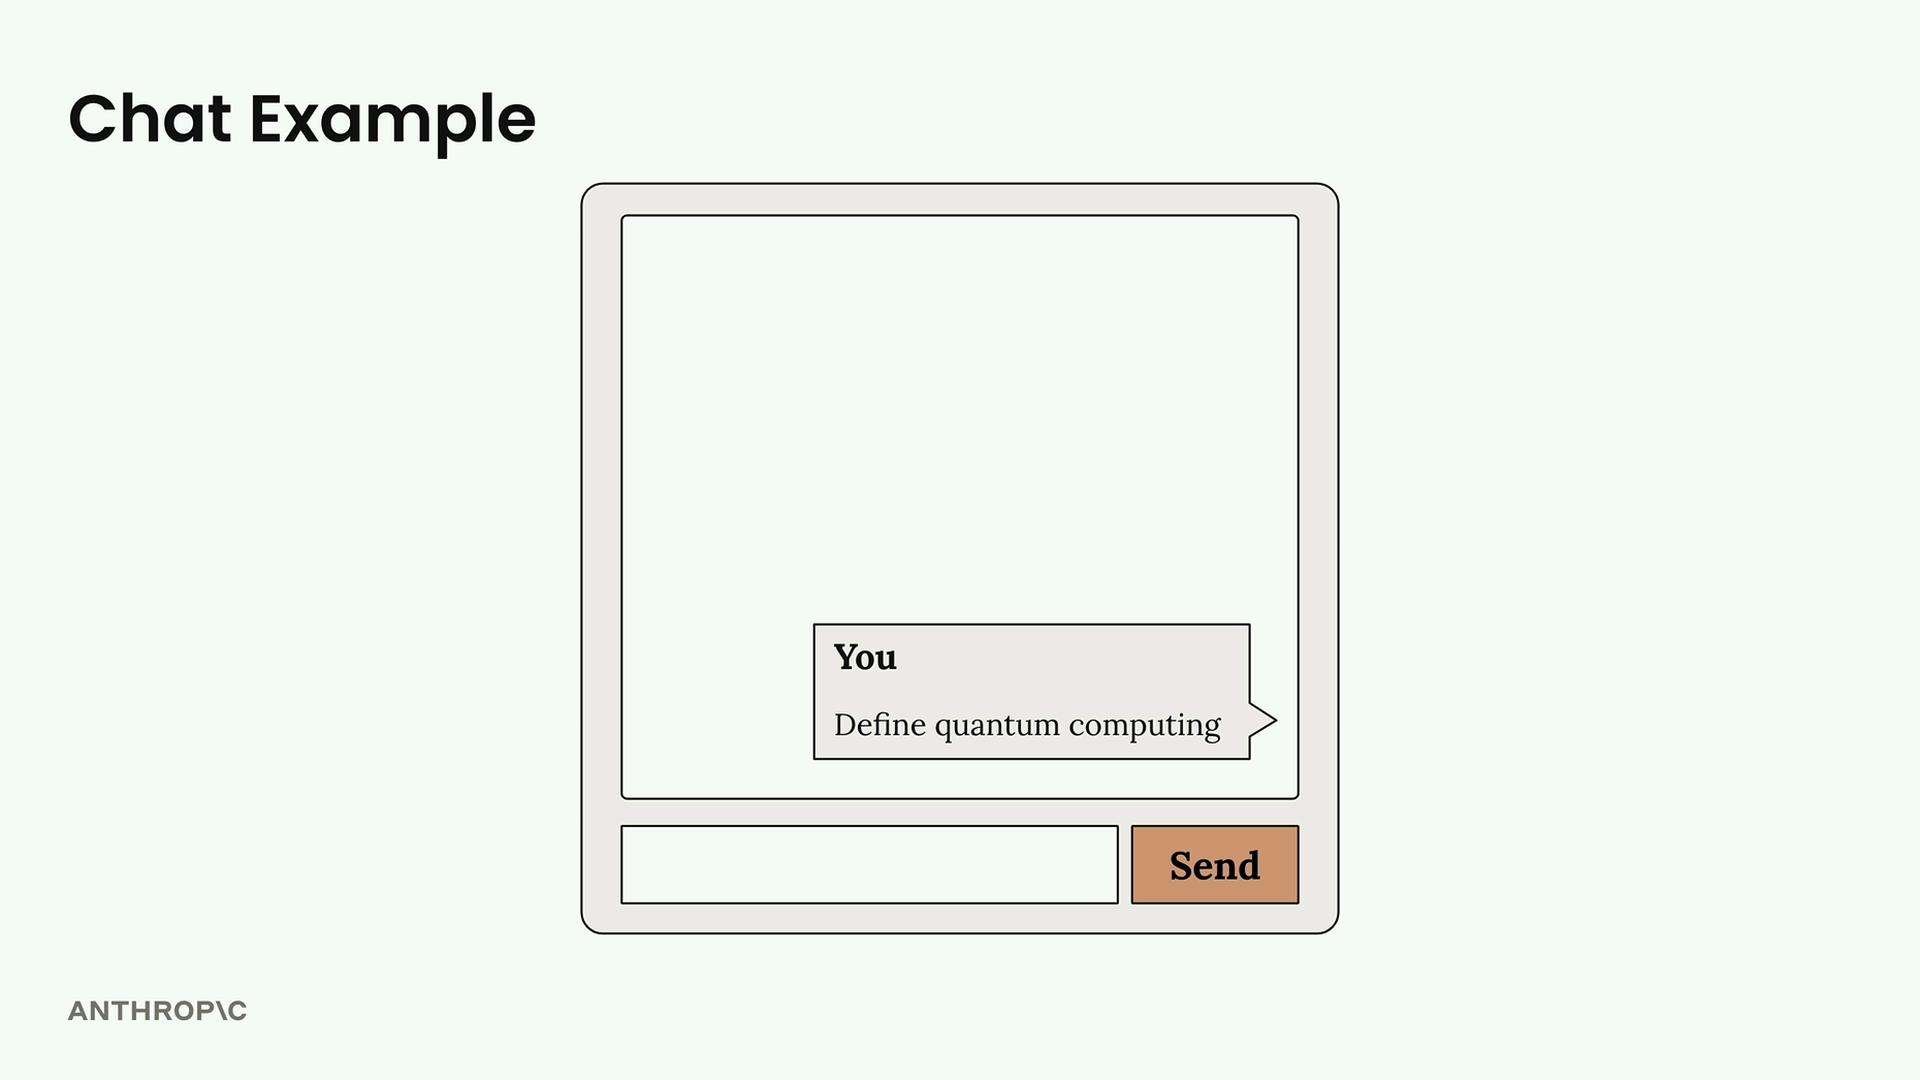
El usuario ve una interfaz limpia, pero hay todo un sistema trabajando detrás de escena para generar esa respuesta.
El flujo de la solicitud
Cuando un usuario envía un texto, este es el recorrido que sigue ese mensaje:
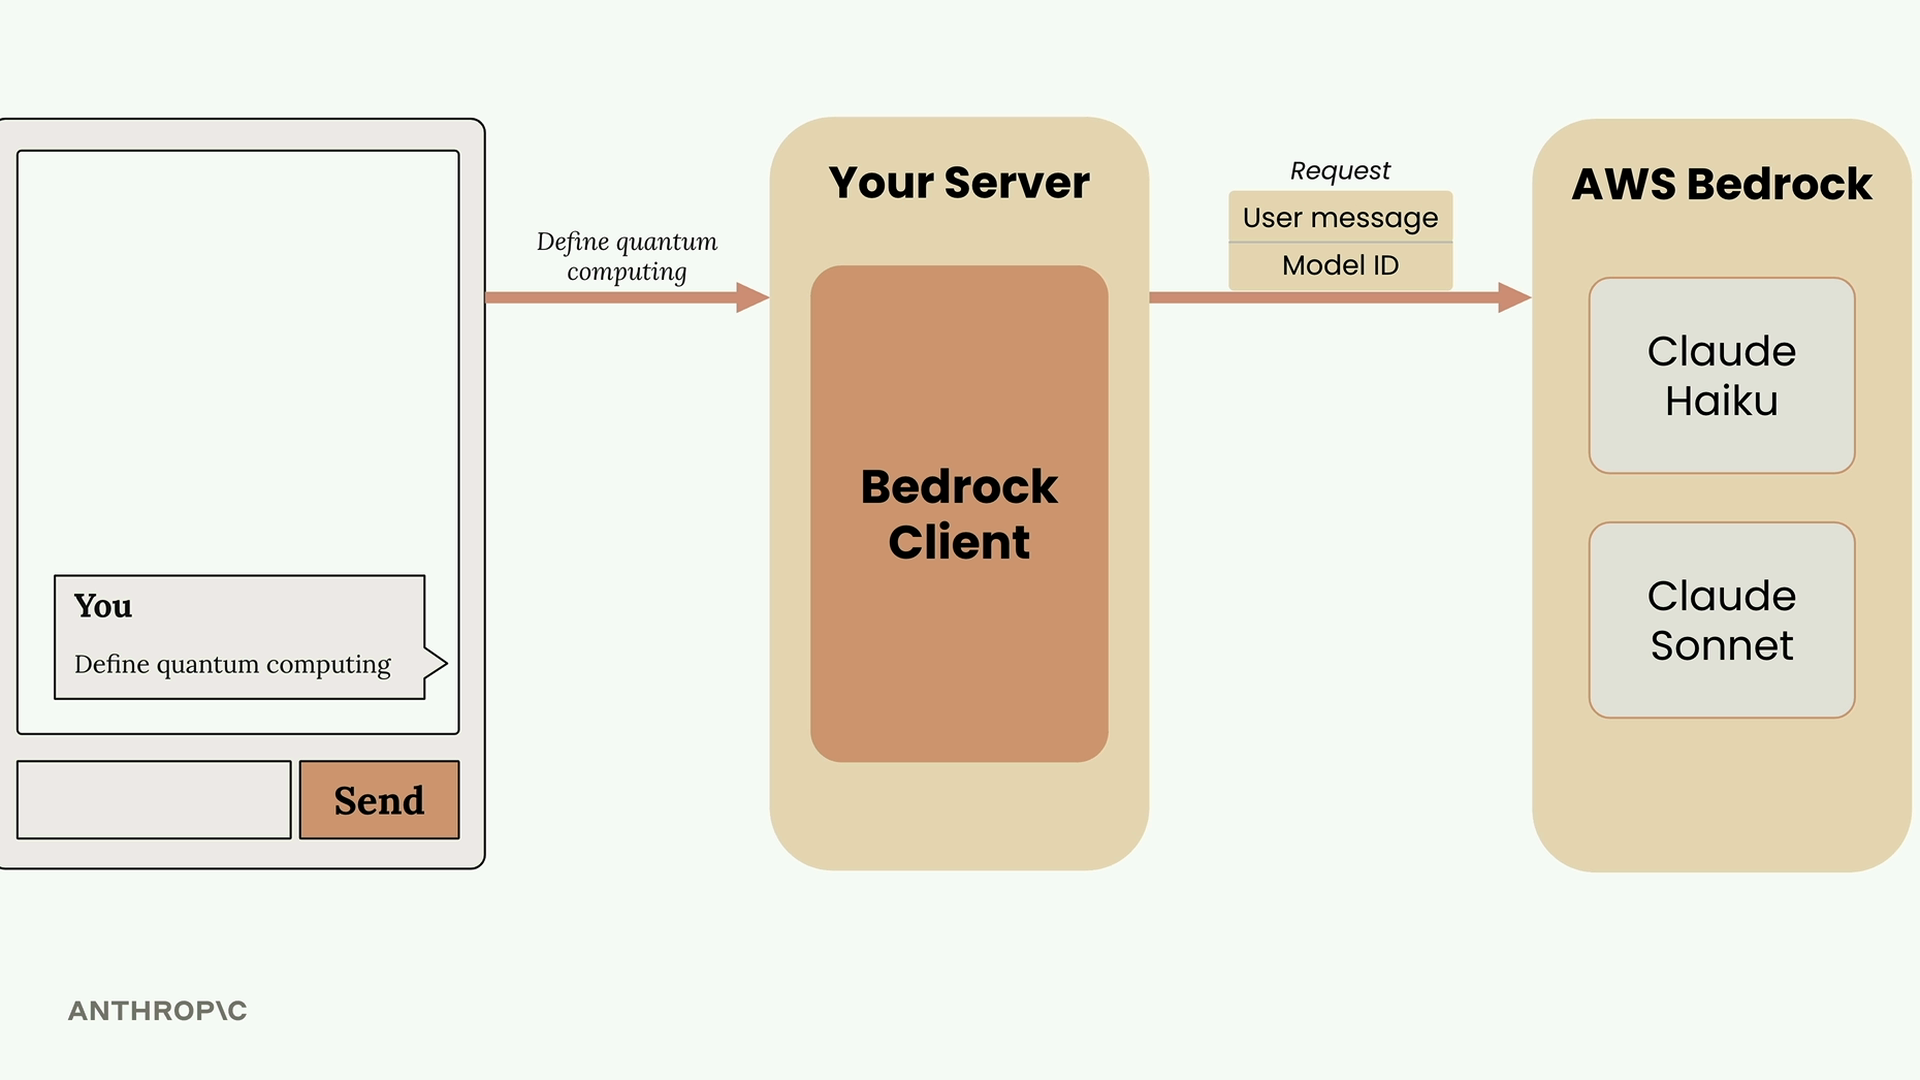
- El usuario envía su mensaje a través de tu interfaz web
- Tu servidor recibe la solicitud que contiene ese texto
- Tu servidor usa el cliente de Bedrock para hacer una solicitud a AWS Bedrock
- La solicitud incluye el mensaje del usuario y un ID de modelo (como Claude Haiku o Claude Sonnet)
- El modelo elegido procesa la solicitud y genera texto
- AWS Bedrock devuelve un mensaje del asistente que contiene la respuesta generada
- Tu servidor reenvía esta respuesta de vuelta al navegador del usuario