El almacenamiento en caché de prompts es una función que acelera las respuestas de Claude y reduce el costo de la generación de texto al reutilizar el trabajo computacional de solicitudes anteriores. Para entender cómo funciona esto, primero veamos qué sucede normalmente dentro de Claude durante una solicitud típica.
Cómo procesa Claude normalmente las solicitudes
Cuando envías un mensaje a Claude, suceden muchas cosas detrás de escena antes de que obtengas una respuesta. Claude no comienza a generar texto de inmediato; primero realiza un trabajo extenso sobre tu mensaje de entrada.
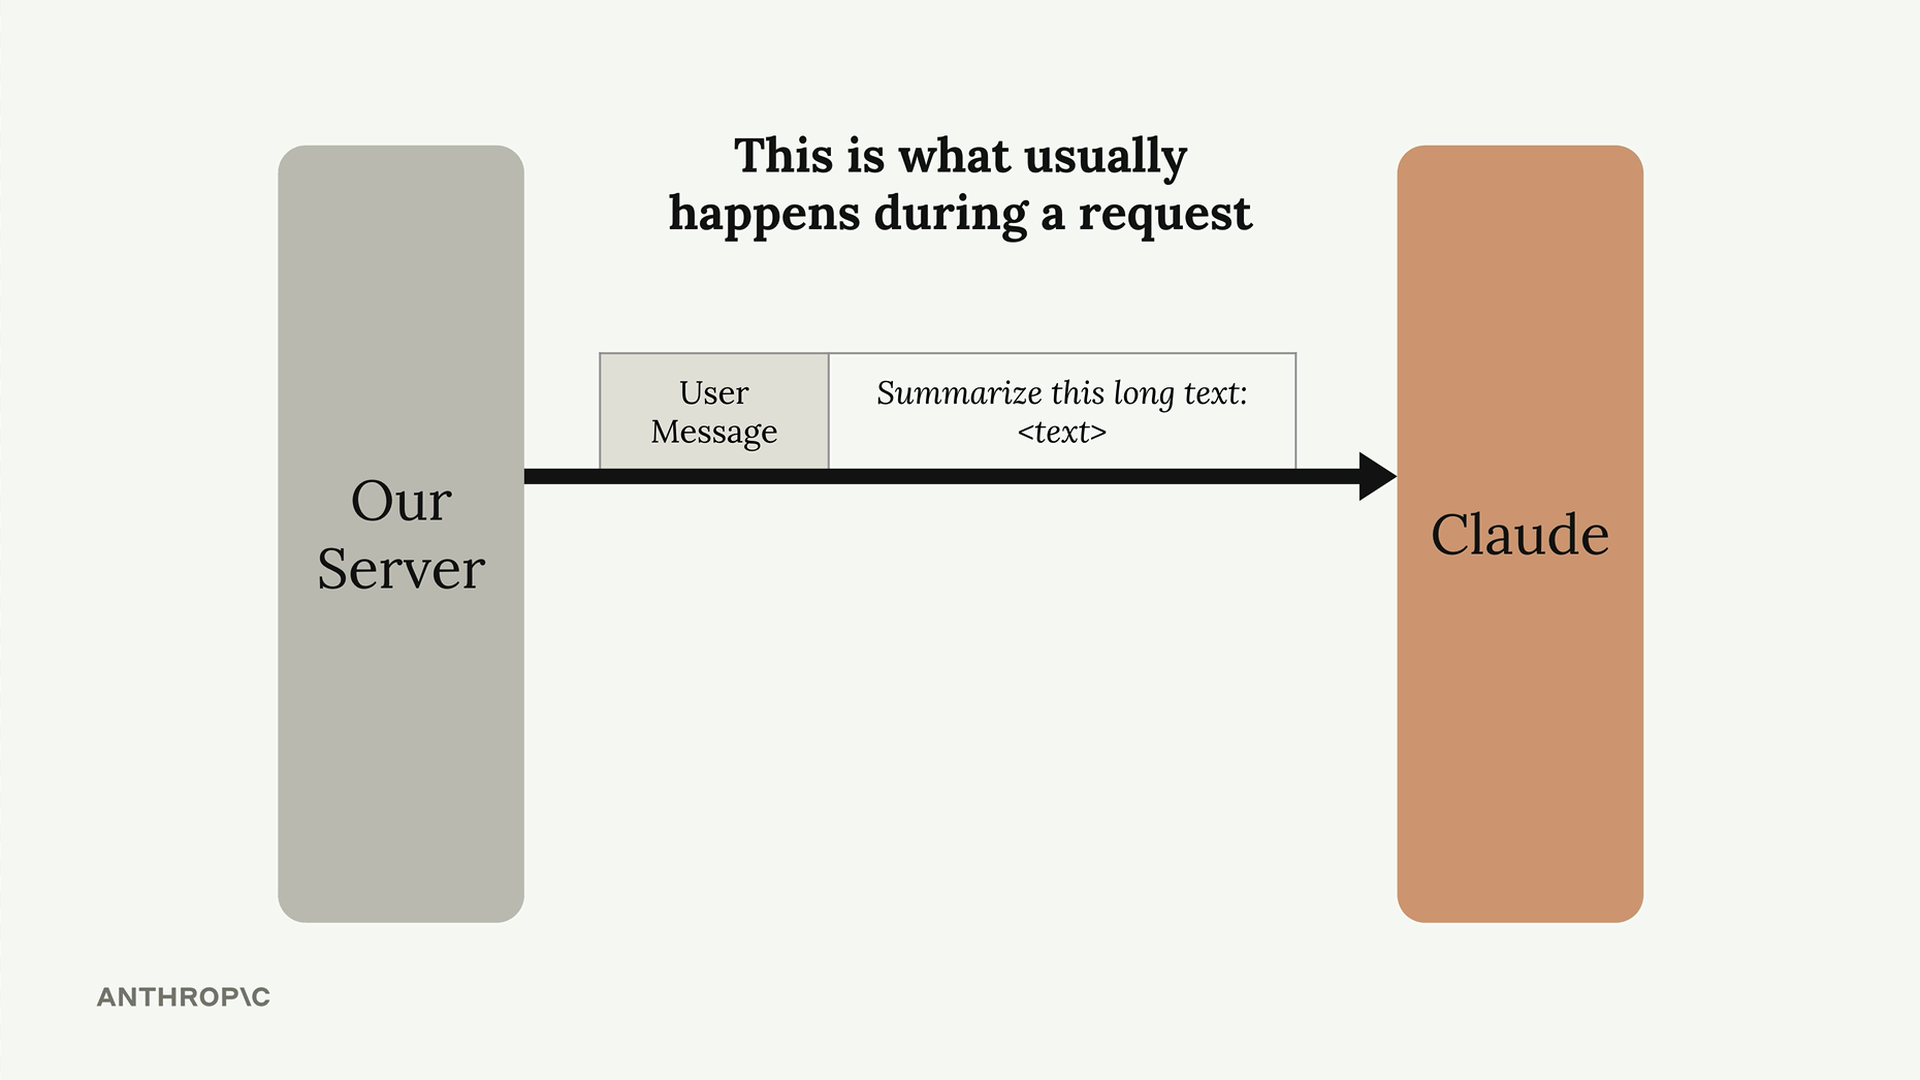
Esto es lo que Claude hace con tu mensaje:
- Tokenizar el prompt
- Crear embeddings para cada token
- Agregar contexto basado en el texto circundante
- Generar el texto de salida
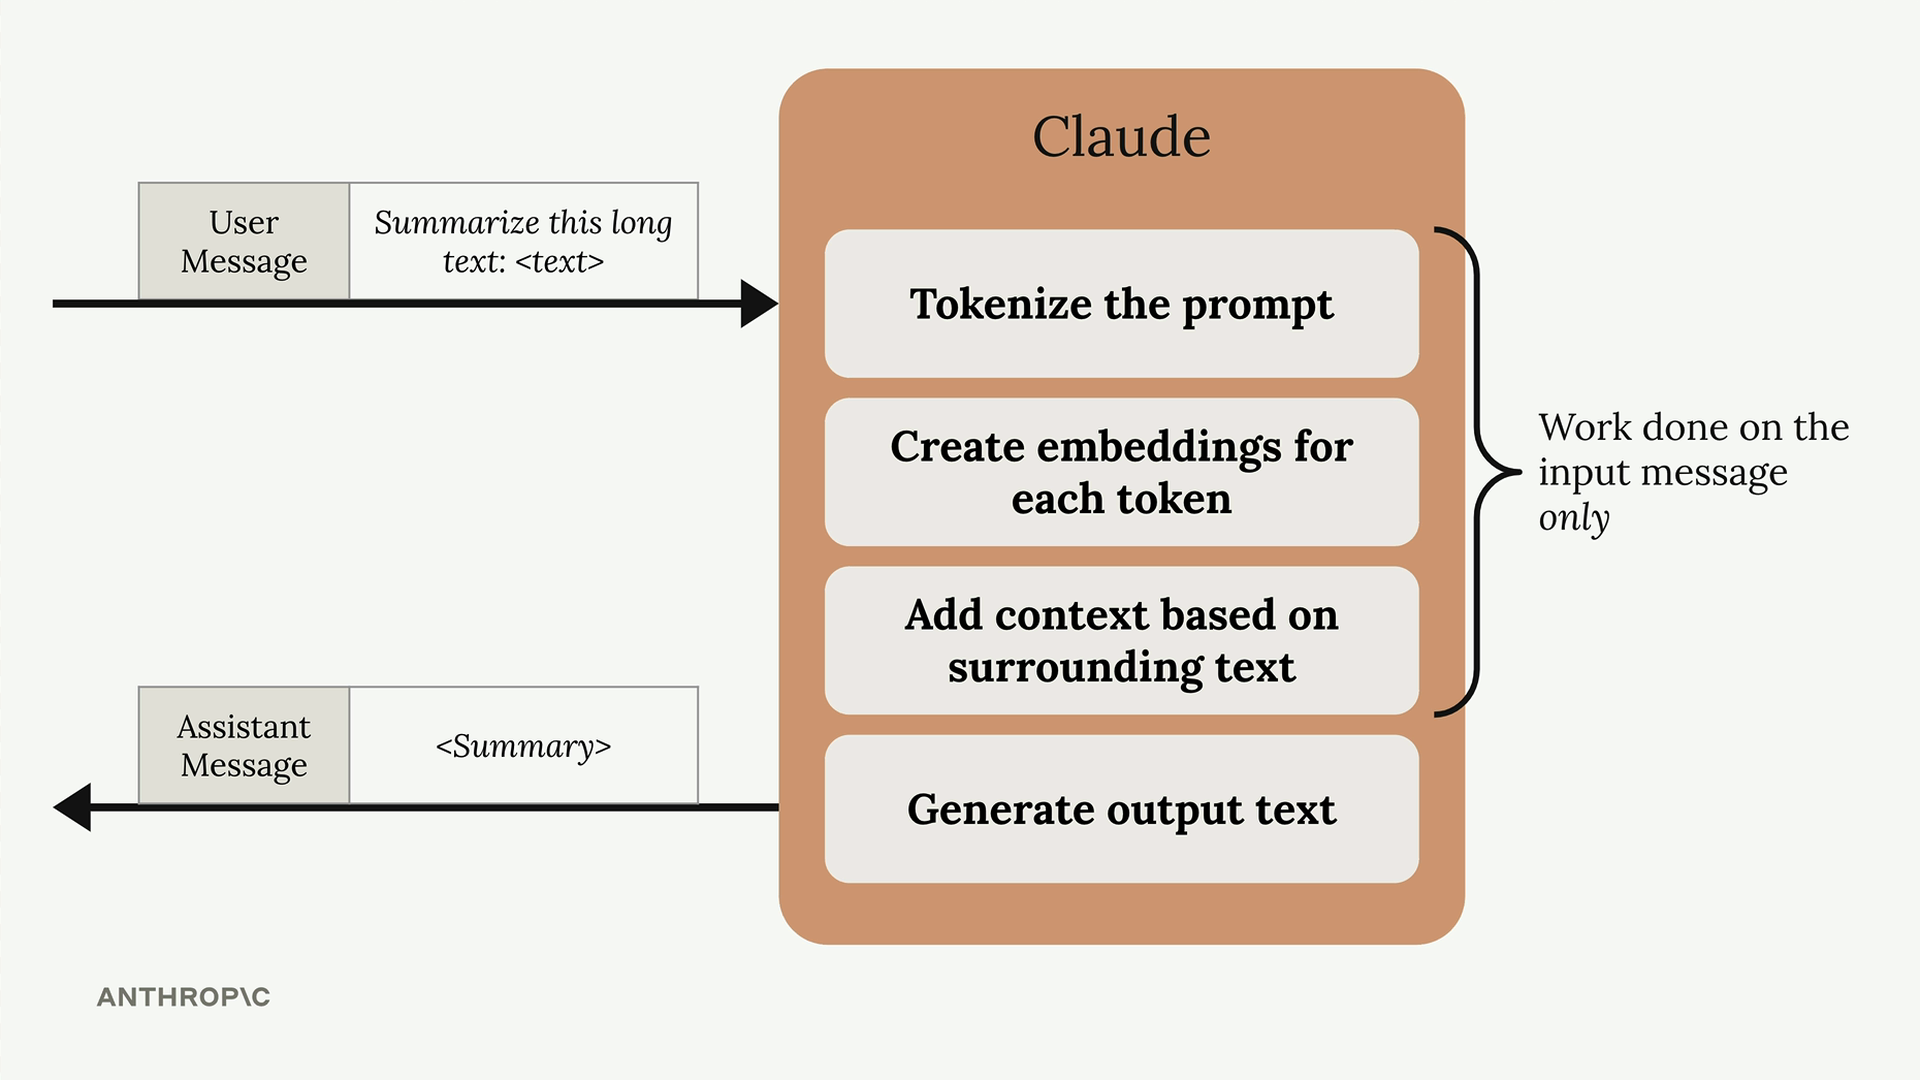
Todo este trabajo de preprocesamiento ocurre antes de que Claude genere cualquier respuesta real. Una vez que Claude termina de procesar tu solicitud y envía la respuesta, descarta todo el trabajo computacional que acaba de realizar.
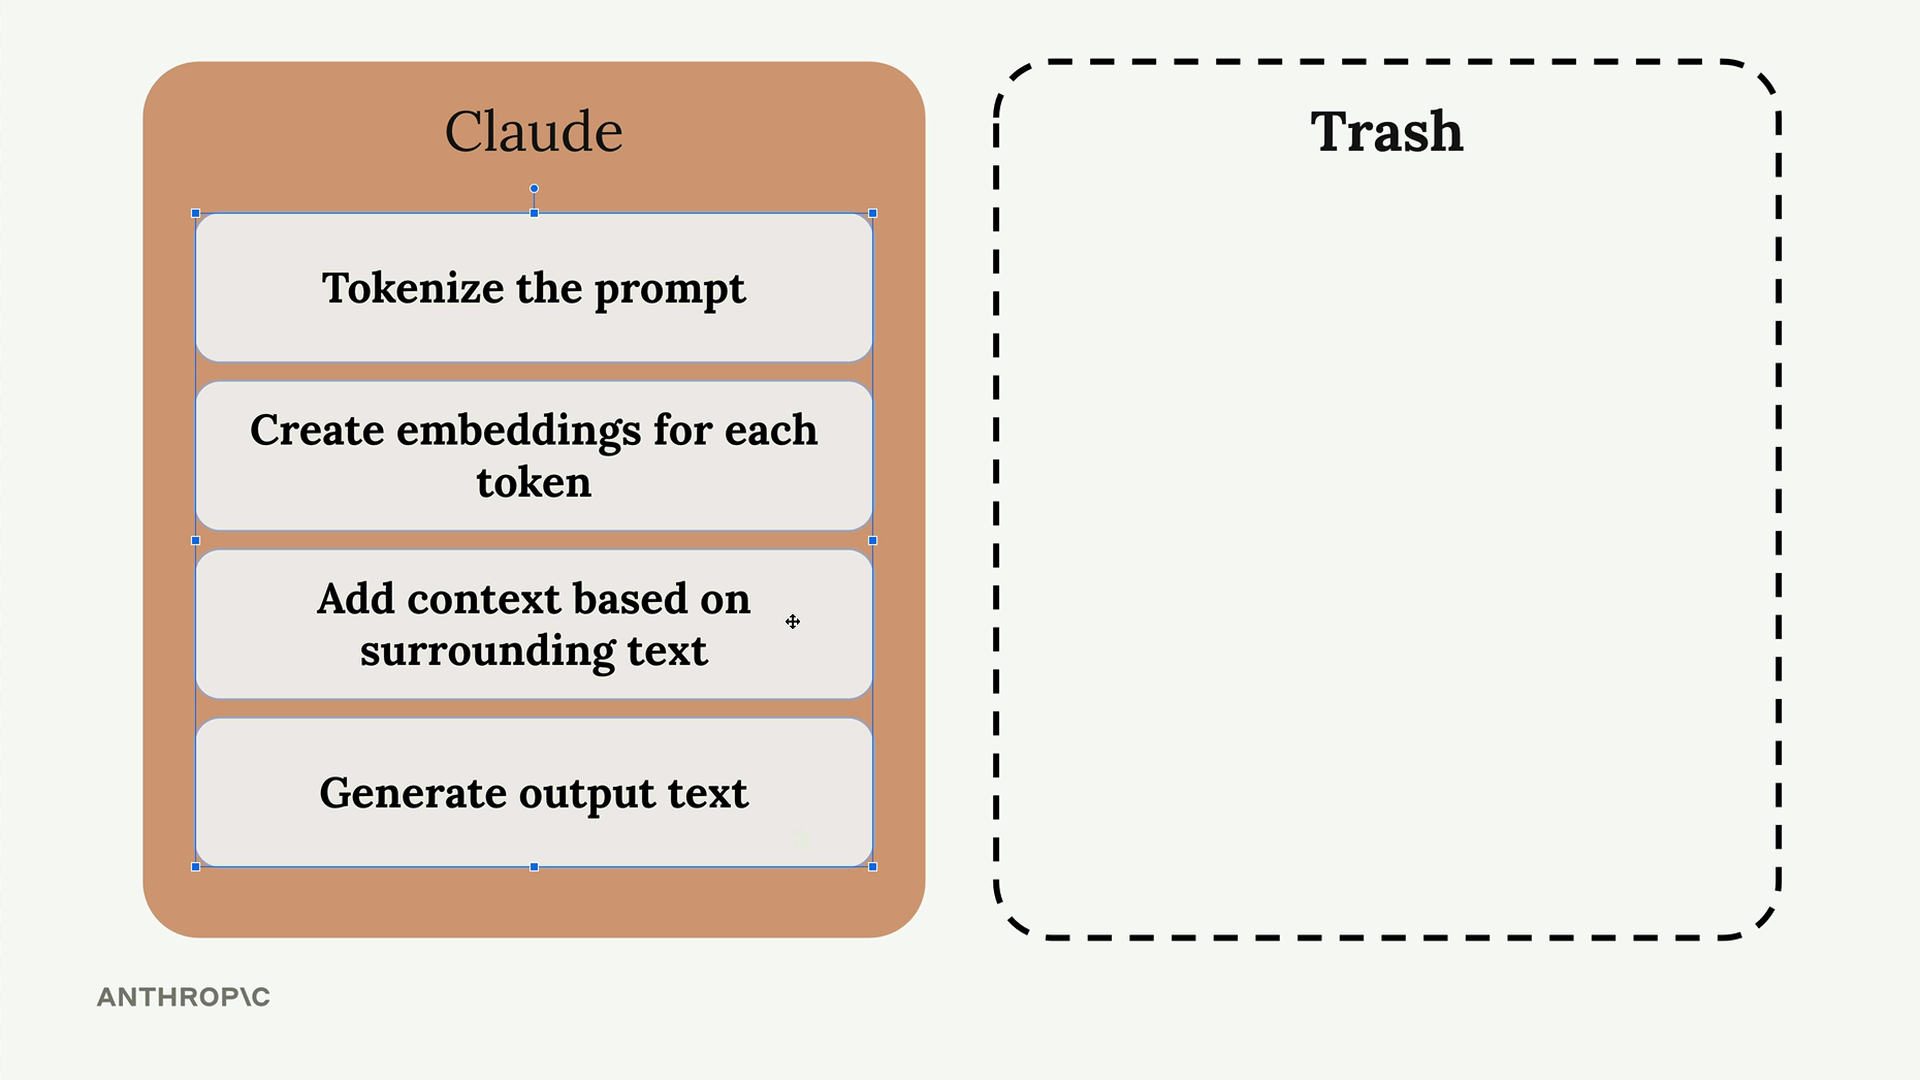
El problema de descartar el trabajo
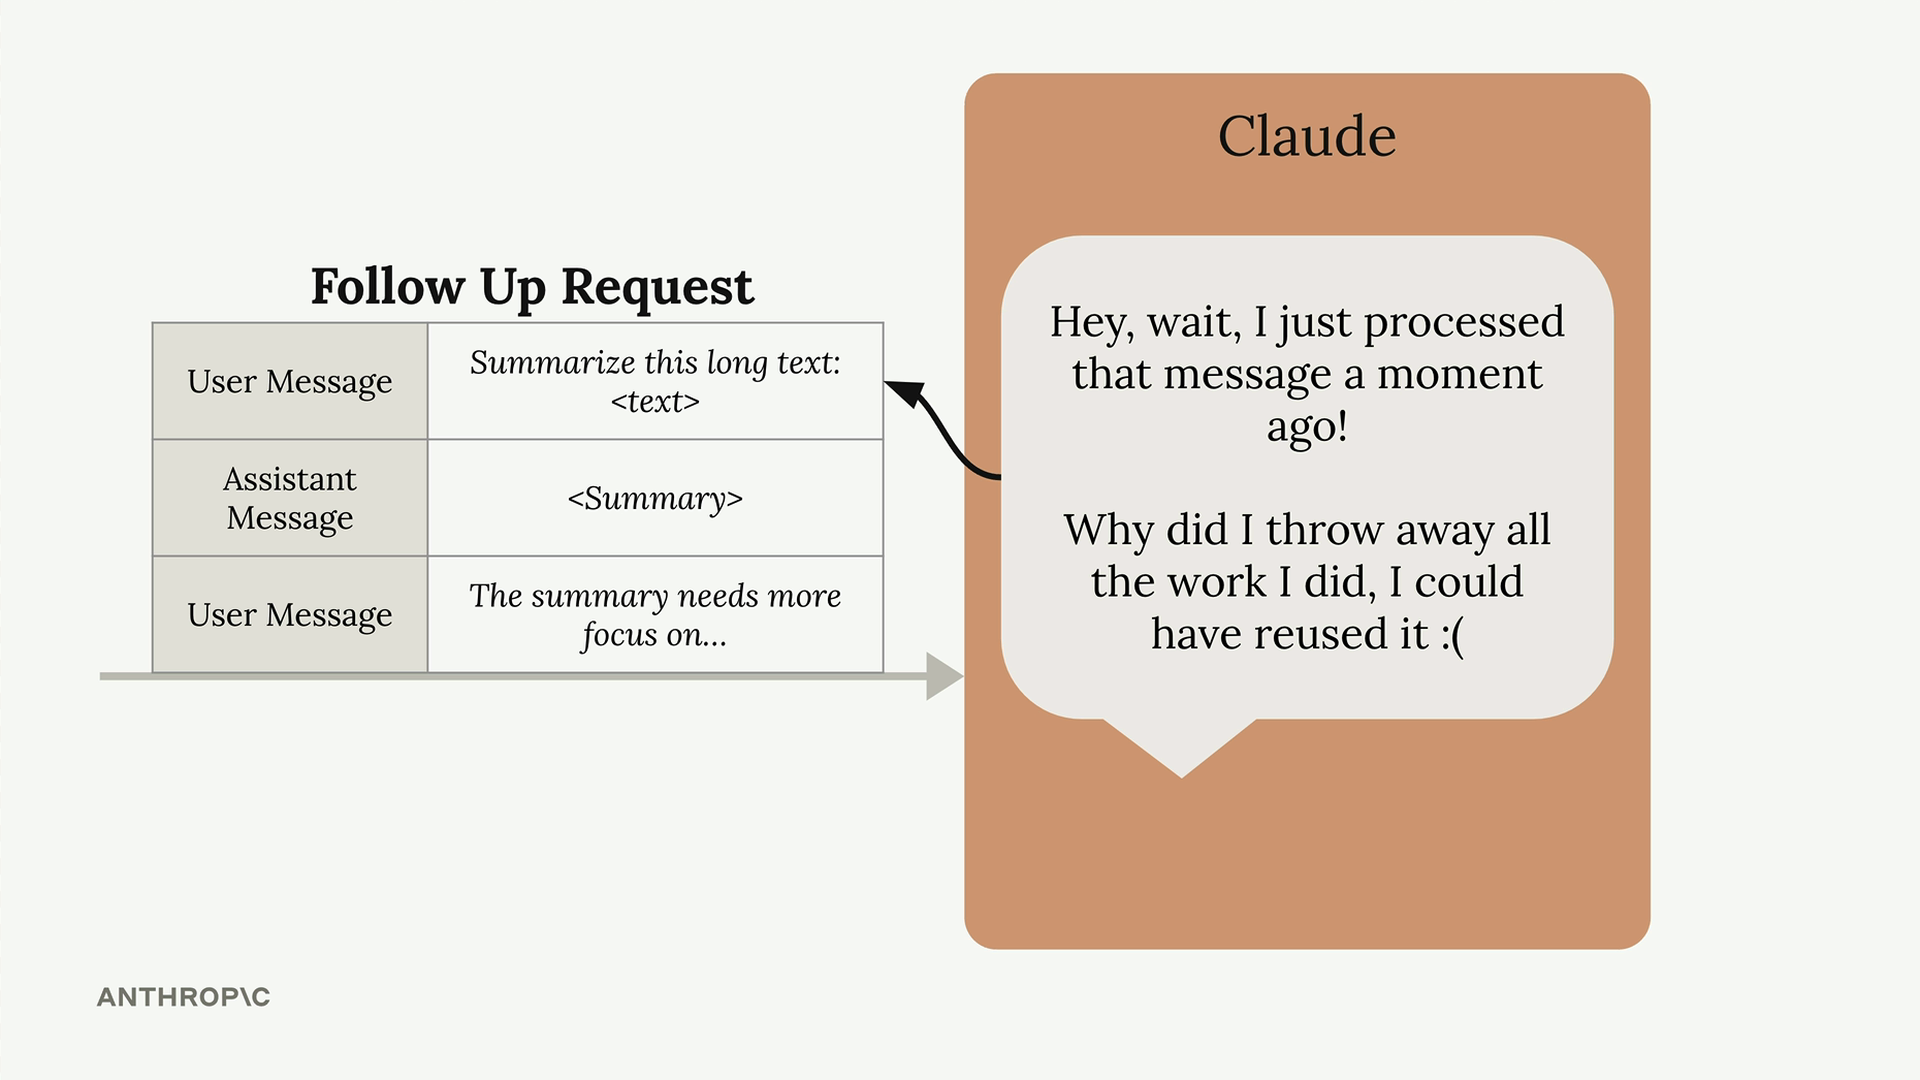
Esto crea una ineficiencia cuando estás teniendo conversaciones con Claude. Supongamos que haces una solicitud de seguimiento que incluye el mismo mensaje de antes, más la respuesta anterior de Claude, más un nuevo mensaje para continuar la conversación.
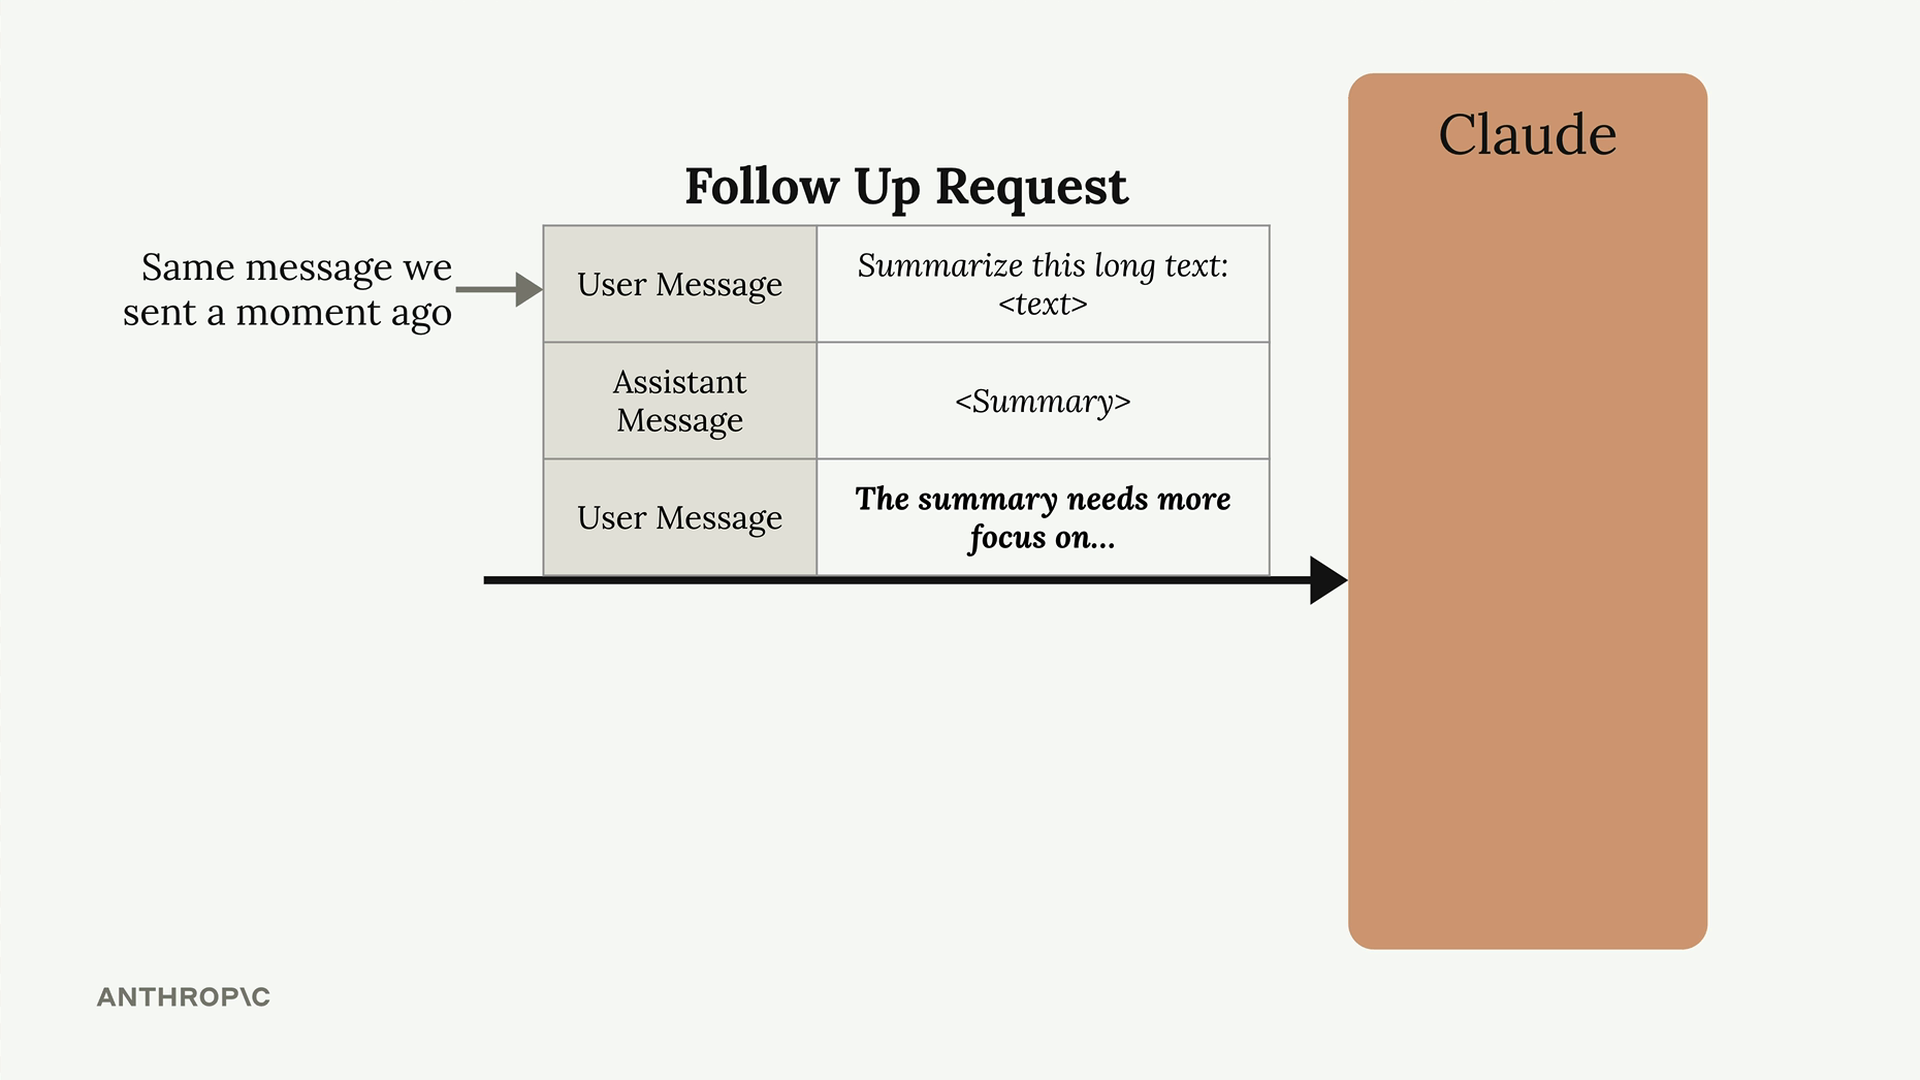
Cuando Claude ve ese mensaje original de nuevo, tiene que rehacer todo el mismo trabajo computacional que acababa de descartar momentos antes. Claude esencialmente piensa: "Acabo de procesar este mensaje exacto e hice todo este trabajo, luego lo descarté. Ahora tengo que hacerlo todo de nuevo".
Cómo el almacenamiento en caché de prompts soluciona esto
El almacenamiento en caché de prompts aborda esta ineficiencia al guardar el trabajo computacional en lugar de descartarlo. Así es como funciona:
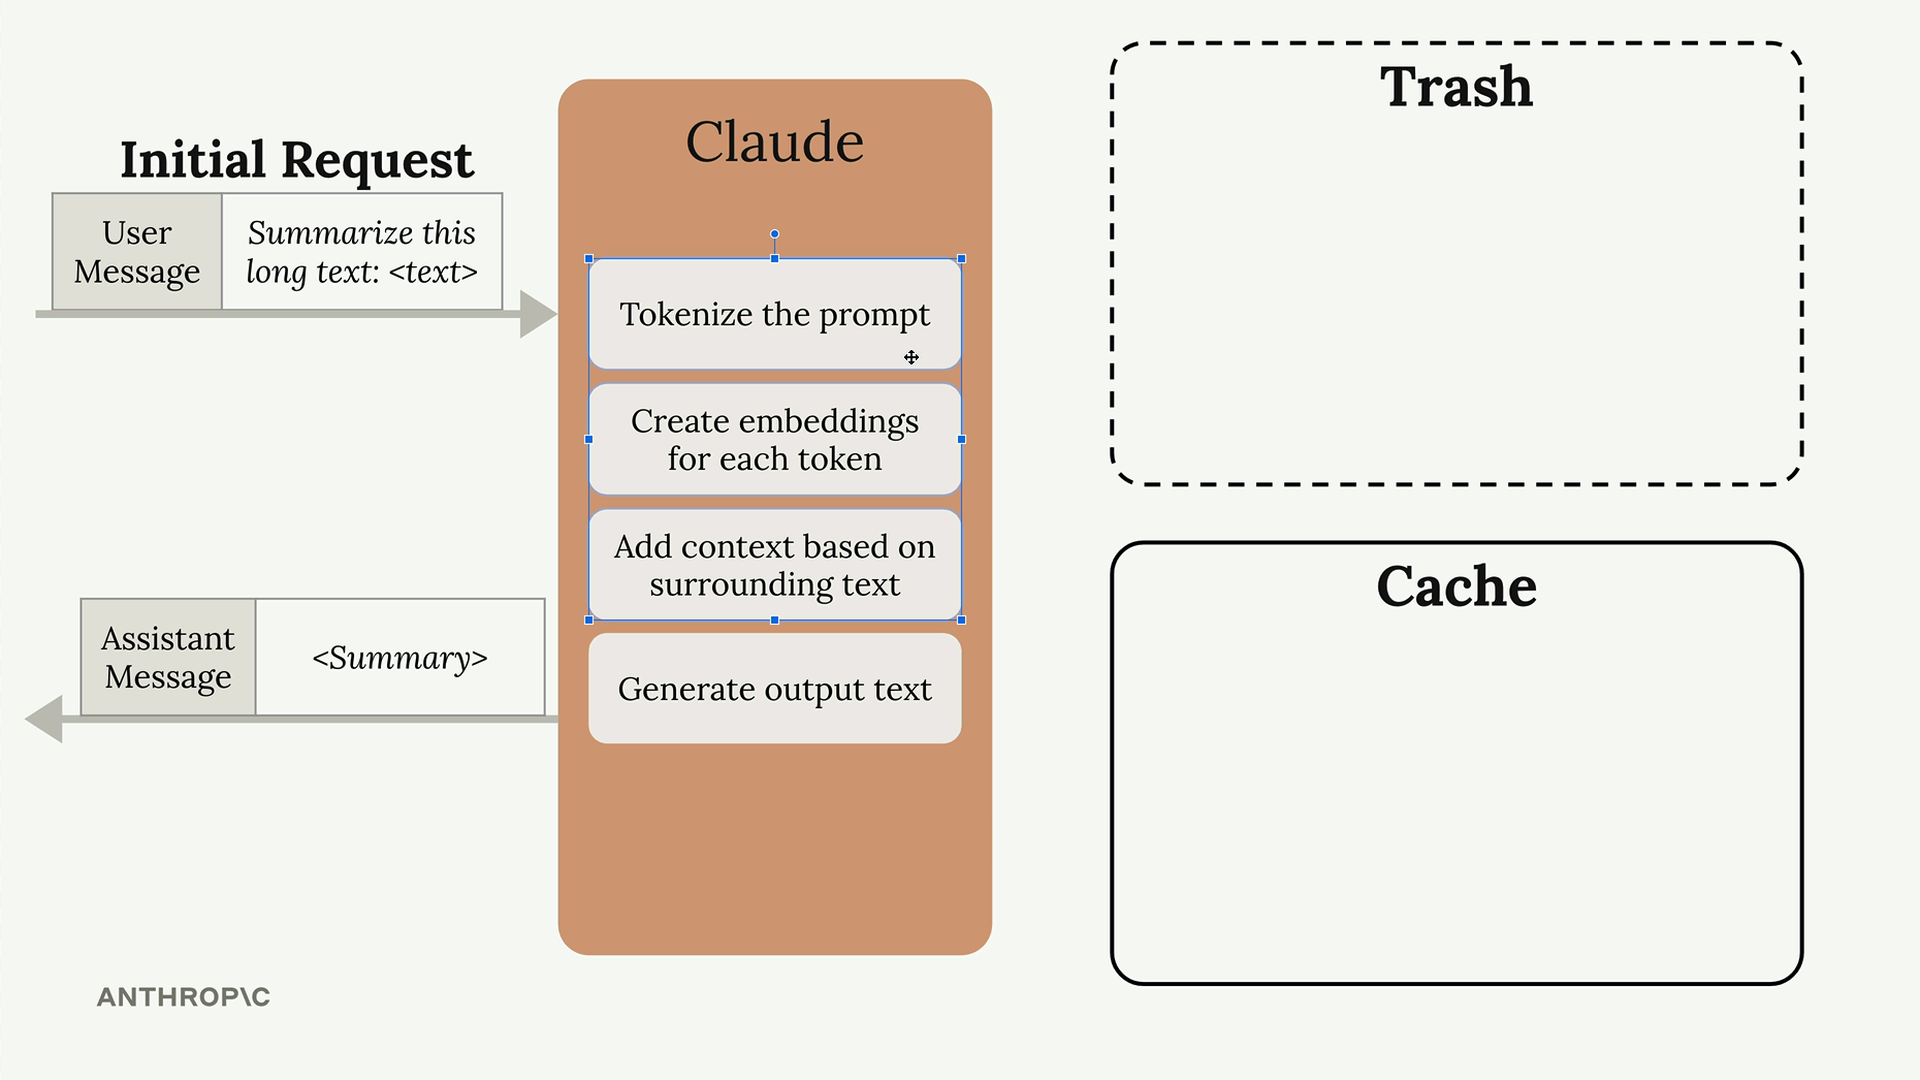
Cuando Claude procesa tu solicitud inicial, en lugar de descartar todo el trabajo de preprocesamiento, lo almacena en una caché. La caché actúa como una tabla de búsqueda que asigna mensajes de entrada específicos a sus resultados computacionales correspondientes.
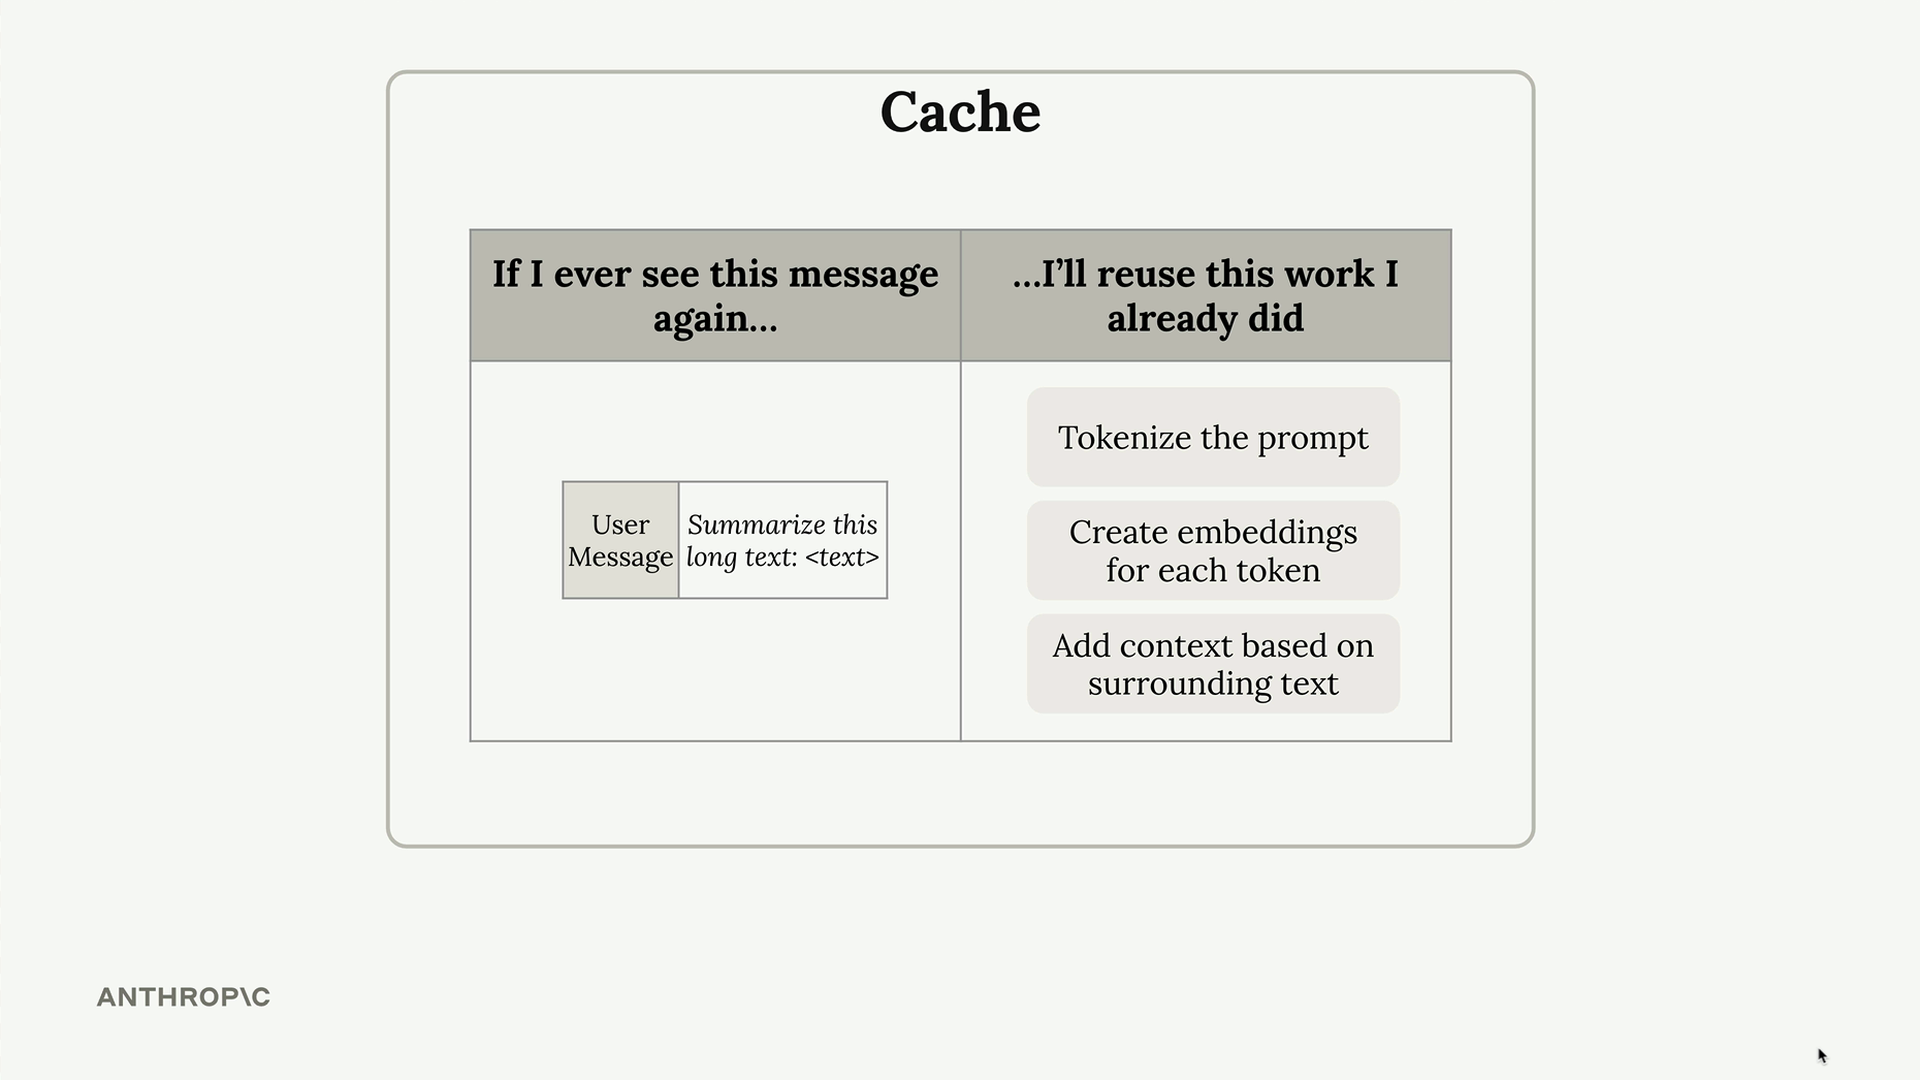
Cuando haces una solicitud de seguimiento que incluye el mismo contenido, Claude puede consultar su caché y reutilizar el trabajo anterior en lugar de empezar desde cero.
Beneficios y limitaciones clave
El almacenamiento en caché de prompts ofrece varias ventajas:
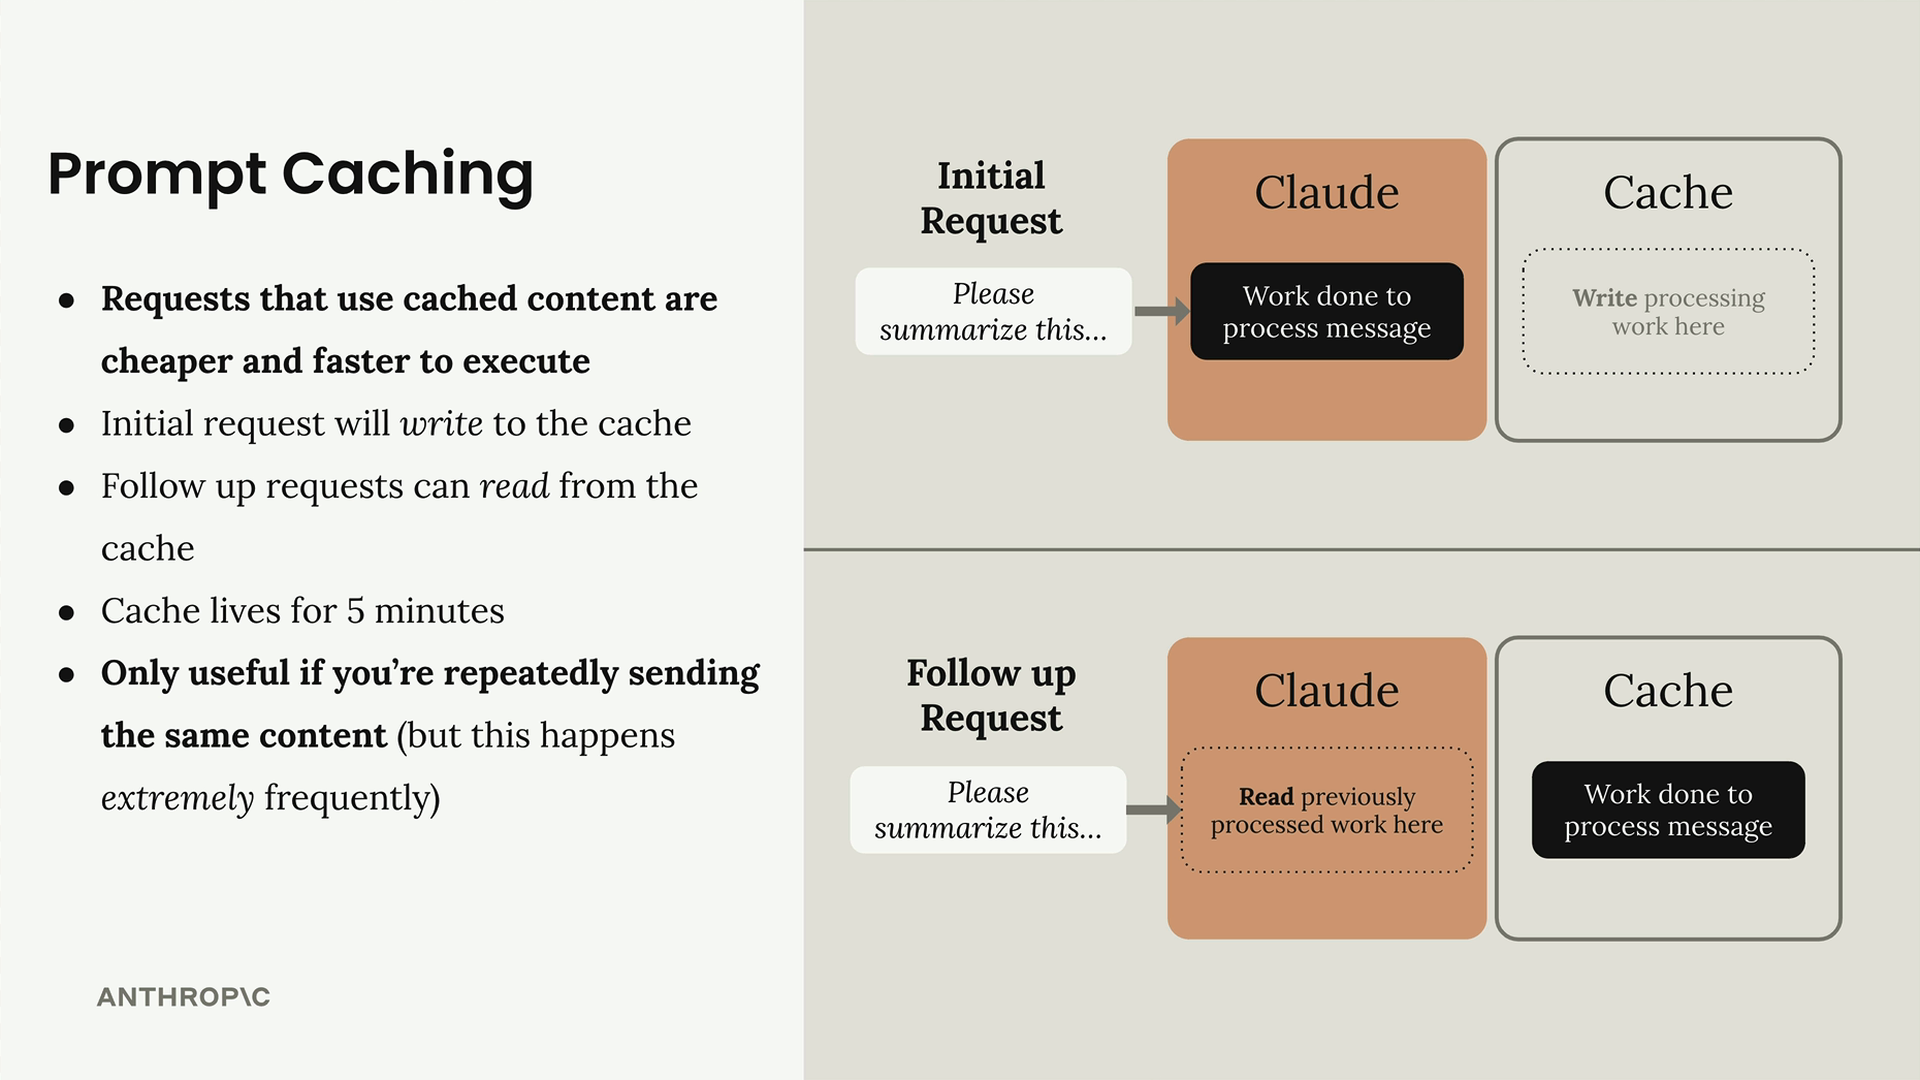
- Las solicitudes que usan contenido en caché son más económicas y rápidas de ejecutar
- La solicitud inicial escribirá en la caché
- Las solicitudes de seguimiento pueden leer de la caché
- La caché vive durante 5 minutos
- Solo es útil si estás enviando repetidamente el mismo contenido (pero esto sucede con extrema frecuencia)
La caché tiene una vida útil de 5 minutos, por lo que es más beneficiosa para conversaciones o flujos de trabajo donde realizas múltiples solicitudes con contenido superpuesto dentro de un período corto de tiempo. Este patrón es, de hecho, muy común en aplicaciones reales; piensa en chatbots, herramientas de análisis de documentos o cualquier sistema que mantenga contexto de conversación.
El almacenamiento en caché de prompts es particularmente valioso porque muchas aplicaciones de IA envían repetidamente el mismo contenido. Ya sea que se trate de indicaciones del sistema, historial de conversación o documentos extensos que se están analizando, el mismo texto a menudo aparece en múltiples solicitudes dentro de una sesión.