Un flujo de trabajo típico de evaluación de prompts sigue un enfoque sistemático para medir y mejorar tus prompts de manera objetiva. Aunque hay muchas formas diferentes de ensamblar estos flujos de trabajo y diversas herramientas de código abierto y de pago disponibles, entender el proceso central te ayuda a empezar de forma pequeña y escalar según sea necesario.
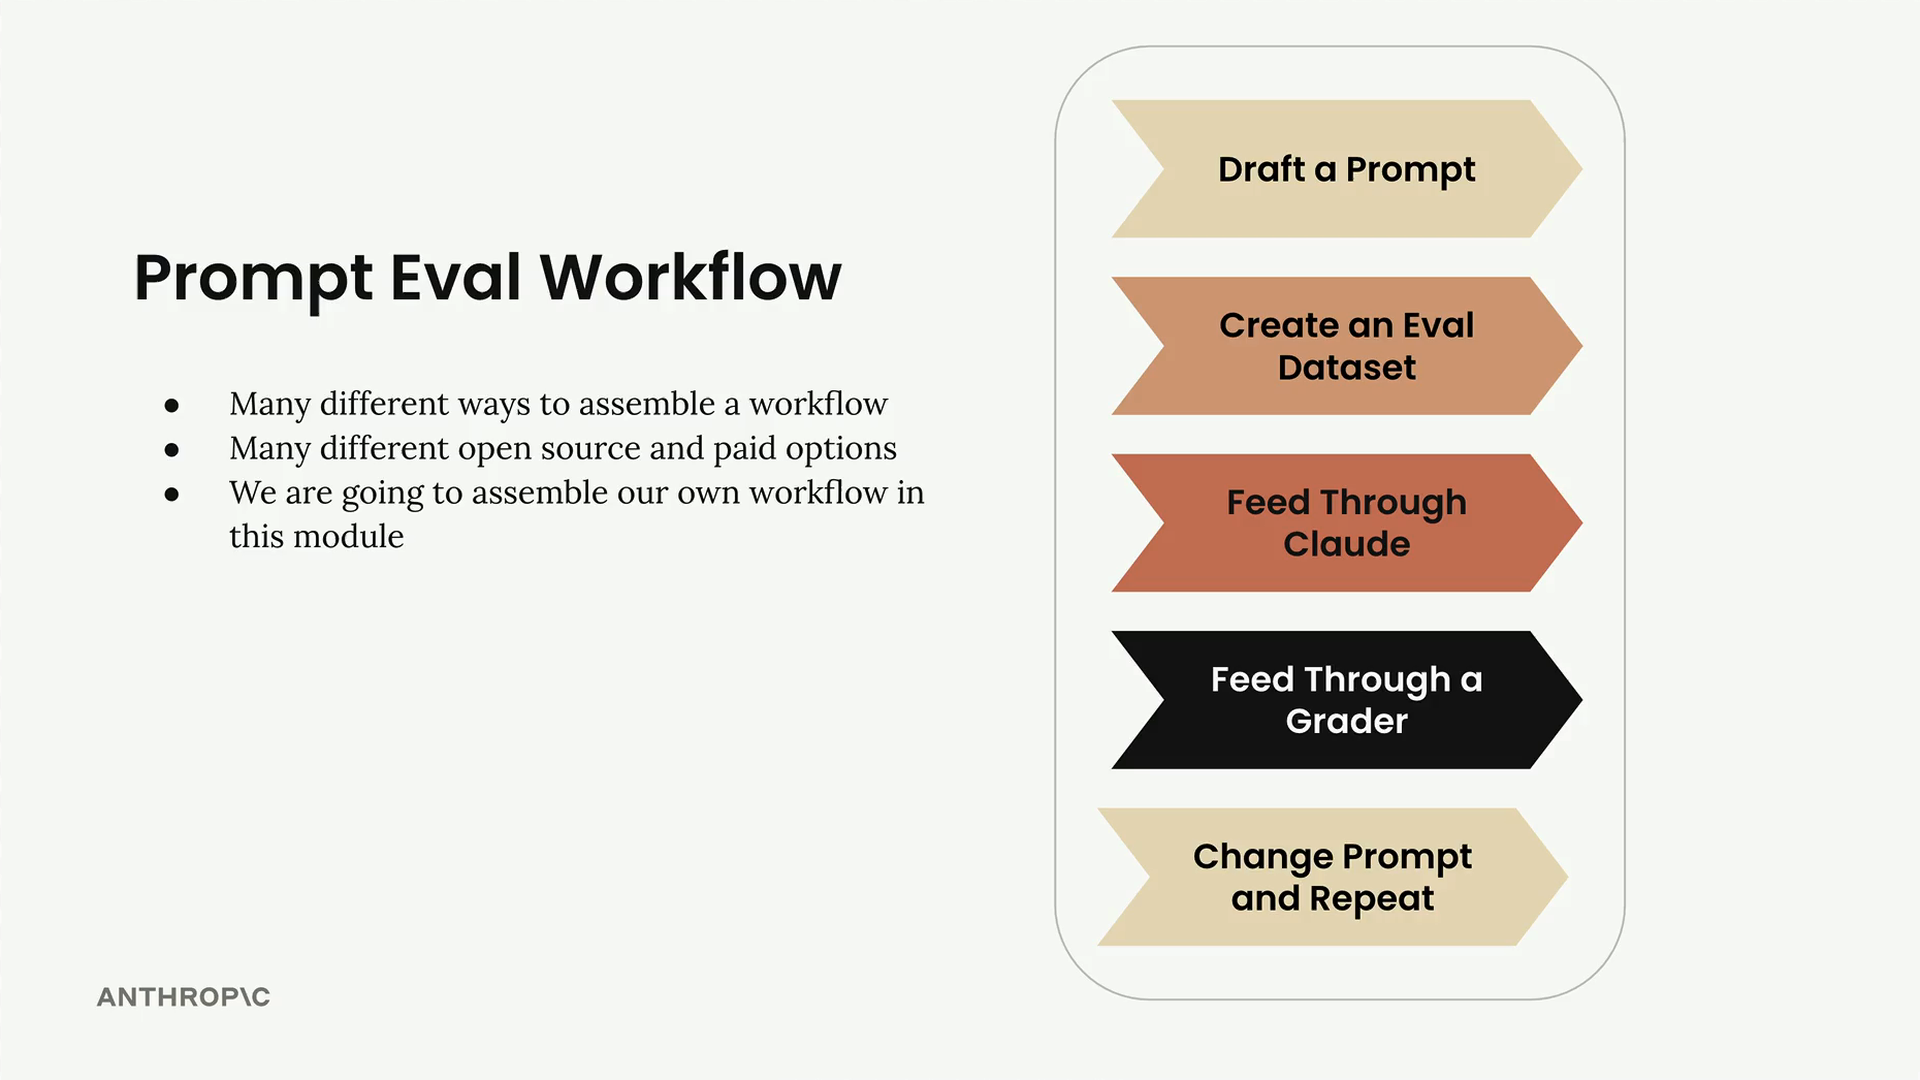
Paso 1: Redacta tu prompt inicial
Comienza escribiendo un prompt básico que quieras mejorar. Para este ejemplo, usaremos una estructura de prompt simple:
prompt = f"""
Please answer the user's question:

{question}
"""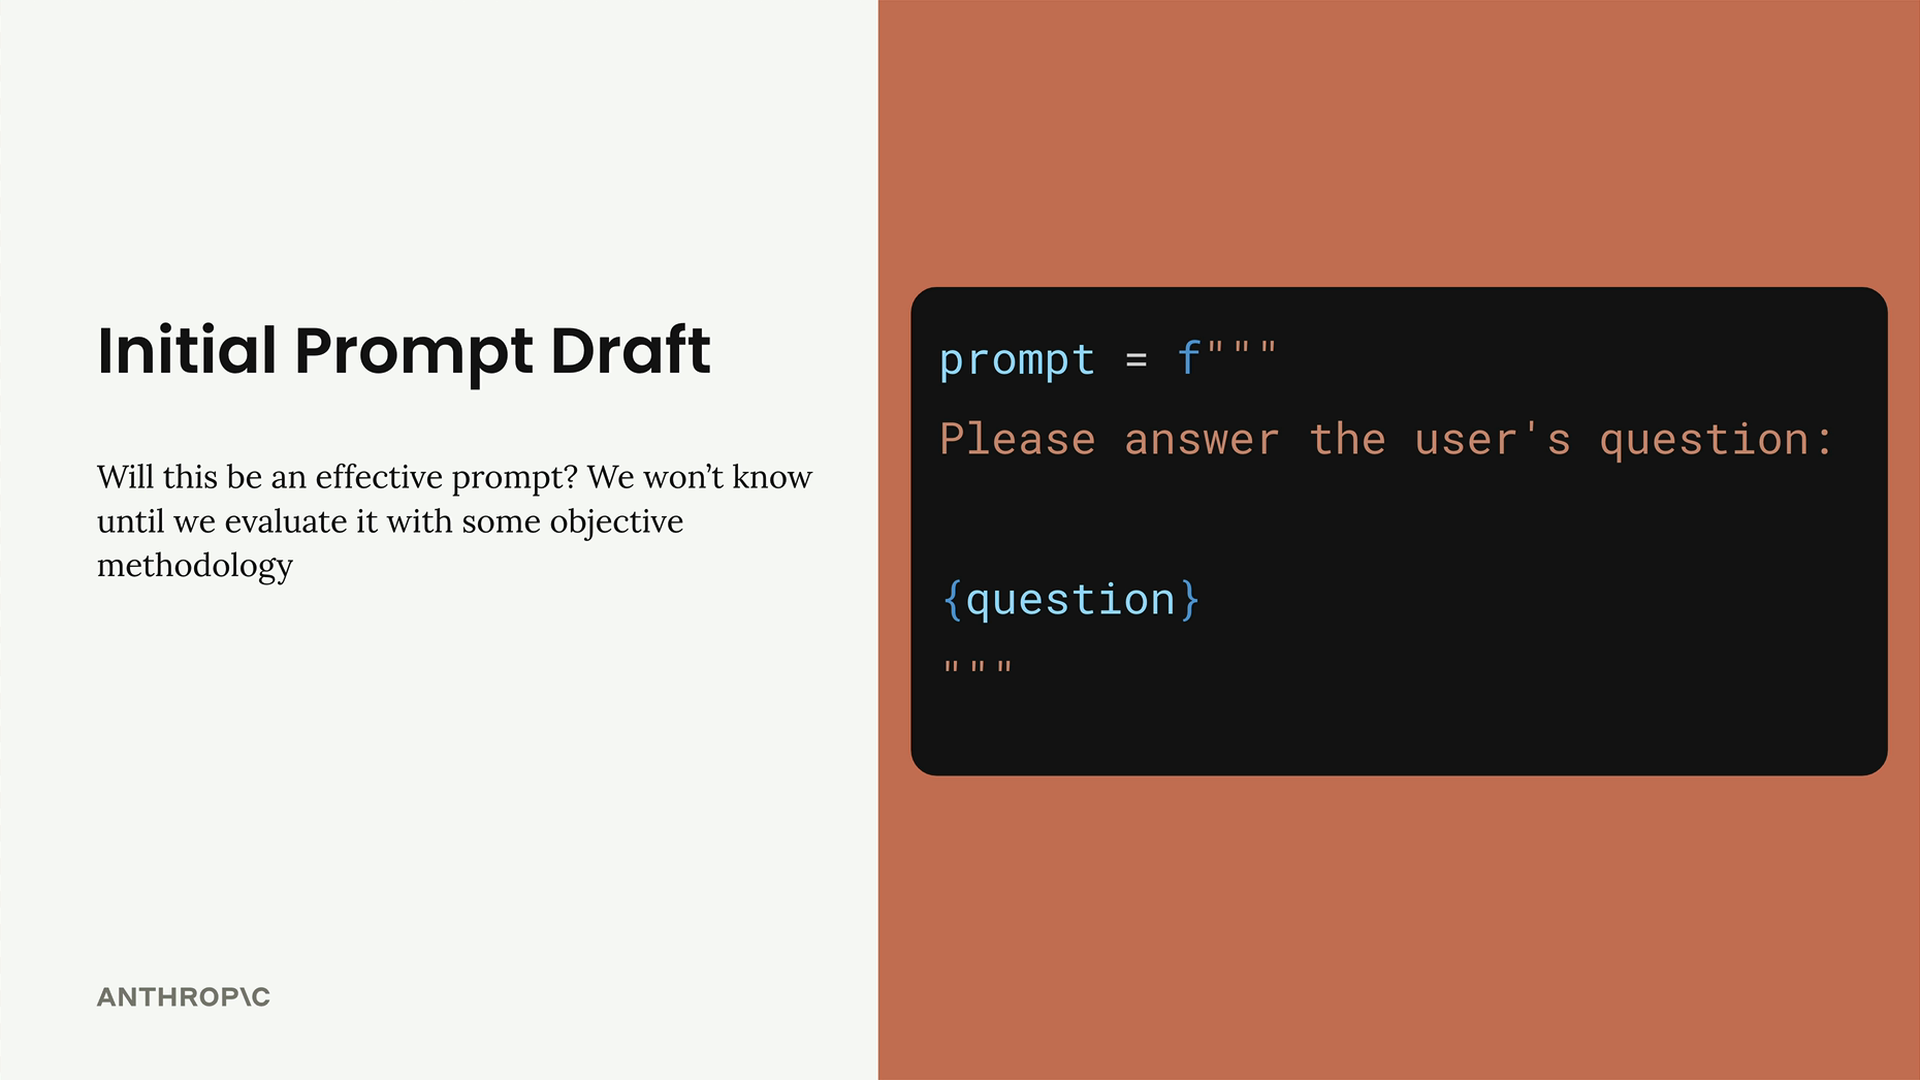
Esto nos da una línea base desde la cual trabajar. No sabremos si es efectivo hasta que lo evaluemos con alguna metodología objetiva.
Paso 2: Crea un conjunto de datos de evaluación
Tu conjunto de datos de evaluación contiene entradas de muestra que alimentarás a tu prompt. Dado que nuestro prompt solo tiene una entrada (la pregunta del usuario), necesitamos una colección de diferentes preguntas para probar.
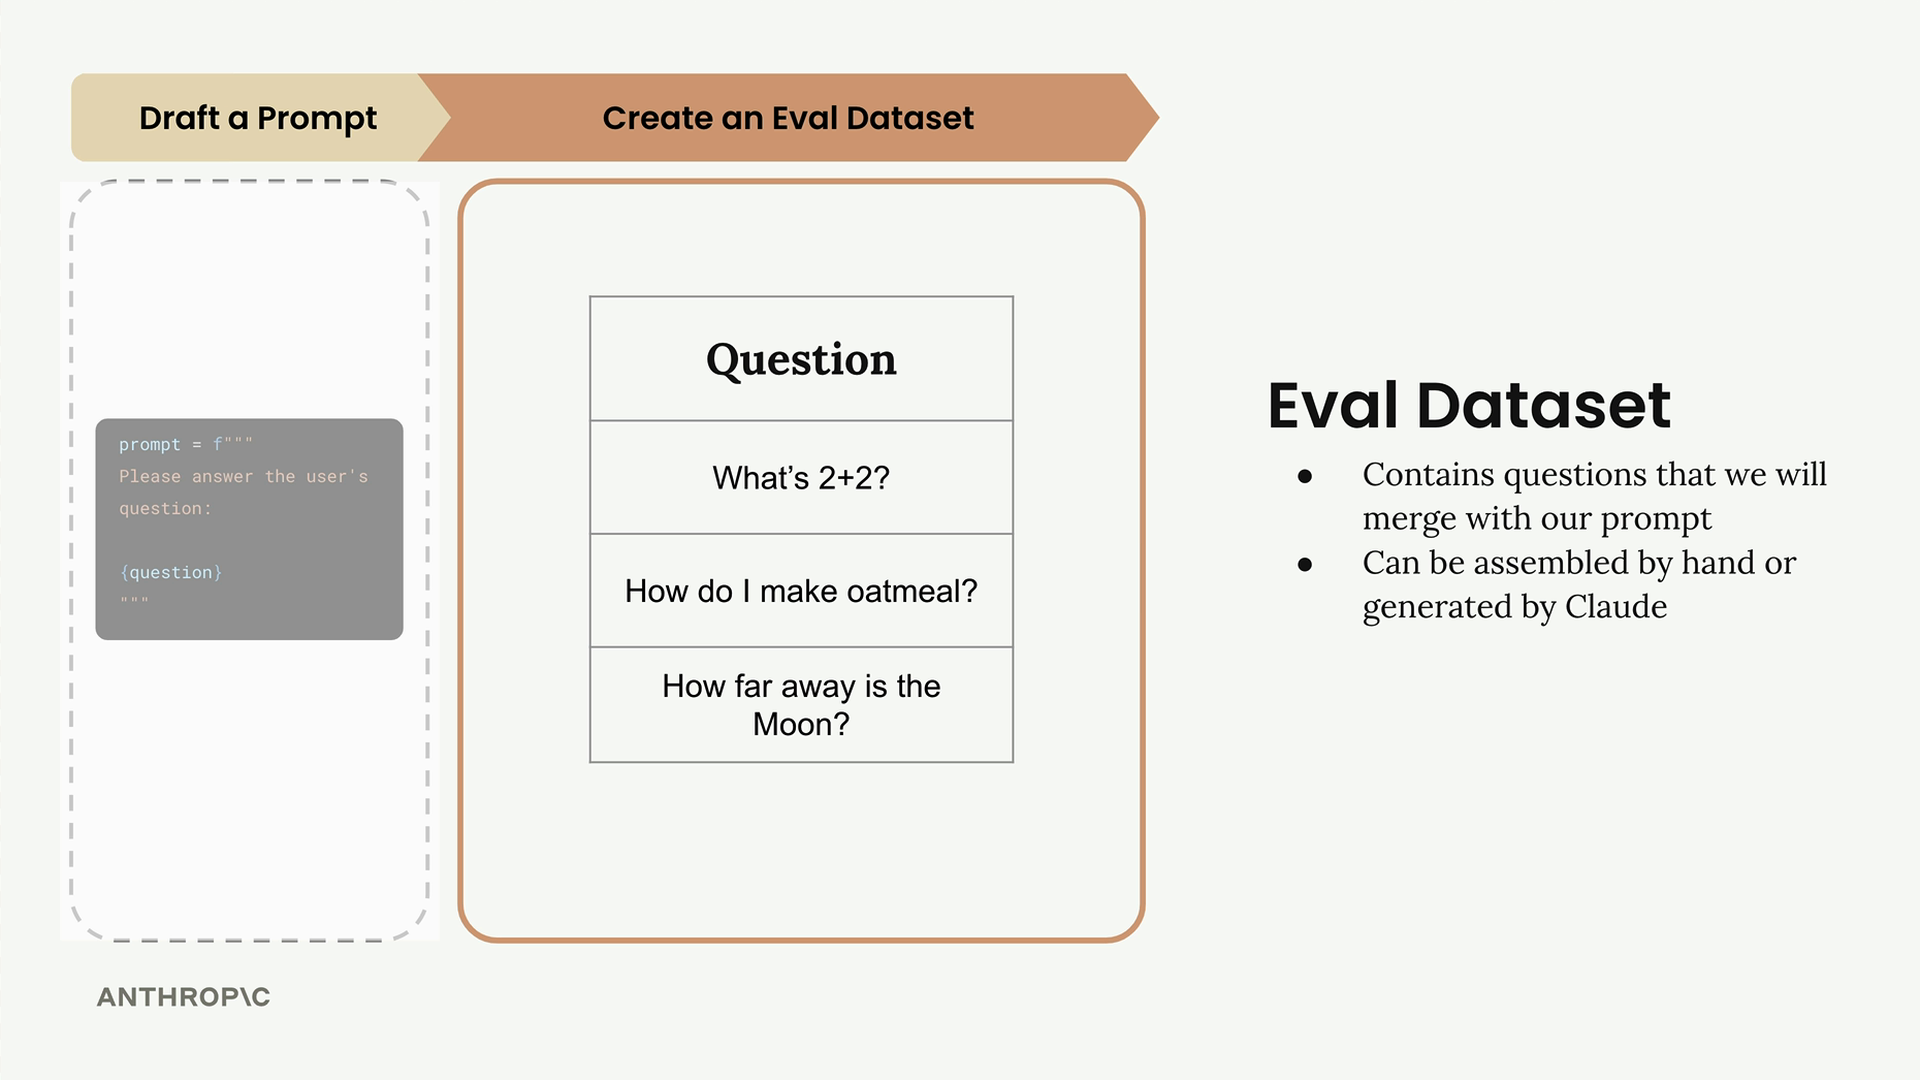
El conjunto de datos contiene preguntas que fusionaremos con nuestro prompt. Puedes ensamblar estos conjuntos de datos a mano o generarlos usando Claude. En evaluaciones del mundo real, podrías tener decenas, cientos o incluso miles de registros diferentes, pero comenzaremos con solo tres preguntas para este ejemplo:
- ¿Cuánto es 2+2?
- ¿Cómo preparo avena?
- ¿A qué distancia está la Luna?
Paso 3: Pasa por Claude
Toma cada pregunta de tu conjunto de datos y fusiónala con tu plantilla de prompt para crear prompts completos. Luego envía cada uno a Claude y recopila las respuestas.
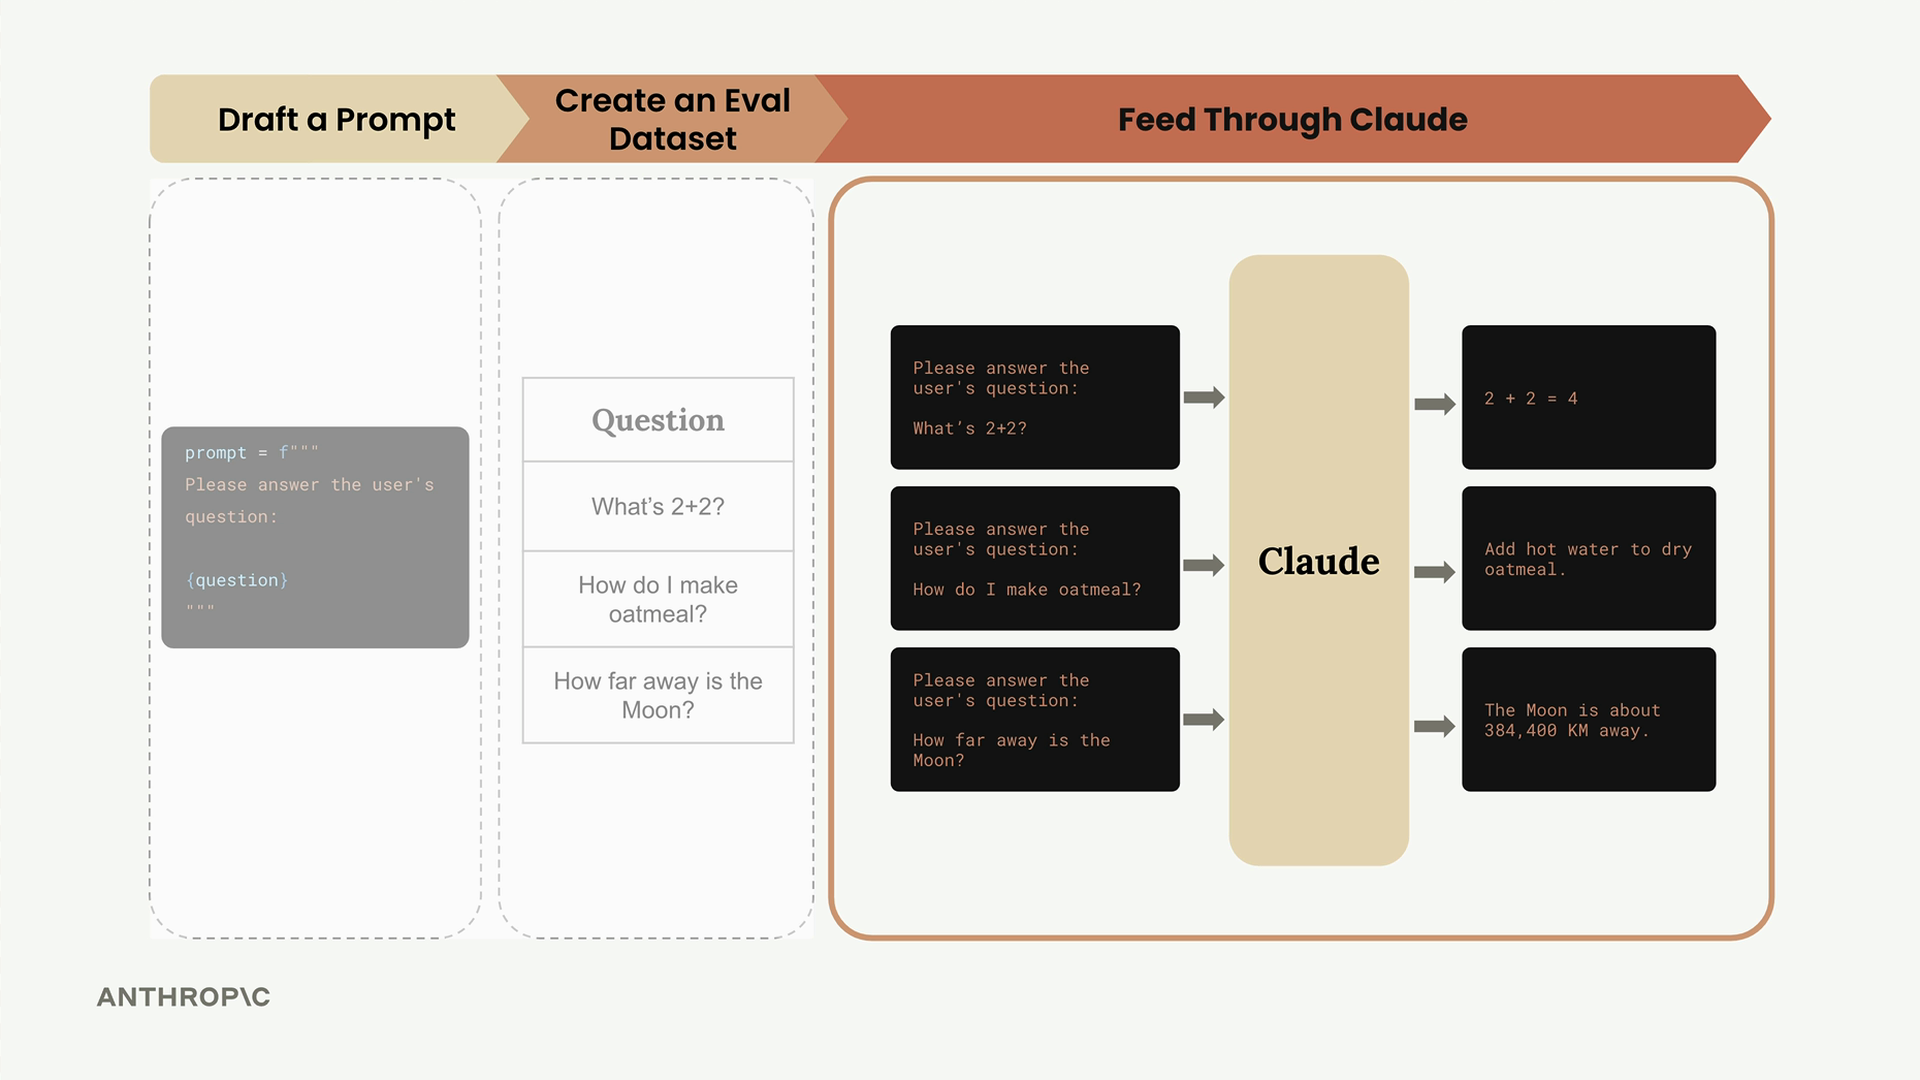
Por ejemplo, la primera pregunta se convierte en un prompt completo al que Claude puede responder. Repetirás este proceso para todos los registros de tu conjunto de datos, obteniendo respuestas como "2 + 2 = 4", instrucciones detalladas sobre la avena e información sobre la distancia de la Luna.
Paso 4: Pasa por un evaluador
Ahora viene el paso crucial: puntuar objetivamente las respuestas de Claude. Toma cada par de pregunta y respuesta y aliméntalos a un evaluador que calificará la calidad de la respuesta de Claude.
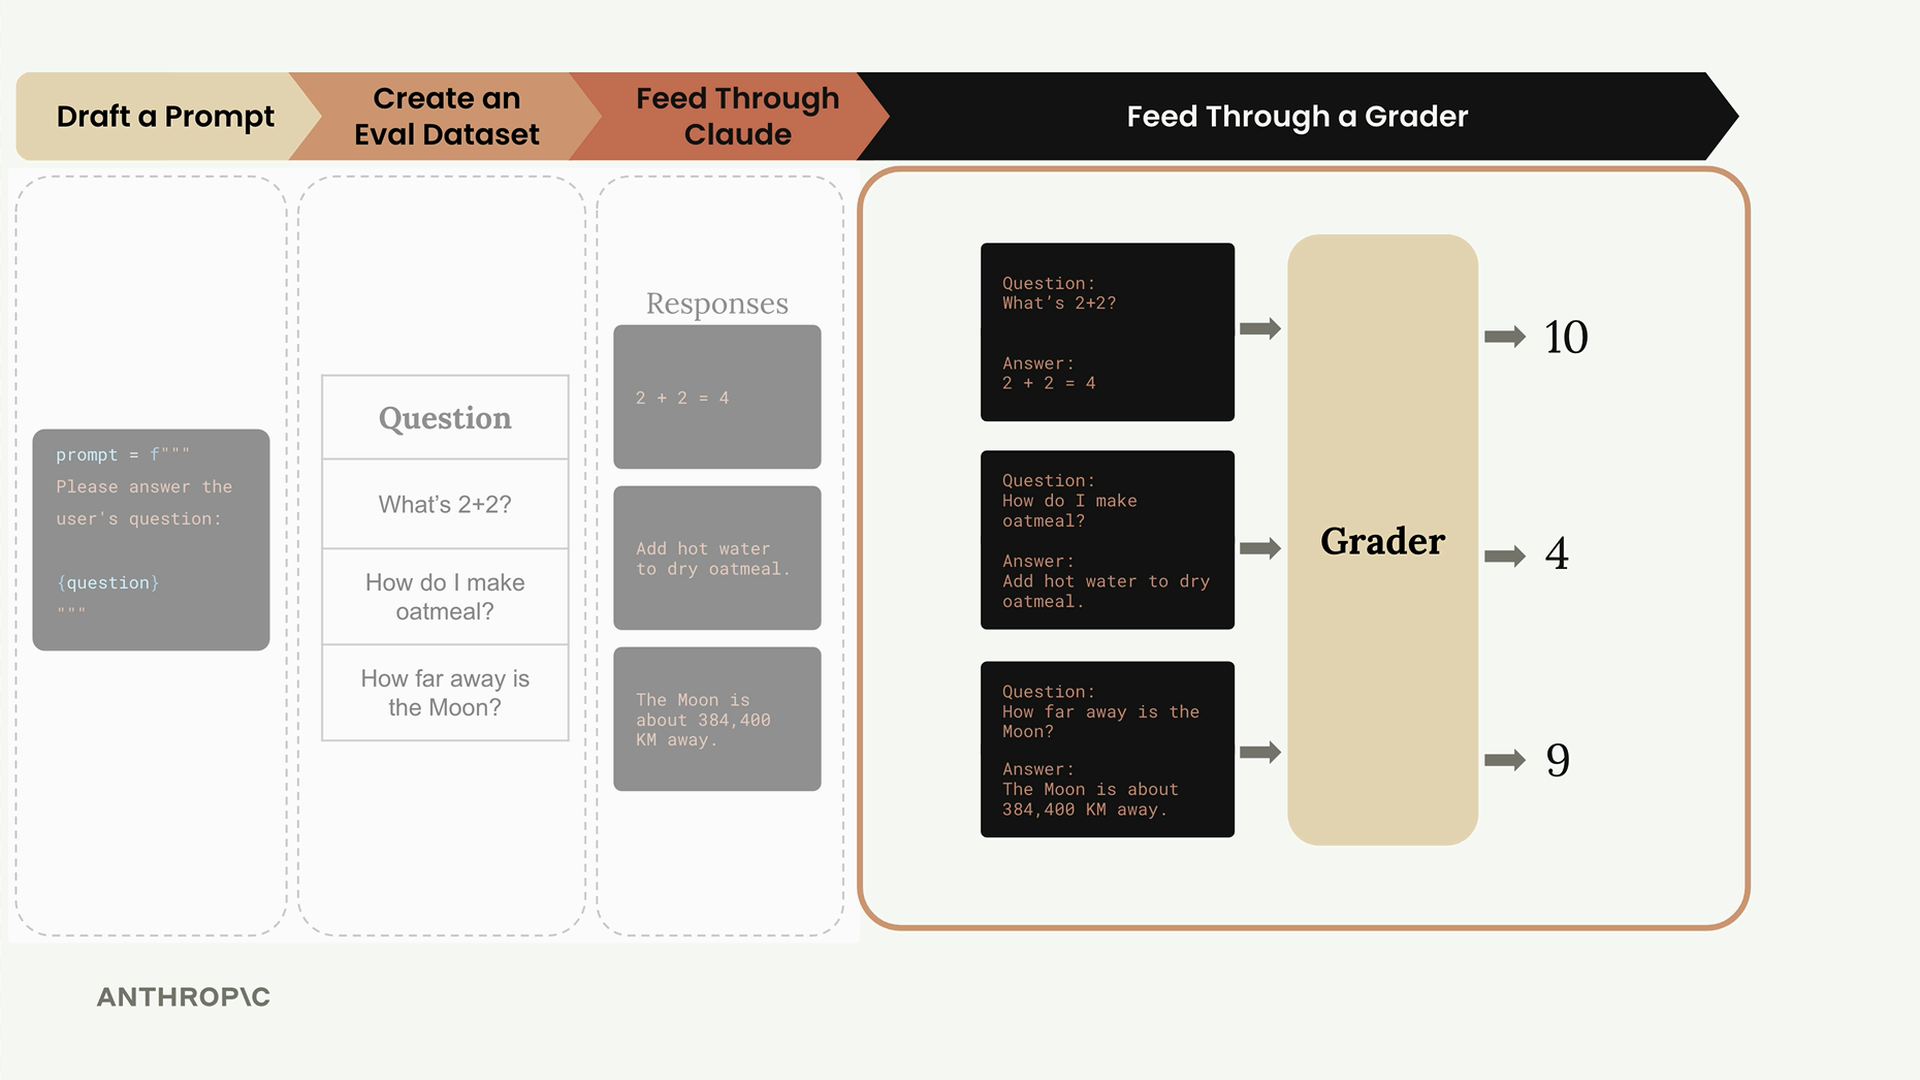
El evaluador asigna puntuaciones (normalmente del 1 al 10) según la calidad de la respuesta:
- 10 = Respuesta perfecta, sin margen de mejora
- 4 = Definitivamente hay margen de mejora
- 1 = Respuesta deficiente o incorrecta
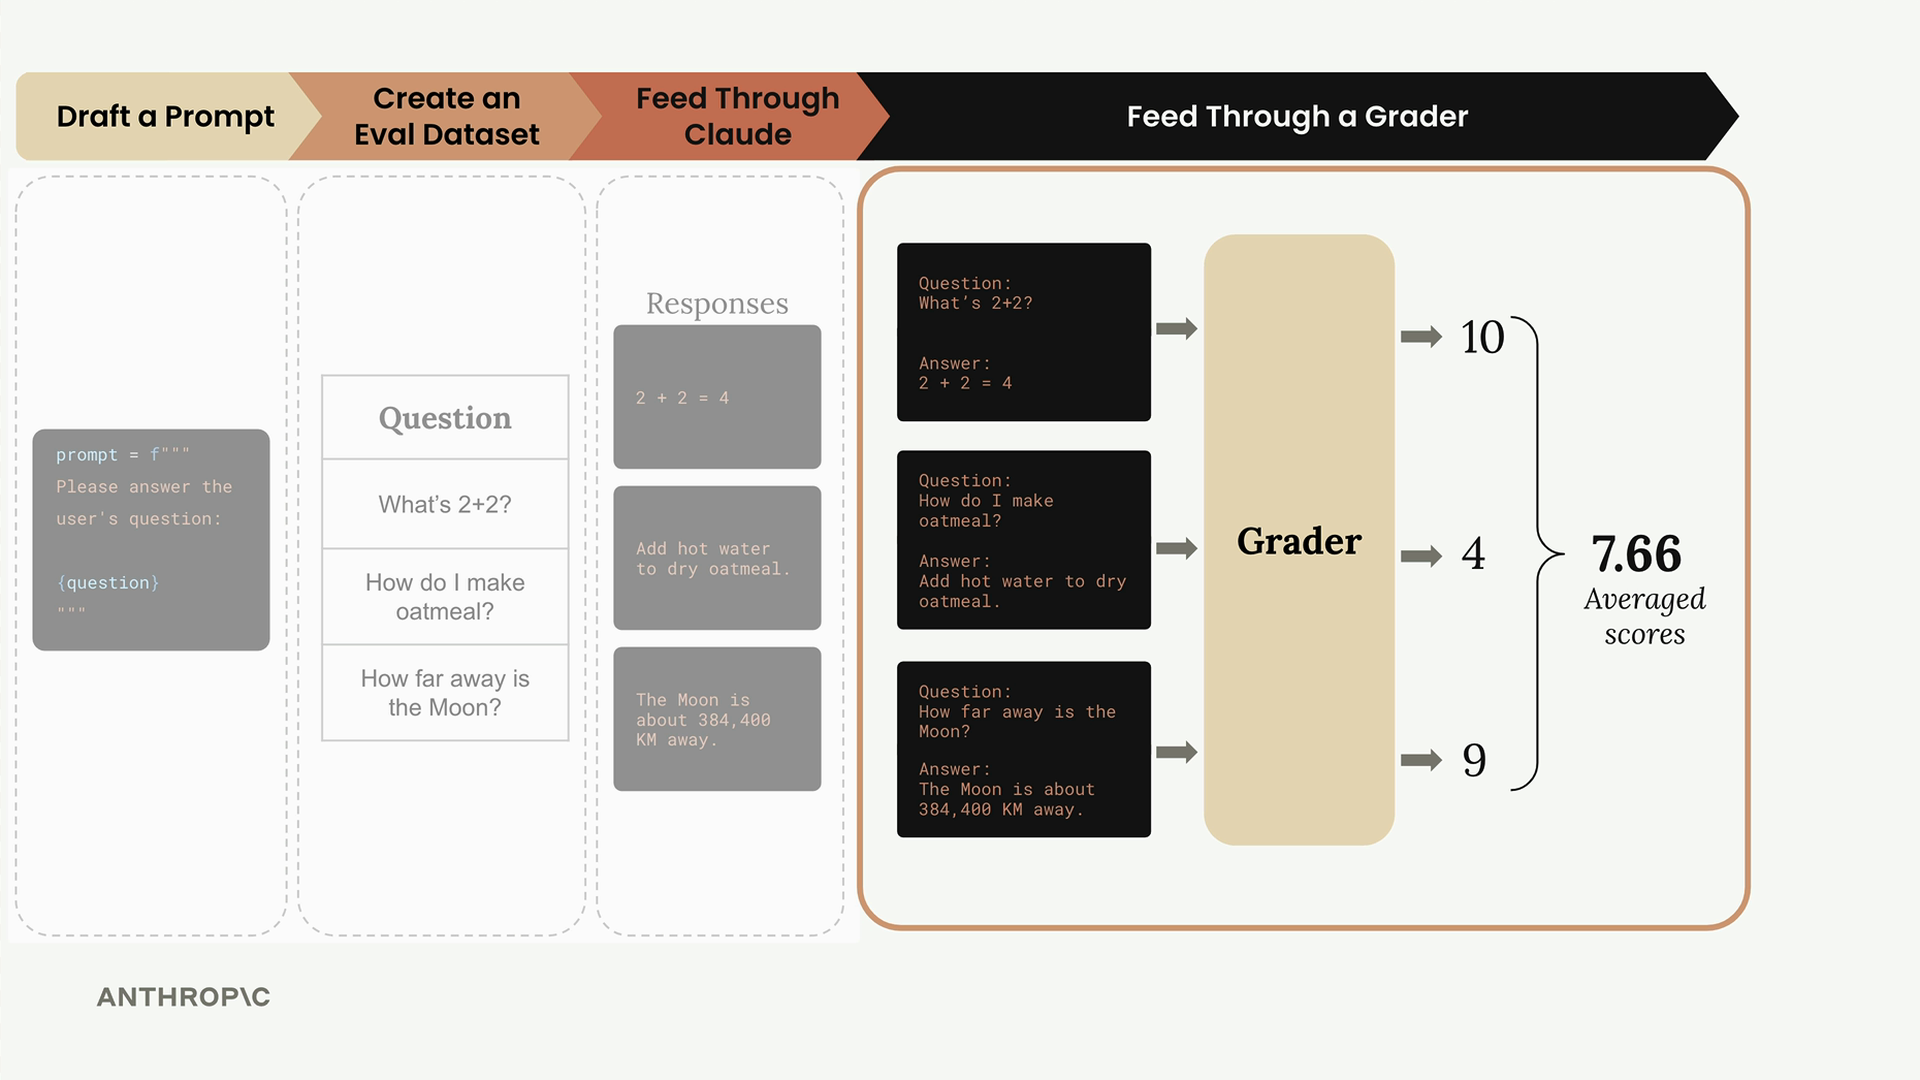
En nuestro ejemplo, las respuestas podrían puntuarse con 10, 4 y 9 respectivamente. Promedia estas puntuaciones para obtener una métrica de rendimiento general: 7.66.
Paso 5: Cambia el prompt y repite
Con tu puntuación base establecida, ahora puedes iterar sobre tu prompt. Intenta agregar instrucciones más específicas para guiar las respuestas de Claude:
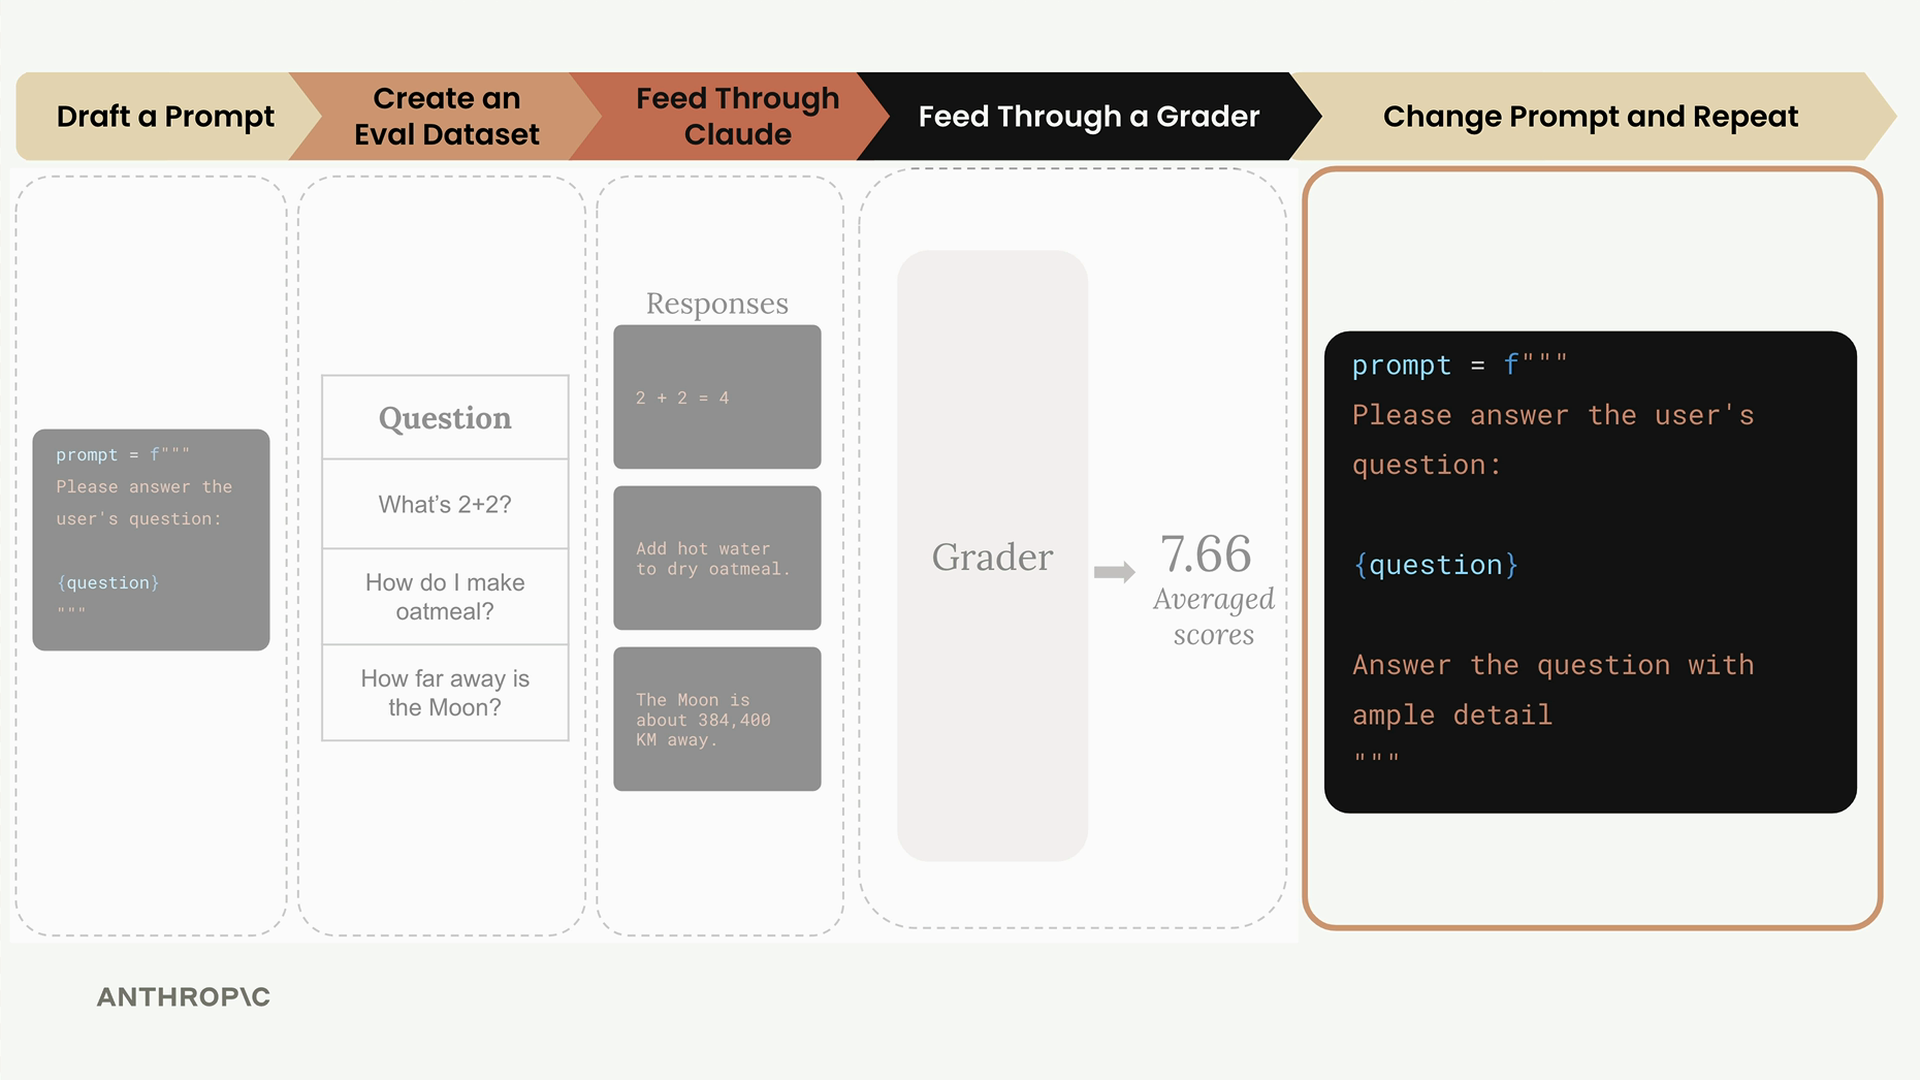
prompt = f"""
Please answer the user's question:

{question}

Answer the question with ample detail
"""
Ejecuta este prompt mejorado a través de todo el pipeline de evaluación nuevamente. Compara las puntuaciones para ver qué versión funciona mejor.
Puntuación e iteración de prompts
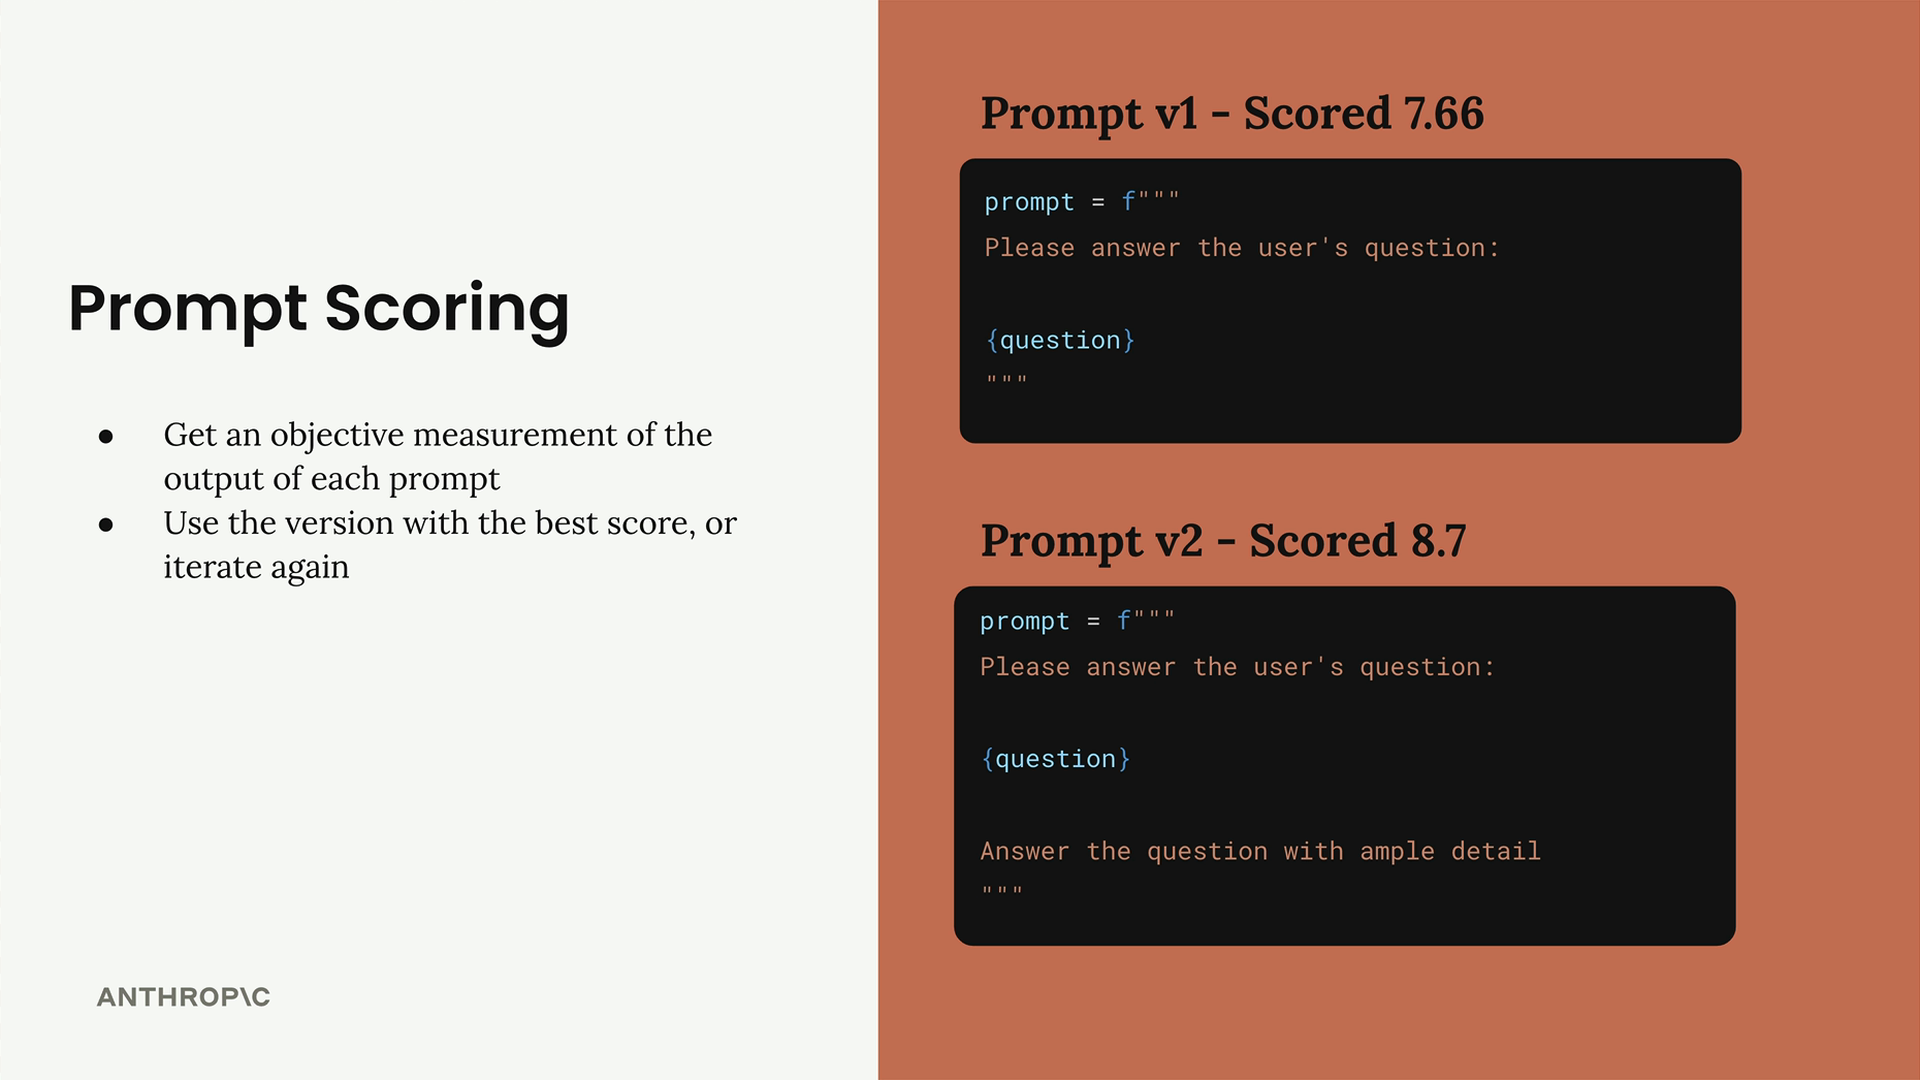
El poder de este flujo de trabajo radica en obtener mediciones objetivas para cada versión del prompt. Puedes comparar puntuaciones entre diferentes iteraciones y usar la versión con mejor rendimiento, o seguir iterando para encontrar enfoques aún mejores.
En nuestro ejemplo:
- El prompt v1 puntuó 7.66
- El prompt v2 puntuó 8.7
La puntuación más alta para v2 sugiere que agregar "Responde la pregunta con abundante detalle" mejoró el rendimiento del prompt en nuestros casos de prueba.
Este enfoque sistemático te da una forma objetiva de medir las mejoras del prompt en lugar de depender del juicio subjetivo. Puedes comenzar con una implementación simple e ir agregando criterios de evaluación más sofisticados a medida que crezcan tus necesidades.