Crear un flujo de trabajo personalizado de evaluación de prompts comienza con establecer un objetivo claro y generar datos de prueba. En este caso, estamos construyendo un prompt que ayuda a los usuarios a escribir código específico de AWS, ya sean funciones de Python, configuraciones JSON o expresiones regulares, sin explicaciones ni formato adicional.
Estableciendo el objetivo
El prompt debería tomar la descripción de una tarea del usuario y devolver uno de tres tipos de salida:
- Código Python
- Configuración JSON
- Expresiones regulares
El requisito clave es que las respuestas contengan únicamente el código solicitado, sin encabezados, pies de página ni explicaciones.
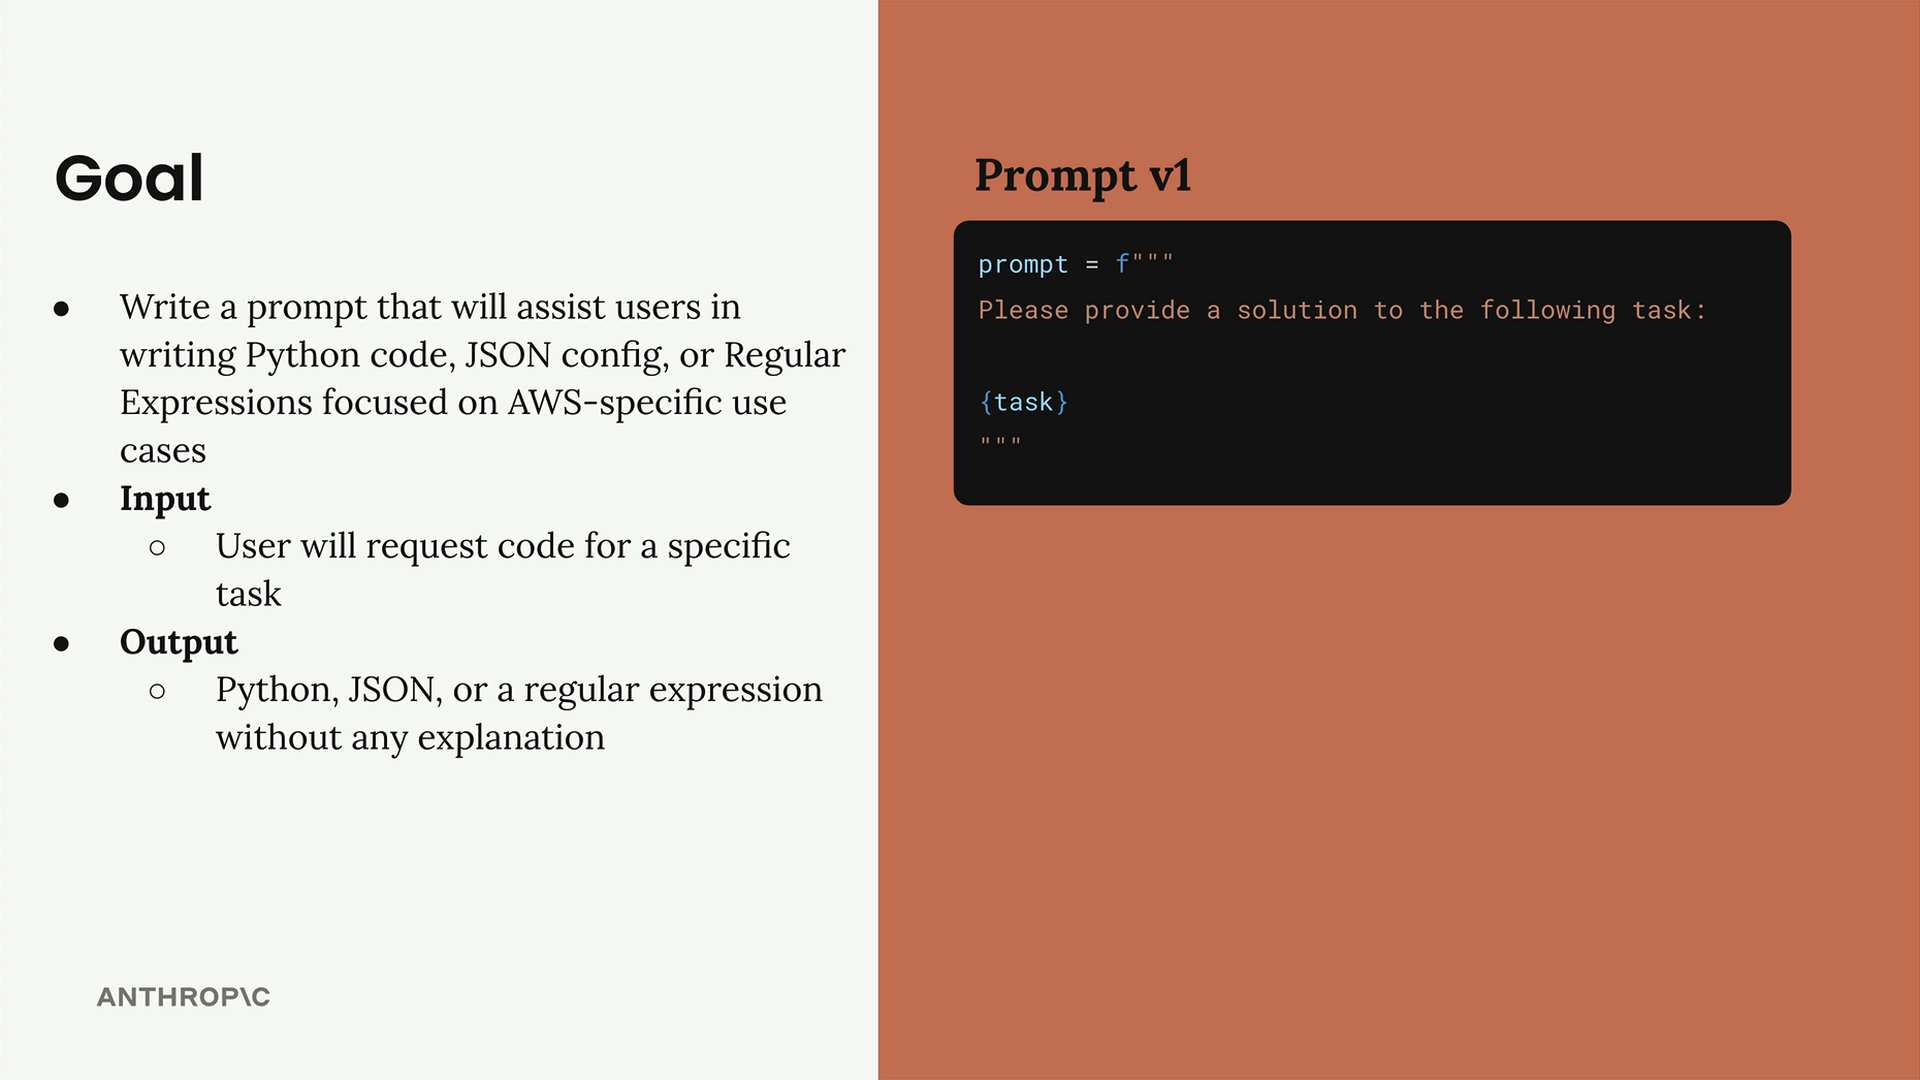
Comenzar con una primera versión sencilla hace que las cosas sean manejables. La plantilla inicial del prompt es directa: "Please provide a solution to the following task: {task}"
Creando conjuntos de datos de evaluación
Un conjunto de datos de evaluación contiene ejemplos de entrada que alimentarás a tu prompt. Cada caso de prueba se combina con tu prompt y se envía a Claude, lo que te permite ver qué tan bien se desempeña el prompt en diferentes escenarios.
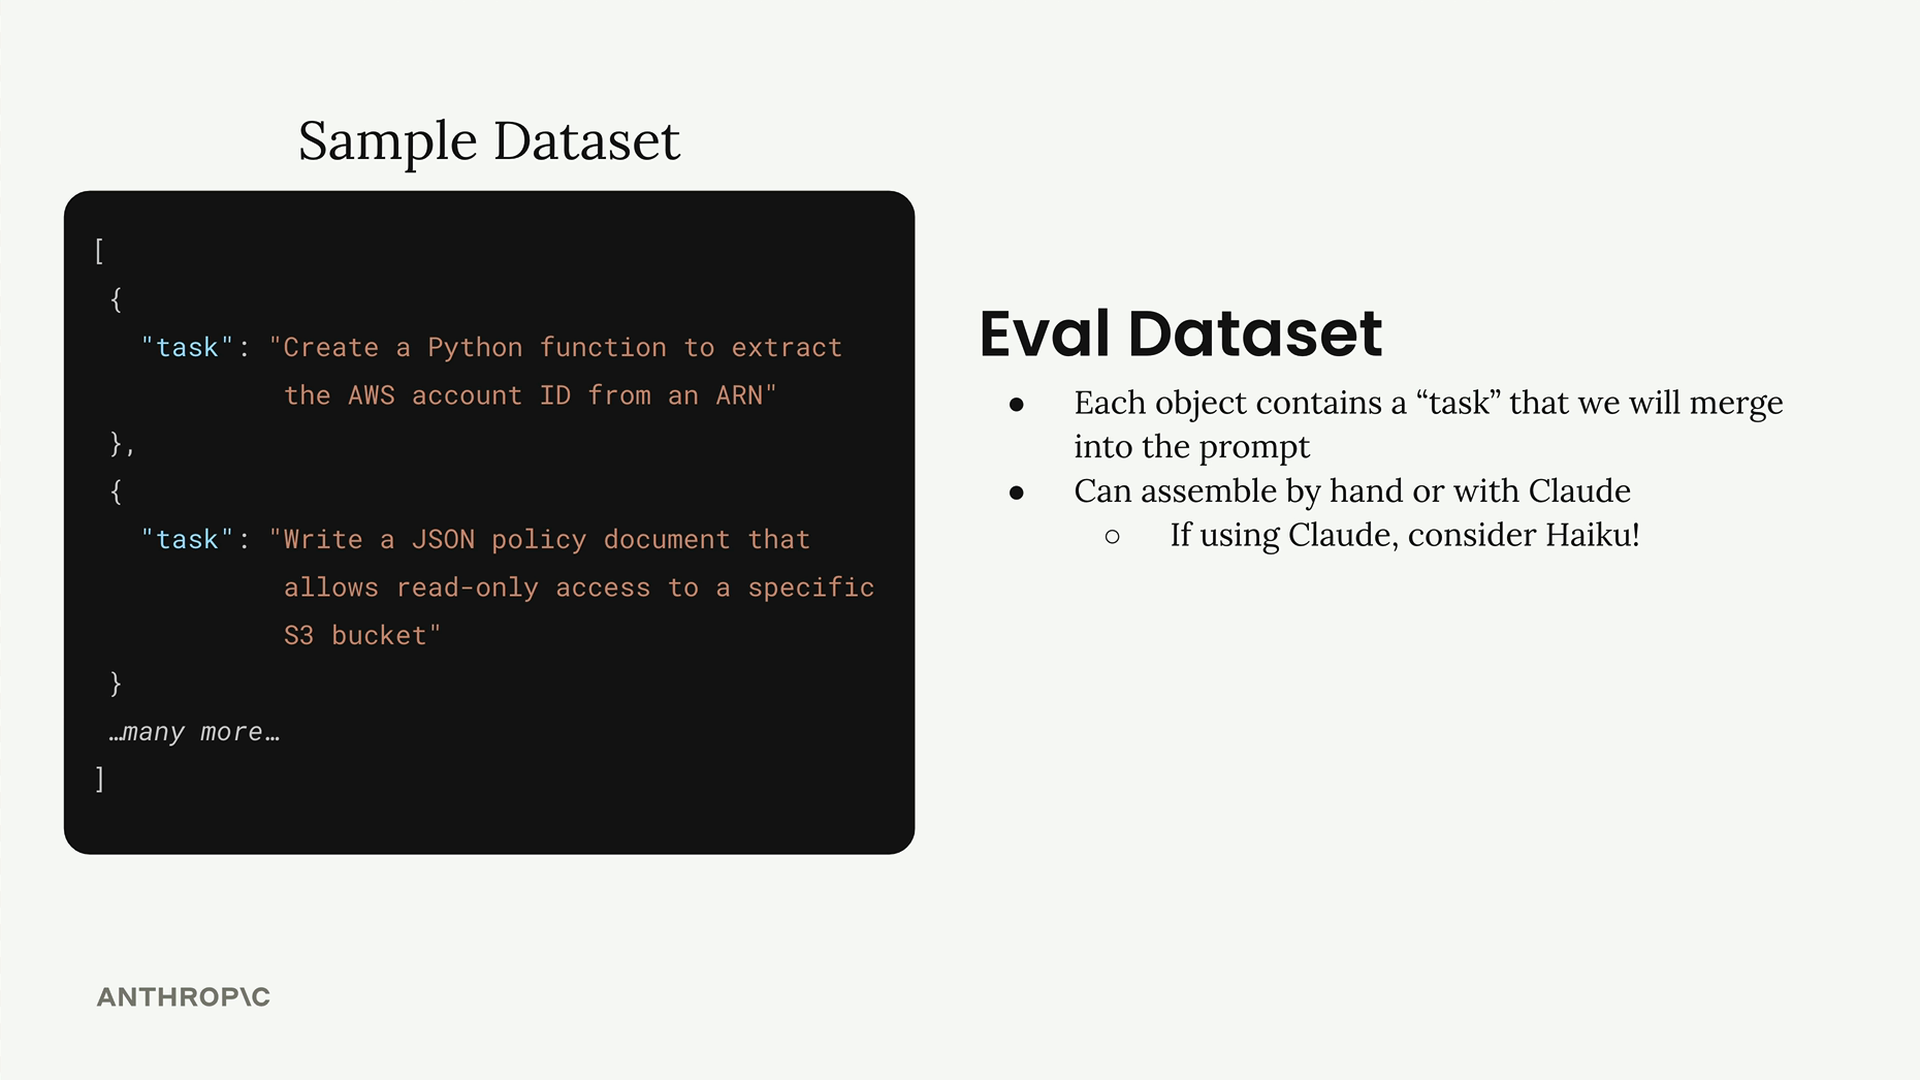
Puedes crear conjuntos de datos de dos maneras:
- Escribir casos de prueba manualmente a mano
- Generarlos automáticamente usando Claude
Para la generación automática, usar un modelo más rápido como Haiku tiene sentido, ya que estás generando múltiples casos de prueba.
Generando datos de prueba con código
La función de generación de conjuntos de datos usa Claude para crear escenarios de prueba realistas. Aquí está la estructura básica:
def generate_dataset():
    prompt = """
    Generate 3 AWS-related tasks that require Python, JSON, or Regex solutions.

    Focus on tasks that can be solved by writing a single Python function,
    a single JSON object, or tasks that do not require writing much code.

    Example output:
    [
        {
            "task": "Description of task"
        },
        ...additional
    ]

    Please generate 3 objects.
    """

    messages = []
    add_user_message(messages, prompt)
    add_assistant_message(messages, "```json")
    text = chat(messages, stop_sequences=["```"])
    return json.loads(text)
Este enfoque usa la técnica de mensaje del asistente prellenado con secuencias de parada para extraer respuestas JSON limpias. El mensaje del asistente comienza con ```json y se detiene en el cierre ```, asegurando que obtengas datos correctamente formateados.
Guardando tu conjunto de datos
Una vez generado, guarda el conjunto de datos para evitar regenerarlo constantemente:
dataset = generate_dataset()
with open("dataset.json", "w") as f:
    json.dump(dataset, f, indent=2)
El conjunto de datos generado crea tareas realistas de AWS, como extraer IDs de cuenta a partir de ARNs, escribir esquemas JSON para configuraciones de EC2 y crear patrones de expresiones regulares para nombres de buckets de S3. Aunque tres casos de prueba funcionan para el desarrollo inicial, la evaluación en producción necesitaría significativamente más ejemplos con mayor variedad.
Esta base te da un proceso repetible para crear conjuntos de datos de evaluación que se ajusten a tu caso de uso específico, preparando el terreno para los siguientes pasos de ejecutar evaluaciones y medir el rendimiento del prompt.