Cuando tienes tanto la búsqueda semántica (embeddings vectoriales) como la búsqueda léxica (BM25) funcionando de forma independiente, el siguiente paso es combinarlas en un pipeline de búsqueda unificado. Este enfoque híbrido aprovecha las fortalezas de ambos métodos para ofrecer resultados más precisos.
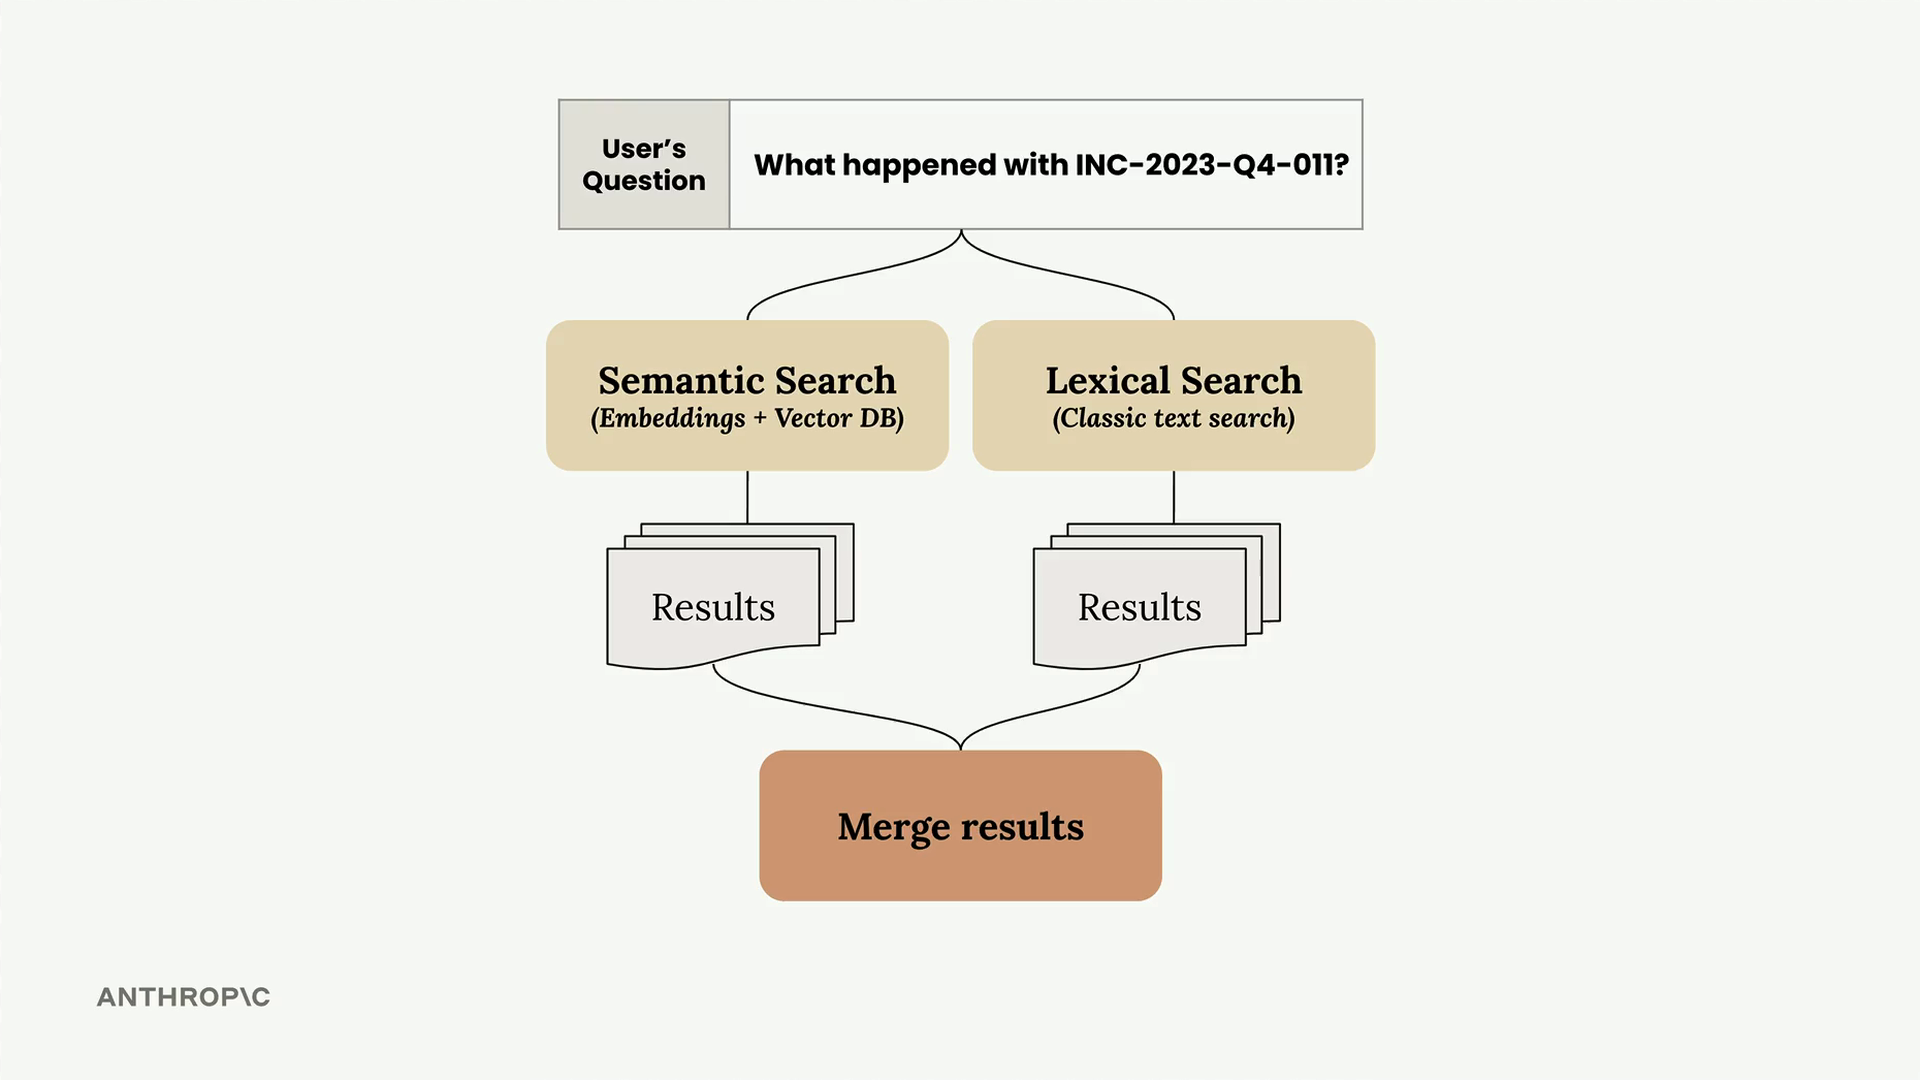
Construyendo una interfaz unificada
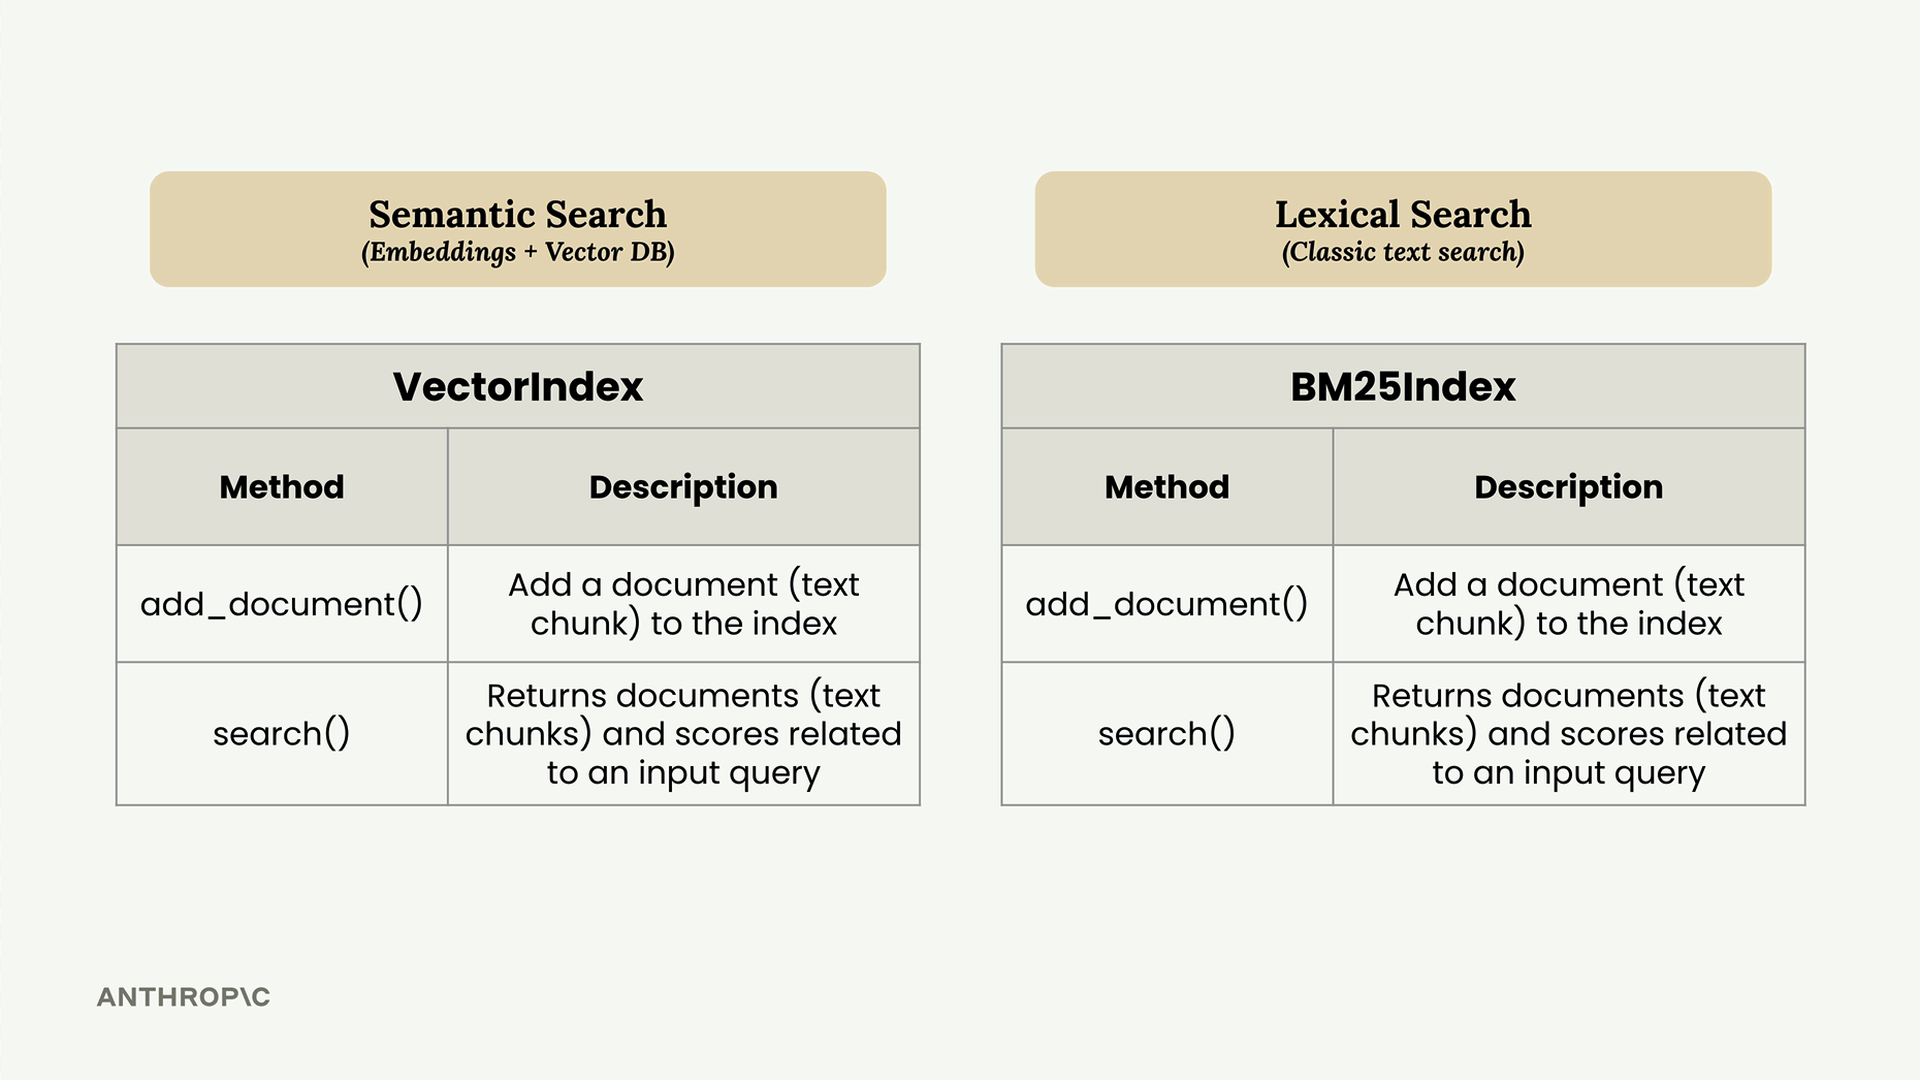
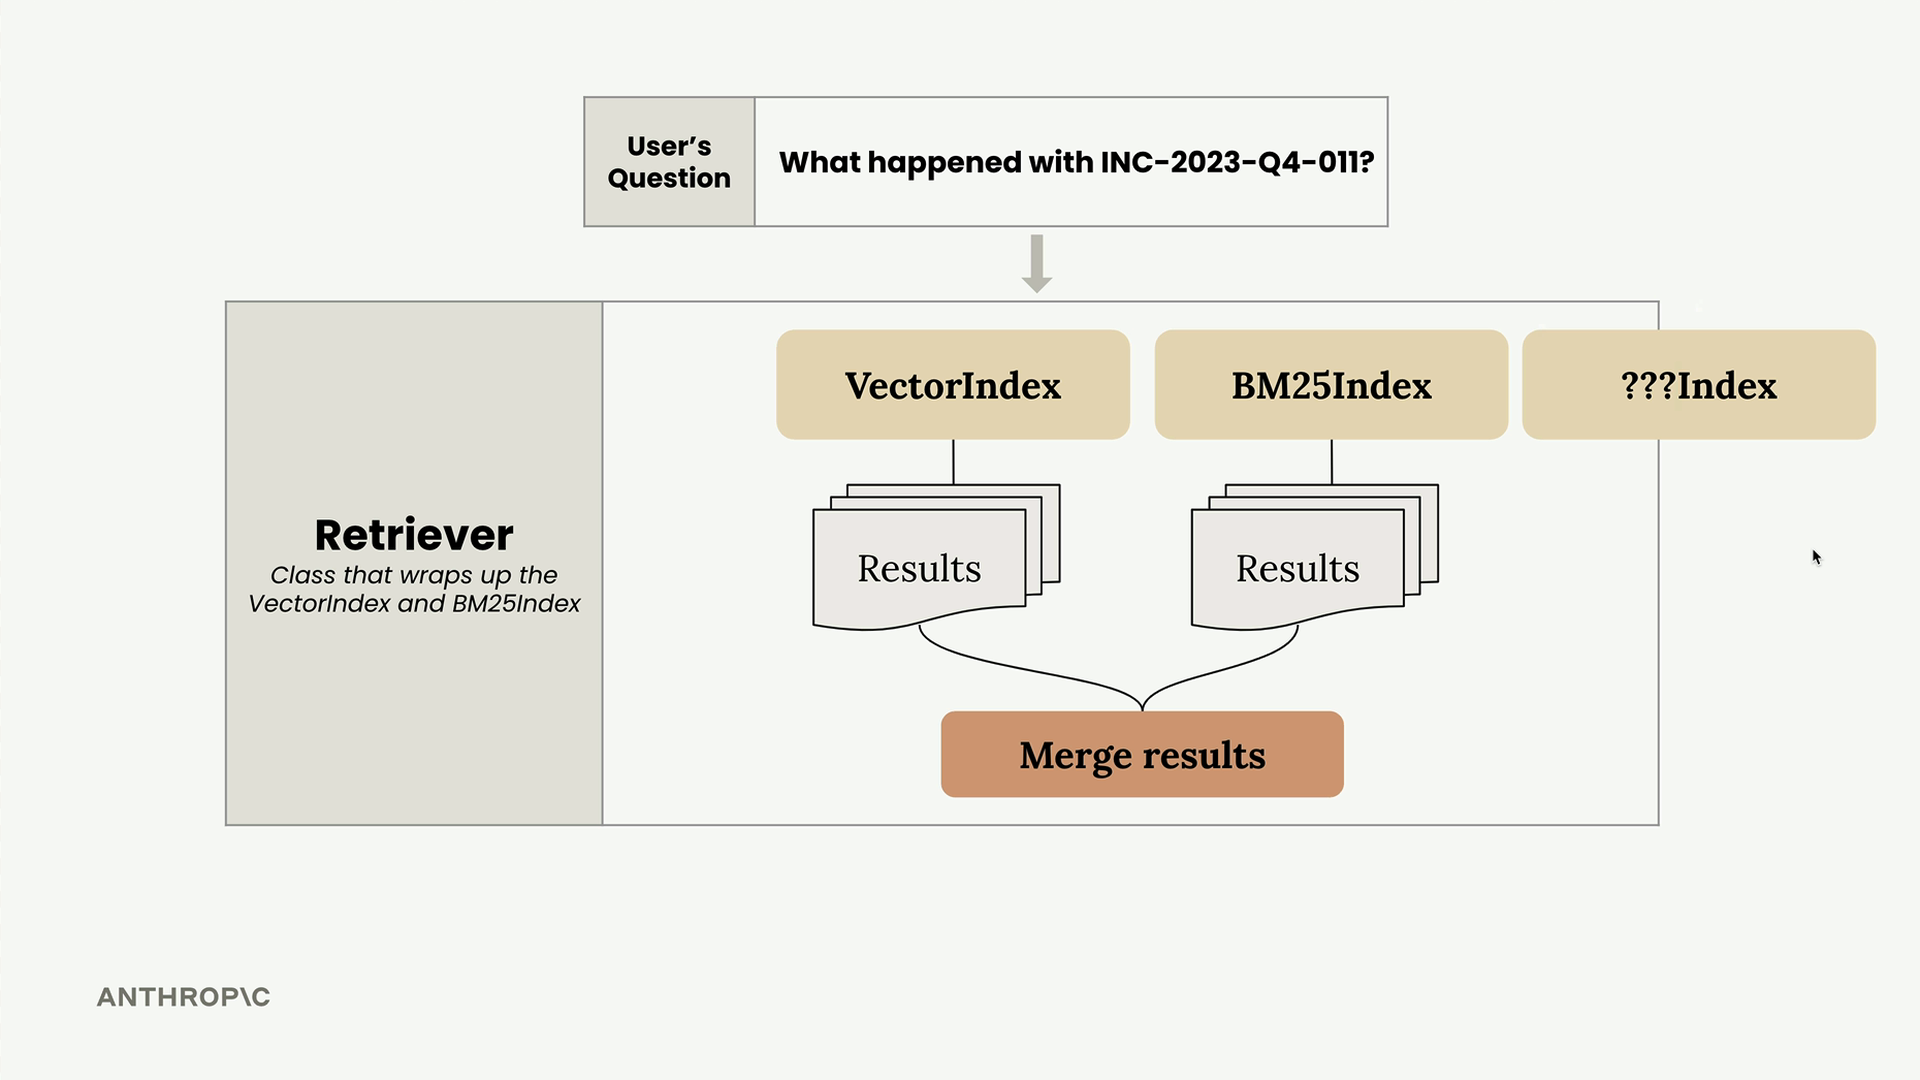
Ambas implementaciones de búsqueda comparten APIs casi idénticas: ambas tienen métodos add_document() y search(). Esta consistencia hace que sea sencillo envolverlas en una única clase Retriever que coordina entre ambos enfoques.
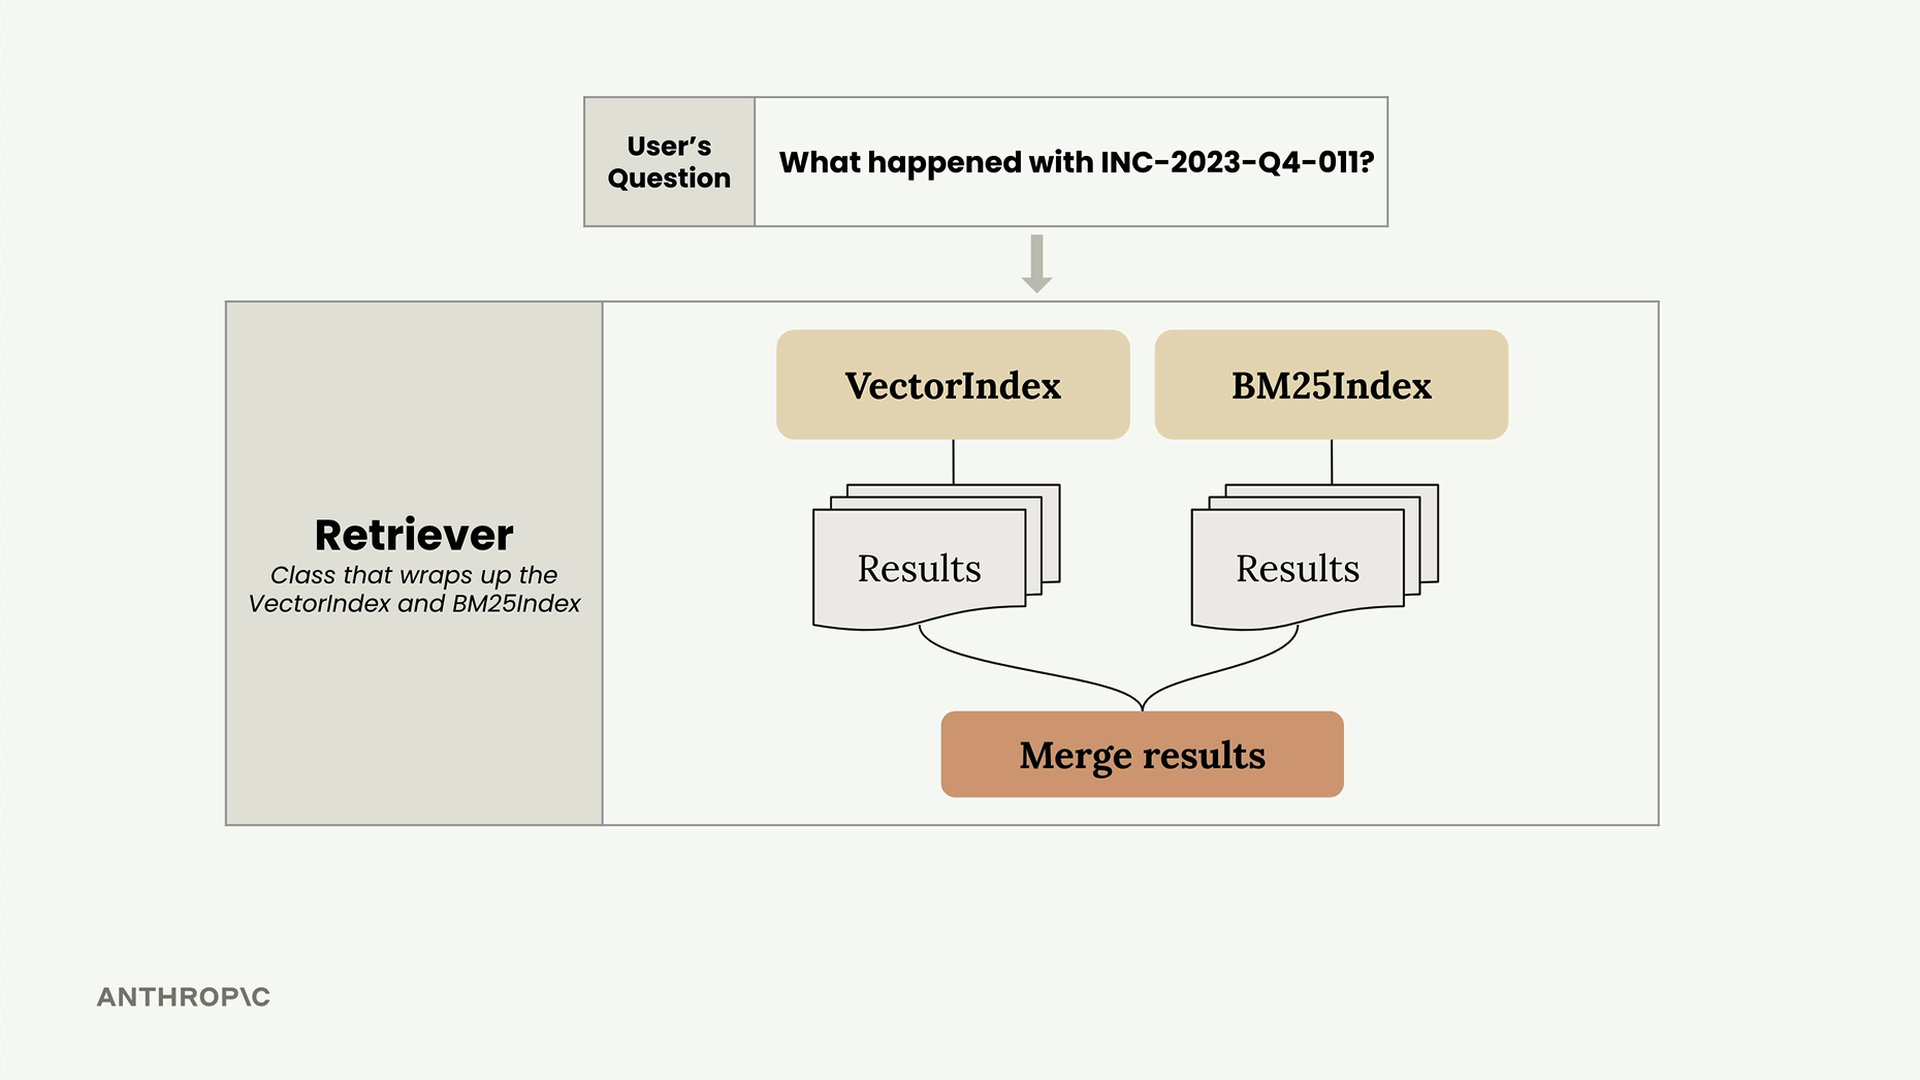
El Retriever actúa como un coordinador que:
- Recibe la pregunta de un usuario
- La reenvía tanto al VectorIndex como al BM25Index
- Recopila resultados de ambos sistemas
- Combina los resultados usando un algoritmo de clasificación
Reciprocal Rank Fusion
El desafío radica en combinar resultados de diferentes métodos de búsqueda. Cada sistema devuelve resultados con mecanismos de puntuación distintos, por lo que no puedes simplemente combinar las puntuaciones directamente. En su lugar, usamos una técnica llamada Reciprocal Rank Fusion (RRF).
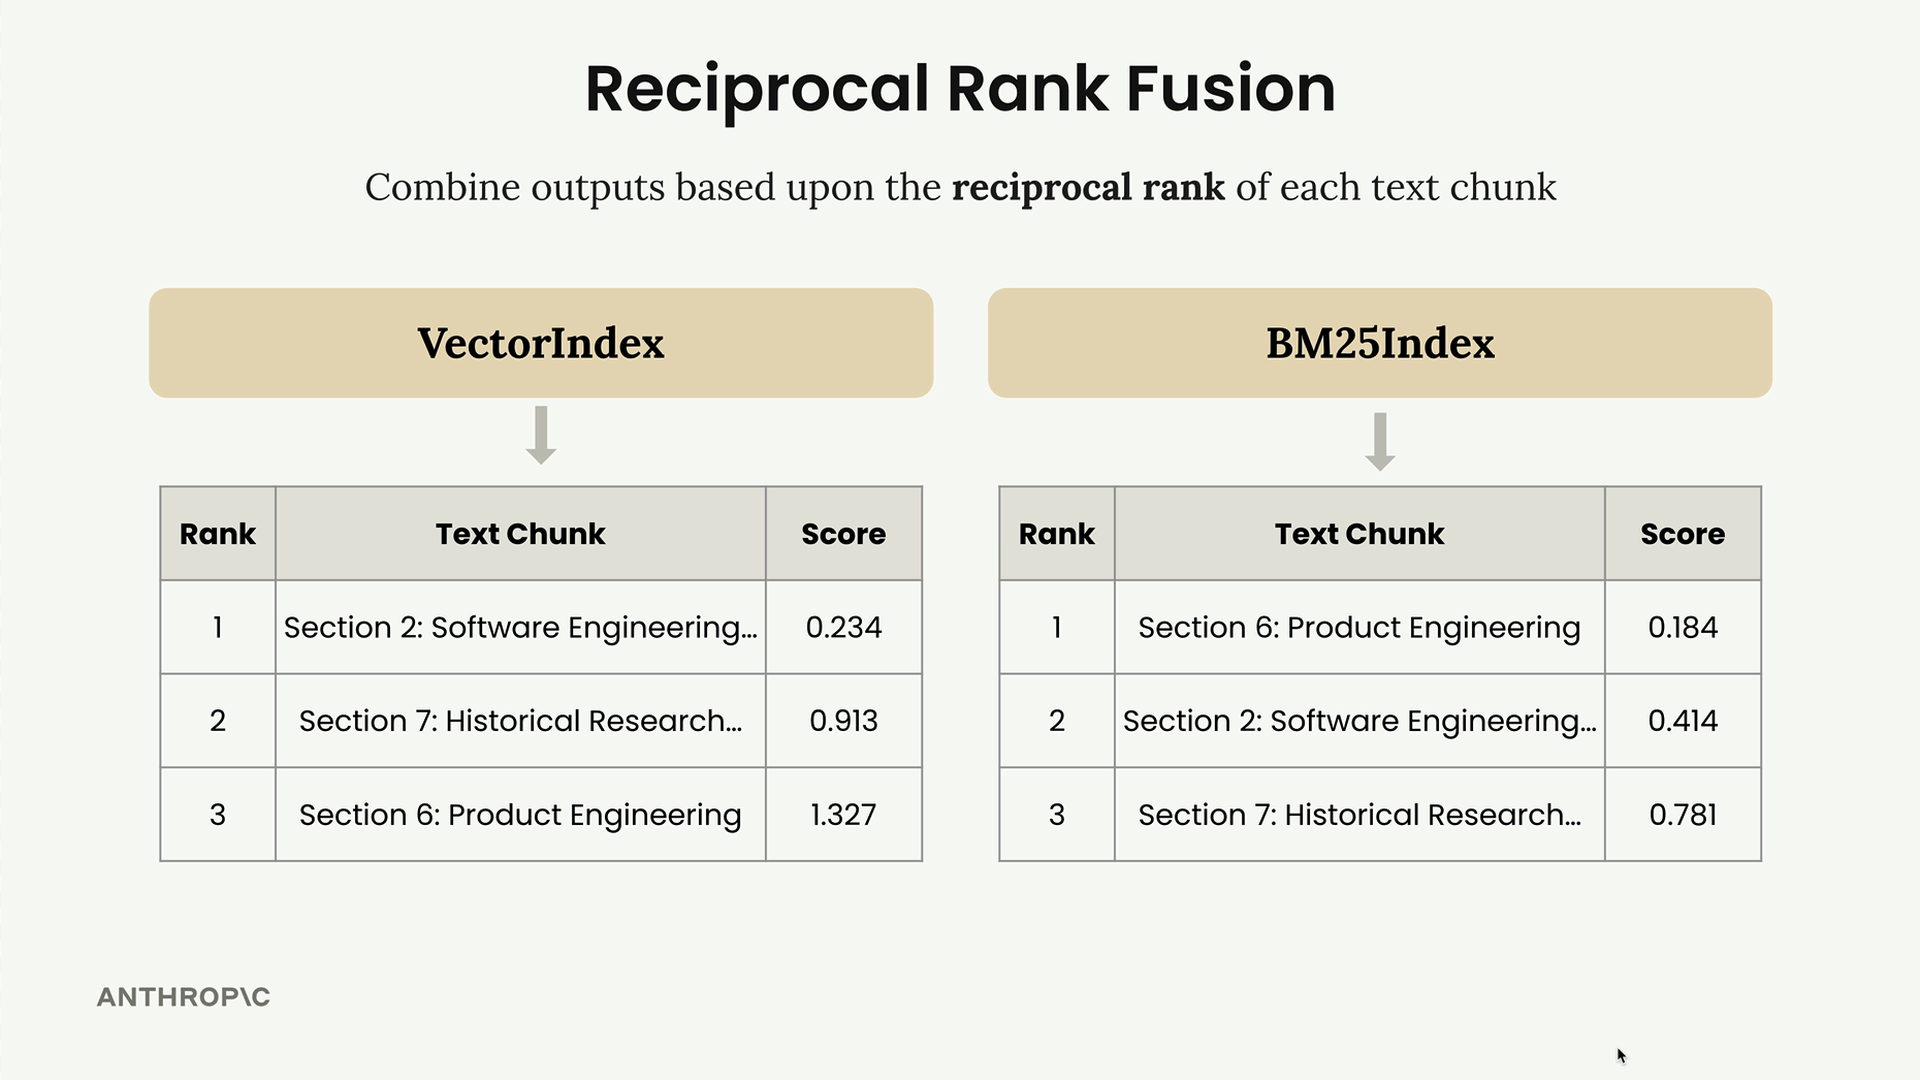
Así es como funciona RRF con un ejemplo práctico. Supongamos que tu VectorIndex devuelve los resultados clasificados como: Sección 2, Sección 7, Sección 6. Mientras tanto, tu BM25Index devuelve: Sección 6, Sección 2, Sección 7.
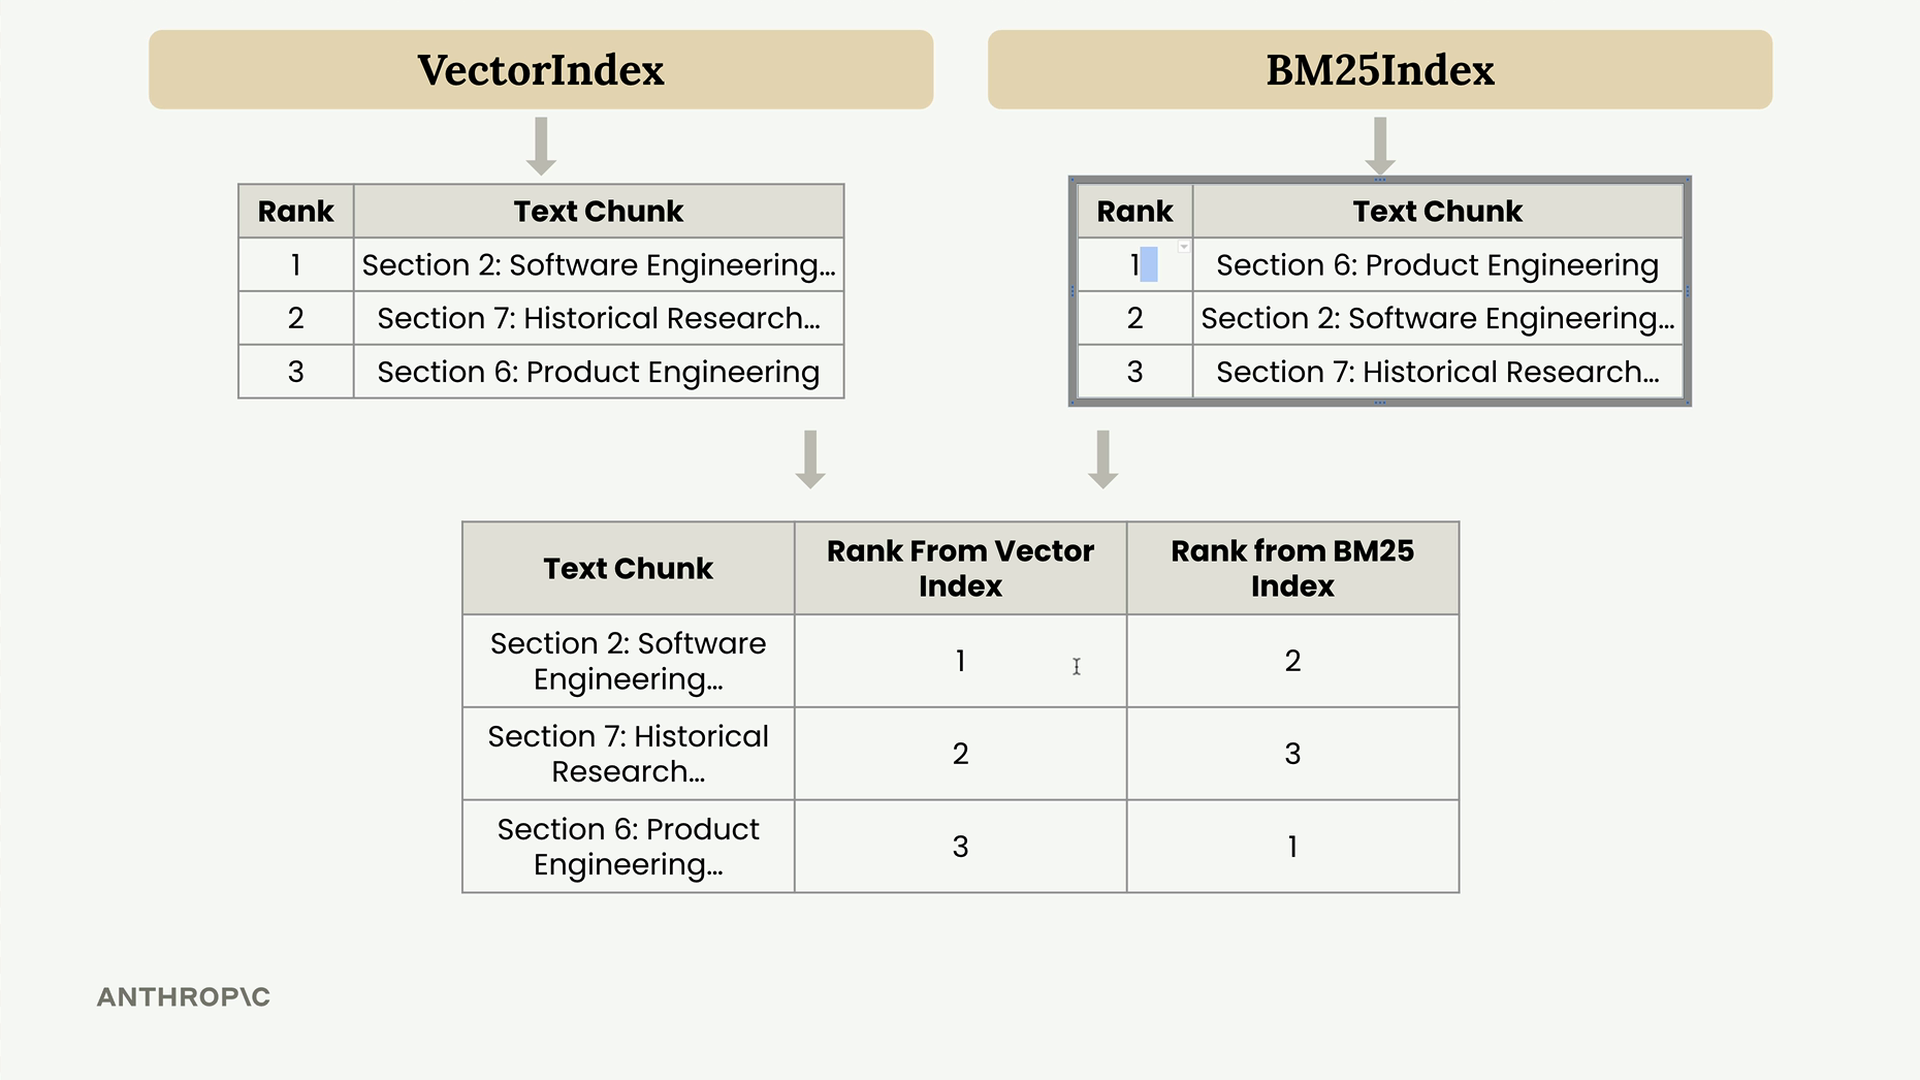
Para combinar estos resultados, creas una tabla combinada que muestra el rango de cada fragmento de texto en ambos sistemas:
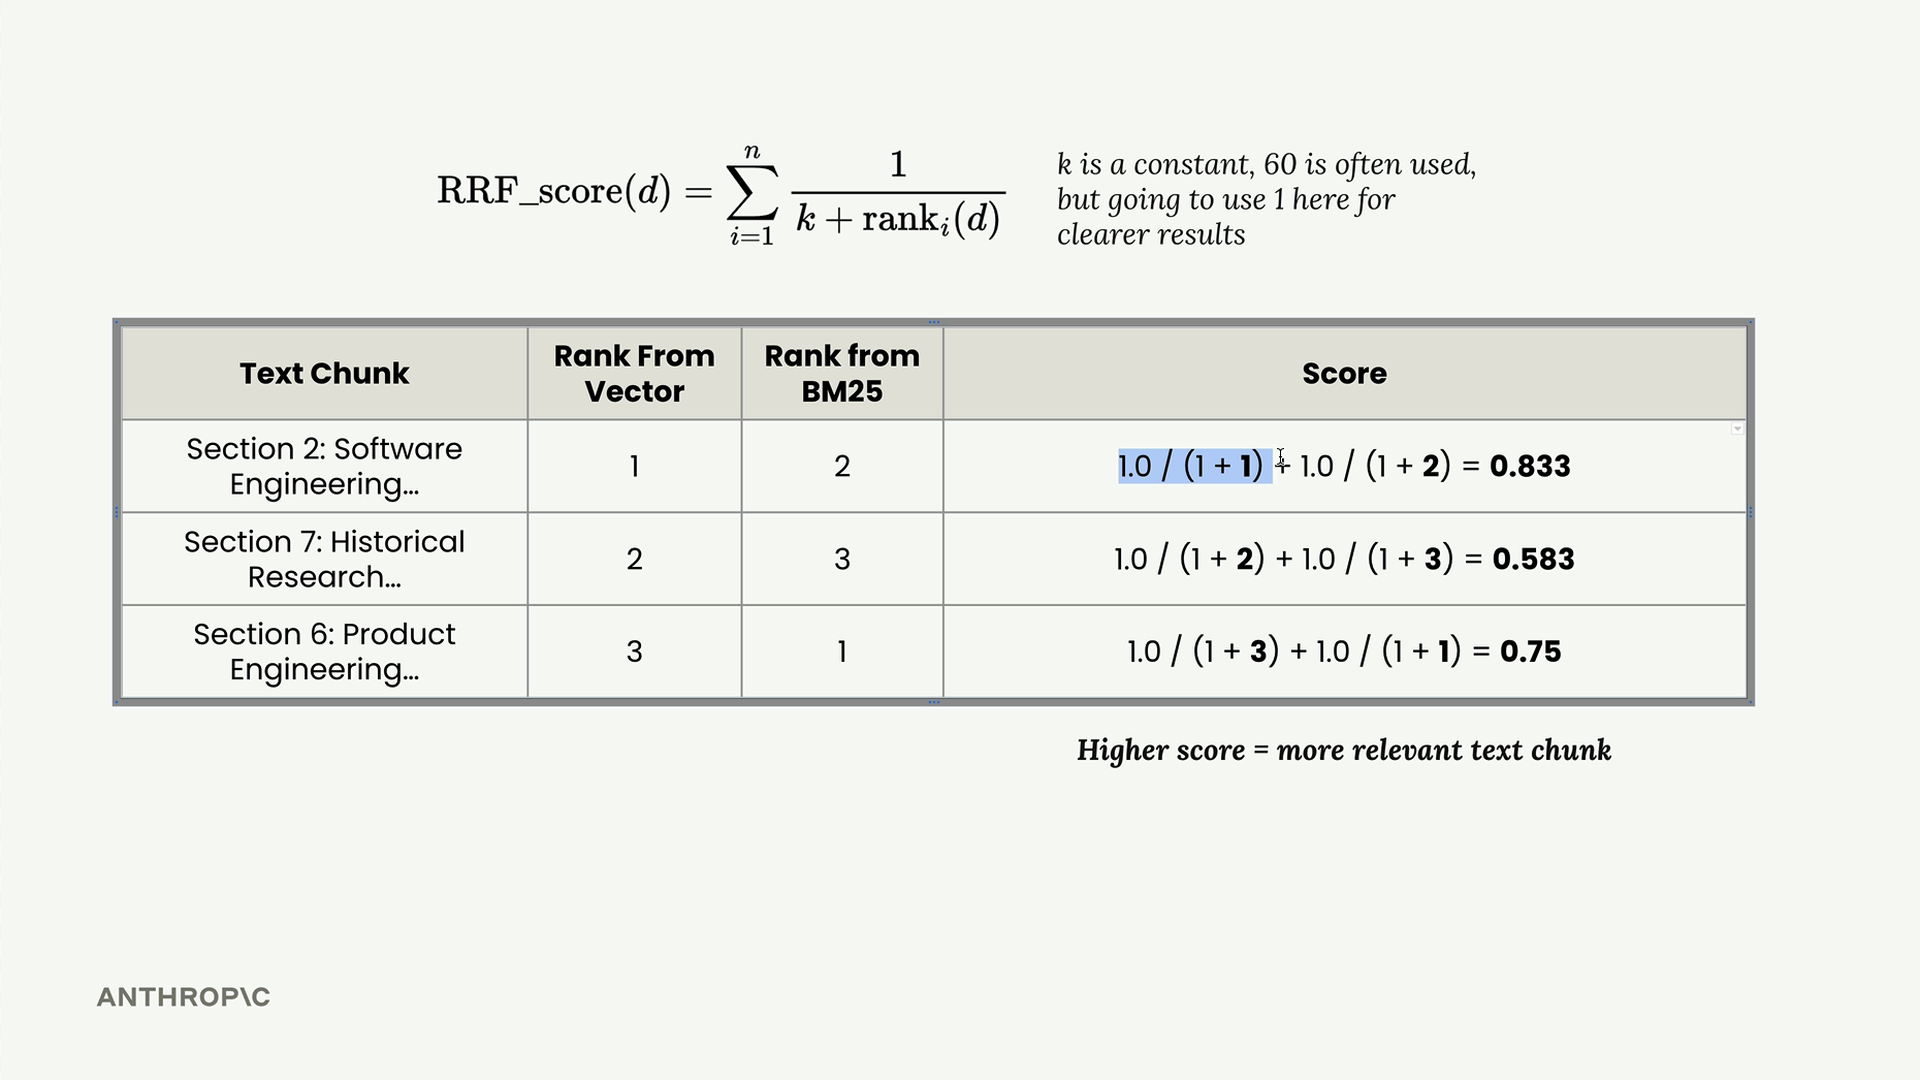
La fórmula RRF calcula una puntuación para cada documento:
RRF_score(d) = Σ(1 / (k + rank_i(d)))Donde k es una constante (normalmente 60, aunque 1 funciona bien para resultados más claros) y rank_i(d) es el rango del documento d en el i-ésimo sistema de clasificación.
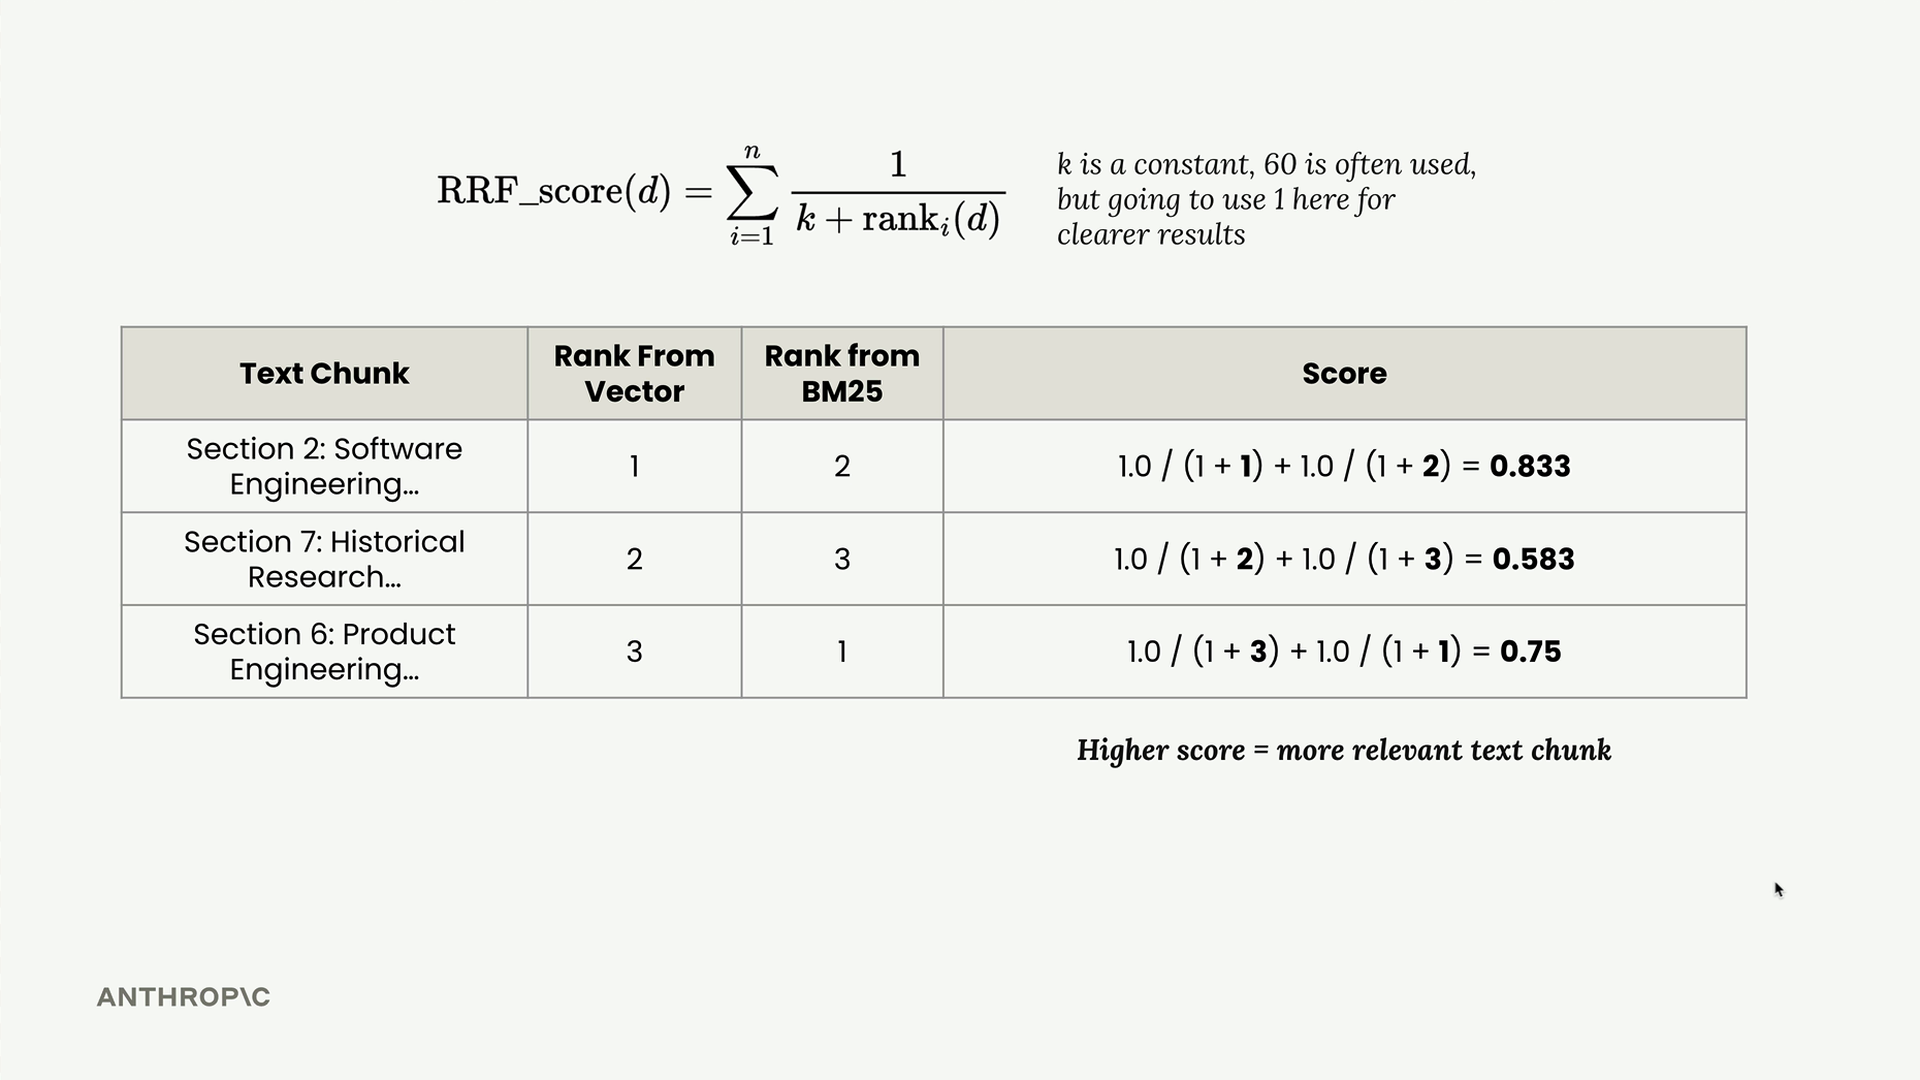
Para cada fragmento de texto, calculas:
- Sección 2: 1.0/(1+1) + 1.0/(1+2) = 0.833
- Sección 7: 1.0/(1+2) + 1.0/(1+3) = 0.583
- Sección 6: 1.0/(1+3) + 1.0/(1+1) = 0.75
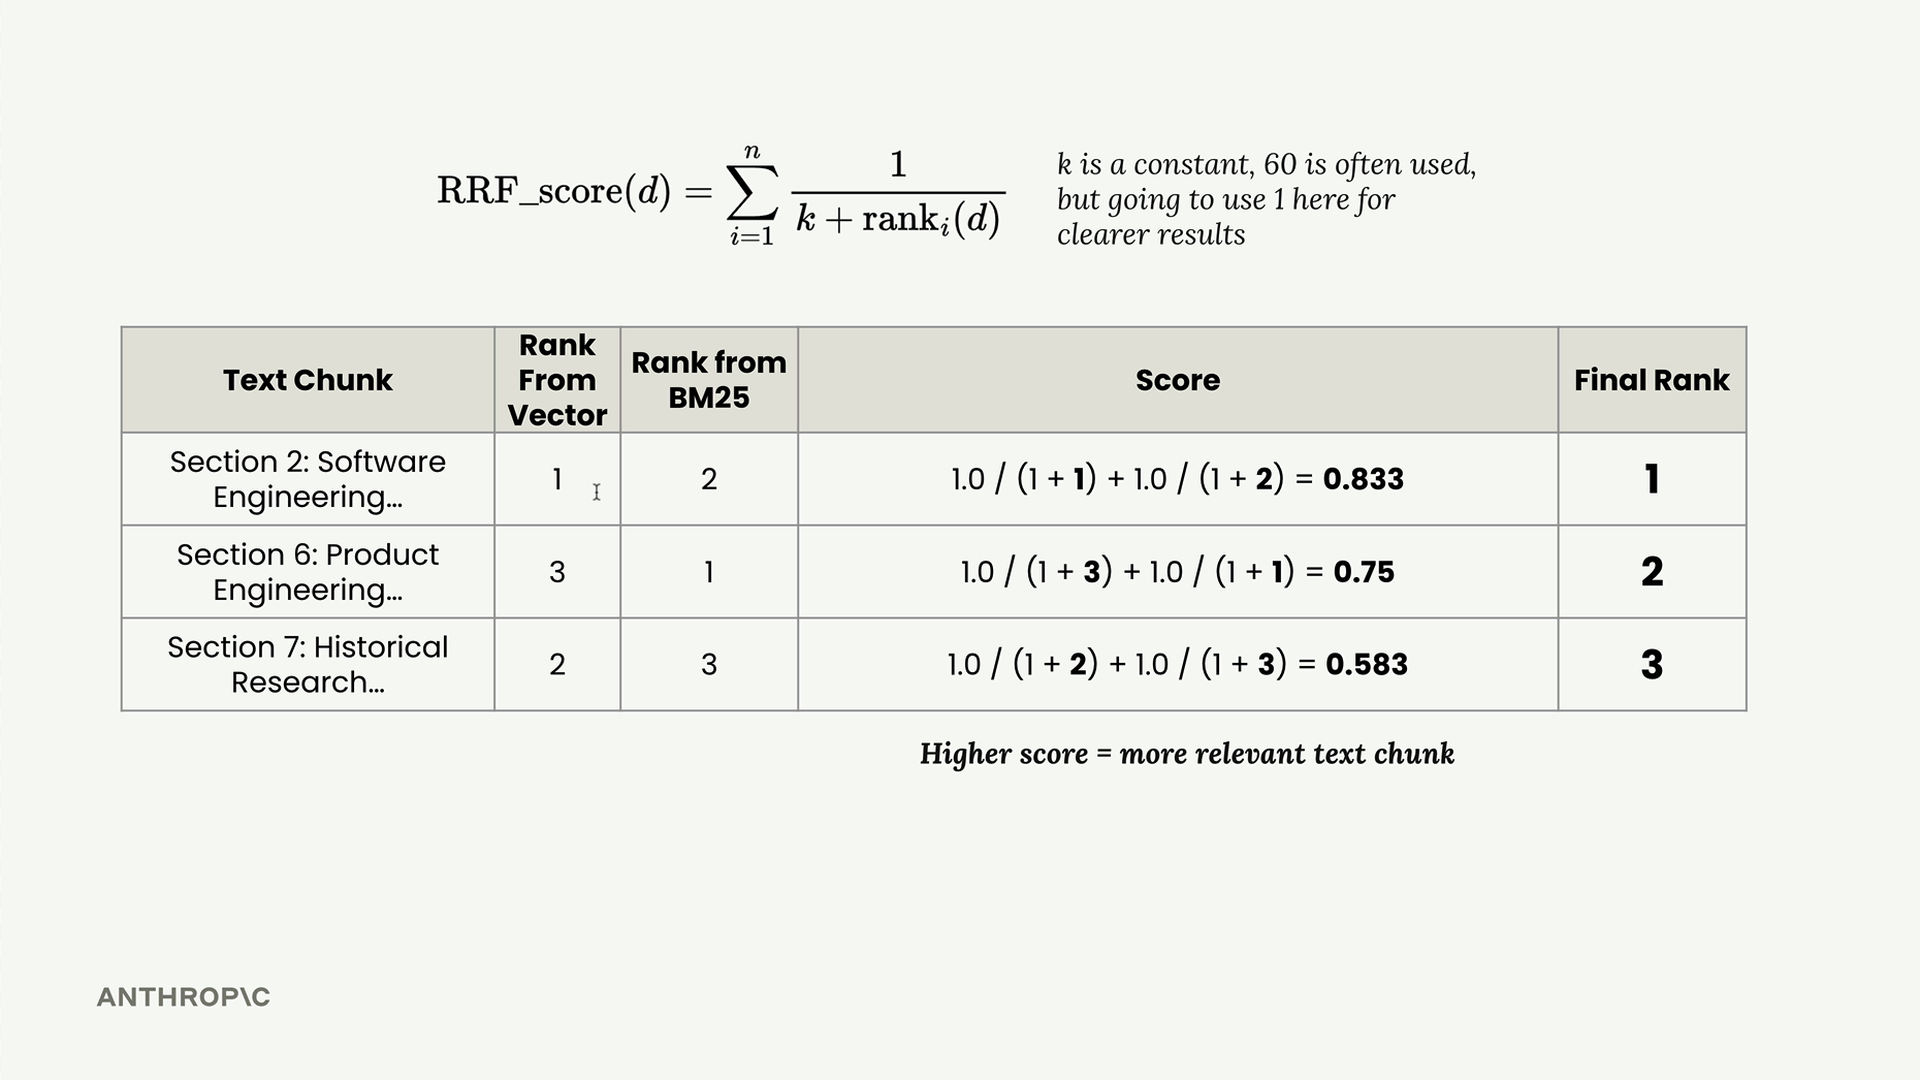
Después de ordenar por puntuación, la clasificación final se convierte en: Sección 2 (primera), Sección 6 (segunda), Sección 7 (tercera).
Implementación
La implementación de la clase Retriever es sencilla:
class Retriever:
    def __init__(self, *indexes):
        self._indexes = list(indexes)

    def add_document(self, document):
        for index in self._indexes:
            index.add_document(document)

    def search(self, query_text, k=1, k_rrf=60):
        # Obtiene resultados de todos los índices
        all_results = []
        for idx, results in enumerate(all_results):
            for rank, (doc, _) in enumerate(results):
                # Rastrea los rangos de documentos entre sistemas
                # Aplica la fórmula RRF
                # Devuelve los resultados combinados y ordenados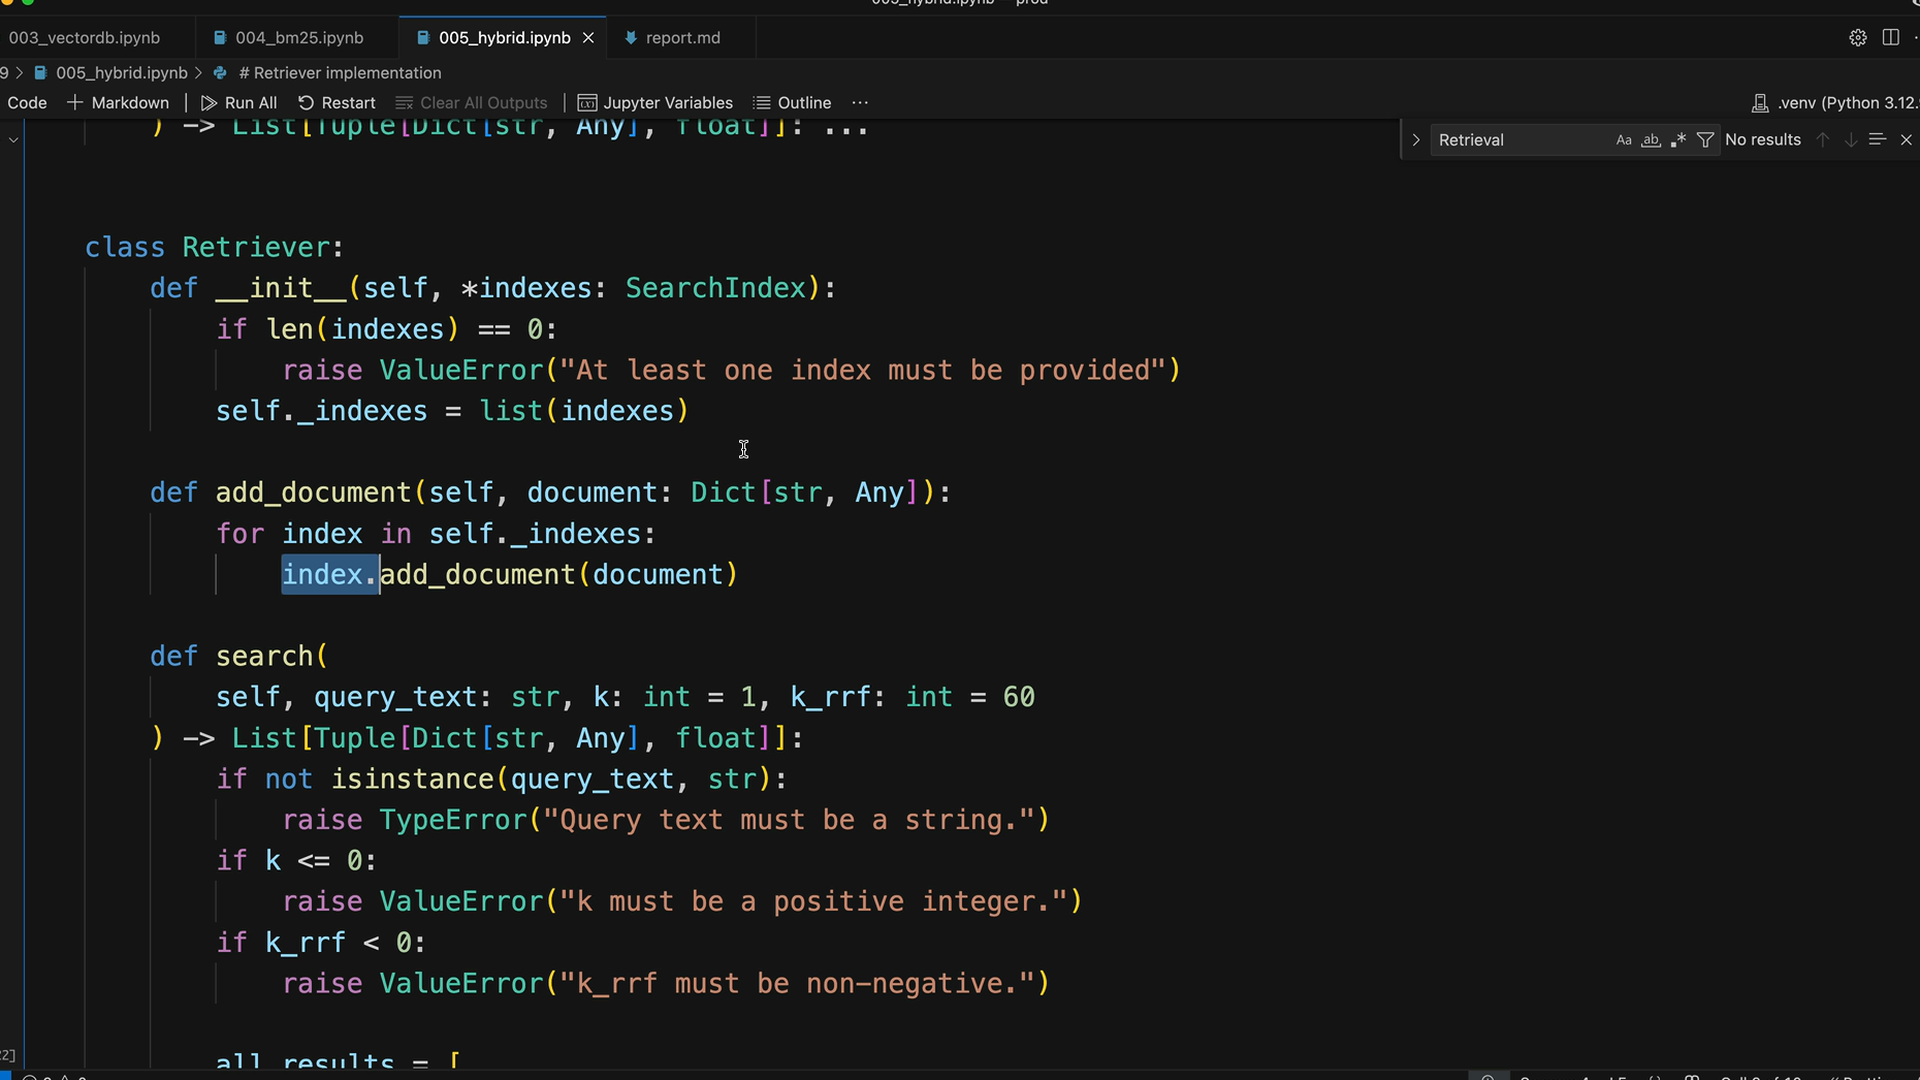
La idea clave es que el algoritmo RRF crea una clasificación unificada al considerar qué tan bien se desempeña cada documento en todos los sistemas de búsqueda, en lugar de depender de un único método de puntuación.
Probando el enfoque híbrido
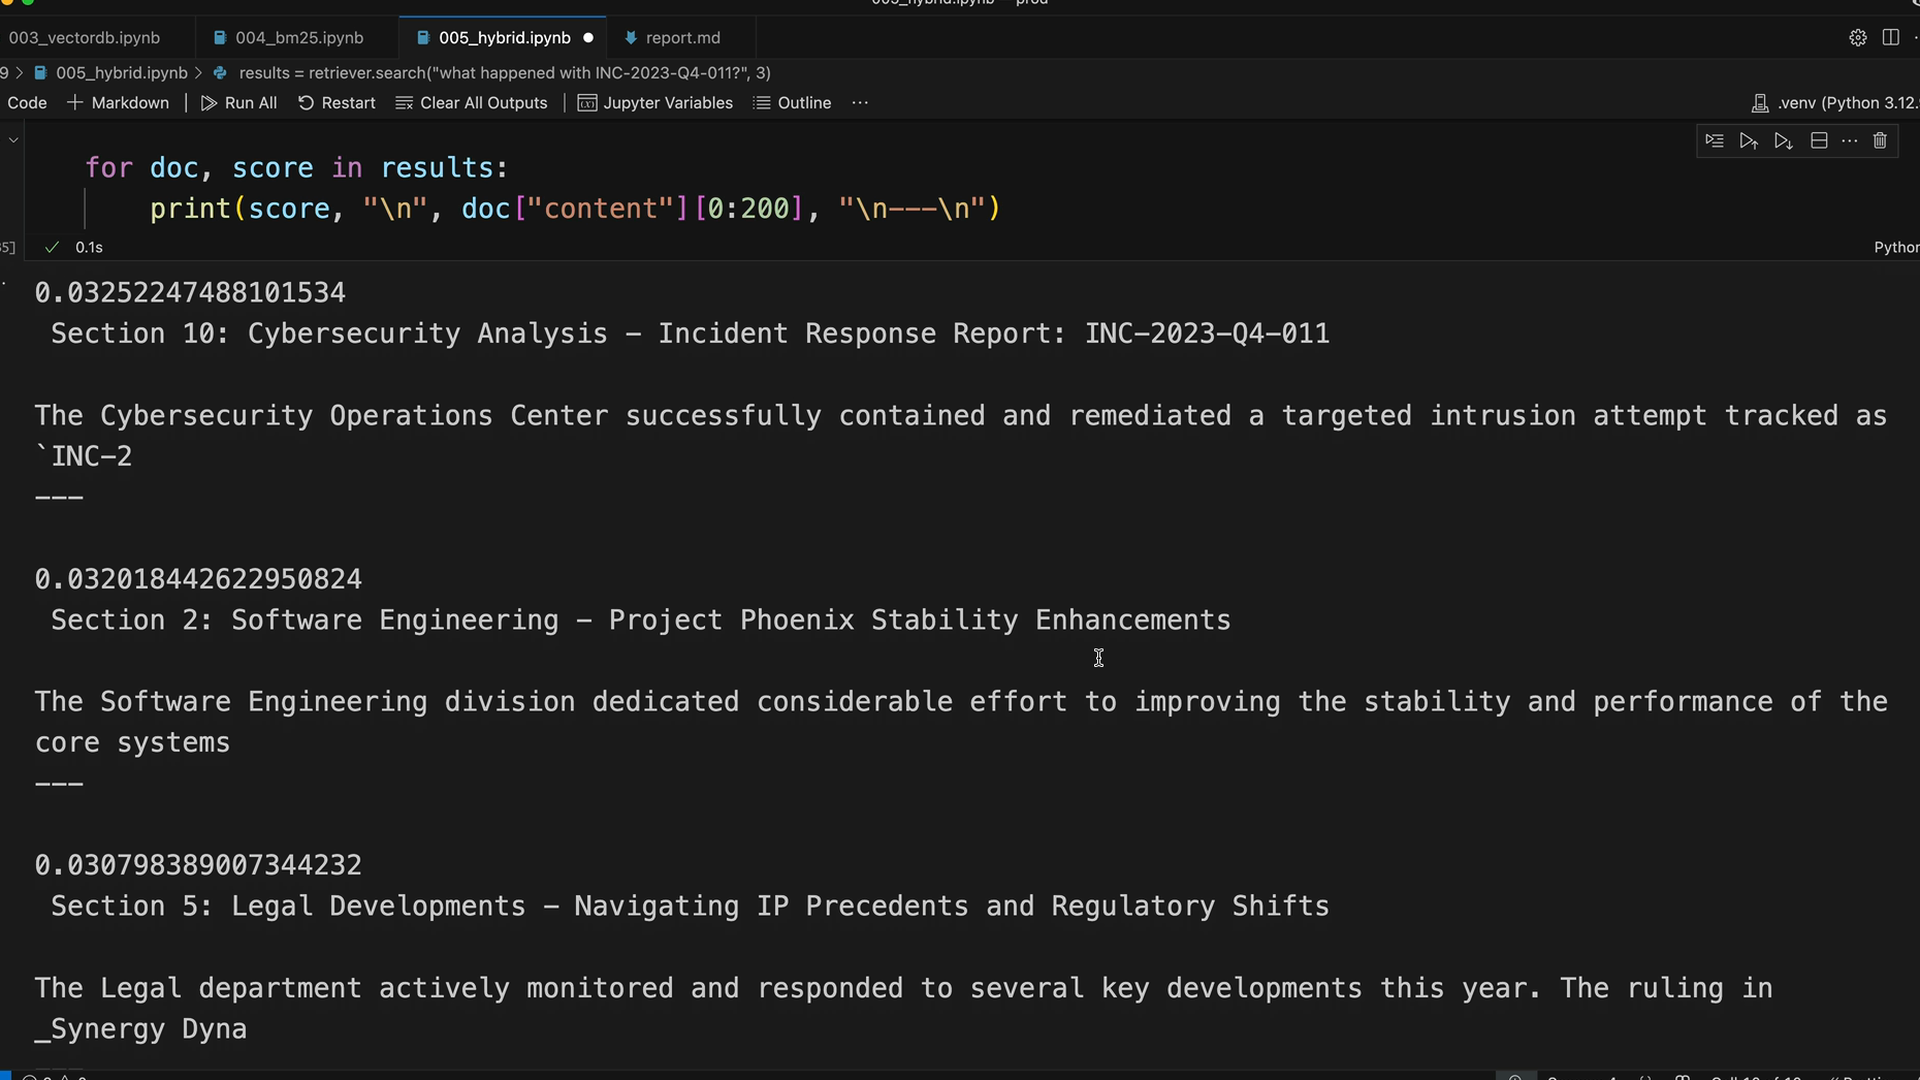
Al probar con una consulta como "¿qué pasó con INC-2023-Q4-011?", el enfoque híbrido ofrece resultados significativamente mejores que cualquiera de los dos métodos por sí solos. En lugar de obtener resultados inesperados de la búsqueda vectorial pura, ahora obtienes primero el informe de incidente de ciberseguridad más relevante, seguido de contenido relacionado con ingeniería de software.
Extensibilidad
La belleza de este diseño es su modularidad. Dado que cada índice de búsqueda implementa la misma interfaz (add_document() y search()), puedes agregar fácilmente nuevas metodologías de búsqueda al sistema. Ya sea un modelo de embeddings diferente, una búsqueda de dominio especializado, o cualquier otra técnica de recuperación, mientras siga la API establecida, se integra sin problemas en el pipeline híbrido.
Este enfoque de búsqueda híbrida representa una mejora significativa en la precisión de recuperación al combinar la comprensión semántica de la búsqueda vectorial con la coincidencia precisa de palabras clave de la búsqueda léxica, todo unificado a través del algoritmo de clasificación RRF matemáticamente sólido.