Ahora que hemos cubierto los fundamentos de RAG, la fragmentación de texto y los embeddings, repasemos paso a paso el pipeline completo de RAG. Este ejemplo te mostrará exactamente cómo todas estas piezas funcionan juntas para recuperar información relevante y generar respuestas.
Paso 1: Fragmenta tu texto fuente
Primero, tomamos nuestro documento fuente y lo dividimos en fragmentos manejables. Para este ejemplo, usaremos dos secciones de texto simples:
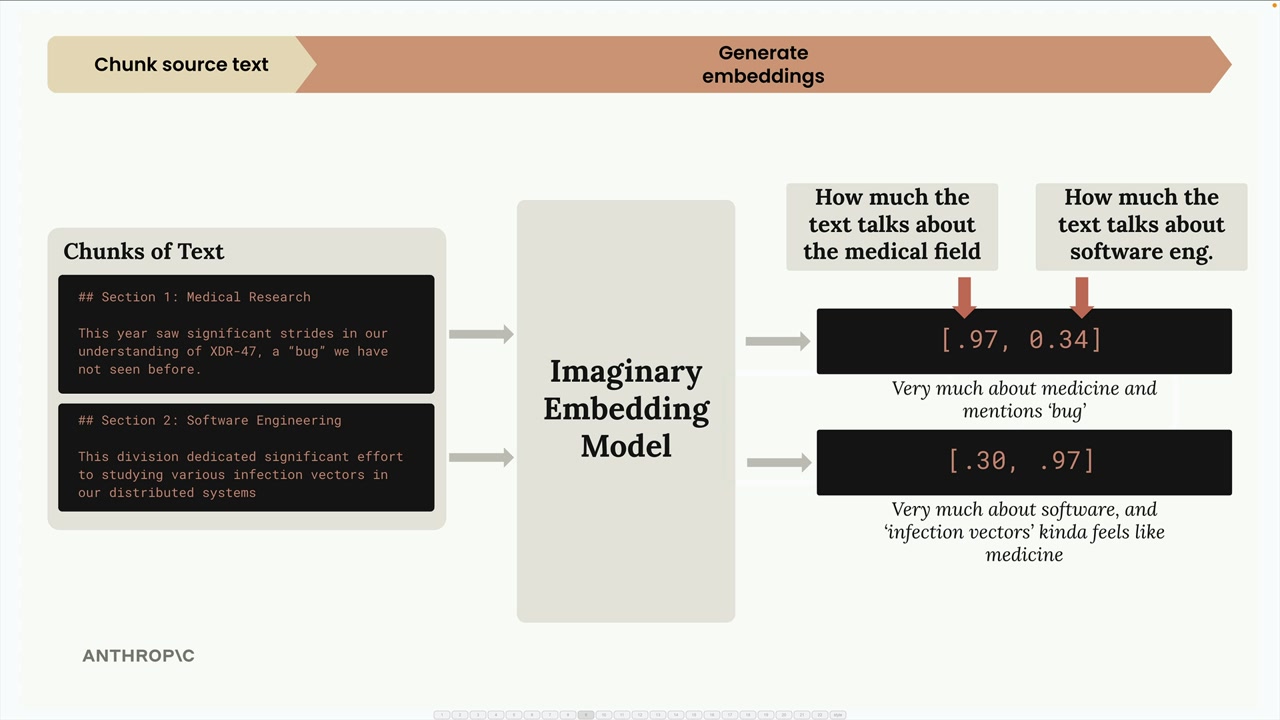
- Sección 1: Investigación médica - "Este año vimos avances significativos en nuestra comprensión del XDR-47, un 'bicho' que no habíamos visto antes."
- Sección 2: Ingeniería de software - "Esta división dedicó un esfuerzo significativo a estudiar varios vectores de infección en nuestros sistemas distribuidos"
Paso 2: Genera embeddings
A continuación, convertimos cada fragmento de texto en embeddings numéricos usando un modelo de embeddings. Para facilitar la comprensión, imaginemos que tenemos un modelo de embeddings perfecto que siempre devuelve exactamente dos números, y sabemos qué representa cada número.
En nuestro modelo imaginario:
- El primer número representa cuánto habla el texto del campo médico
- El segundo número representa cuánto habla el texto de ingeniería de software
Para la sección de investigación médica, podríamos obtener [0.97, 0.34] - muy enfocado en lo médico pero con algunos elementos de software debido a la palabra "bug" ("bicho"). Para la sección de ingeniería de software, obtenemos [0.30, 0.97] - fuertemente enfocado en software pero con matices médicos por "vectores de infección".
Normalización
La API de embeddings normalmente realiza un paso de normalización que escala cada vector para que tenga una magnitud de 1.0. No necesitas preocuparte por las matemáticas aquí - se maneja automáticamente. Esto nos da vectores normalizados como [0.944, 0.331] y [0.295, 0.955].
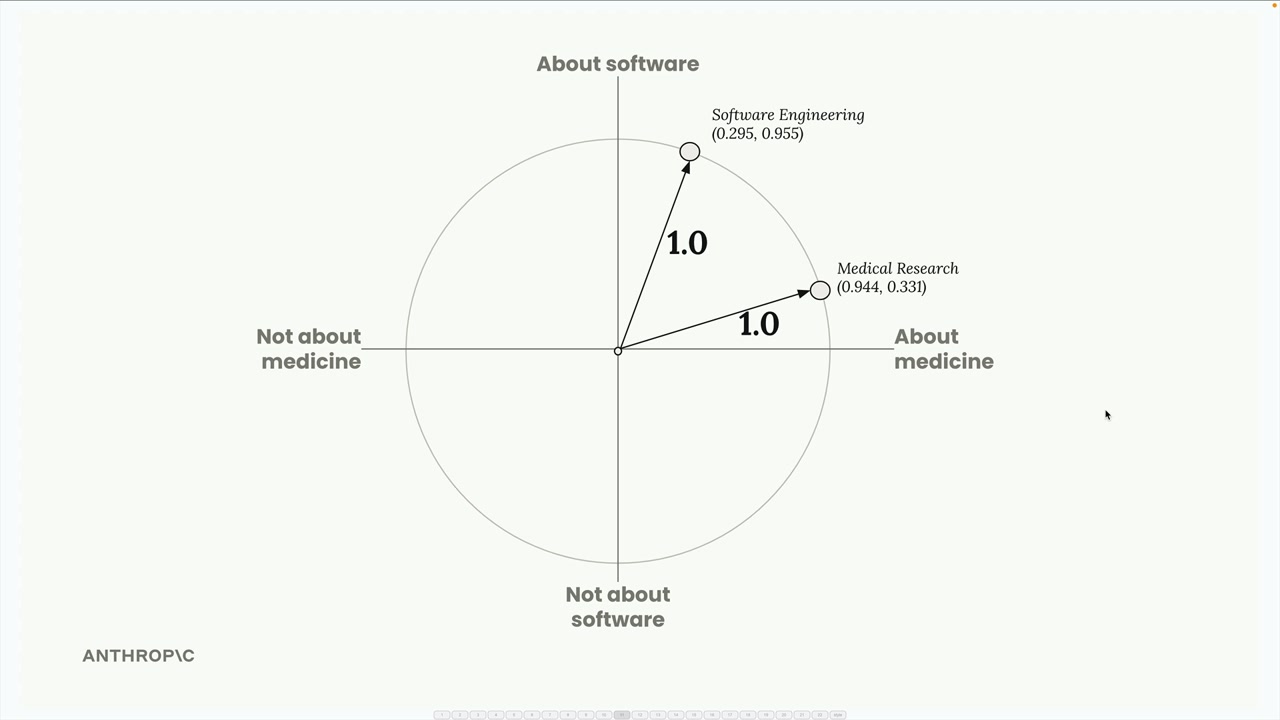
Podemos visualizar estos embeddings en un círculo unitario, donde cada punto representa uno de nuestros fragmentos de texto.
Paso 3: Almacena en la base de datos vectorial
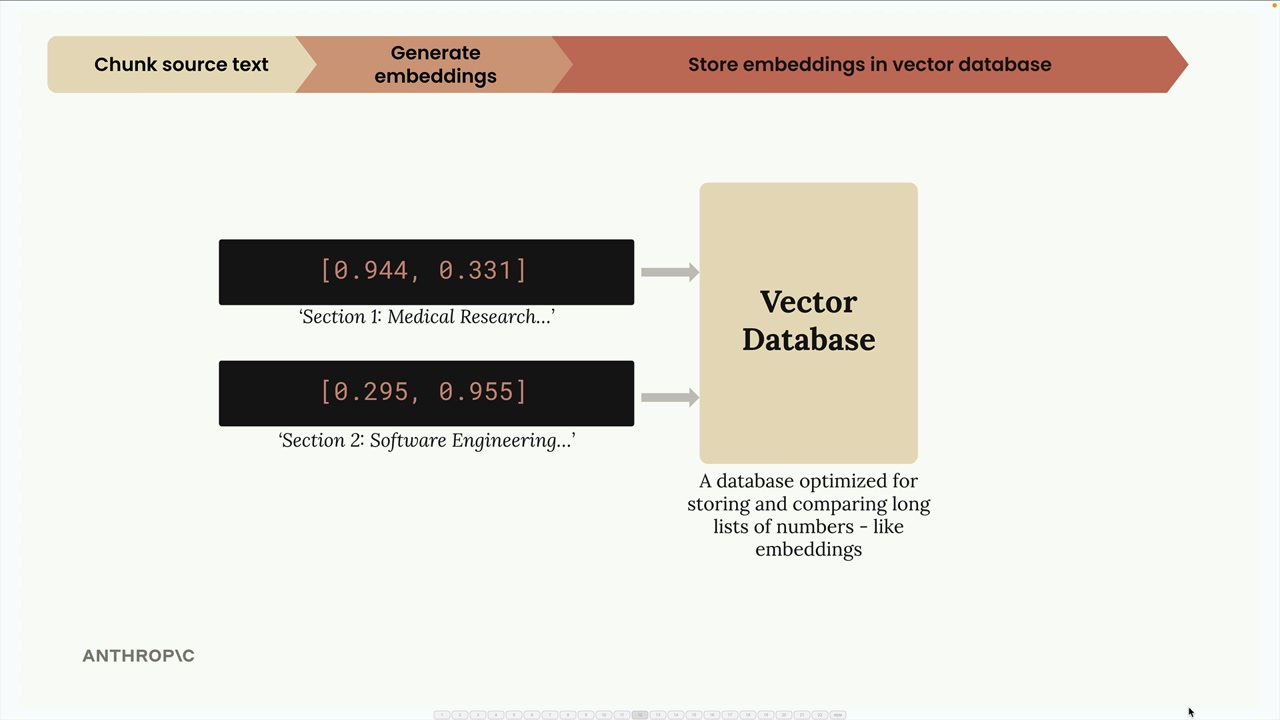
Almacenamos estos embeddings en una base de datos vectorial - una base de datos especializada optimizada para almacenar, comparar y buscar a través de largas listas de números como nuestros embeddings.
En este punto, hacemos una pausa. Todo el trabajo hasta ahora ha sido preprocesamiento que ocurre con antelación. Ahora esperamos a que un usuario envíe una consulta.
Paso 4: Procesa la consulta del usuario
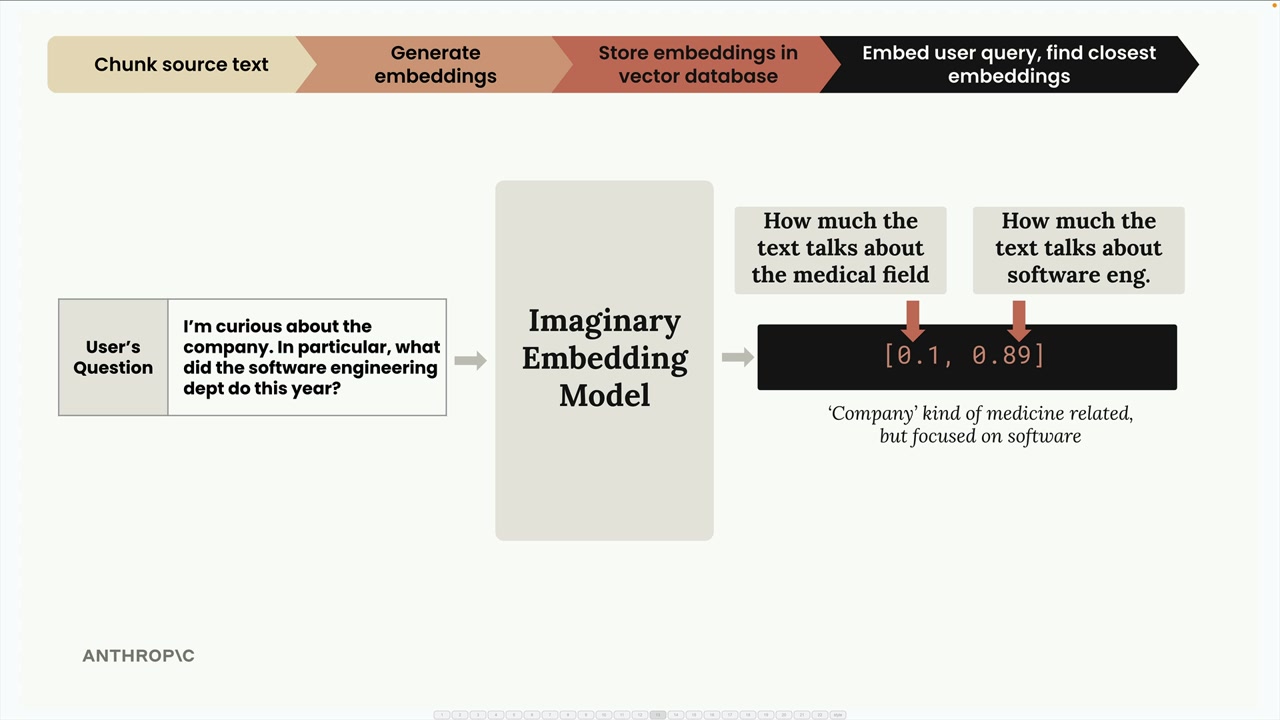
Cuando un usuario hace una pregunta como "Tengo curiosidad sobre la empresa. En particular, ¿qué hizo el departamento de ingeniería de software este año?", ejecutamos su consulta a través del mismo modelo de embeddings.
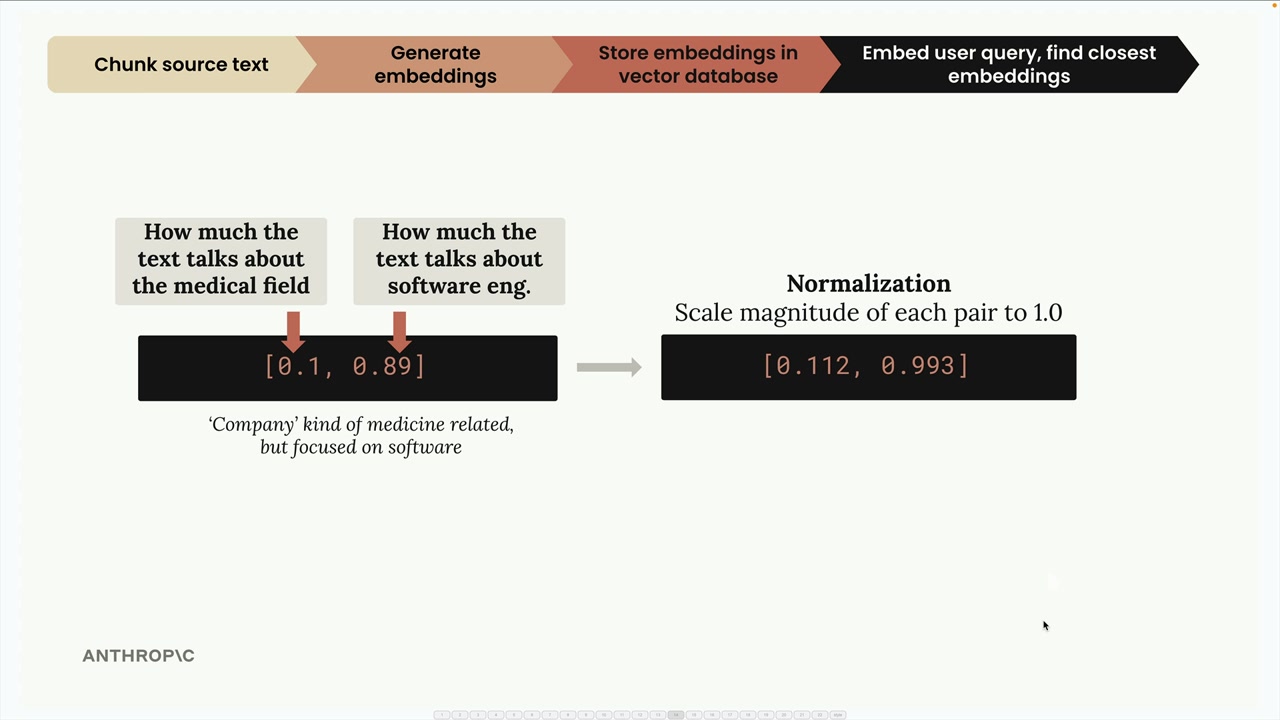
Esta consulta se incorpora como algo similar a [0.1, 0.89] - puntuación médica baja, puntuación alta en ingeniería de software. Después de la normalización, obtenemos [0.112, 0.993].
Paso 5: Encuentra embeddings similares
Enviamos el embedding de la consulta del usuario a nuestra base de datos vectorial y le pedimos que encuentre los embeddings almacenados más similares.
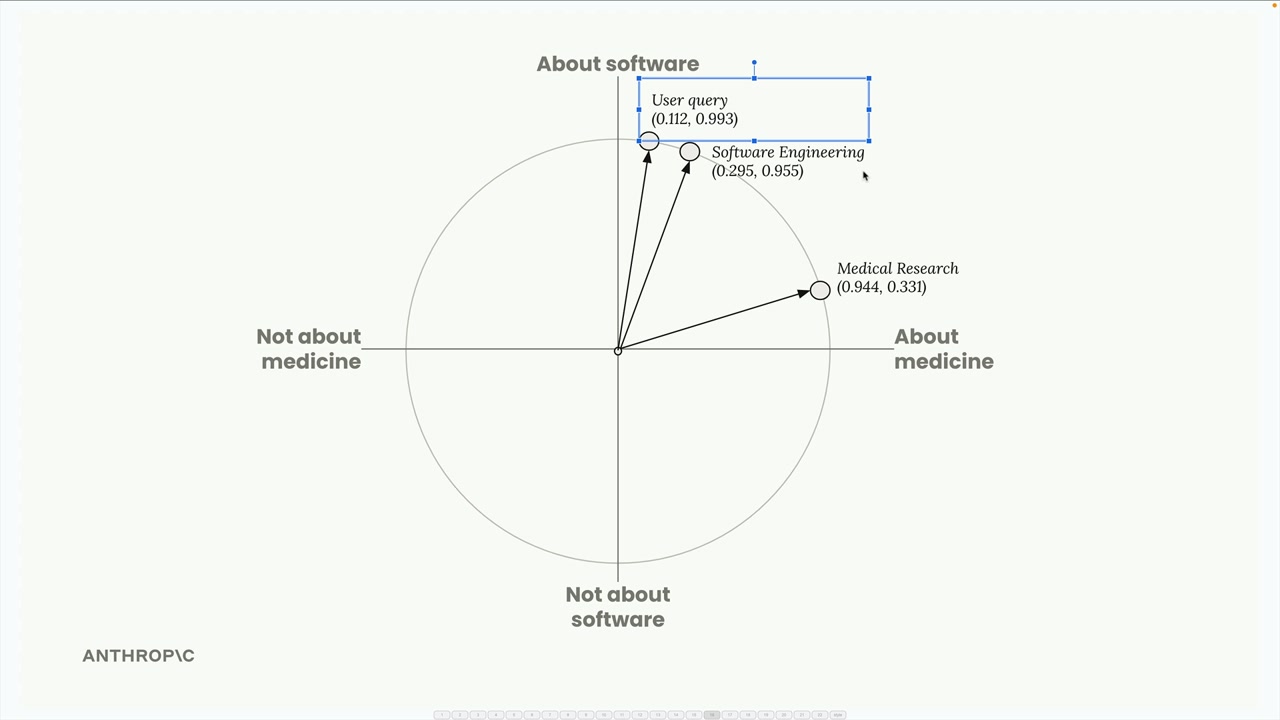
La base de datos devuelve la sección de ingeniería de software porque es la coincidencia más cercana a lo que preguntó el usuario.
Cómo funciona la similitud: similitud coseno
La base de datos vectorial usa la similitud coseno para determinar qué embeddings son más similares. Esto mide el coseno del ángulo entre dos vectores.
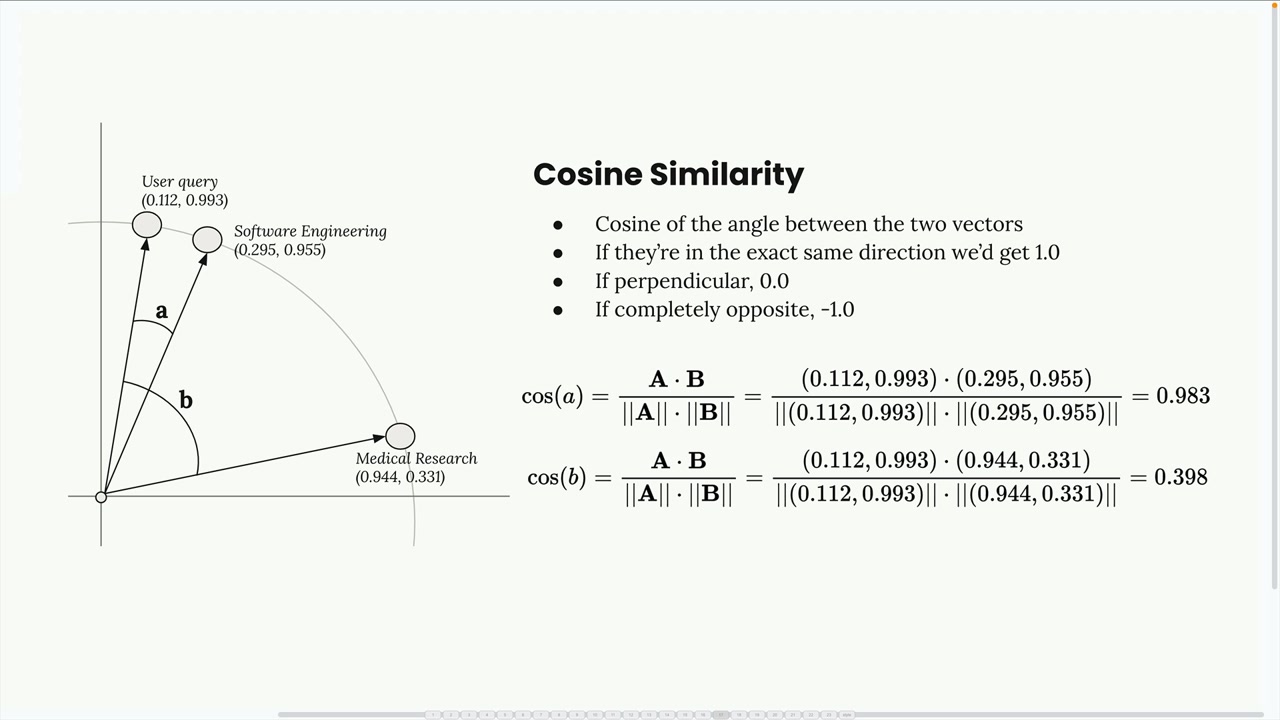
Puntos clave sobre la similitud coseno:
- Los resultados varían entre -1 y 1
- Los valores cercanos a 1 significan alta similitud
- Los valores cercanos a -1 significan muy diferentes
- 0 significa perpendicular (sin relación)
En nuestro ejemplo, la similitud coseno entre la consulta del usuario y el fragmento de ingeniería de software es 0.983 - una similitud muy alta. La similitud con el fragmento de investigación médica es solo 0.398 - mucho más baja.
Distancia coseno
Frecuentemente verás "distancia coseno" en la documentación de bases de datos vectoriales. Esto se calcula simplemente como (1 - similitud coseno). Con la distancia coseno:
- Los valores cercanos a 0 significan alta similitud
- Los valores más grandes significan menos similitud
Este ajuste hace que los números sean más fáciles de interpretar en muchos contextos.
Paso 6: Crea el prompt final
Finalmente, tomamos la pregunta del usuario y el fragmento de texto más relevante que encontramos, los combinamos en un prompt, y lo enviamos a Claude para obtener una respuesta.
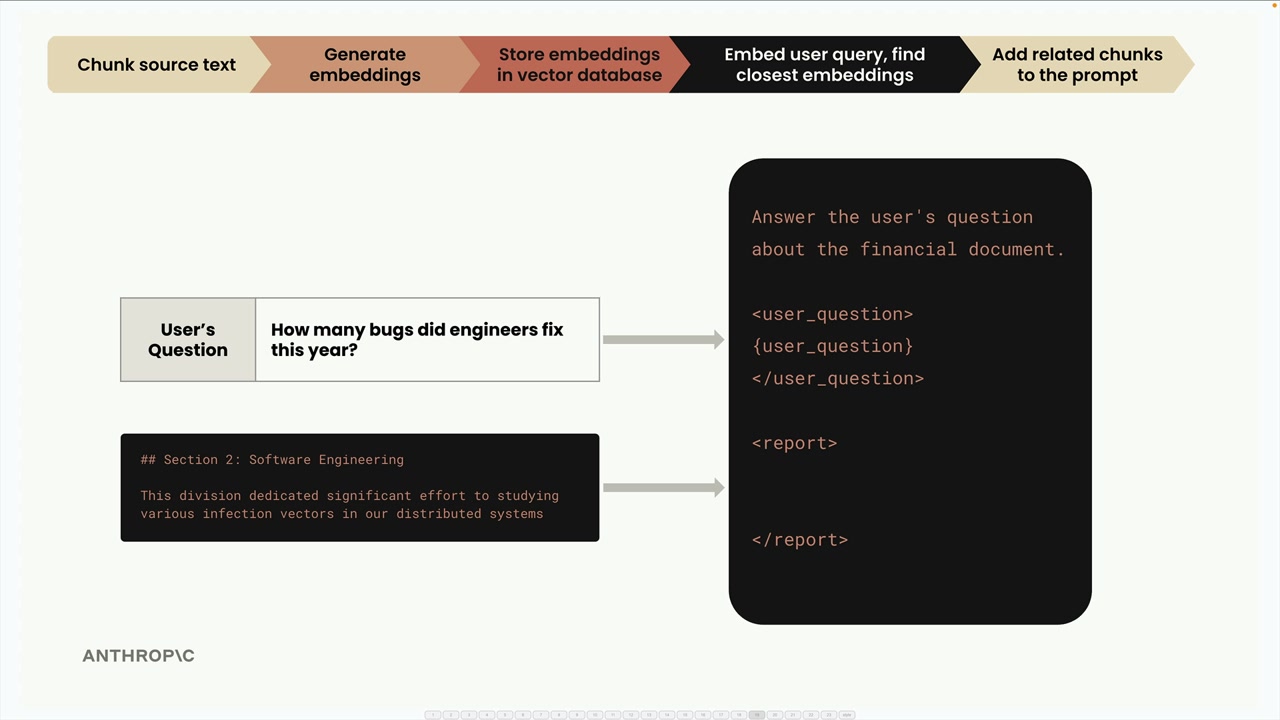
El prompt podría verse así:
Answer the user's question about the financial document.

<user_question>
How many bugs did engineers fix this year?
</user_question>

<report>
## Section 2: Software Engineering
This division dedicated significant effort to studying various infection vectors in our distributed systems
</report>¡Y ese es el pipeline completo de RAG! El sistema recuperó con éxito la información más relevante según la similitud semántica y la proporcionó como contexto para generar una respuesta precisa.