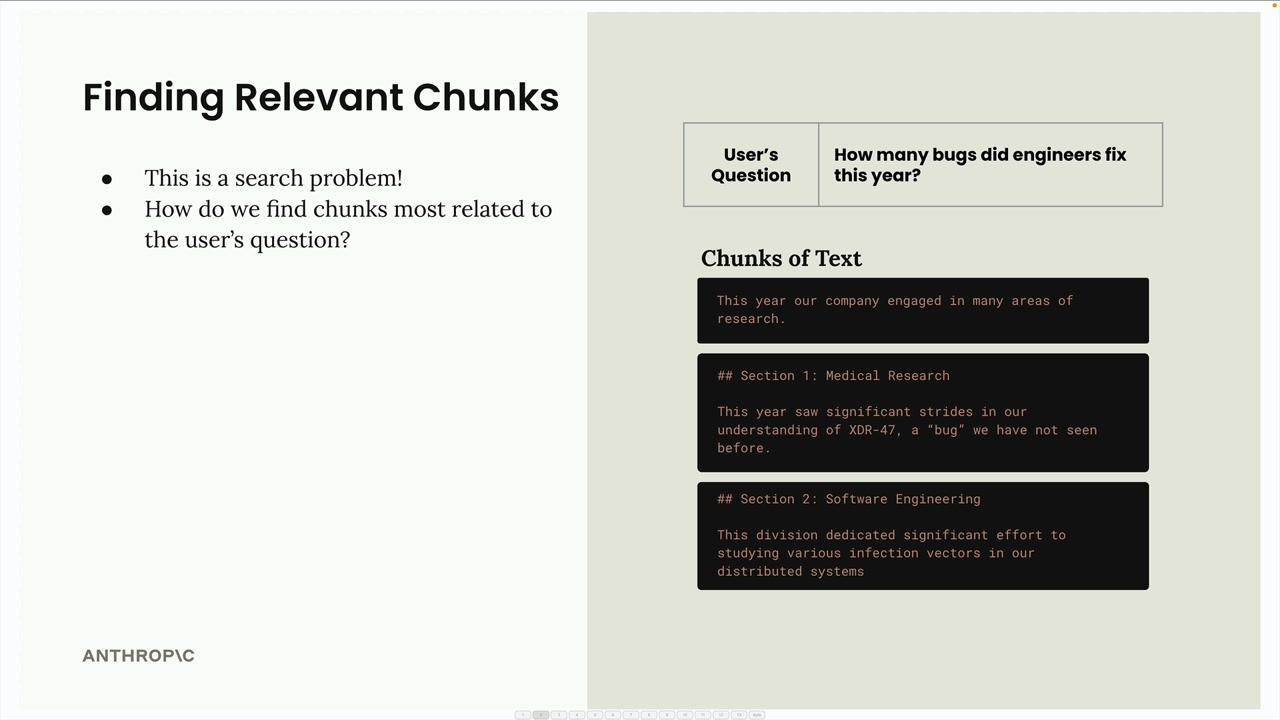
Después de dividir un documento en fragmentos, el siguiente paso en un pipeline de RAG es encontrar qué fragmentos son más relevantes para la pregunta de un usuario. Esto es esencialmente un problema de búsqueda: necesitas revisar todos tus fragmentos de texto e identificar los que se relacionan con lo que el usuario está preguntando.
Búsqueda semántica
El enfoque más común para encontrar fragmentos relevantes es la búsqueda semántica. A diferencia de la búsqueda basada en palabras clave, que busca coincidencias exactas de palabras, la búsqueda semántica usa embeddings de texto para comprender el significado y el contexto tanto de la pregunta del usuario como de cada fragmento de texto.
Embeddings de texto
Un embedding de texto es una representación numérica del significado contenido en un texto. Piensa en ello como convertir palabras y oraciones en un formato con el que las computadoras puedan trabajar matemáticamente.
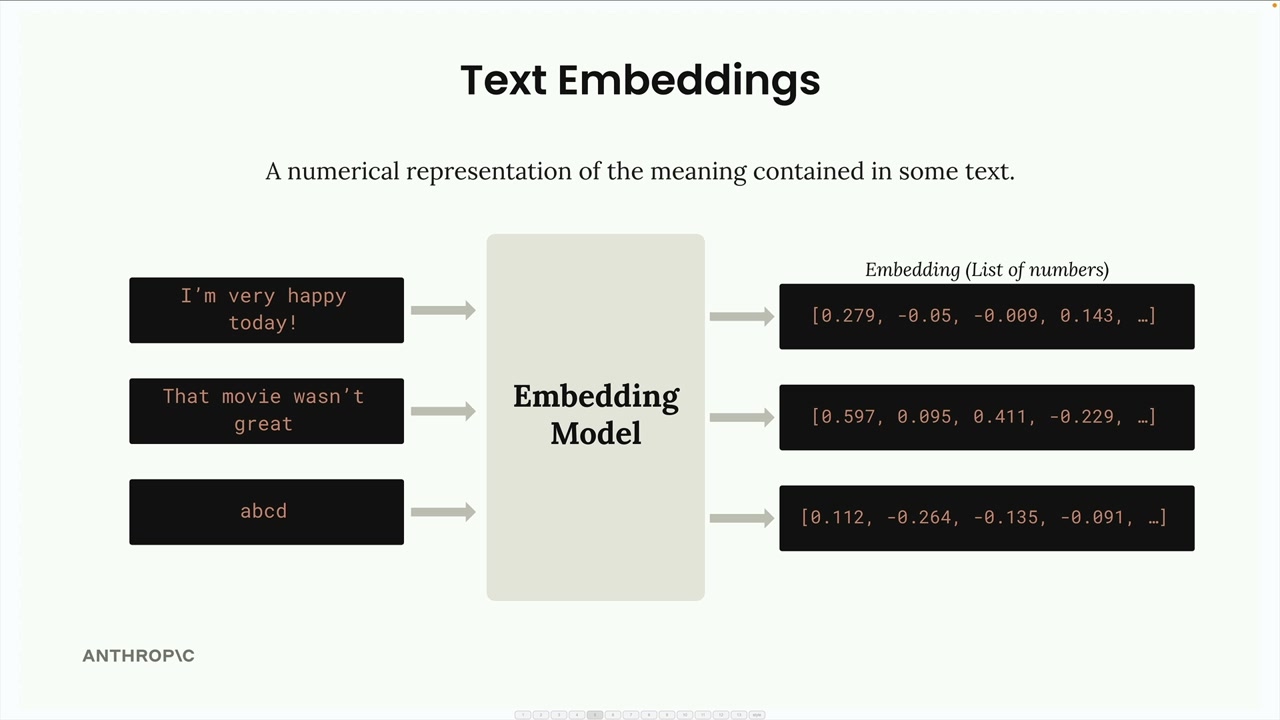
Así es como funciona el proceso:
- Introduces texto en un modelo de embedding
- El modelo genera una larga lista de números (el embedding)
- Cada número varía entre -1 y +1
- Estos números representan diferentes cualidades o características del texto de entrada
Entendiendo los números
Cada número en un embedding es esencialmente una "puntuación" para alguna cualidad del texto de entrada. Sin embargo, aquí está la advertencia importante: no sabemos con precisión qué representa cada número.
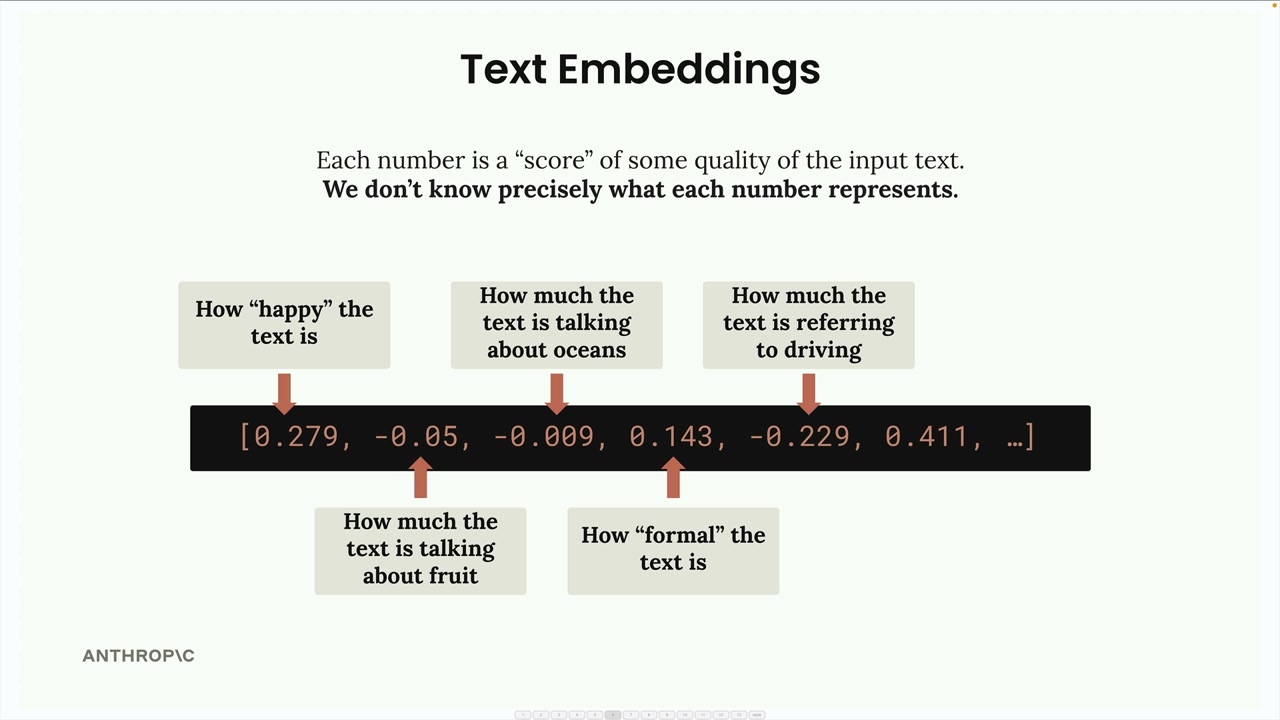
Si bien es útil imaginar que un número podría representar "qué tan feliz es el texto" o "cuánto habla el texto sobre océanos", estos son solo ejemplos conceptuales. El significado real de cada dimensión es aprendido por el modelo durante el entrenamiento y no es directamente interpretable por humanos.
VoyageAI para embeddings
Dado que Anthropic actualmente no ofrece generación de embeddings, el proveedor recomendado es VoyageAI. Necesitarás:
- Registrarte para obtener una cuenta separada de VoyageAI
- Obtener una clave de API (gratis para comenzar)
- Agregar la clave a tus variables de entorno
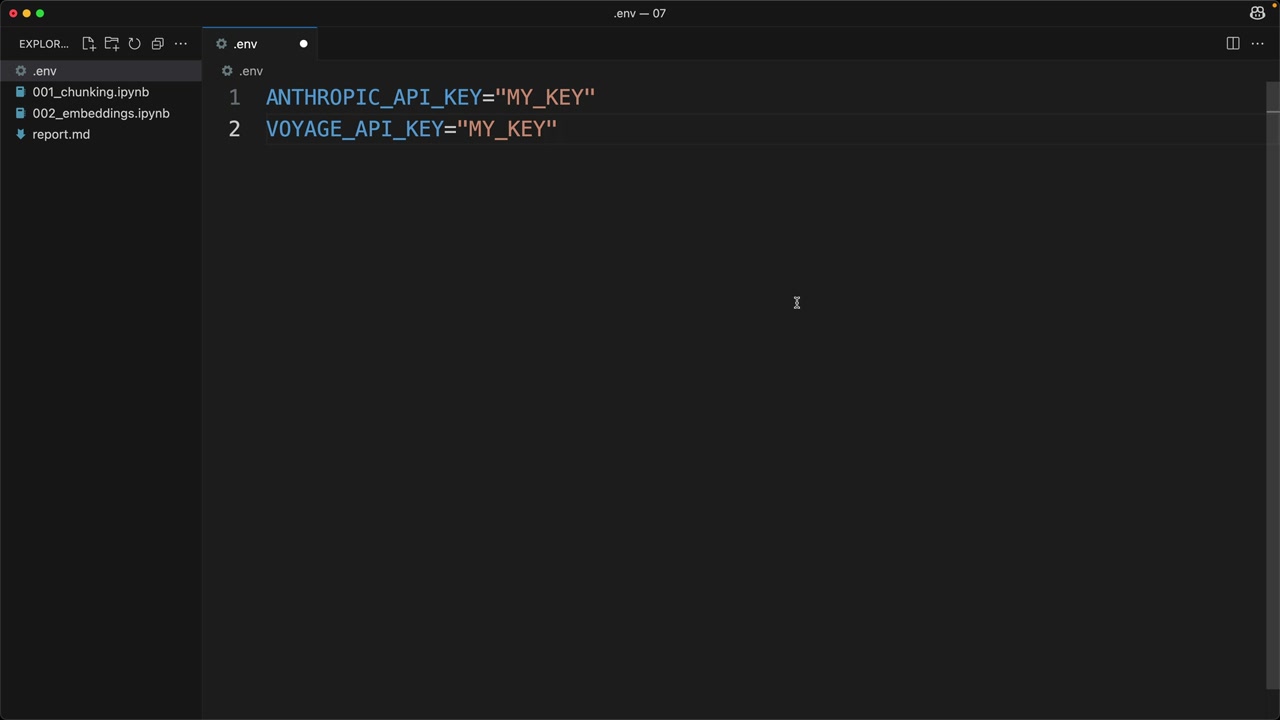
En tu archivo .env, agrega:
VOYAGE_API_KEY="your_key_here"Implementación
Primero, instala la librería de VoyageAI:
%pip install voyageaiLuego, configura el cliente y crea una función para generar embeddings:
from dotenv import load_dotenv
import voyageai

load_dotenv()
client = voyageai.Client()

def generate_embedding(text, model="voyage-3-large", input_type="query"):
    result = client.embed([text], model=model, input_type=input_type)
    return result.embeddings[0]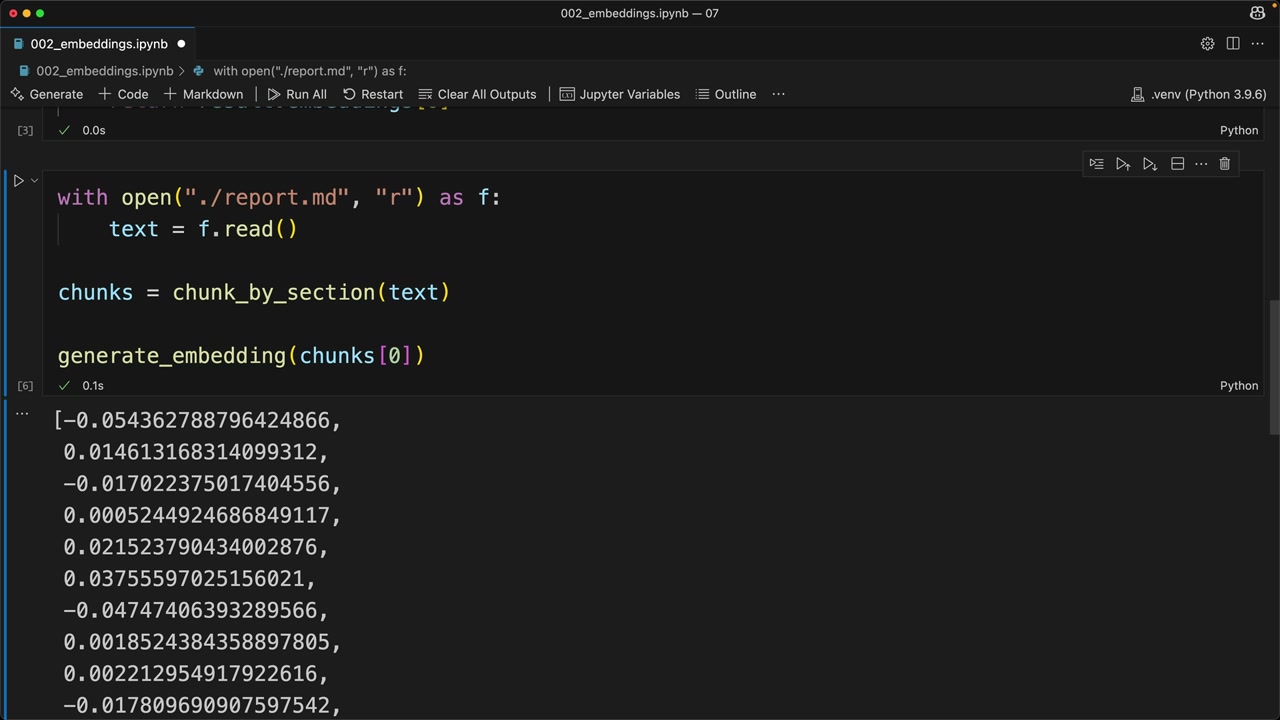
Cuando ejecutas esta función en un fragmento de texto, obtienes de vuelta una lista de números de punto flotante que representan el embedding. El proceso es rápido y sencillo; el verdadero desafío es entender cómo usar estos embeddings de manera efectiva en tu pipeline de RAG para encontrar el contenido más relevante.
El siguiente paso es aprender cómo comparar embeddings para determinar qué fragmentos son más similares a la pregunta de un usuario, lo cual forma el núcleo del proceso de búsqueda semántica.