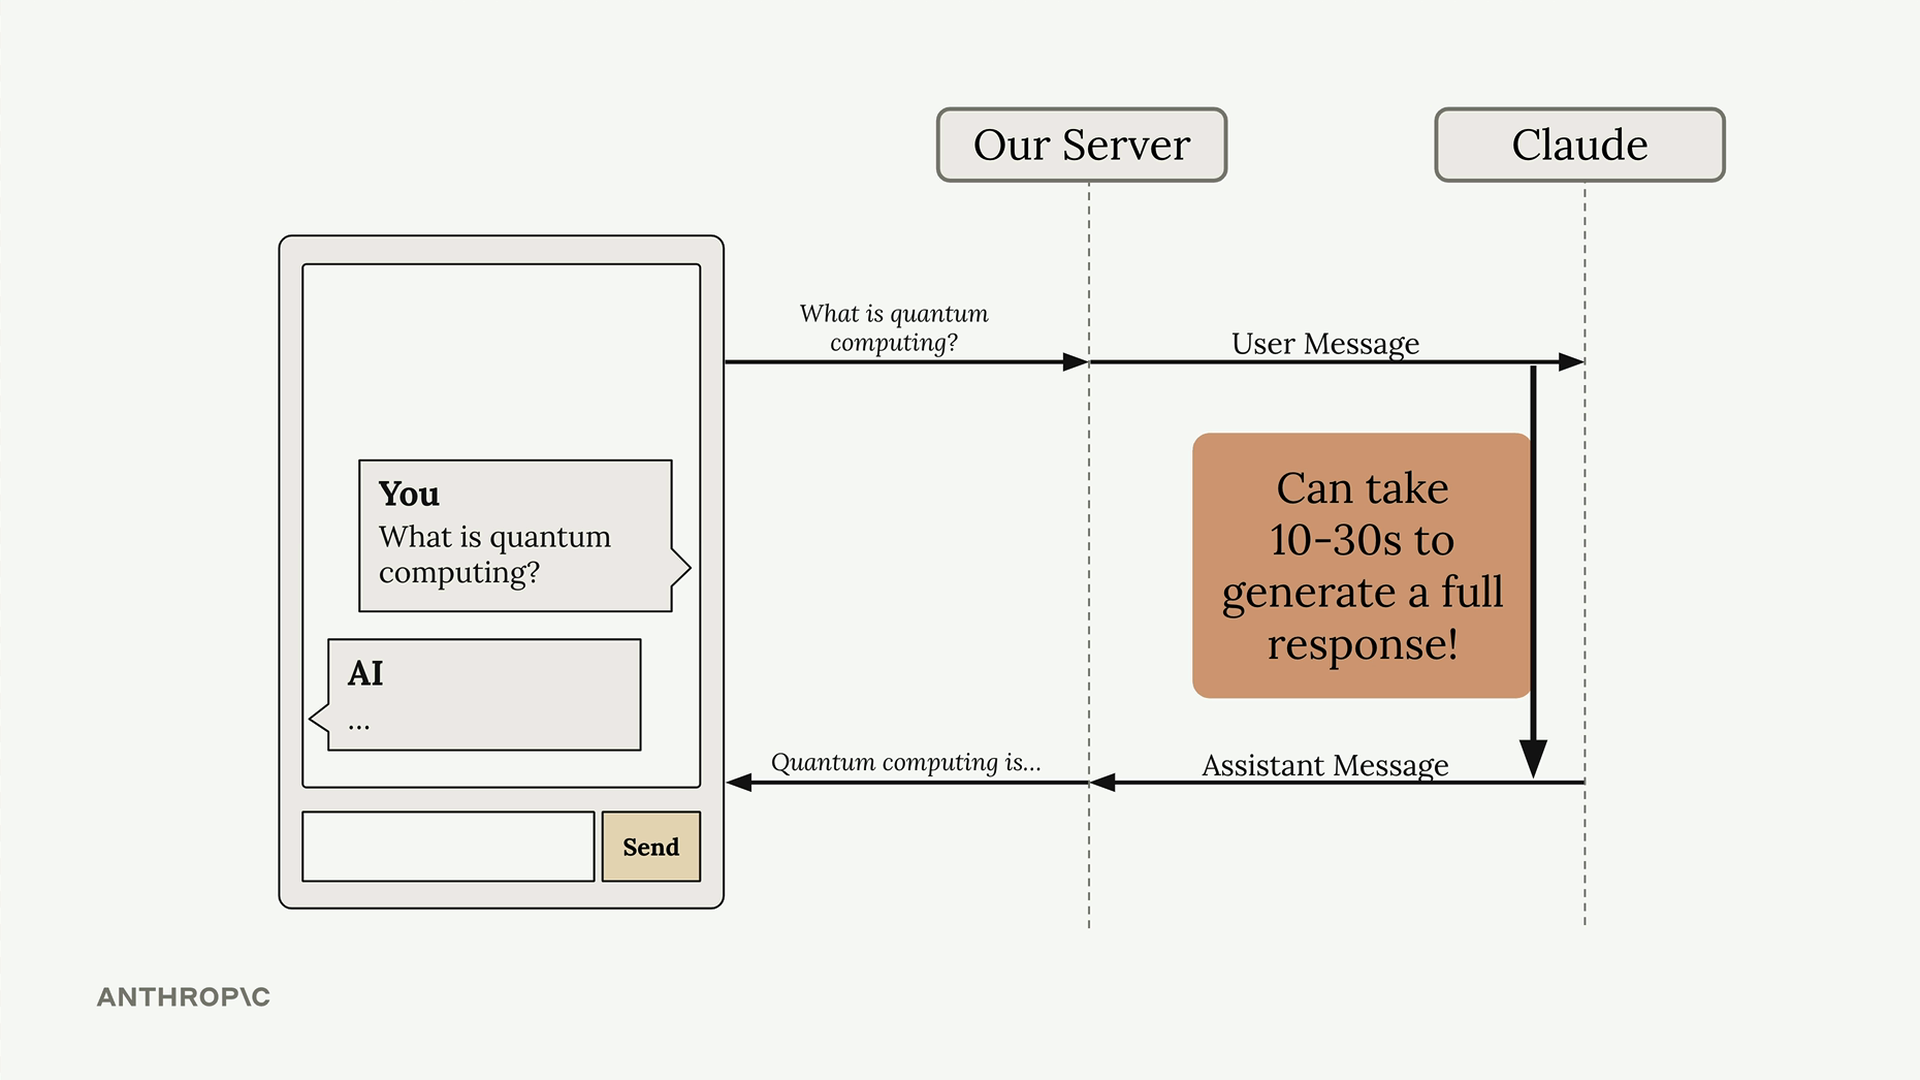
Al crear aplicaciones de chat con Claude, existe un desafío importante de experiencia de usuario: las respuestas pueden tardar entre 10 y 30 segundos en generarse, dejando a los usuarios mirando un indicador de carga. La solución es el streaming de respuestas, que permite a los usuarios ver cómo aparece el texto fragmento a fragmento a medida que Claude lo genera, creando una sensación mucho más receptiva.
El problema con las respuestas estándar
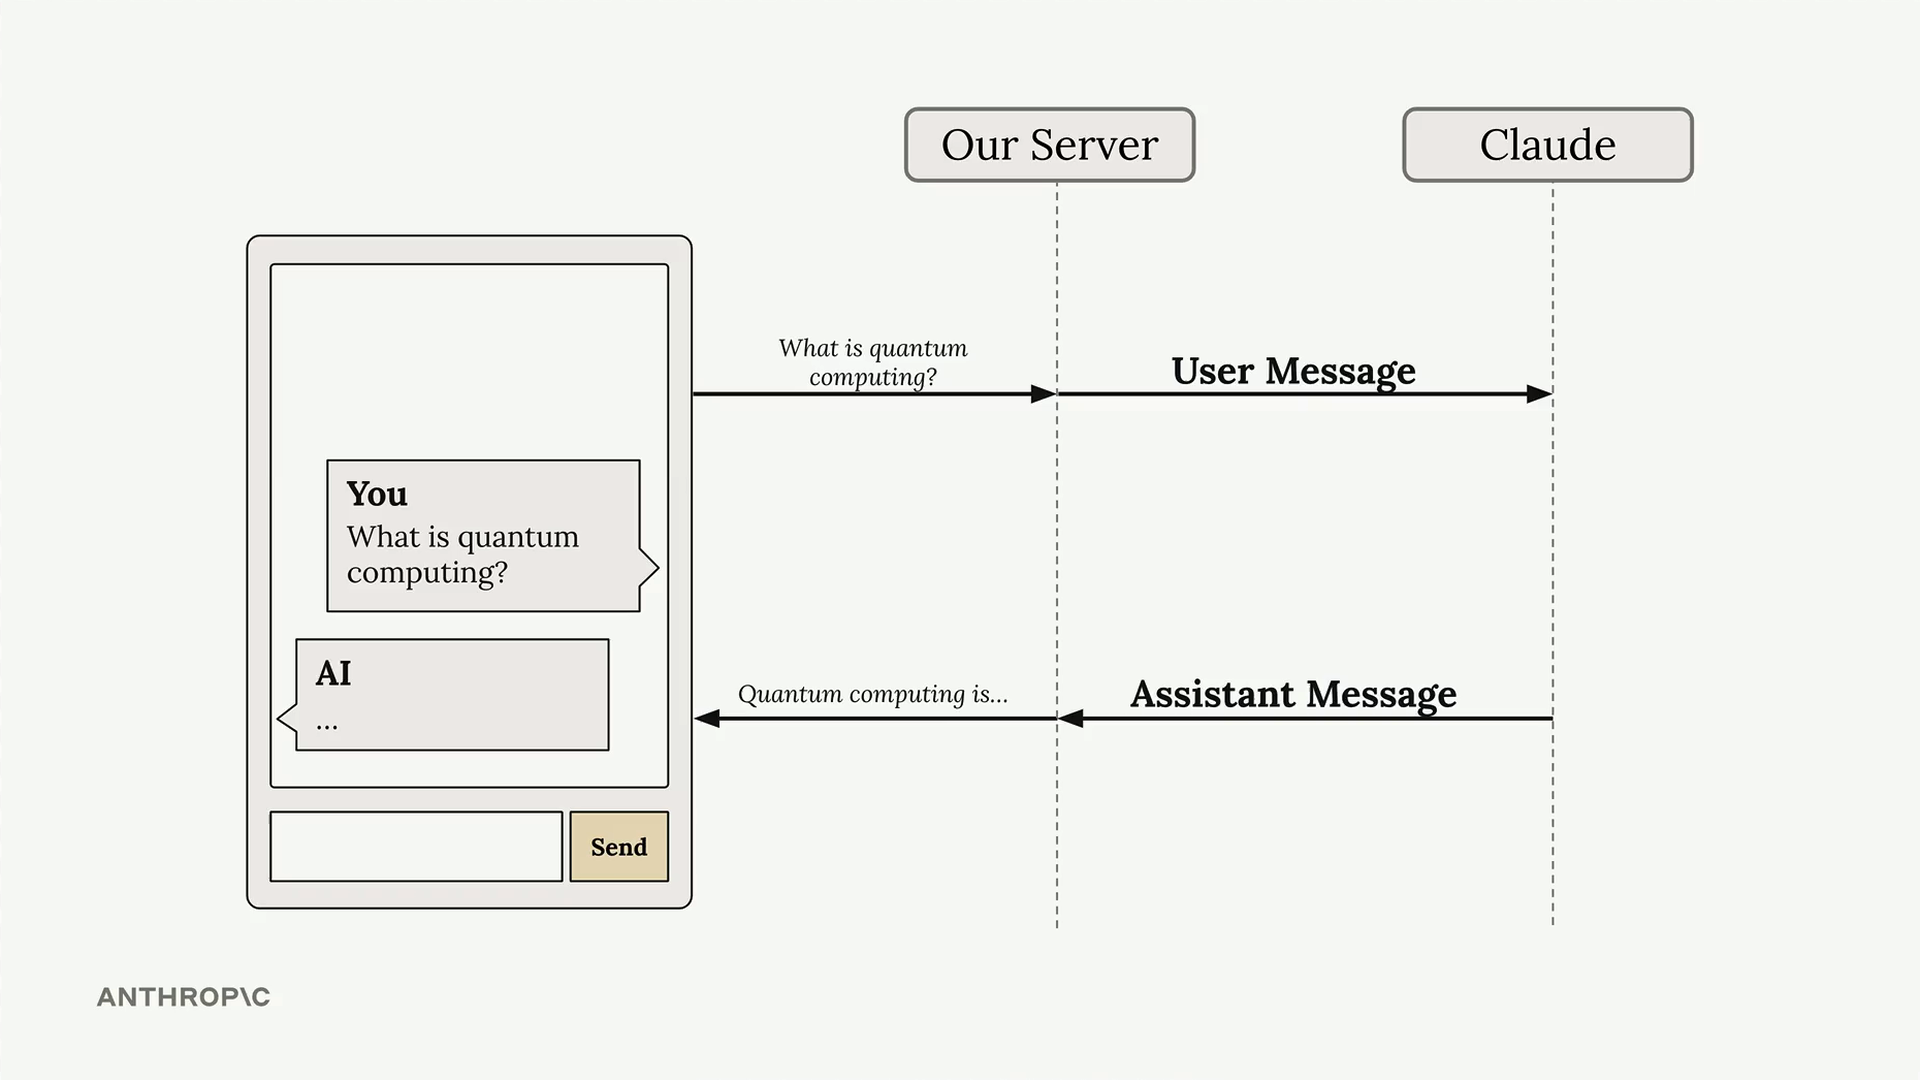
En una configuración de chat típica, tu servidor envía un mensaje del usuario a Claude y espera la respuesta completa antes de enviar algo de vuelta al cliente. Esto crea una demora incómoda en la que los usuarios no tienen retroalimentación de que algo esté sucediendo.
Cómo funciona el streaming
Con el streaming habilitado, Claude envía de inmediato una respuesta inicial indicando que ha recibido tu solicitud y está comenzando a generar texto. Luego recibes una serie de eventos, cada uno con un pequeño fragmento de la respuesta general.
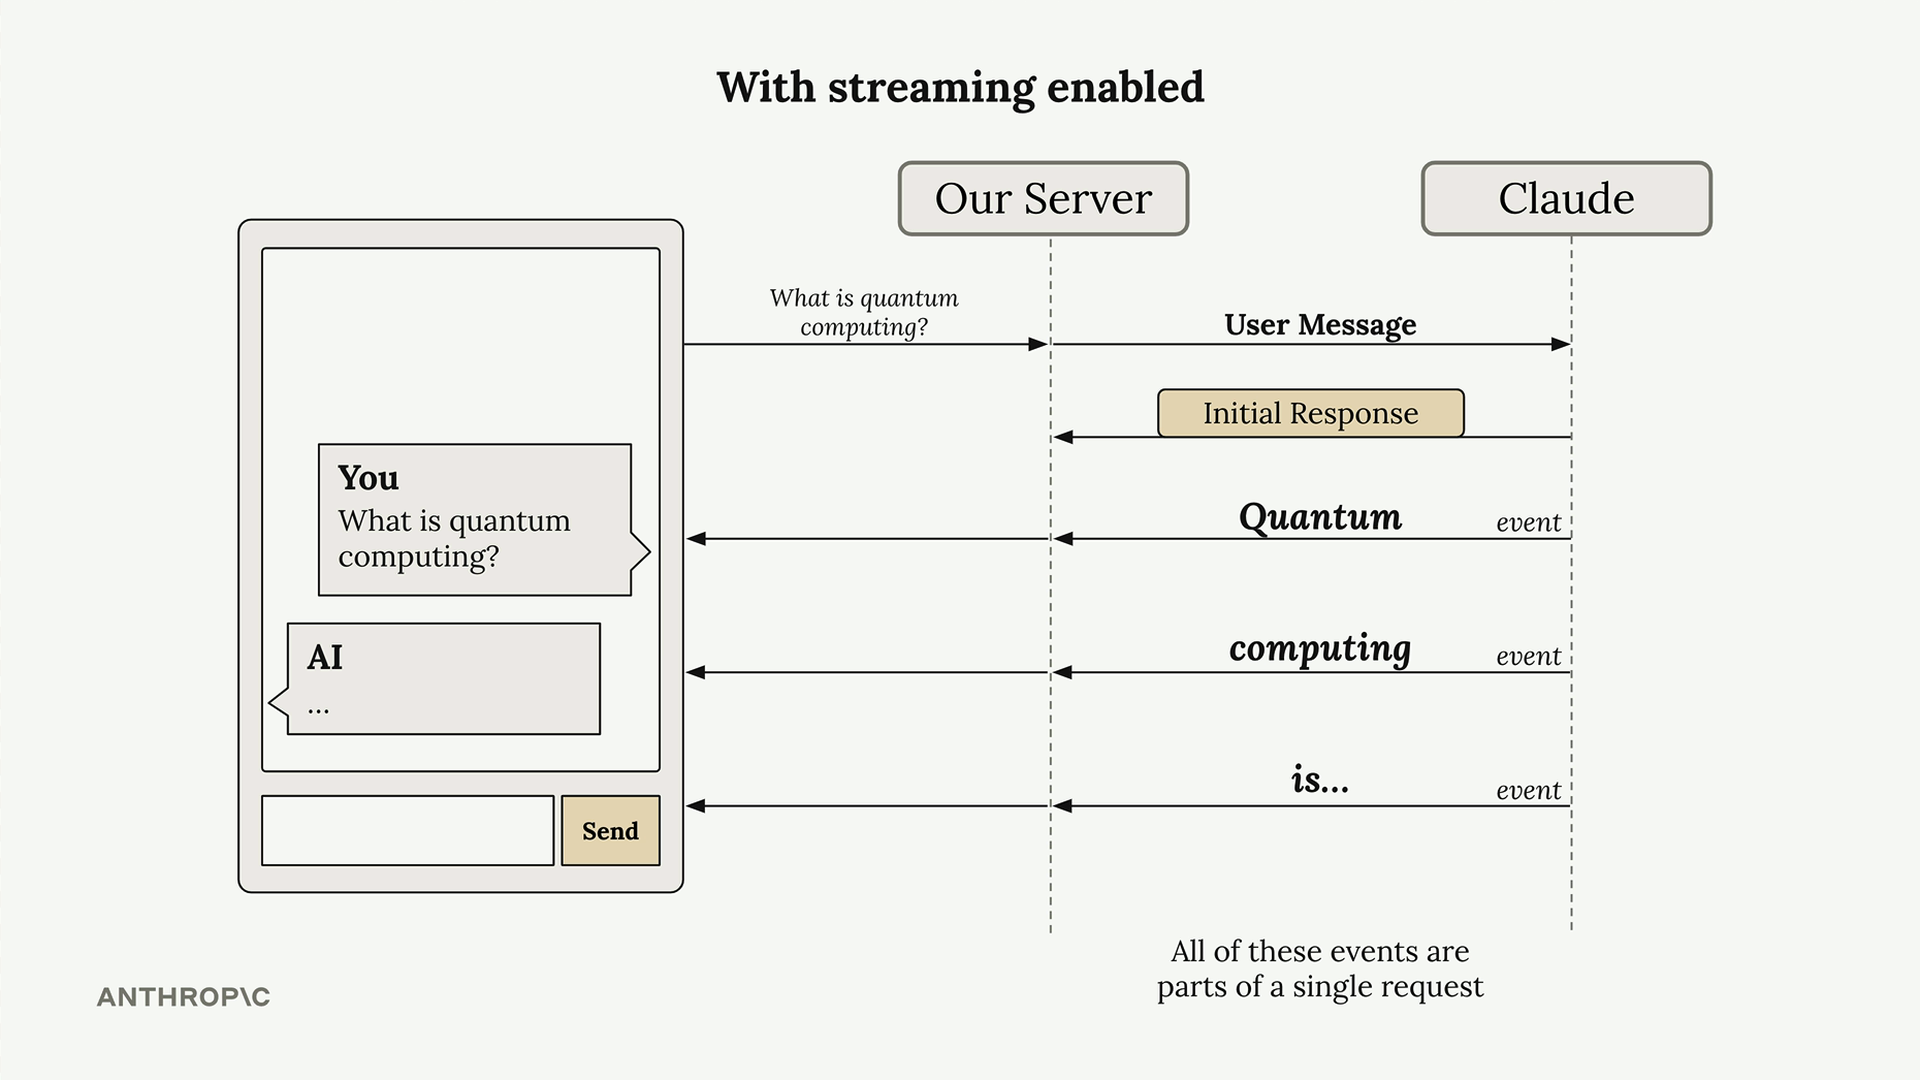
Tu servidor puede reenviar estos fragmentos de texto a tu aplicación cliente a medida que llegan, permitiendo que los usuarios vean la respuesta construirse palabra por palabra. Todos estos eventos forman parte de una sola solicitud a Claude.
Comprender los eventos de streaming
Cuando habilitas el streaming, Claude envía de vuelta varios tipos de eventos:
- MessageStart - Se está enviando un nuevo mensaje
- ContentBlockStart - Inicio de un nuevo bloque que contiene texto, uso de herramientas u otro contenido
- ContentBlockDelta - Fragmentos del texto real generado
- ContentBlockStop - El bloque de contenido actual se ha completado
- MessageDelta - El mensaje actual está completo
- MessageStop - Fin de la información sobre el mensaje actual
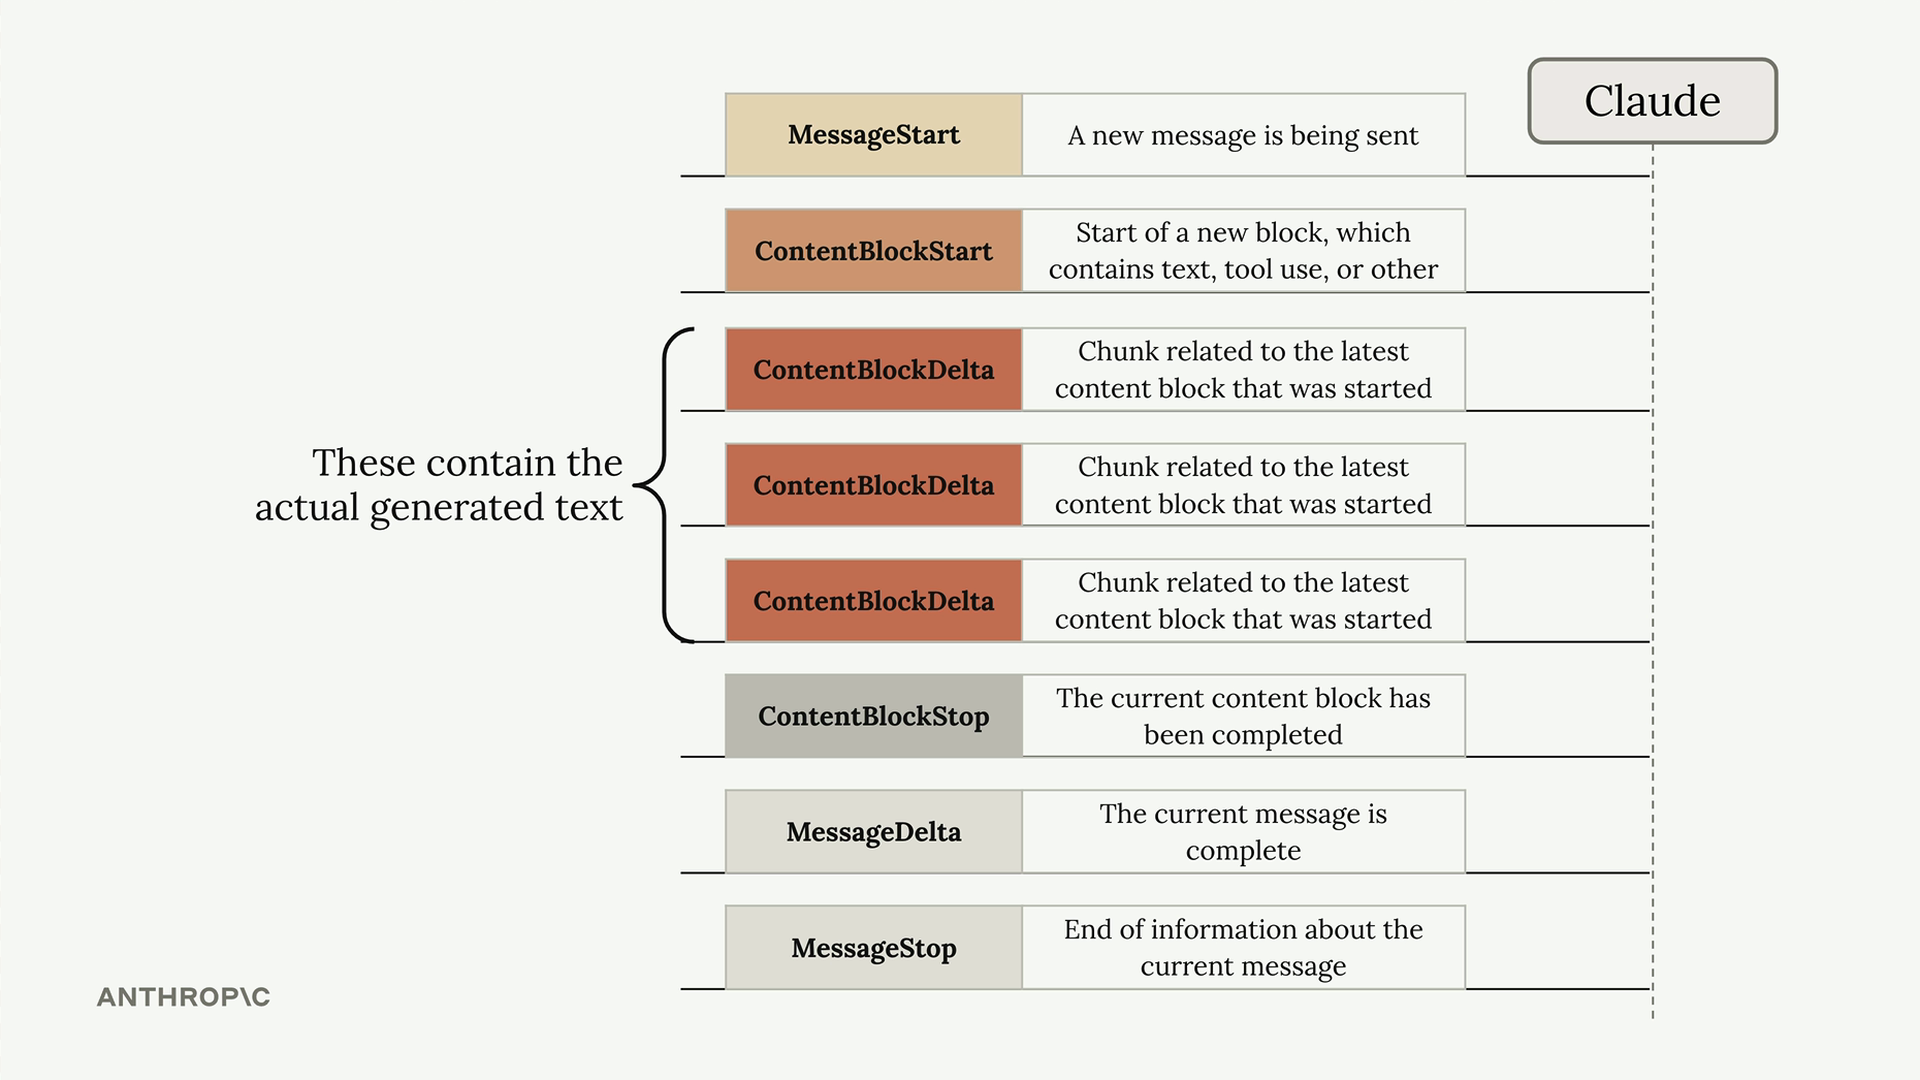
Los eventos ContentBlockDelta contienen el texto real generado que querrás mostrar a los usuarios.
Implementación básica de streaming
Para habilitar el streaming, añade stream=True a tu llamada a messages.create:
messages = []
add_user_message(messages, "Write a 1 sentence description of a fake database")

stream = client.messages.create(
    model=model,
    max_tokens=1000,
    messages=messages,
    stream=True
)

for event in stream:
    print(event)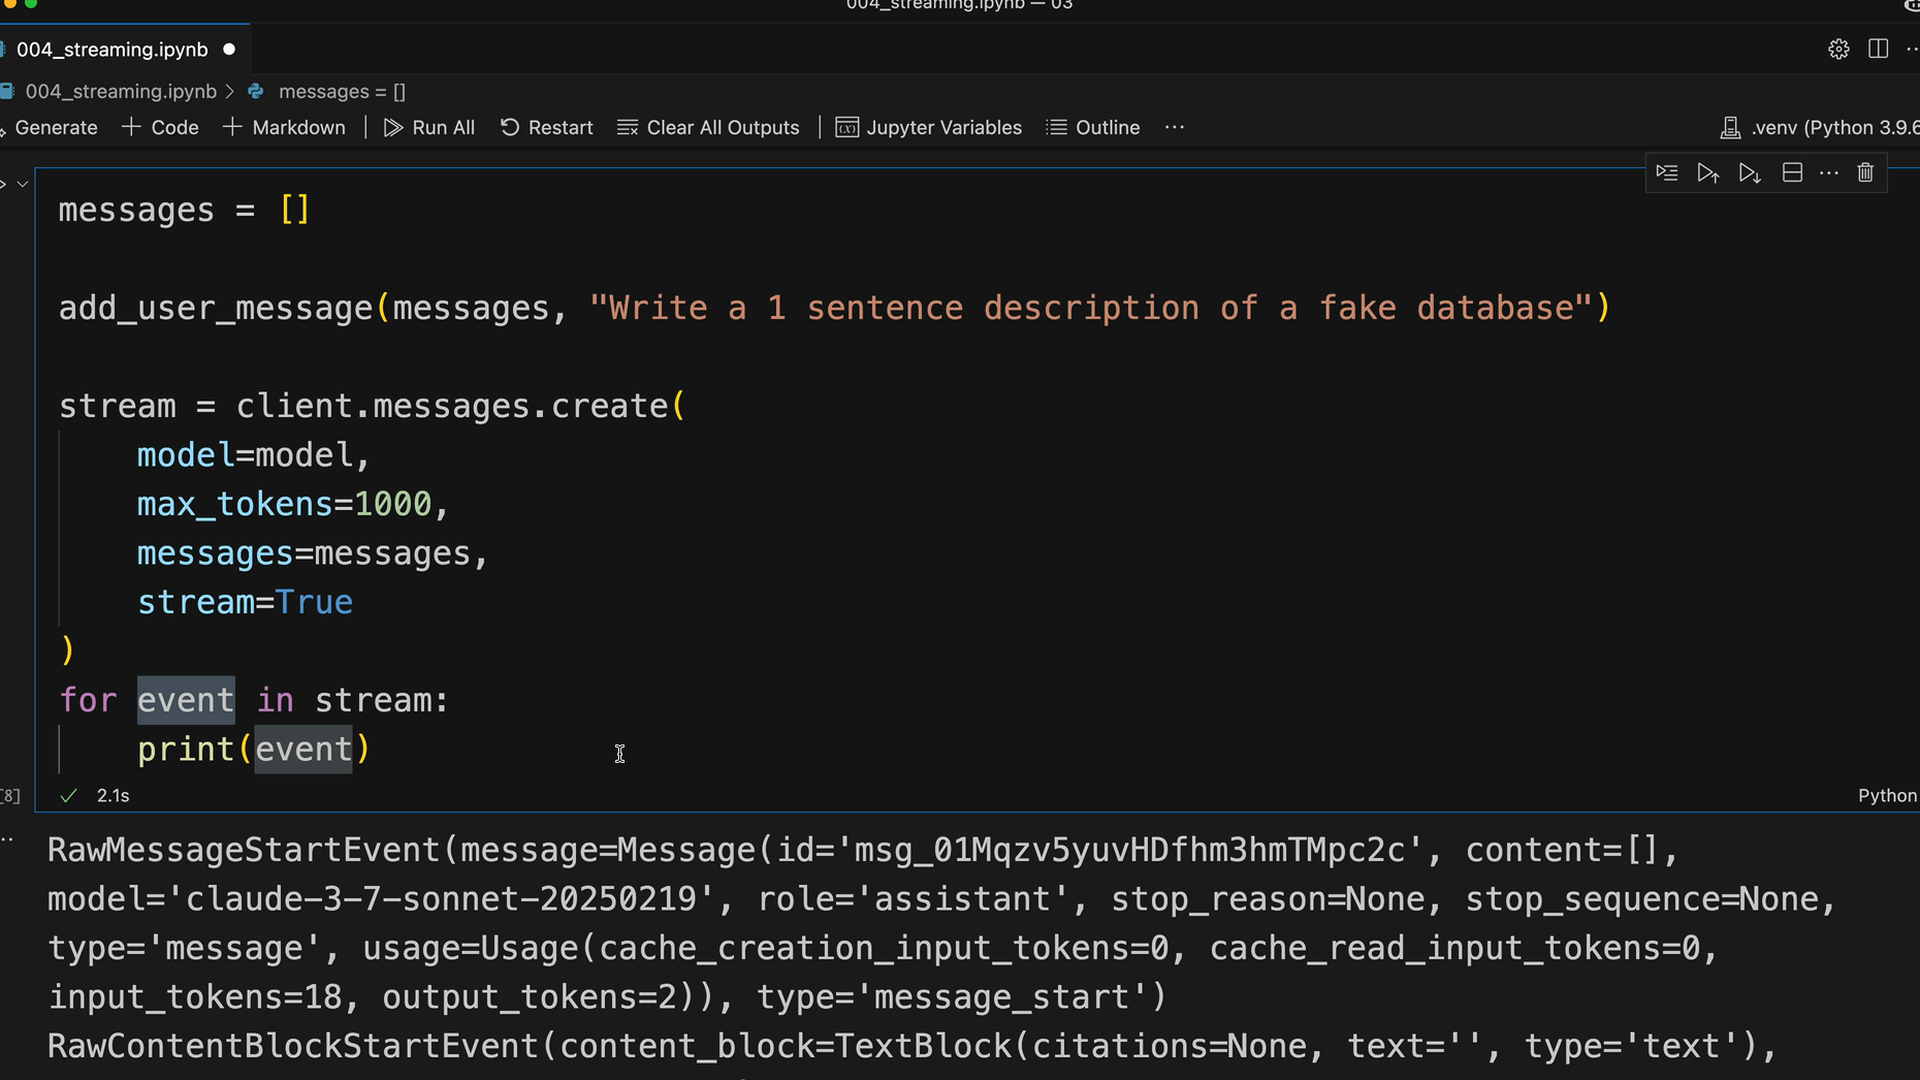
Streaming de texto simplificado
En lugar de analizar manualmente los eventos, puedes usar la interfaz de streaming simplificada del SDK que extrae solo el contenido de texto:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        print(text, end="")
Este enfoque filtra automáticamente todo excepto el contenido de texto real, que generalmente es lo que necesitas para mostrar respuestas a los usuarios.
Obtener el mensaje completo
Si bien transmitir fragmentos individuales es excelente para la experiencia de usuario, a menudo necesitas el mensaje completo para almacenamiento o procesamiento adicional. Después de que el streaming se completa, puedes obtener el mensaje final ensamblado:
with client.messages.stream(
    model=model,
    max_tokens=1000,
    messages=messages
) as stream:
    for text in stream.text_stream:
        # Envía cada fragmento a tu cliente
        pass

    # Obtén el mensaje completo para almacenarlo en la base de datos
    final_message = stream.get_final_message()
Esto te da lo mejor de ambos mundos: streaming en tiempo real para los usuarios y un objeto de mensaje completo para la lógica de tu aplicación.