Ahora que tenemos listo nuestro conjunto de datos de evaluación, es momento de construir el pipeline principal de evaluación. Esto implica tomar cada caso de prueba, combinarlo con nuestra indicación, pasarlo a Claude y luego calificar los resultados.
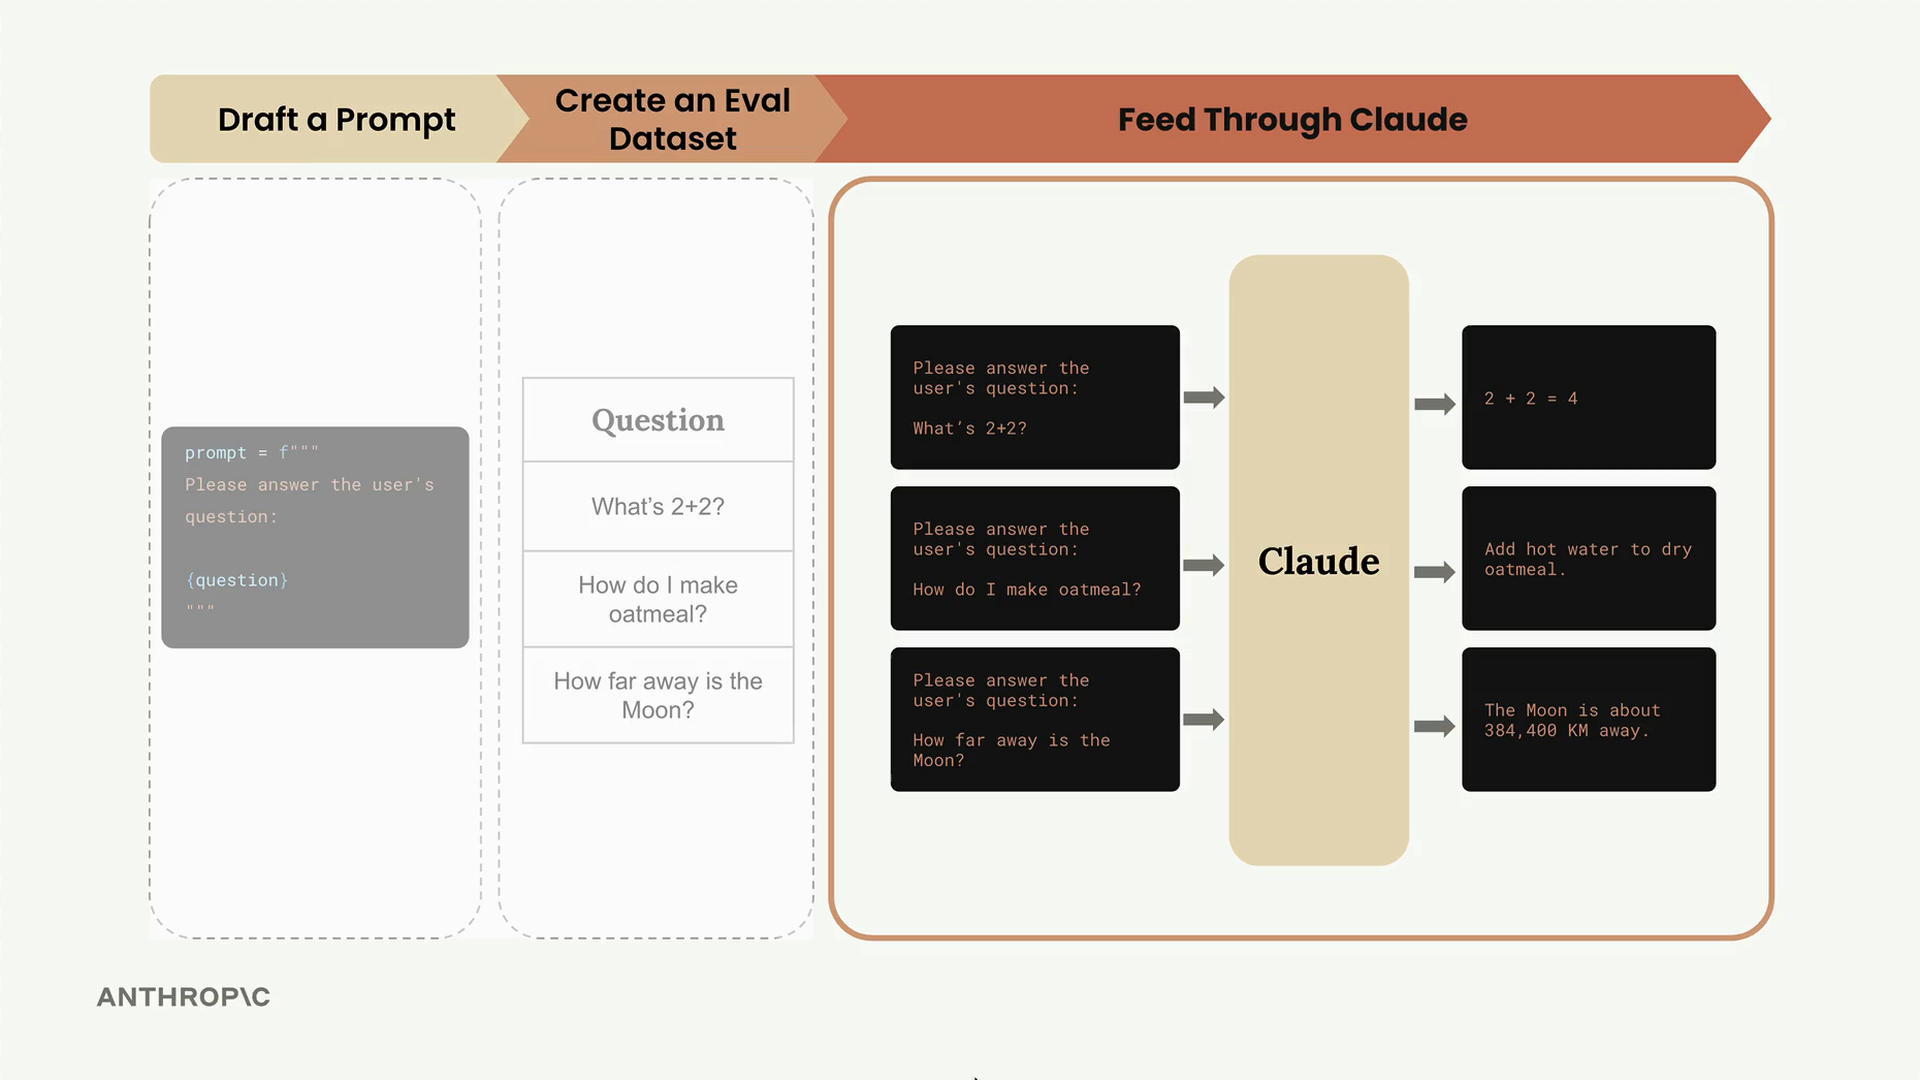
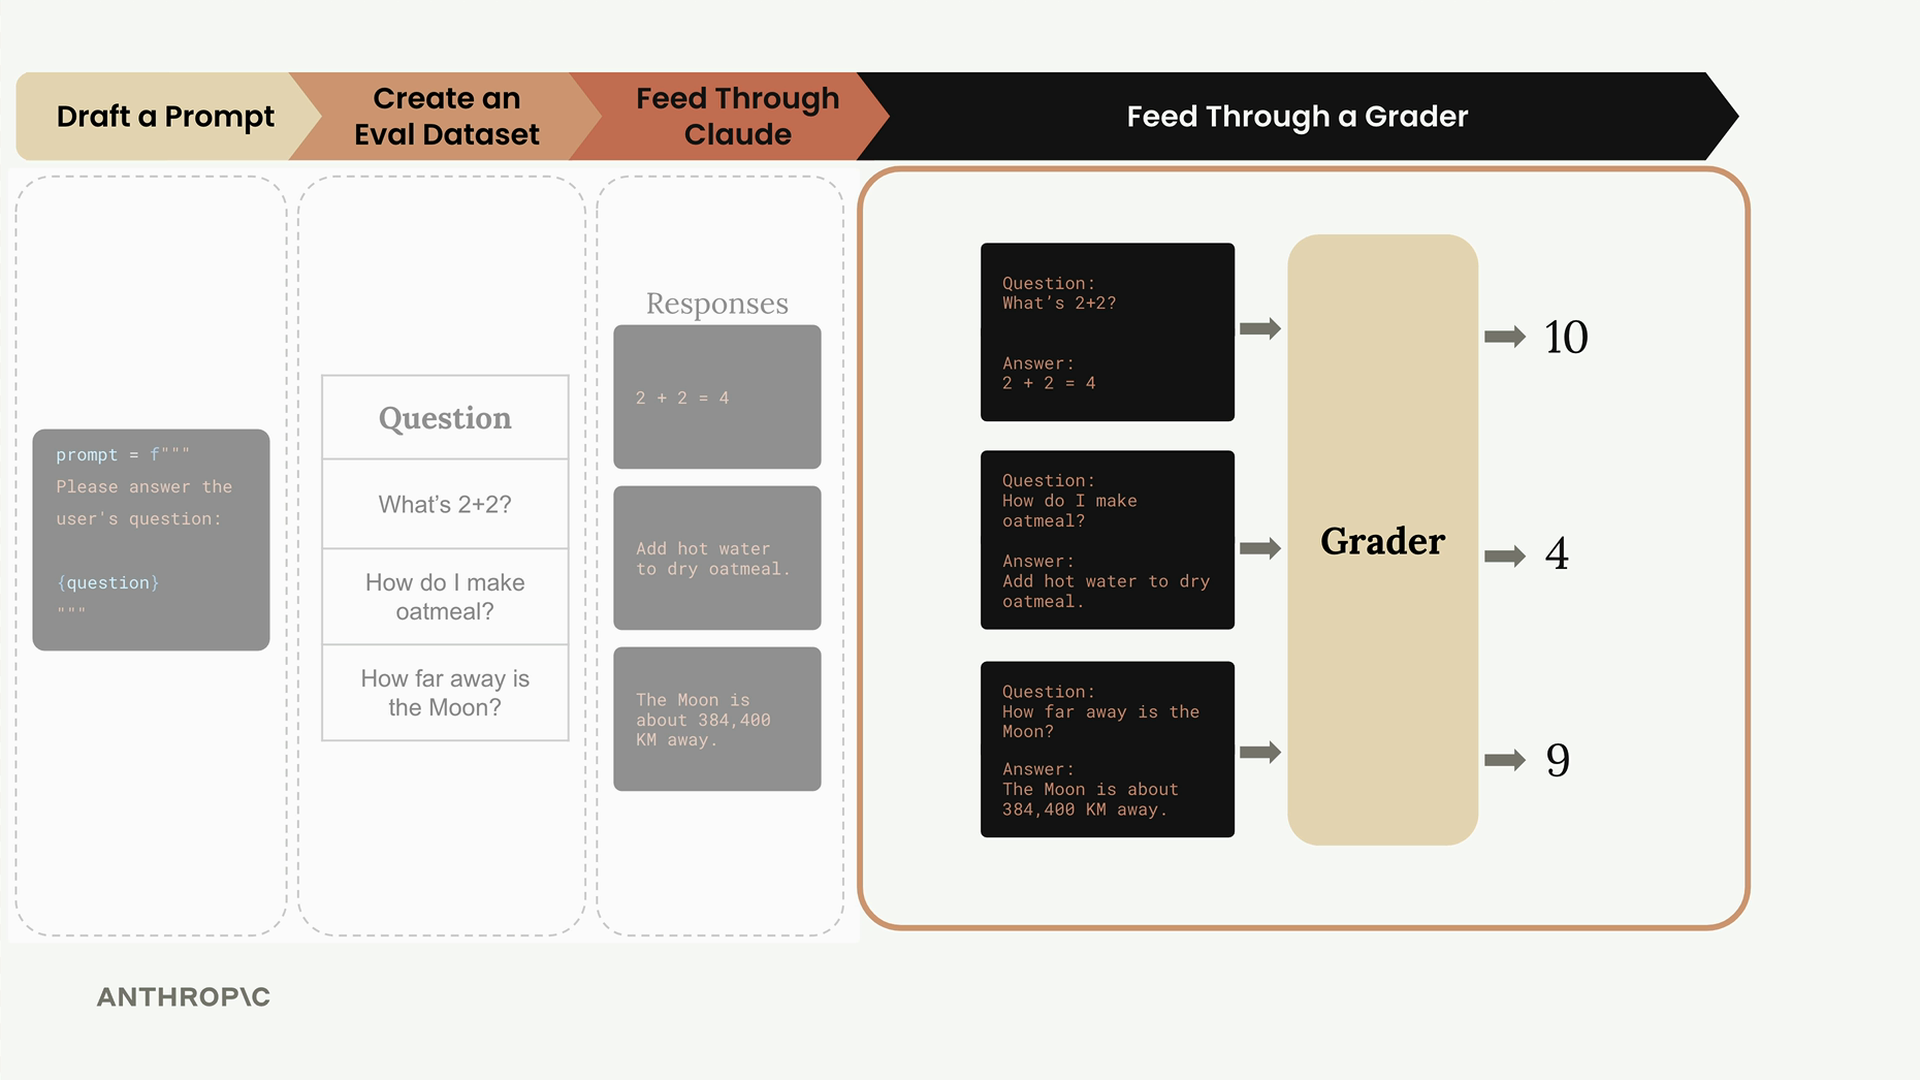
El proceso de evaluación sigue un flujo de trabajo claro: tomamos nuestro conjunto de datos de casos de prueba, combinamos cada uno con nuestra plantilla de indicación, lo enviamos a Claude para su procesamiento y luego evaluamos la salida usando un sistema calificador.
Construyendo las funciones principales
El pipeline de evaluación consta de tres funciones principales, cada una con una responsabilidad específica. Comencemos con la más simple: la función que maneja las indicaciones individuales.
La función run_prompt
Esta función toma un caso de prueba y lo combina con nuestra plantilla de indicación:
def run_prompt(test_case):
    """Merges the prompt and test case input, then returns the result"""
    prompt = f"""
Please solve the following task:

{test_case["task"]}
"""

    messages = []
    add_user_message(messages, prompt)
    output = chat(messages)
    return output
Por ahora, mantenemos la indicación extremadamente simple. No incluimos ninguna instrucción de formato, así que es probable que Claude devuelva una salida más detallada de lo que necesitamos. Refinaremos esto más adelante a medida que iteramos en el diseño de nuestra indicación.
La función run_test_case
Esta función orquesta la ejecución de un solo caso de prueba y la calificación del resultado:
def run_test_case(test_case):
    """Calls run_prompt, then grades the result"""
    output = run_prompt(test_case)

    # TODO - Calificación
    score = 10

    return {
        "output": output,
        "test_case": test_case,
        "score": score
    }
Por ahora, estamos usando una puntuación fija de 10. La lógica de calificación es donde dedicaremos un tiempo significativo en las próximas secciones, pero este marcador de posición nos permite probar el pipeline completo.
La función run_eval
Esta función coordina todo el proceso de evaluación:
def run_eval(dataset):
    """Loads the dataset and calls run_test_case with each case"""
    results = []

    for test_case in dataset:
        result = run_test_case(test_case)
        results.append(result)

    return results
Esta función procesa cada caso de prueba en nuestro conjunto de datos y recopila todos los resultados en una sola lista.
Ejecutando la evaluación
Para ejecutar nuestro pipeline de evaluación, cargamos nuestro conjunto de datos y lo procesamos a través de nuestras funciones:
with open("dataset.json", "r") as f:
    dataset = json.load(f)

results = run_eval(dataset)
La primera vez que ejecutes esto, espera que tome algo de tiempo; incluso con Claude Haiku, puede tardar alrededor de 30 segundos en procesar un conjunto de datos completo. Cubriremos técnicas de optimización más adelante.
Examinando los resultados
La evaluación devuelve un arreglo JSON estructurado donde cada objeto representa el resultado de un caso de prueba:
print(json.dumps(results, indent=2))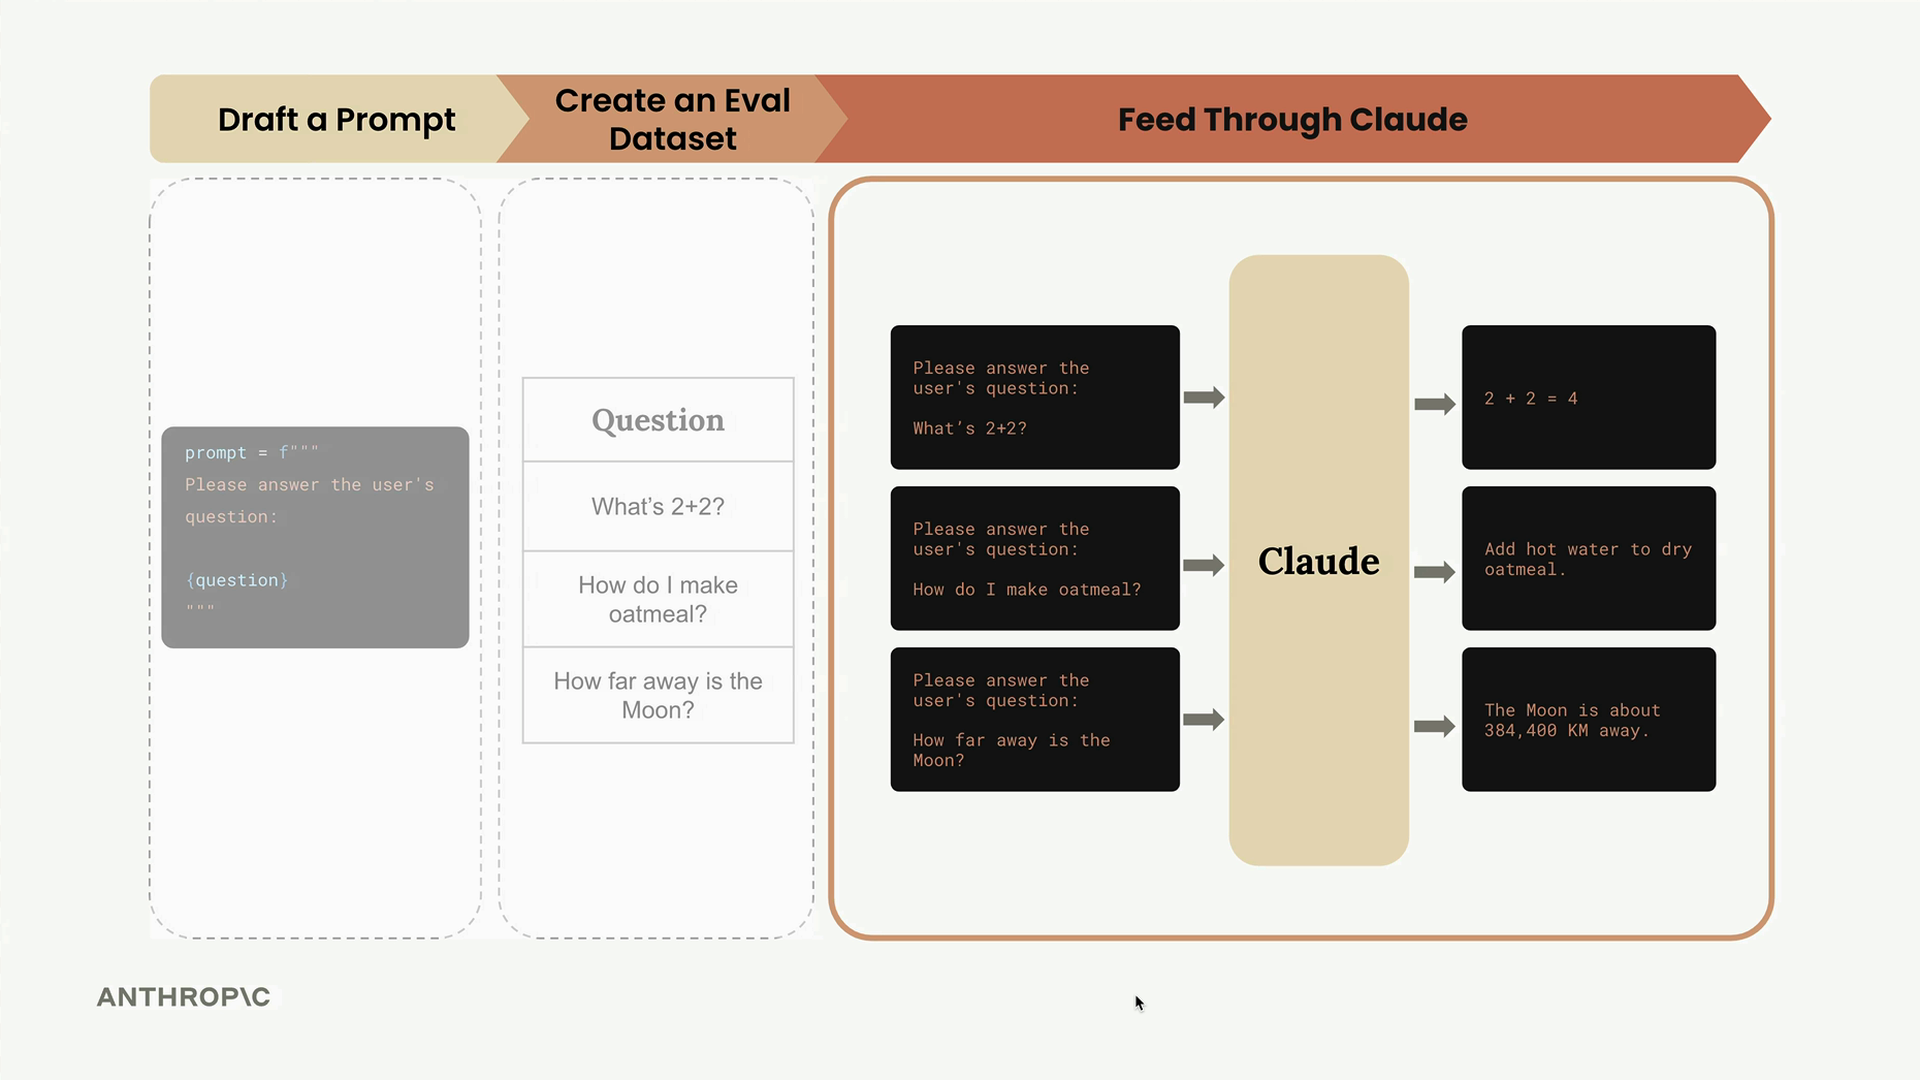
Cada resultado contiene tres piezas clave de información:
- output: La respuesta completa de Claude
- test_case: El caso de prueba original que fue procesado
- score: La puntuación de evaluación (actualmente fija)
Como puedes ver en la salida, Claude genera respuestas bastante detalladas ya que aún no hemos proporcionado instrucciones de formato específicas. Este es exactamente el tipo de problema que abordaremos a medida que refinemos nuestras indicaciones.
Lo que hemos logrado
En este punto, hemos construido con éxito el pipeline principal de evaluación. Podemos tomar nuestro conjunto de datos, procesarlo a través de Claude y recopilar resultados estructurados. La pieza principal que falta es el sistema de calificación: esa puntuación fija de 10 debe reemplazarse con lógica de evaluación real.
Este pipeline representa la base de la mayoría de los sistemas de evaluación de IA. Aunque pueda parecer simple, acabas de construir la mayor parte de lo que realmente hace un pipeline de evaluación. La complejidad está en los detalles: mejores indicaciones, calificación sofisticada y optimizaciones de rendimiento.
A continuación, profundizaremos en el tema crítico de los calificadores, que transformará nuestras puntuaciones fijas en evaluaciones significativas del rendimiento de Claude.