El pensamiento extendido es la función de razonamiento avanzado de Claude que le da al modelo tiempo para trabajar en problemas complejos antes de generar una respuesta final. Piensa en ello como el "papel de borrador" de Claude: puedes ver el proceso de razonamiento que lleva a la respuesta, lo cual ayuda con la transparencia y a menudo resulta en respuestas de mejor calidad.
Cómo funciona el pensamiento extendido
Cuando el pensamiento extendido está habilitado, la respuesta de Claude cambia de un simple bloque de texto a una respuesta estructurada que contiene dos partes:
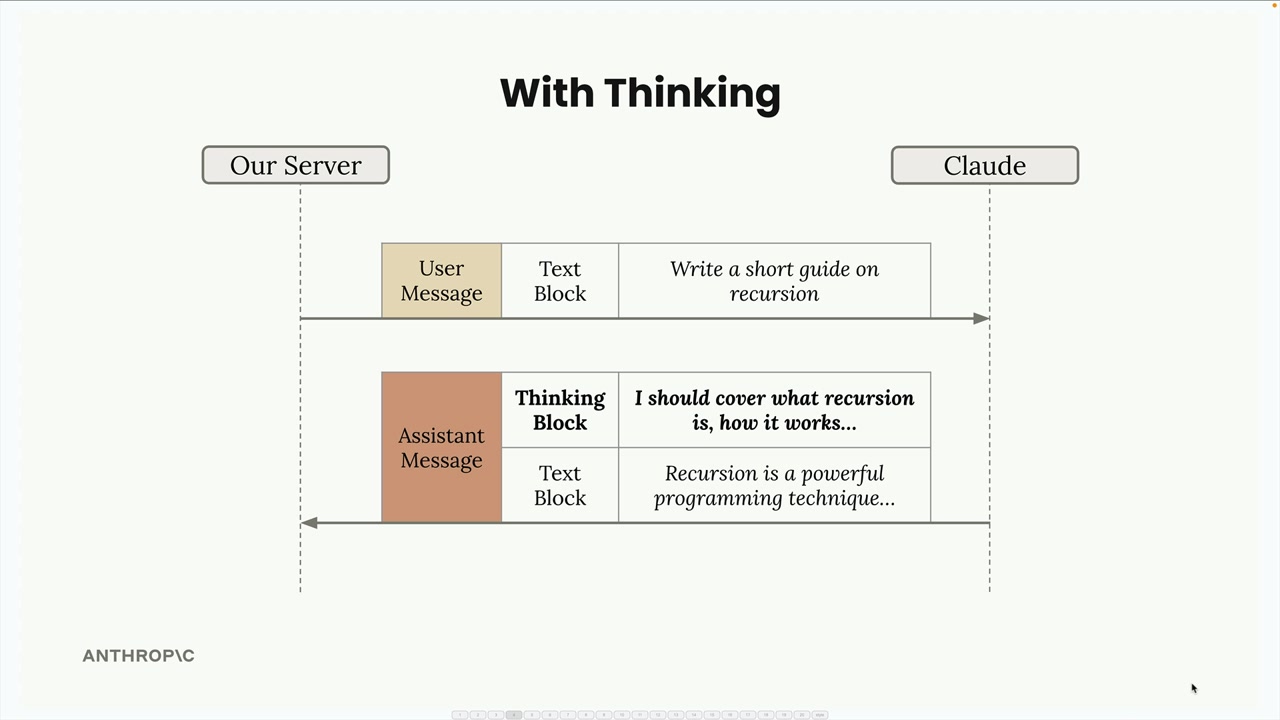
Con el pensamiento habilitado, obtienes tanto el proceso de razonamiento como la respuesta final:
Los beneficios clave incluyen:
- Mejores capacidades de razonamiento para tareas complejas
- Mayor precisión en problemas difíciles
- Transparencia en el proceso de pensamiento de Claude
Sin embargo, hay compensaciones importantes:
- Costos más altos (pagas por los tokens de pensamiento)
- Mayor latencia (pensar toma tiempo)
- Manejo de respuestas más complejo en tu código
Cuándo usar el pensamiento extendido
La decisión es sencilla: usa tus evaluaciones de prompts. Ejecuta tus prompts sin pensamiento primero, y si la precisión no cumple con tus requisitos después de haber optimizado ya tu prompt, entonces considera habilitar el pensamiento extendido. Es una herramienta para cuando la indicación estándar no te acerca lo suficiente.
Estructura de respuesta y seguridad
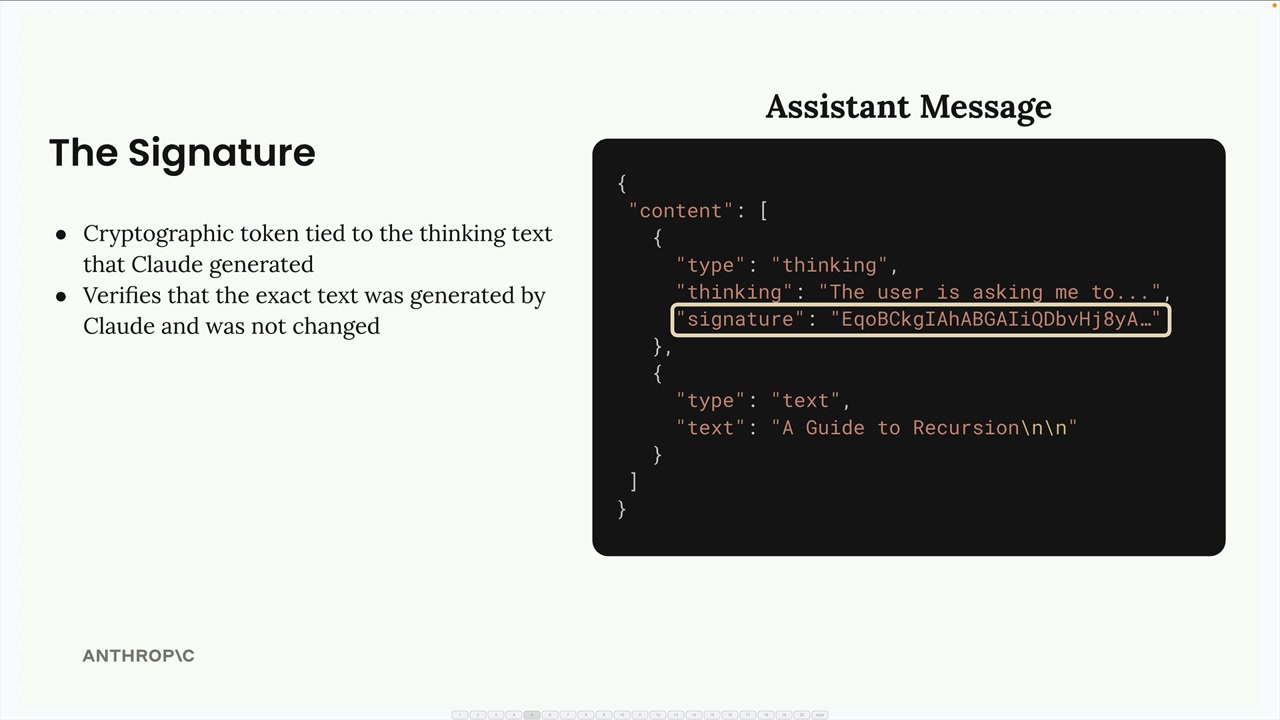
Las respuestas de pensamiento extendido incluyen un sistema especial de firma para la seguridad:
La firma es un token criptográfico que garantiza que no hayas modificado el texto de pensamiento. Esto evita que los desarrolladores alteren el proceso de razonamiento de Claude, lo cual podría potencialmente llevar al modelo en direcciones inseguras.
Pensamiento redactado
A veces recibirás un bloque de pensamiento redactado en lugar de texto de razonamiento legible.
Esto sucede cuando el proceso de pensamiento de Claude es marcado por sistemas internos de seguridad. El contenido redactado contiene el pensamiento real en forma cifrada, lo que te permite pasar el mensaje completo de vuelta a Claude en conversaciones futuras sin perder contexto.
Implementación
Para habilitar el pensamiento extendido en tu código, necesitas agregar dos parámetros a tu función de chat:
def chat(
    messages,
    system=None,
    temperature=1.0,
    stop_sequences=[],
    tools=None,
    thinking=False,
    thinking_budget=1024
):
El presupuesto de pensamiento —budget_tokens en la solicitud— establece el máximo de tokens que Claude puede usar para el razonamiento. El valor mínimo de budget_tokens es 1024, y tu parámetro max_tokens debe ser mayor que budget_tokens.
Agrega el parámetro thinking a tu solicitud de API —un objeto con type establecido en "enabled" y un valor de budget_tokens— y aumenta max_tokens para que sea mayor que budget_tokens:
if thinking:
    params["max_tokens"] = thinking_budget + 1000
    params["thinking"] = {
        "type": "enabled",
        "budget_tokens": thinking_budget
    }
Luego llama a tu función de chat con el pensamiento habilitado:
chat(messages, thinking=True)Prueba de respuestas redactadas
Para fines de prueba, puedes forzar a Claude a devolver un bloque de pensamiento redactado enviando una cadena especial de activación. Esto ayuda a garantizar que tu aplicación maneje las respuestas redactadas con elegancia sin fallar.
El pensamiento extendido es una función poderosa cuando necesitas que Claude aborde tareas de razonamiento complejas, pero úsala con criterio dadas las implicaciones de costo y latencia. Comienza con la indicación estándar, optimiza a fondo y luego agrega el pensamiento cuando necesites esa capacidad de razonamiento adicional.