Al evaluar modelos de IA que generan código, necesitas más que simplemente comprobar si la respuesta tiene sentido. También necesitas verificar que el código generado realmente tenga una sintaxis válida y siga el formato correcto. Aquí es donde entra en juego la calificación basada en código.
Cómo funciona la calificación de código
La calificación de código valida dos aspectos clave de las respuestas generadas por IA:
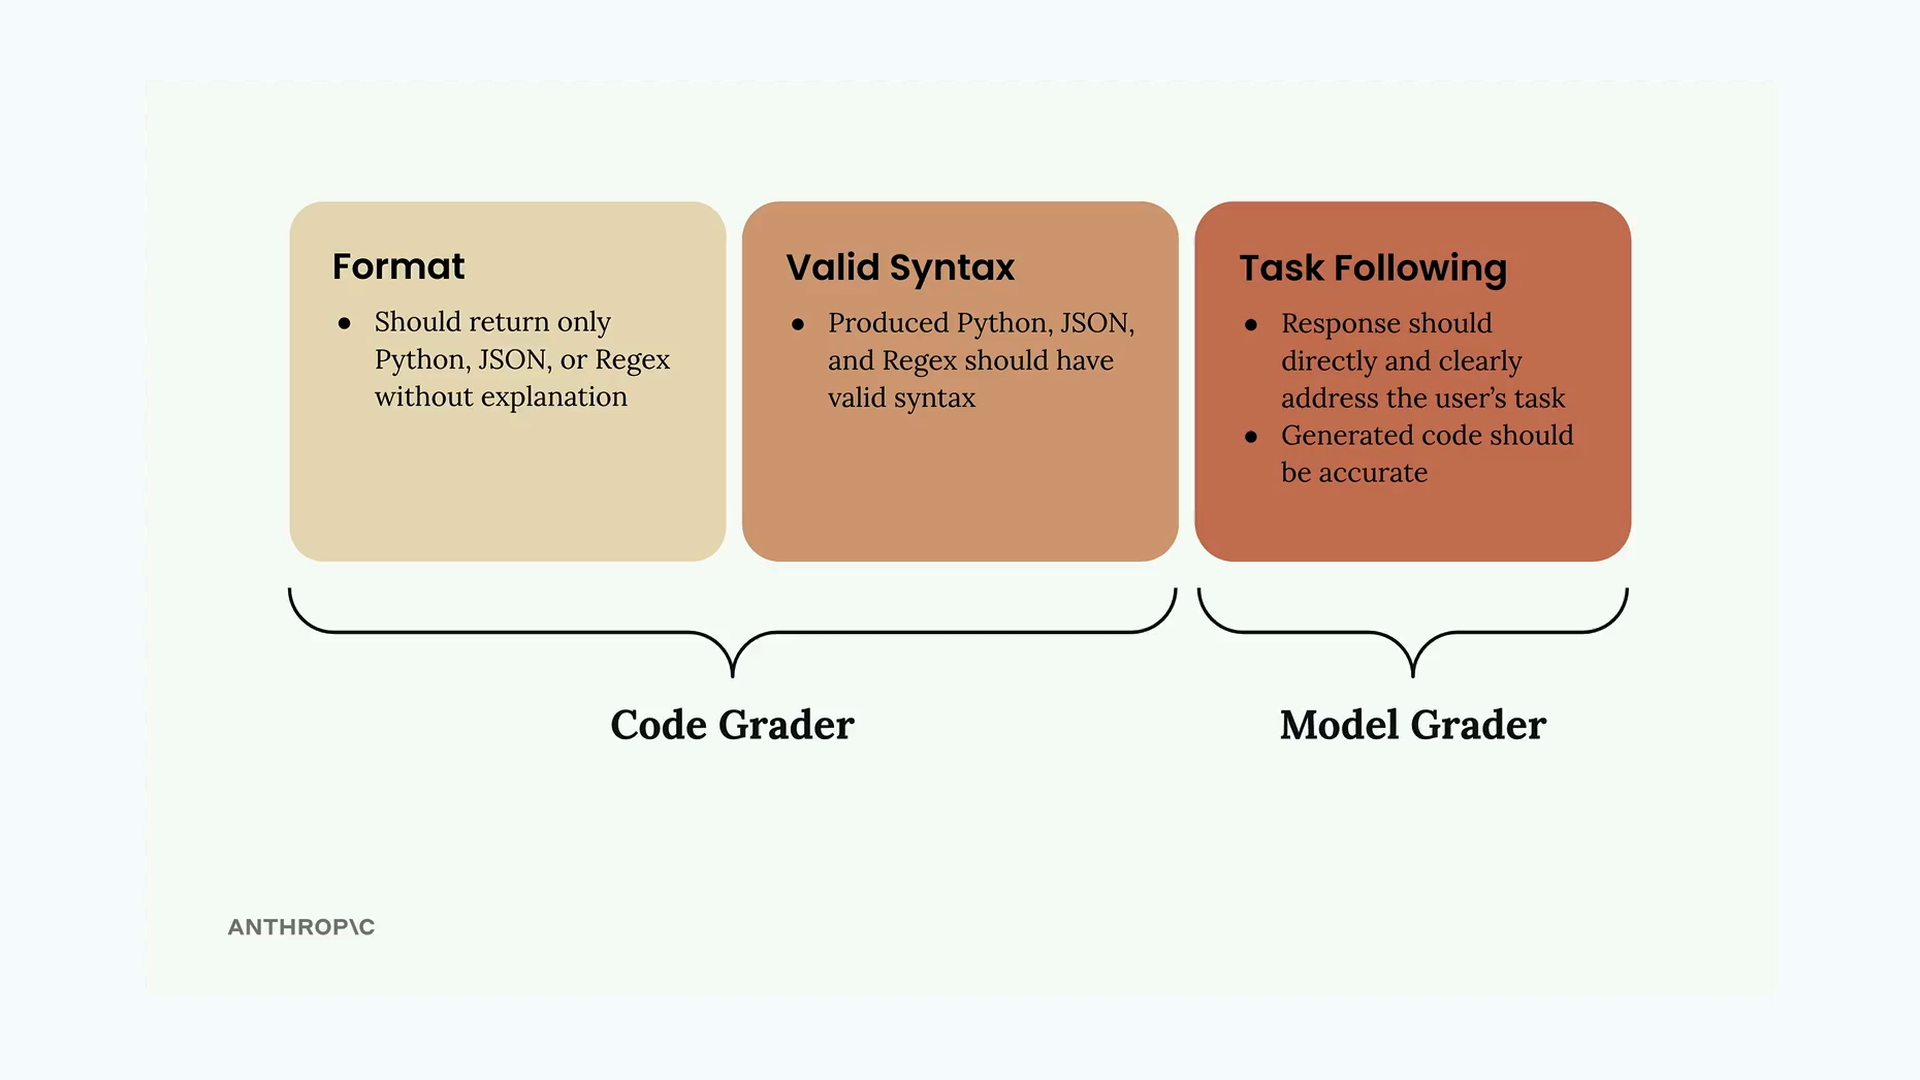
- Formato - La respuesta debe devolver únicamente el tipo de código solicitado (Python, JSON o Regex) sin explicaciones
- Sintaxis válida - El código generado realmente debe analizarse (parse) correctamente como el lenguaje previsto
- Seguimiento de la tarea - La respuesta debe abordar directamente lo que se pidió y ser precisa
Los dos primeros criterios son manejados por el calificador de código, mientras que el seguimiento de la tarea es evaluado por el calificador del modelo. Juntos, proporcionan una evaluación integral.
Funciones de validación de sintaxis
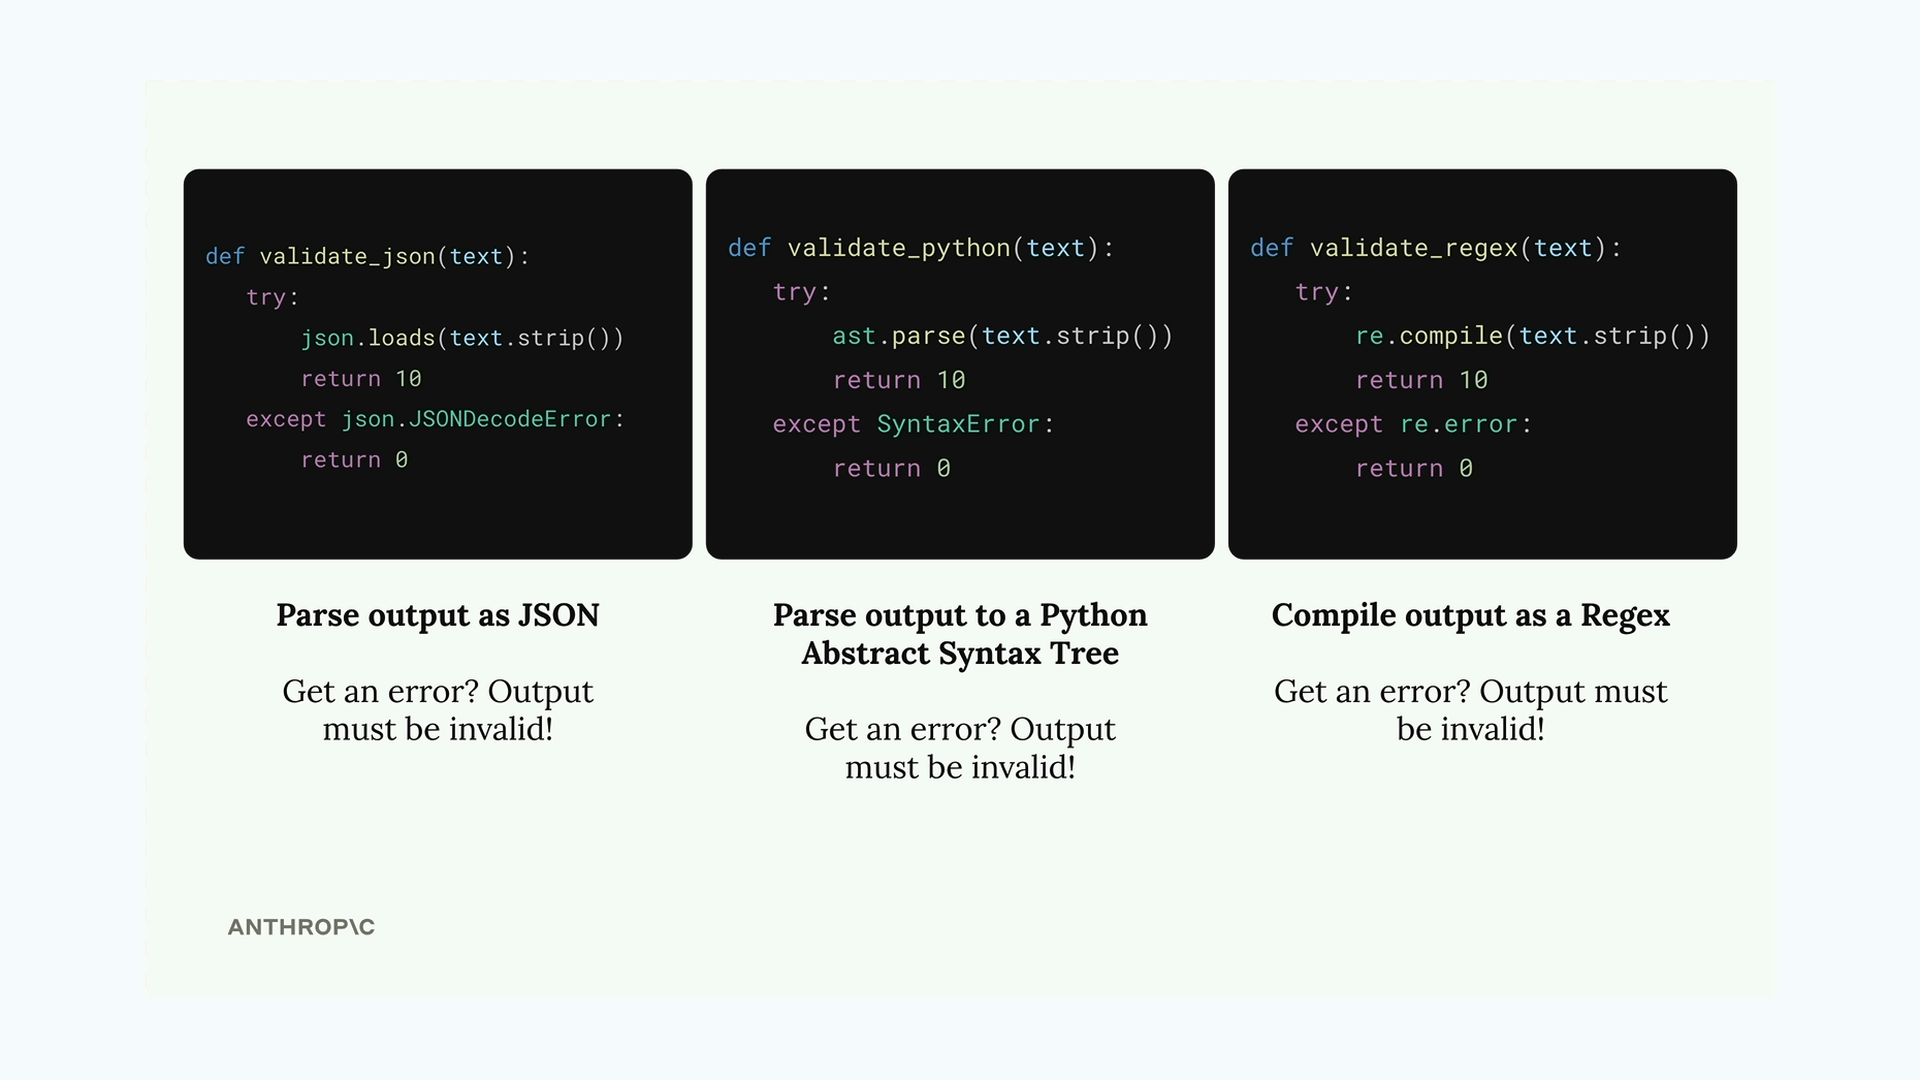
Para comprobar si el código generado tiene una sintaxis válida, puedes crear tres funciones auxiliares que intenten analizar la salida:
import ast
import json
import re

def validate_json(text):
    try:
        json.loads(text.strip())
        return 10
    except json.JSONDecodeError:
        return 0

def validate_python(text):
    try:
        ast.parse(text.strip())
        return 10
    except SyntaxError:
        return 0

def validate_regex(text):
    try:
        re.compile(text.strip())
        return 10
    except re.error:
        return 0
Cada función intenta analizar el texto como su formato respectivo. Si el análisis tiene éxito, devuelve una puntuación perfecta de 10. Si falla con un error, la sintaxis no es válida y devuelve 0.
Requisitos de formato del conjunto de datos
Para que el calificador de código sepa qué validador usar, tus casos de prueba deben especificar el formato de salida esperado:
{
    "task": "Create a Python function to validate an AWS IAM username",
    "format": "python"
}
Puedes actualizar tu indicación de generación del conjunto de datos para incluir automáticamente este campo de formato, agregándolo a la estructura de salida de ejemplo.
Mejorando la claridad de la indicación
Para obtener mejores resultados de tu modelo de IA, haz que las instrucciones de tu indicación sean más específicas sobre el formato de salida esperado:
* Respond only with Python, JSON, or a plain Regex
* Do not add any comments or commentary or explanationTambién puedes usar un mensaje del asistente prerrellenado con bloques de código para animar al modelo a devolver solo el código en bruto:
add_assistant_message(messages, "```code")
output = chat(messages, stop_sequences=["```"])
Esto le indica a Claude que comience a generar contenido de código sin tener que especificar de antemano si es Python, JSON o Regex.
Combinando puntuaciones
Primero, elige el validador que coincida con cada caso de prueba:
def grade_syntax(output, test_case):
    if test_case["format"] == "json":
        return validate_json(output)
    if test_case["format"] == "python":
        return validate_python(output)
    return validate_regex(output)
El paso final es fusionar la puntuación del calificador del modelo con la puntuación del calificador de código. Un enfoque simple es tomar el promedio dentro de run_test_case:
model_grade = grade_by_model(test_case, output)
model_score = model_grade["score"]
syntax_score = grade_syntax(output, test_case)

score = (model_score + syntax_score) / 2
Esto otorga el mismo peso tanto a la calidad del contenido como a la corrección técnica. Puedes ajustar estos pesos según lo que importe más para tu caso de uso específico.
Probando tu implementación
Una vez que hayas implementado la calificación de código, ejecuta tu evaluación para obtener una puntuación de referencia. La puntuación en sí no es inherentemente buena o mala: lo que importa es si puedes mejorarla refinando tus indicaciones. Esto te brinda una forma cuantitativa de medir el progreso de la ingeniería de indicaciones en lugar de depender de una evaluación subjetiva.