La ingeniería de prompts consiste en tomar un prompt que has escrito y mejorarlo para obtener resultados más confiables y de mayor calidad. Este proceso implica un refinamiento iterativo: empezar con un prompt básico, evaluar su rendimiento y luego aplicar sistemáticamente técnicas de ingeniería para mejorarlo.
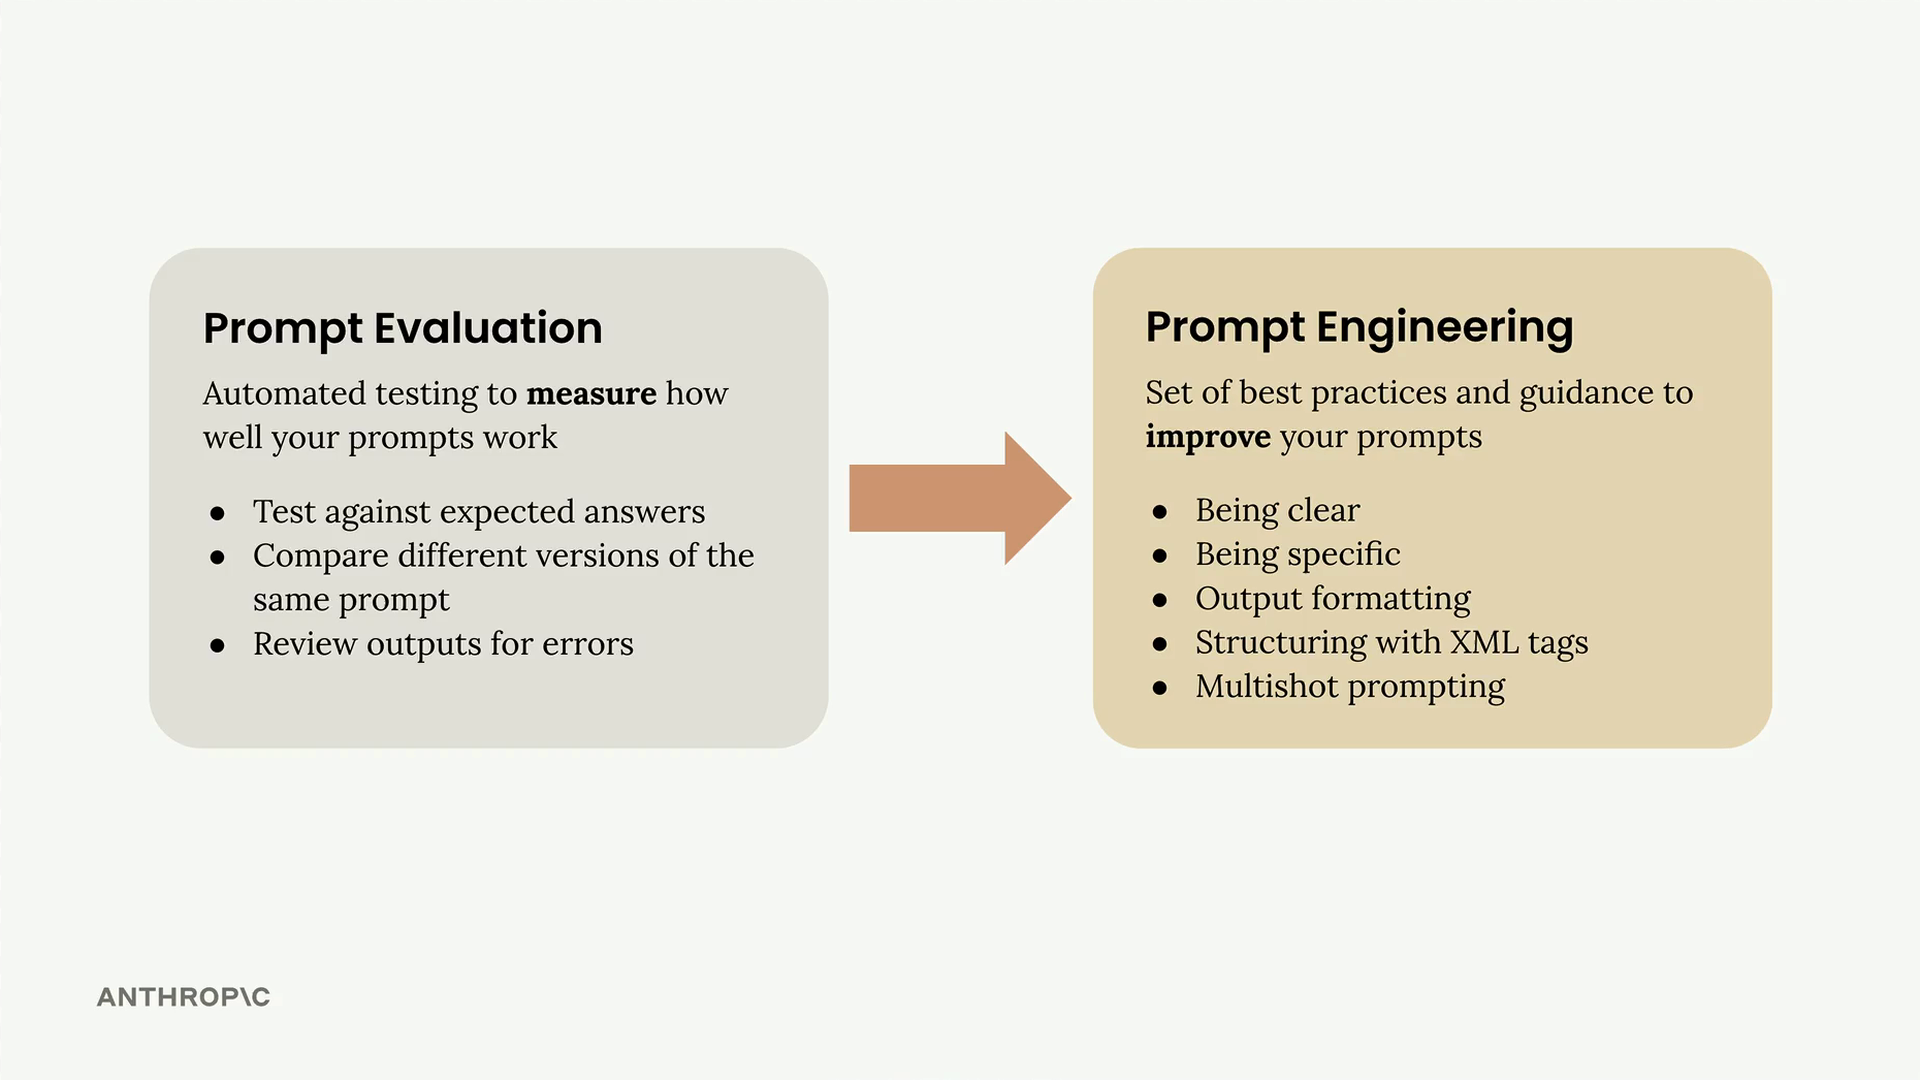
El proceso de mejora iterativa
El enfoque sigue un ciclo claro que puedes repetir hasta lograr los resultados deseados:
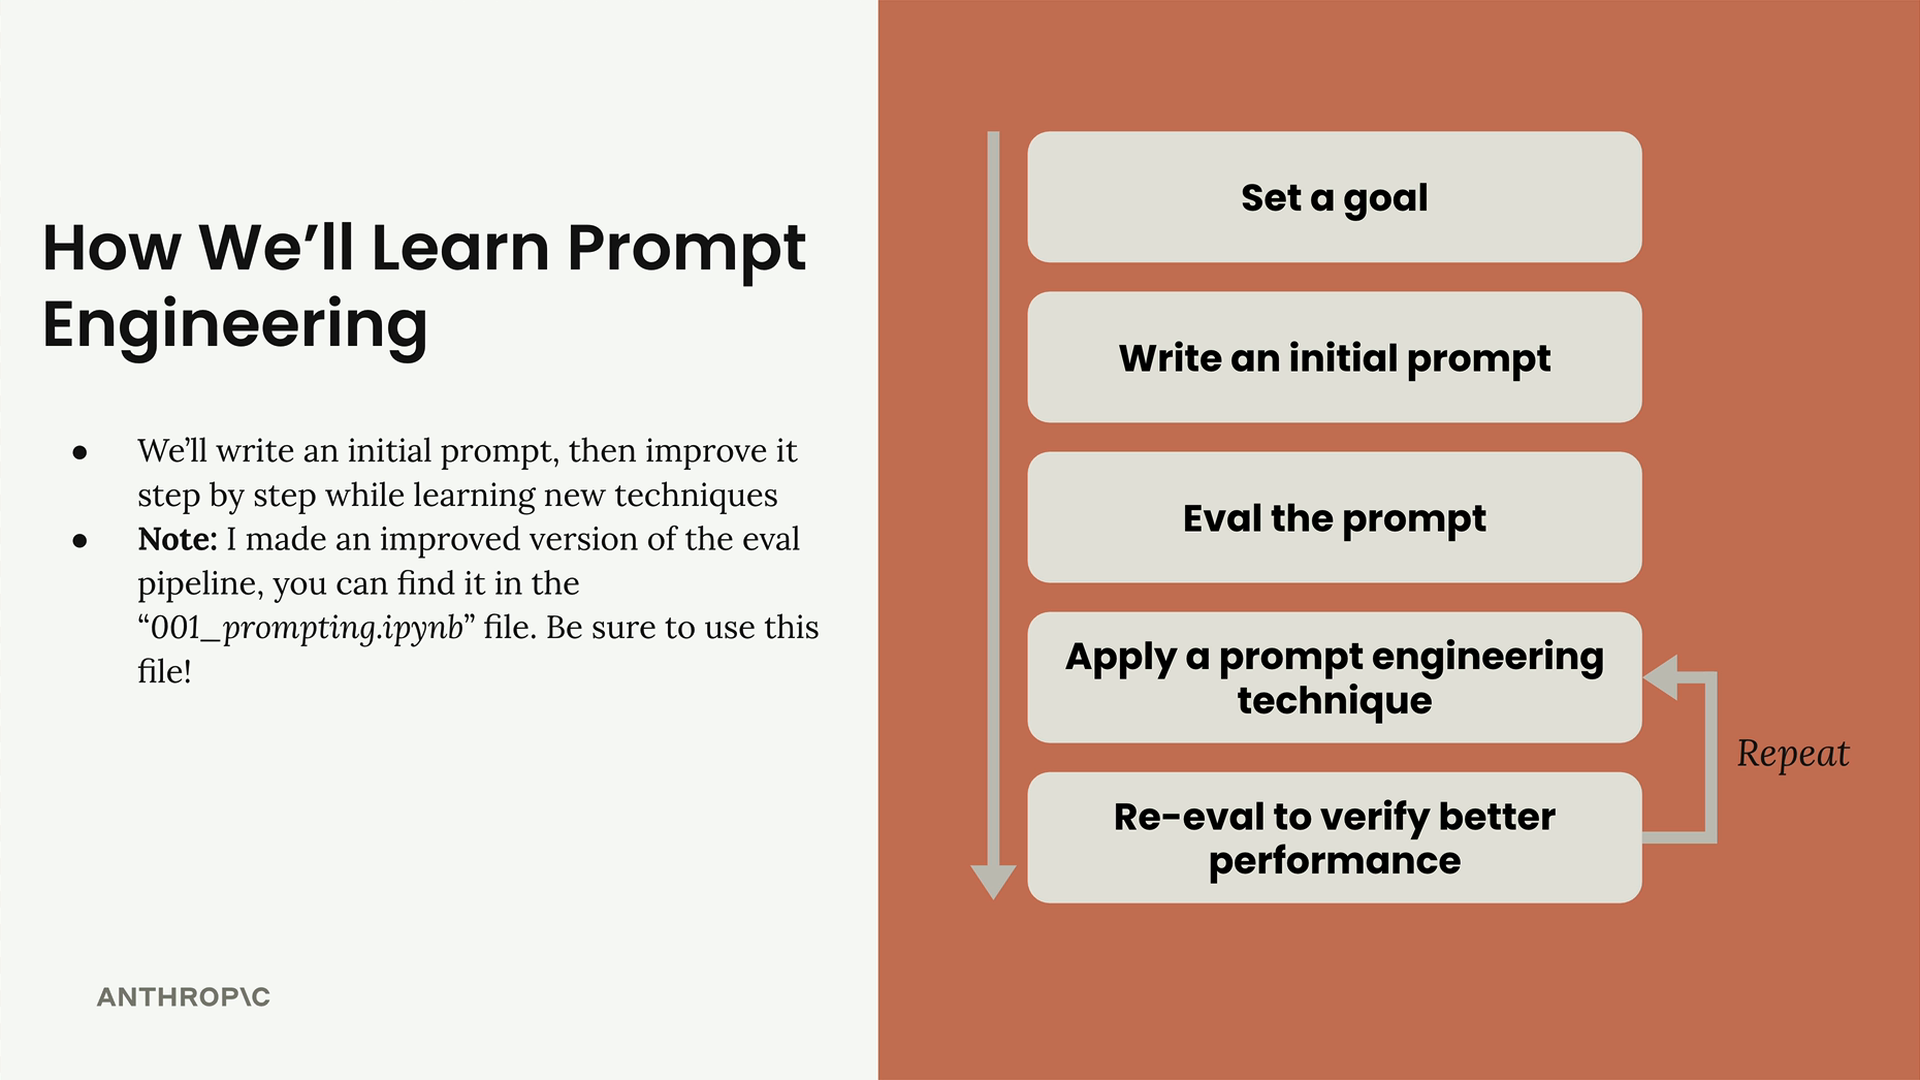
- Establece un objetivo - Define qué quieres que logre tu prompt
- Escribe un prompt inicial - Crea un primer intento básico
- Evalúa el prompt - Pruébalo según tus criterios
- Aplica técnicas de ingeniería de prompts - Usa métodos específicos para mejorar el rendimiento
- Vuelve a evaluar - Verifica que tus cambios realmente mejoraron los resultados
Repites los dos últimos pasos hasta que estés satisfecho con el rendimiento. Cada iteración debe mostrar una mejora medible en tus puntuaciones de evaluación.
Configurando tu pipeline de evaluación
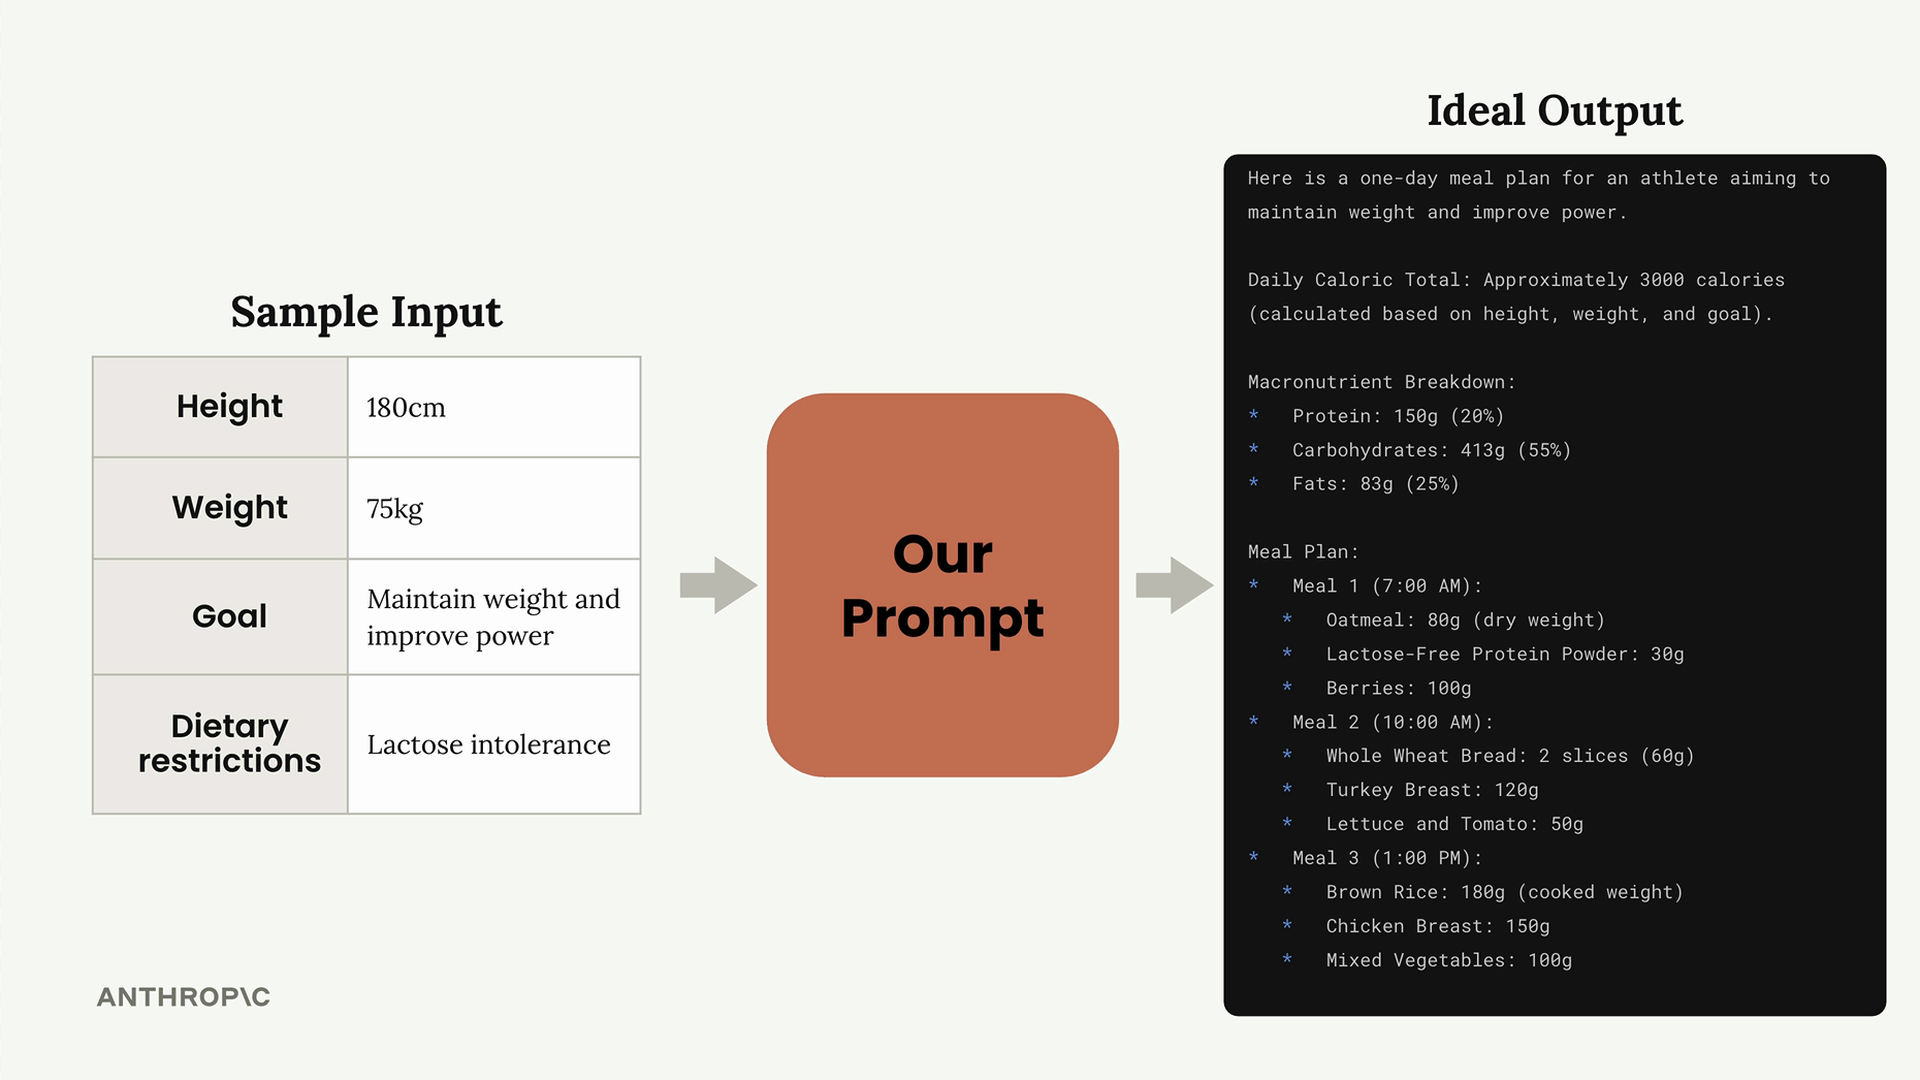
Para demostrar este proceso, trabajaremos con un ejemplo práctico: crear un prompt que genere planes de comidas de un día para atletas. El prompt debe tener en cuenta la altura, el peso, los objetivos y las restricciones dietéticas del atleta, y luego producir un plan de comidas completo.
La configuración de evaluación usa una clase PromptEvaluator que se encarga de la generación del conjunto de datos y la calificación del modelo. Al crear tu instancia del evaluador, puedes controlar la concurrencia con el parámetro max_concurrent_tasks:
evaluator = PromptEvaluator(max_concurrent_tasks=5)Comienza con un valor de concurrencia bajo (como 3) para evitar errores de límite de velocidad. Puedes aumentarlo si tu cuota de API permite un procesamiento más rápido.
Generando datos de prueba
El sistema de evaluación puede generar automáticamente casos de prueba según los requisitos de tu prompt. Defines qué entradas necesita tu prompt:
dataset = evaluator.generate_dataset(
    task_description="Write a compact, concise 1 day meal plan for a single athlete",
    prompt_inputs_spec={
        "height": "Athlete's height in cm",
        "weight": "Athlete's weight in kg",
        "goal": "Goal of the athlete",
        "restrictions": "Dietary restrictions of the athlete"
    },
    output_file="dataset.json",
    num_cases=3
)
Mantén bajo el número de casos de prueba (2-3) durante el desarrollo para acelerar tu ciclo de iteración. Puedes aumentarlo para la validación final.
Escribiendo tu prompt inicial
Comienza con un prompt simple e ingenuo para establecer una línea base. Aquí tienes un ejemplo de un primer intento deliberadamente básico:
def run_prompt(prompt_inputs):
    prompt = f"""
What should this person eat?

- Height: {prompt_inputs["height"]}
- Weight: {prompt_inputs["weight"]}
- Goal: {prompt_inputs["goal"]}
- Dietary restrictions: {prompt_inputs["restrictions"]}
"""

    messages = []
    add_user_message(messages, prompt)
    return chat(messages)
Es probable que este prompt básico produzca resultados deficientes, pero te da un punto de partida para medir la mejora.
Agregando criterios de evaluación
Al ejecutar tu evaluación, puedes especificar criterios adicionales que el modelo calificador debe considerar:
results = evaluator.run_evaluation(
    run_prompt_function=run_prompt,
    dataset_file="dataset.json",
    extra_criteria="""
The output should include:
- Daily caloric total
- Macronutrient breakdown
- Meals with exact foods, portions, and timing
"""
)
Esto ayuda a garantizar que tu prompt se evalúe según los requisitos específicos que importan para tu caso de uso.
Analizando resultados
Después de ejecutar una evaluación, obtendrás tanto una puntuación numérica como un informe HTML detallado. El informe te muestra exactamente cómo se desempeñó cada caso de prueba, incluyendo el razonamiento del modelo para cada puntuación.
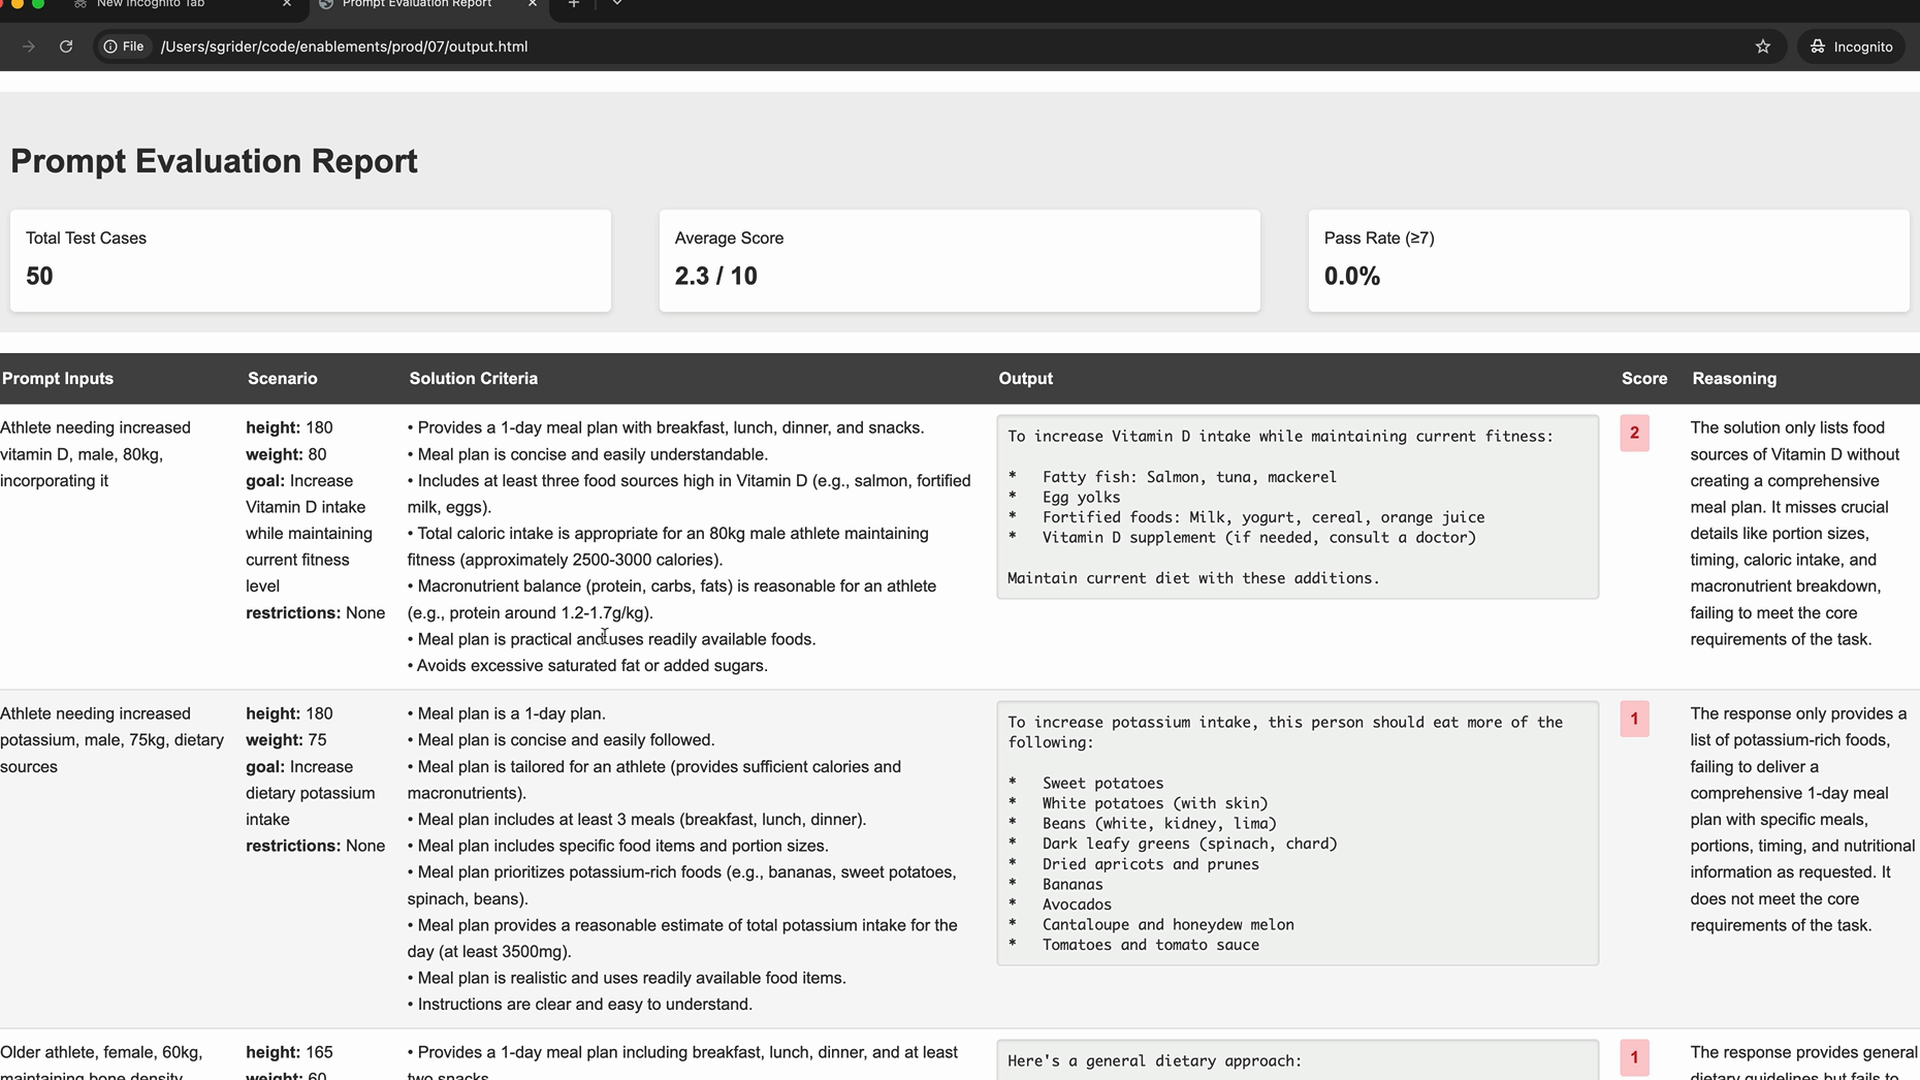
No te desanimes por las puntuaciones iniciales bajas - una puntuación de 2.3 sobre 10 es típica para un primer intento. El objetivo es ver una mejora constante a medida que aplicas técnicas de ingeniería.
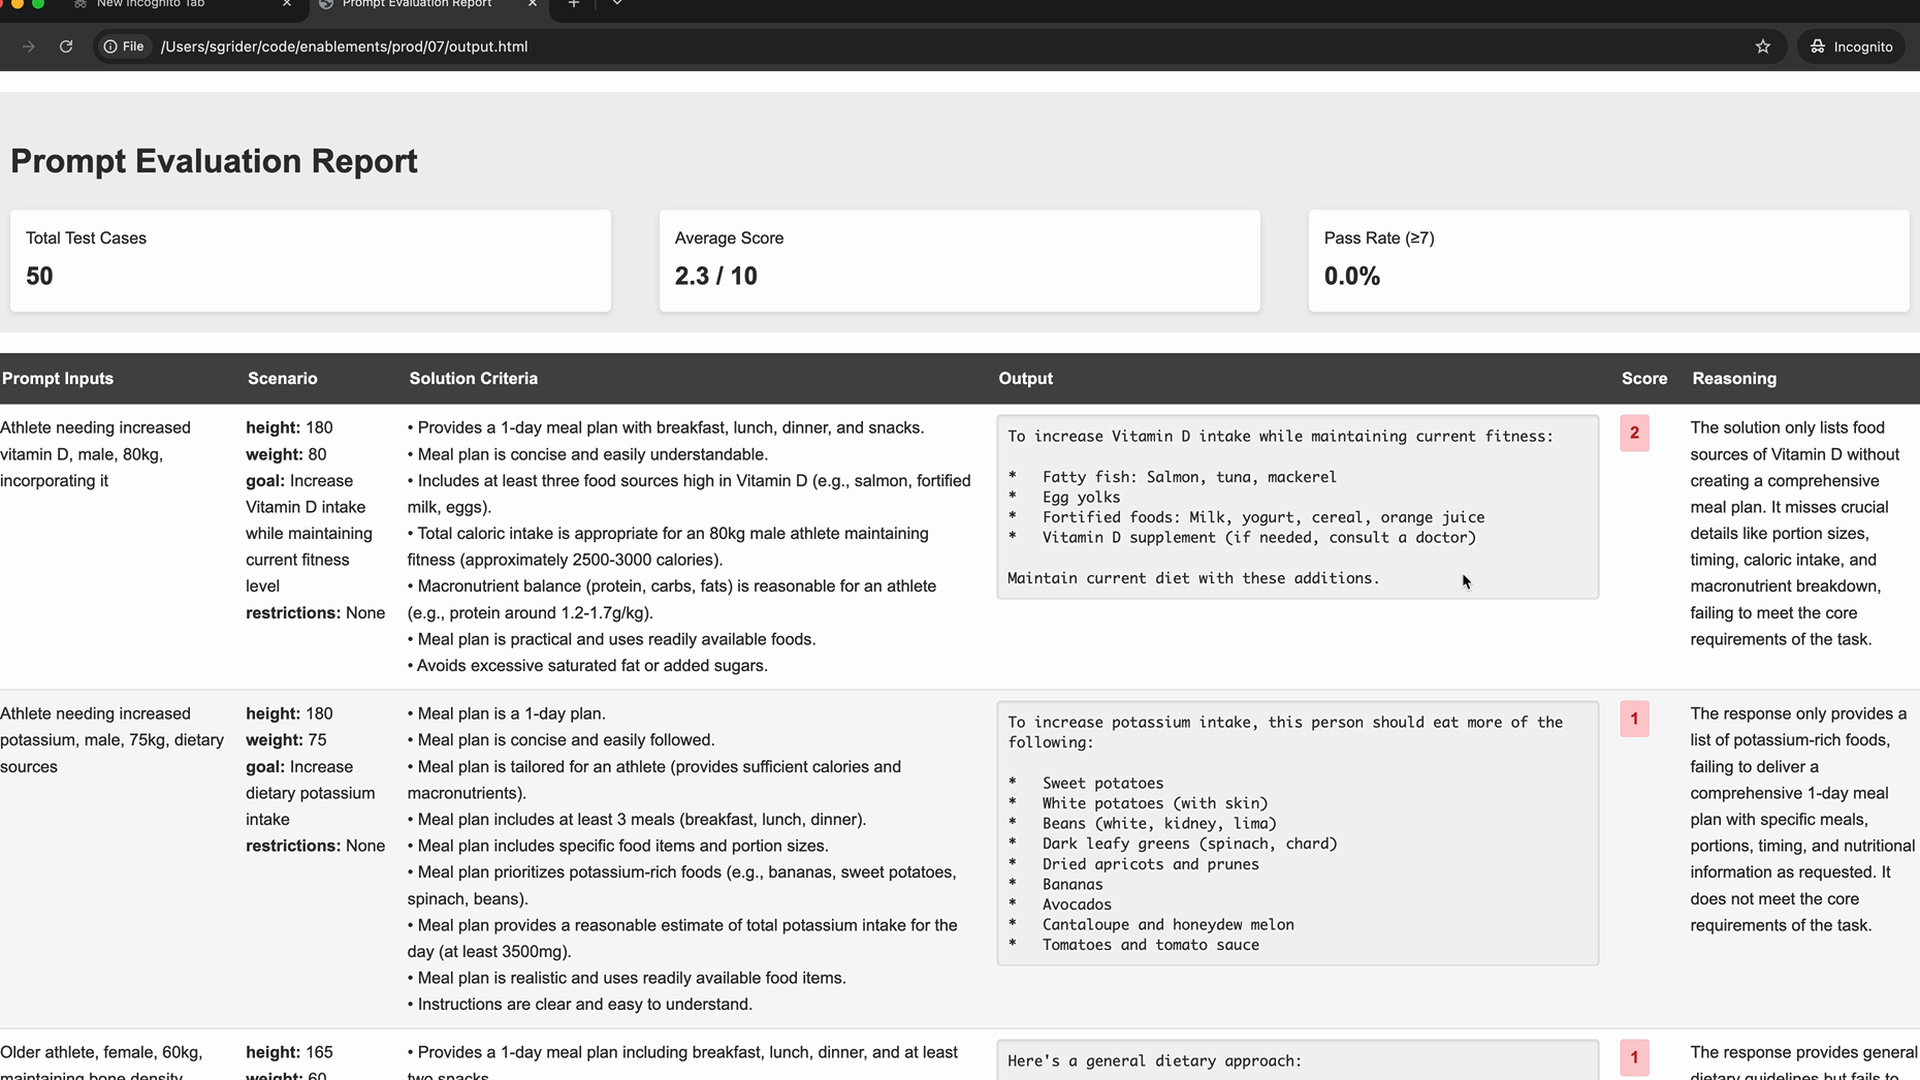
El informe de evaluación detallado te ayuda a entender exactamente dónde está fallando tu prompt y qué mejoras se necesitan. Usa esta retroalimentación para guiar tu próxima iteración.
Próximos pasos
Con tu línea base establecida, estás listo para empezar a aplicar técnicas específicas de ingeniería de prompts. Cada técnica que aprendas debe generar una mejora medible en tus puntuaciones de evaluación, transformando gradualmente tu prompt básico en una herramienta confiable y de alto rendimiento.
Recuerda que la ingeniería de prompts es un proceso iterativo. La clave es hacer un cambio a la vez, evaluar el impacto y construir sobre lo que funciona. Este enfoque sistemático asegura que entiendas qué técnicas aportan más valor para tu caso de uso específico.